N-gram çözümleyici
Açıklama: Metni N adet ardışık karakterden oluşan dizilere ayırır. 2-gram ve 3-gram desteklenir. Bu çözümleyici, anlamsal olmayan arama senaryoları için uygundur.
Bu çözümleyici yalnızca özel uygulamalar için kullanılabilir ve alanın SHORT_TEXT türünde olması gerekir.
Örnekler:
-
2-gram
If the document field content is "Open Search", the tokenization result is 'op','pe','en','n ',' s','se','ea','ar','rc','ch' -
3-gram
If the document field content is "Open Search", the tokenization result is 'ope','pen','en ','n s',' se','sea','ear','arc','rch'
Anahtar sözcük çözümleyici
Açıklama: Metni parçalamaz. Bu çözümleyici; etiketler, anahtar sözcükler ve parçalanmaması gereken diğer dize veya sayısal değerler gibi tam eşleşme gerektiren senaryolar için uygundur.
Not: Bu çözümleyici LITERAL, INT, LITERAL_ARRAY ve INT_ARRAY alan türlerine uygulanır.
Örnek:
Example: If the document field content is "chrysanthemum tea", the document can be retrieved only when you search for "chrysanthemum tea".Yapılandırma adımları:
Çevrimdışı bir değişikliğin Application Schema adımında, hedef alanın türünü LITERAL olarak ayarlayın.
Index Schema adımında alan için bir dizin oluşturun. Alanın analiz yöntemi otomatik olarak anahtar sözcük analizi olarak ayarlanır.
Çevrimdışı değişikliği gönderin ve hizmet geçişinin tamamlanmasını bekleyin.
Tam eşleşme sorgusu çalıştırmak için
query=field_name:"search_term"kullanın. Yalnızca alan değerleri çift tırnak içindeki içerikle tamamen aynı olan belgeler getirilir. Örnek:query=id:"cloud search".
TEXT alanları için tümcecik sorgusu çalıştırmak amacıyla çift tırnak işaretlerini kullanabilirsiniz. Çift tırnak işaretleri arasındaki içerik bir bütün olarak eşleştirilir ve parçalanmaz. Örnek: query=default:"open search". Daha fazla bilgi için bkz. Yaklaşık arama.
Çince - genel çözümleyici
Açıklama: Metni, Çince anlam bilgisine dayalı olarak getirme birimine göre parçalar. Bu çözümleyici, İnternet genelindeki genel amaçlı endüstriler için uygundur ve endüstri analiz türüne aittir.
Not: Bu çözümleyici TEXT ve SHORT_TEXT alan türlerine uygulanır.
Örnek:
In the examples in this topic, Chinese characters are represented as ASCII Unicode escapes (\uXXXX). Decode them into the actual Chinese characters before you enter them in a document or query.
Example: If the document field content is "\u83ca\u82b1\u8336" (Chinese for "chrysanthemum tea"), the document can be retrieved when you search for "\u83ca\u82b1\u8336", "\u83ca\u82b1", "\u8336", or "\u82b1\u8336".
Çince - e-ticaret çözümleyici
Açıklama: E-ticaret endüstrisi için uygun bir çözümleyicidir.
Not: Bu çözümleyici TEXT ve SHORT_TEXT alan türlerine uygulanır.
Örnek:
Example (Chinese characters are shown as Unicode escapes; decode them before use): If the document field content is "\u5927\u5b9dSOD\u871c" (a Chinese skin care product name), the document can be retrieved when you search for "\u5927\u5b9d", "sod", "sod\u871c", "SOD\u871c", or "\u871c".Çince - tek karakterli çözümleyici
Açıklama: Metni tek karaktere veya tek kelimeye göre parçalar. Bu çözümleyici, roman yazar adları ve mağaza adları aramaları gibi anlamsal olmayan Çince arama senaryoları için uygundur.
Not: Bu çözümleyici TEXT ve SHORT_TEXT alan türlerine uygulanır.
Örnek:
Example (Chinese characters are shown as Unicode escapes; decode them before use): If the document field content is "\u83ca\u82b1\u8336" (Chinese for "chrysanthemum tea"), the document can be retrieved when you search for "\u83ca\u82b1\u8336", "\u83ca\u82b1", "\u8336", "\u82b1\u8336", "\u83ca", "\u82b1", or "\u83ca\u8336".Yaklaşık çözümleyici
Açıklama: Pinyin aramasını, sayılar için ön ek ve son ek aramasını (Çince karakterler için ön ek ve son ek eşleşmesi desteklenmez ancak harfler, rakamlar ve pinyin için desteklenir) ve tek karakterli veya tek harfli aramayı destekler. Bir alanın uzunluğu en fazla 100 bayt olabilir. Daha fazla bilgi ve kullanım notları için bkz. Yaklaşık arama.
Not: Bu çözümleyici yalnızca SHORT_TEXT türüne uygulanır.
Örnek:
Example (Chinese characters are shown as Unicode escapes; decode them before use): If the document field content is "\u83ca\u82b1\u8336" (Chinese for "chrysanthemum tea", pinyin: ju hua cha), the document can be retrieved when you search for "\u83ca\u82b1\u8336", "\u83ca\u82b1", "\u8336", "\u82b1\u8336", "\u83ca", "\u82b1", "\u83ca\u8336", "ju", "juhua", "juhuacha", "j", "jh", or "jhc".
Example: If the document field content is the mobile phone number "138****5678", you can search for "^138" to find mobile phone numbers that start with "138", and search for "5678$" to find mobile phone numbers that end with "5678".
Example: If the document field content is "OpenSearch", the document can be retrieved by a single letter or a combination of letters.
İngilizce - kök bulma çözümleyici
Açıklama: İngilizce anlamsal arama senaryoları için uygundur. Varsayılan olarak, her İngilizce kelime parçalandıktan sonra kök bulma ve tekil/çoğul dönüştürme işlemleri uygulanır.
Not: Bu çözümleyici TEXT ve SHORT_TEXT alan türlerine uygulanır. Bu çözümleyici, sorgu analizi yapılandırmalarını desteklemez.
Örnek:
Example (Chinese characters are shown as Unicode escapes; decode them before use): If the document field content is "\u82f1\u6587\u5206\u8bcd\u5668 english analyzer" (the Chinese part means "English analyzer"), the document can be retrieved when you search for "\u82f1\u6587\u5206\u8bcd\u5668", "english", "analyz", "analyzer", "analyzers", "analyze", "analyzed", or "analyzing".
(Note: In the English analyzer, consecutive Chinese characters are treated as a single term.)
İngilizce - kök bulmayan çözümleyici
Açıklama: İngilizce kitap başlıkları ve kişi adları aramaları gibi senaryolarda kullanılır. Metin, boşluklara ve noktalama işaretlerine göre parçalanır.
Not: Bu çözümleyici TEXT ve SHORT_TEXT alan türlerine uygulanır. Bu çözümleyici, sorgu analizi yapılandırmalarını desteklemez.
Örnek:
Example (Chinese characters are shown as Unicode escapes; decode them before use): If the document field content is "\u82f1\u6587\u5206\u8bcd\u5668 english analyzer" (the Chinese part means "English analyzer"), the document can be retrieved when you search for "\u82f1\u6587\u5206\u8bcd\u5668", "english", or "analyzer".
(Note: In the English analyzer, consecutive Chinese characters are treated as a single term.)
İngilizce - ayrıntılı analiz
Açıklama: Metni, İngilizce anlam bilgisine dayalı olarak İngilizce getirme birimine göre parçalar. Bu çözümleyici, genel amaçlı İngilizce endüstrileri için uygundur.
Not: Bu çözümleyici yalnızca TEXT ve SHORT_TEXT alan türlerine uygulanır.
Yalnızca özel teknik özelliklere sahip uygulamalar için kullanılabilir.
Örnek:
If the document field content is "dataprocess", the tokenization result is "data process", and the document can be retrieved when you search for "dataprocess", "data process", "data", or "process".Tam pinyin çözümleyici
Açıklama: Kısa metindeki Çince karakterleri pinyin baş harfleri ve tam pinyin ile aramanıza olanak tanır. Bu çözümleyici; kişi adları ve film başlıkları gibi kısaltılmış pinyin ve tam pinyin araması gerektiren senaryolar için uygundur. Tam pinyin araması için, Çince bir karakterin yalnızca bir kısmını değil, tam pinyin değerini girmeniz gerekir.
Not: Bu çözümleyici yalnızca SHORT_TEXT türüne uygulanır.
Örnek:
Example (Chinese characters are shown as Unicode escapes; decode them before use): If the document field content is "\u5927\u5185\u5bc6\u63a2007" (a Chinese movie title, pinyin: da nei mi tan), the document can be retrieved when you search for "d", "dn", "dnm", "dnmt", "dnmt007", "da", "danei", "daneimi", or "daneimitan". The document cannot be retrieved when you search for "an" or "anei".Kısaltılmış pinyin çözümleyici
Açıklama: Kısa metindeki Çince karakterleri pinyin baş harfleri ile aramanıza olanak tanır. Bu çözümleyici; kişi adları ve film başlıkları gibi kısaltılmış pinyin araması gerektiren senaryolar için uygundur.
Not: Bu çözümleyici yalnızca SHORT_TEXT türüne uygulanır.
Örnek:
Example (Chinese characters are shown as Unicode escapes; decode them before use): If the document field content is "\u5927\u5185\u5bc6\u63a2007" (a Chinese movie title, pinyin: da nei mi tan), the document can be retrieved when you search for "d", "dn", "dnm", "dnmt", "dnmt0", "dnmt007", "m", "mt", "mt007", or "007".Basit çözümleyici
Açıklama: Yerleşik çözümleyicilerin işleyemediği özel arama senaryoları için uygundur ve kullanıcılara parçalama üzerinde tam kontrol sağlar. Belgeleri gönderirken ve arama yaparken, alan içeriğini (veya sorgu terimlerini) ayırmak için sekme karakteri "\t" kullanın. Belge ve sorguların parçalamasının tutarlı olduğundan emin olun. Aksi takdirde, belgeler getirilemeyebilir.
Not: Bu çözümleyici TEXT ve SHORT_TEXT alan türlerine uygulanır. Bu çözümleyici, sorgu analizi yapılandırmalarını desteklemez.
Örnek:
Example (Chinese characters are shown as Unicode escapes; decode them before use; "\t" is the tab character): If the field content is "\u83ca\t\u82b1\u8336\thao", the document can be retrieved only by the query terms "\u83ca", "\u82b1\u8336", "\u83ca\t\u82b1\u8336", "\u82b1\u8336\thao", "\u83ca\thao", and "\u83ca\t\u82b1\u8336\thao".Sayısal çözümleyici
Açıklama: Zaman aralığı sorguları ve sayısal aralık sorguları gerektiren arama senaryoları için uygundur.
Not: Bu çözümleyici INT ve zaman damgası alan türlerine uygulanır.
Örnek:
Example: query=default:'open search' AND index:[number1,number2]
//Here, index is the name of the index for which numeric analysis is configured.
Coğrafi konum çözümleyici
Açıklama: Coğrafi konum aralığı sorguları gerektiren senaryolar için uygundur.
Not: Bu çözümleyici yalnızca geo_point alan türüne uygulanır.
Örnek:
Example: query=spatial_index:'circle(116.5806 39.99624, 1000)'
//Queries points within a circle. This can be used to query points within a certain number of kilometers nearby.
BT içeriği çözümleyici
Açıklama: BT endüstrisindeki teknik içerikler için bir çözümleyicidir. Endüstri parçalamasına aittir. Genel çözümleyici ile karşılaştırıldığında, bazı BT teknoloji terimleri için farklı parçalama sonuçları üretir.
Not: Bu çözümleyici yalnızca TEXT ve SHORT_TEXT alan türlerine uygulanır.
Örnek:
Example (Chinese characters are shown as Unicode escapes; decode them before use; the Chinese text means "precautions for using C++ arrays"):
Original content: c++\u6570\u7ec4\u4f7f\u7528\u6ce8\u610f\u4e8b\u9879
General analysis: c ++\u6570\u7ec4\u4f7f\u7528\u6ce8\u610f\u4e8b\u9879
IT content analysis: c++\u6570\u7ec4\u4f7f\u7528\u6ce8\u610f\u4e8b\u9879
Endüstri - genel e-ticaret analizi
Açıklama: E-ticaret endüstrisi senaryoları için bir çözümleyicidir. Endüstri parçalamasına aittir. OpenSearch, yıllarca süren endüstri deneyimine ve DAMO Academy'nin akıllı dil işleme teknolojisine dayanarak, endüstrinin ağrı noktalarını ve gereksinimlerini ele alan, e-ticarete özel sorgu analizi yetenekleri sağlar.
Not:
Bu çözümleyici yalnızca TEXT alan türüne uygulanır.
Yalnızca e-ticaret endüstrisi geliştirilmiş teknik özelliklerine sahip özel uygulamalar için kullanılabilir.
Örnek:
Example (Chinese characters are shown as Unicode escapes; decode them before use; the Chinese text is the name of a concealer product):
Original content: \u5c0f\u91d1\u7ba1\u906e\u7455\u818f
General analysis: \u5c0f\u91d1\u7ba1 \u906e\u7455 \u818f
Industry - e-commerce analysis: \u5c0f\u91d1\u7ba1 \u906e\u7455 \u818f
Tayca - genel analiz
Açıklama: Metni Tayca getirme birimine göre parçalar. Bu çözümleyici, genel amaçlı Tay endüstrileri için uygundur.
Not: Bu çözümleyici yalnızca TEXT ve SHORT_TEXT alan türlerine uygulanır.
Yalnızca özel teknik özelliklere sahip uygulamalar için kullanılabilir.
Örnek:
If the document field content is "แหล่งดึงดูดนักท่องเที่ยว", the tokenization result is "แหล่ง ดึง ดูด นักท่องเที่ยว", and the document can be retrieved when you search for "นักท่องเที่ยว" or "แหล่งดึงดูดนักท่องเที่ยว".Tayca - e-ticaret analizi
Açıklama: Tay e-ticaret endüstrisi için uygun bir çözümleyicidir.
Not: Bu çözümleyici yalnızca TEXT ve SHORT_TEXT alan türlerine uygulanır.
Yalnızca özel teknik özelliklere sahip uygulamalar için kullanılabilir.
Örnek:
If the document field content is "หน้าจอโทรศัพท์", the tokenization result is "หน้าจอ โทรศัพท์", and the document can be retrieved when you search for "หน้าจอโทรศัพท์", "หน้าจอ", or "โทรศัพท์".Vietnamca - genel analiz
Açıklama: Genel amaçlı Vietnam endüstrileri için uygun bir çözümleyicidir.
Not: Bu çözümleyici yalnızca TEXT ve SHORT_TEXT alan türlerine uygulanır.
Yalnızca özel teknik özelliklere sahip uygulamalar için kullanılabilir.
Endonezce - genel analiz
Açıklama: Genel amaçlı Endonez endüstrileri için uygun bir çözümleyicidir.
Not: Bu çözümleyici yalnızca TEXT ve SHORT_TEXT alan türlerine uygulanır.
Yalnızca özel teknik özelliklere sahip uygulamalar için kullanılabilir.
Endüstri - genel oyun analizi
Açıklama: Oyun endüstrisi için uygun bir çözümleyicidir.
Not: Bu çözümleyici yalnızca TEXT ve SHORT_TEXT alan türlerine uygulanır.
Yalnızca oyun endüstrisi geliştirilmiş teknik özelliklerine sahip özel uygulamalar için kullanılabilir.
Örnek:
Example (Chinese characters are shown as Unicode escapes; decode them before use): If the document field content is "\u539f\u795e\u88c5\u5907" (Chinese for "Genshin Impact equipment"), the tokenization result is "\u539f\u795e \u88c5\u5907", and the document can be retrieved when you search for "\u539f\u795e\u88c5\u5907", "\u539f\u795e", or "\u88c5\u5907".Endüstri - genel İngilizce e-ticaret analizi
Açıklama: İngilizce senaryolardaki e-ticaret endüstrisi için uygun bir çözümleyicidir.
Not: Bu çözümleyici yalnızca TEXT alan türüne uygulanır.
Yalnızca e-ticaret endüstrisi geliştirilmiş teknik özelliklerine sahip özel uygulamalar için kullanılabilir.
Çince - karakter analizi
Açıklama: Metni tek tek Çince karakterlere, rakamlara, İngilizce harflere ve noktalama işaretlerine ayırır. Bu çözümleyici, anlamsal olmayan arama senaryoları için uygundur.
Not: Bu çözümleyici yalnızca TEXT ve SHORT_TEXT alan türlerine uygulanır.
Yalnızca özel teknik özelliklere sahip uygulamalar için kullanılabilir.
Örnek:
Example (Chinese characters are shown as Unicode escapes; decode them before use): If the document field content is "\u5f00\u653e\u641c\u7d22OpenSearch123." (the Chinese part is the Chinese name of OpenSearch), the document can be retrieved when you search for "\u5f00", "\u653e", "\u641c", "\u7d22", "O", "p", "e", "n", "S", "e", "a", "r", "c", "h", or ".".Korece - genel analiz
Açıklama: Genel amaçlı Kore endüstrileri için uygun bir çözümleyicidir.
Not: Bu çözümleyici yalnızca TEXT ve SHORT_TEXT alan türlerine uygulanır.
Yalnızca özel teknik özelliklere sahip uygulamalar için kullanılabilir.
Örnek:
If the document field content is "인제군의교육", the tokenization result is "인제군 의 교육", and the document can be retrieved when you search for "인제군의교육", "의", or "교육".Korece - e-ticaret analizi
Açıklama: Kore e-ticaret endüstrisi için uygun bir çözümleyicidir.
Not: Bu çözümleyici yalnızca TEXT ve SHORT_TEXT alan türlerine uygulanır.
Yalnızca özel teknik özelliklere sahip uygulamalar için kullanılabilir.
Örnek:
If the document field content is "스포츠캐주얼신발", the tokenization result is "스포츠 캐주얼 신발", and the document can be retrieved when you search for "스포츠", "캐주얼", or "신발".Japonca - genel analiz
Açıklama: Genel amaçlı Japon endüstrileri için uygun bir çözümleyicidir.
Not: Bu çözümleyici yalnızca TEXT ve SHORT_TEXT alan türlerine uygulanır.
Yalnızca özel teknik özelliklere sahip uygulamalar için kullanılabilir.
Örnek:
If the document field content is "メキシコアグーチ", the tokenization result is "メキシコ アグーチ", and the document can be retrieved when you search for "メキシコ" or "アグーチ".Japonca - e-ticaret analizi
Açıklama: Japon e-ticaret endüstrisi için uygun bir çözümleyicidir.
Not: Bu çözümleyici yalnızca TEXT ve SHORT_TEXT alan türlerine uygulanır.
Yalnızca özel teknik özelliklere sahip uygulamalar için kullanılabilir.
Örnek:
If the document field content is "ラウンドネックスーツ", the tokenization result is "ラウンド ネック スーツ", and the document can be retrieved when you search for "ラウンド", "ネック", or "スーツ".Metin - özel çözümleyici
Açıklama: Özel müdahale girişleriyle birleştirilmiş bir endüstri çözümleyicisidir (genel analiz, e-ticaret analizi veya kişi adı analizi). Kullanımı hakkında daha fazla bilgi için bkz. Metin - özel çözümleyici.
Not: Bu çözümleyici yalnızca TEXT ve SHORT_TEXT alan türlerine uygulanır.
Analiz testi
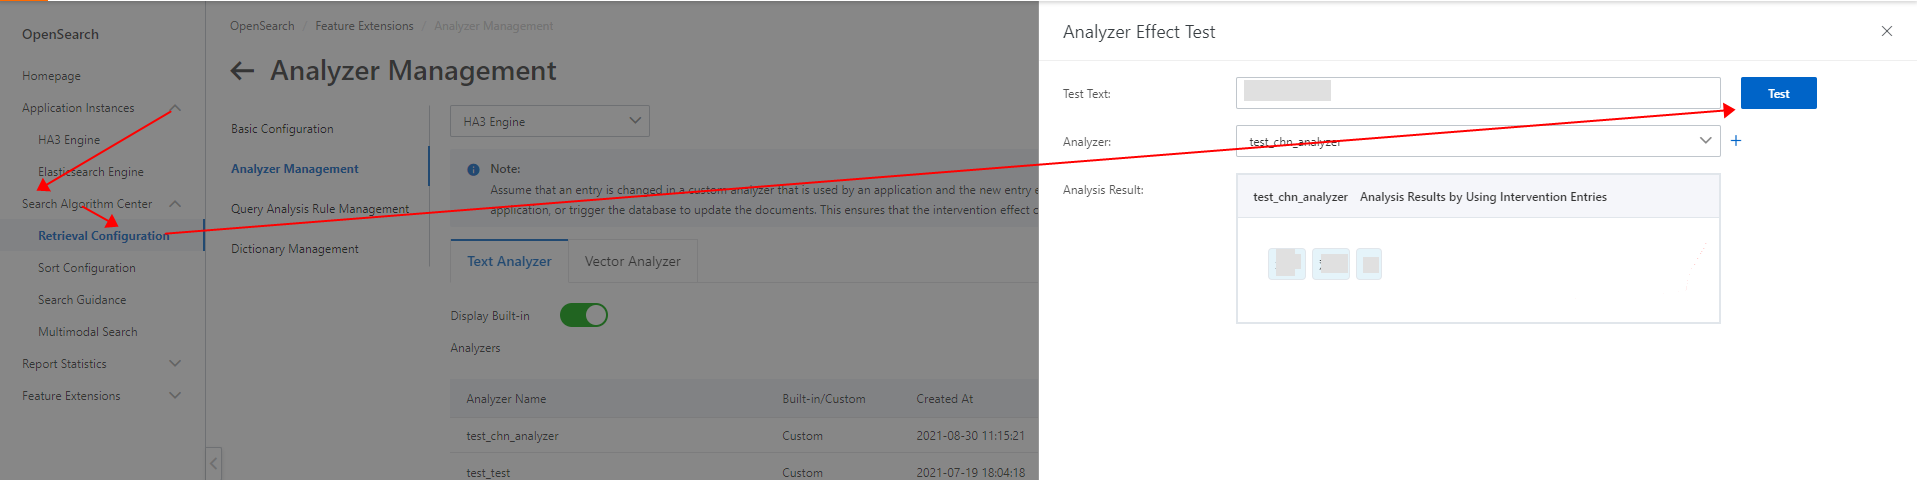
Endüstri çözümleyicilerinin ve özel çözümleyicilerin analiz sonuçlarını test etmek için analiz testi özelliğini kullanabilirsiniz. Uygulama konsolunun uygulama listesi sayfasına gidin ve bir çözümleyicinin analiz sonuçlarını test etmek için Search Algorithm Center -> Retrieval Configuration -> Analyzer Management -> Tokenization Test seçeneklerini seçin. Aşağıdaki şekilde gösterildiği gibi.
Genişletilmiş getirme birimleri
Getirme granülerliği açısından, bir çözümleyici iki tür getirme terimi üretir: temel getirme birimleri ve genişletilmiş getirme birimleri. Temel getirme birimleri, düzenli parçalama sonuçlarıdır. Genişletilmiş getirme birimleri, temel getirme birimlerinin ötesinde türetilen ek getirme terimleridir; yani, aynı metni "parçalamanın diğer makul yolları"dır. Örneğin, "\u7bee\u7403\u978b" metni için (Çince'de "basketbol ayakkabısı" anlamına gelir; bu bölümdeki Çince karakterler Unicode kaçış dizileri olarak gösterilmiştir, gerçek karakterleri girmeden önce bunların kodunu çözmeniz gerekir), temel getirme birimleri "\u7bee\u7403" (basketbol) ve "\u978b" (ayakkabı), genişletilmiş getirme birimi ise "\u7403\u978b" (spor ayakkabı) şeklindedir. Genişletilmiş getirme birimlerinin üretilip üretilmeyeceği, çözümleyicinin iç sözlüğünün yapılandırmasına bağlıdır.
Analyzer Effect Test iletişim kutusunda, Extended Retrieval Unit anahtarını açın ve Test düğmesine tıklayın. Analiz sonuçları daha sonra hem temel getirme birimlerini hem de genişletilmiş getirme birimlerini gösterir. Anahtar kapatıldığında yalnızca temel getirme birimleri gösterilir. Bu anahtarı kullanarak bir parçalamanın genişletilmiş getirme birimlerini tetikleyip tetiklemediğini kontrol edebilir, bu da beklenmeyen parçalama sonuçlarının giderilmesine yardımcı olur. Anahtar yalnızca test sonuçlarının nasıl görüntülendiğini etkiler ve gerçek getirmeyi etkilemez.
Anahtar kapalı: "\u7bee\u7403\u978b" test metninin analiz sonucu
\u7bee\u7403, \u978bşeklindedir.Anahtar açık: "\u7bee\u7403\u978b" test metninin analiz sonucu
\u7bee\u7403, \u7403\u978b, \u978bşeklindedir; burada "\u7403\u978b" genişletilmiş bir getirme birimidir.
Genişletilmiş getirme birimleri ve temel getirme birimleri, analiz sonuçlarında aynı stilde birlikte görüntülenir ve konsol bunları görsel olarak ayırt etmez. Anahtar durumu yalnızca test sonuçlarının nasıl görüntülendiğini etkiler. İletişim kutusunu kapattığınızda, anahtar varsayılan durumuna (kapalı) geri döner.
Genişletilmiş getirme birimleri beklenmeyen parçalama sonuçlarına neden olabilir. Örneğin, eksiksiz bir marka adı tek karakterlere bölünebilir. Bu durumda, ilgili kelimelerin bütünlüğünü korumak için müdahale girişleri eklemek üzere Metin - özel çözümleyici kullanabilirsiniz.
Senaryolar
Anlamsal bağlamda Çince arama için Çince anlamsal çözümleyiciyi kullanmanızı öneririz.
Kısa metinlerde veya anlamsal olmayan bağlamda (sıralama gereksinimleri az olan) Çince arama için, getirmeyi genişletmek amacıyla Çince tek karakterli çözümleyiciyi kullanmanızı öneririz.
Pinyin araması için yaklaşık çözümleyiciyi kullanın.
İngilizce senaryolar için İngilizce kök bulma çözümleyicisini kullanın.
Bazı senaryolarda, Çince anlamsal çözümleyici ile tek karakterli çözümleyicinin birlikte kullanılması mükemmel arama sonuçları sağlar. Örneğin, query=title_index:'\u83ca\u82b1\u8336' OR sws_title_index:'\u83ca\u82b1\u8336' sorgusunu (Çince karakterler Unicode kaçış dizileri olarak gösterilmiştir; kullanmadan önce kodlarını çözün; terim "krizantem çayı" anlamına gelir) text_relevance(title)*5+field_proximity(sws_title) ince sıralama ifadesiyle kullanın. Bu, "xx\u83caxx\u82b1xx\u8336xx" içeren belgeleri getirir ve "\u83ca\u82b1\u8336" içeren belgeler daha yüksek sırada yer alır.
Kullanım notları
-
Dizin alanları oluşturmak için kullanılabilecek alan türleri
INT, INT_ARRAY, TEXT, SHORT_TEXT, LITERAL, LITERAL_ARRAY, TIMESTAMP, GEO_POINT
Dizin alanları oluşturmak için kullanılamayan alan türleri
FLOAT, FLOAT_ARRAY, DOUBLE, DOUBLE_ARRAY
Bir TEXT alanı için arama sonucu özetleri yapılandırılmışsa, vurgulama etiketleri genişletilmiş getirme birimi olan bazı ifadelere eklenmez (bkz. Genişletilmiş getirme birimleri); örneğin, yukarıdaki "\u83ca\u82b1\u8336" örneğindeki "\u82b1\u8336" (Unicode kaçış dizilerini kullanmadan önce kodlarını çözün).
Çince tek karakterli çözümleyici, bir sayıyı veya İngilizce kelimeyi tek bir terim olarak değerlendirir. Örneğin, "hello word" için "hello" araması belgeyi getirir ancak "he" araması getirmez. Bir kelimenin bir kısmına göre belgeleri getirmeniz gerekiyorsa yaklaşık çözümleyiciyi kullanın.
Uygulama şemasındaki birincil tablonun birincil anahtarı varsayılan olarak bir dizin alanı olarak ayarlanır ve dizin alanı adı varsayılan olarak "id"dir. Bu yapılandırma değiştirilemez.