Bu konuda, MaxCompute için Information Schema hizmetinin temel kavramları, kullanımı ve sınırlamaları ele alınmaktadır.
MaxCompute'ün Information Schema özelliği, proje meta verilerini ve kullanım geçmişini sağlar. Bu özellik, ANSI SQL-92 Information Schema standardını MaxCompute hizmetine özel alanlar ve görünümlerle genişletir. Projelerinizin meta verilerini ve kullanım geçmişini almak için public projesindeki Information Schema altındaki salt okunur görünümleri sorgulayabilirsiniz.
Sınırlamalar
Information Schema, mevcut projeye yönelik bir meta veri görünümü sağlar ve proje çaprazı meta veri erişimini desteklemez. Birden çok projeden meta verileri sorgulamak ve analiz etmek için her projeden meta verileri ayrı ayrı alıp bunları birleştirin.
Meta veri sistem tabloları neredeyse gerçek zamanlı bir görünüm sunar. Çok güncel meta verilere ihtiyaç duyan uygulamalarda, belirli nesnelerin meta verilerini doğrudan almak için SDK veya CLI kullanın.
Meta veriler ve iş geçmişi Information Schema içinde saklanır. Anlık görüntü yedeklemeleri oluşturmak veya iş geçmişini 14 günden daha uzun süre korumak için Information Schema'daki verileri düzenli aralıklarla bir projeye yedekleyin.
Information Schema'yı etkinleştirin
1 Mart 2024'ten itibaren MaxCompute, yeni projeler için proje düzeyinde Information Schema'yı otomatik olarak yüklememektedir. Meta verileri sorgulamanız gerekiyorsa, daha kapsamlı bilgilere ulaşmak için kiracı düzeyindeki Information Schema'yı sorgulayabilirsiniz. Kiracı düzeyindeki Information Schema'nın nasıl kullanılacağı hakkında daha fazla bilgi için bakın: Kiracı düzeyinde Information Schema.
Mevcut MaxCompute projeleri için, projenin meta verilerine erişmek amacıyla bir Project Owner veya Super_Administrator rolüne sahip bir RAM kullanıcısının Information Schema izin paketini yüklemesi gerekir. Bir kullanıcıya yönetim rolü atama hakkında daha fazla bilgi için bakın: Kullanıcıya rol atama. Paketi aşağıdaki yöntemlerden biriyle yükleyebilirsiniz:
-
MaxCompute istemcisine giriş yapın ve aşağıdaki komutu çalıştırın:
install package Information_Schema.systables; -
DataWorks konsoluna giriş yapın ve Ad Hoc Query sayfasına gidin. Daha fazla bilgi için bakın: SQL deyimlerini çalıştırmak için ad hoc sorgu kullanma (isteğe bağlı). Aşağıdaki komutu çalıştırın:
install package Information_Schema.systables;
Paketi yüklemek, mevcut projenin Information Schema kullanarak kendi meta verilerini sorgulamasına izin verir. Bu veriler Information Schema projesinde saklanır ve depolama için ücret alınmaz.
Information Schema tarafından sağlanan görünümleri listelemek için aşağıdaki komutu çalıştırın.
odps@myproject1> describe package Information_Schema.systables;Aşağıdaki şekilde sorgu sonucu gösterilmektedir.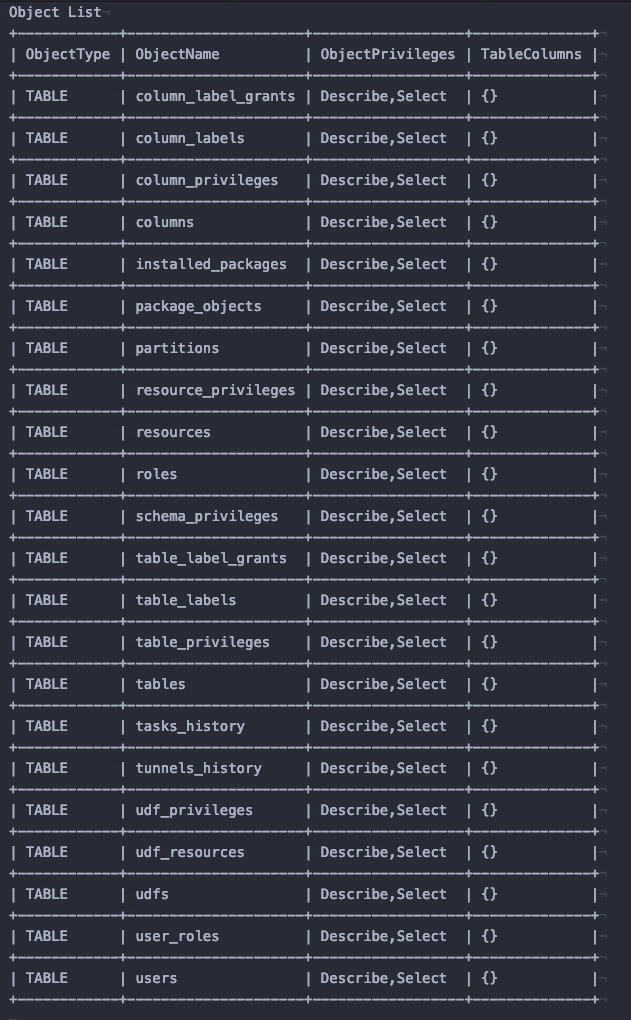
Meta veri görünümlerini sorgulayın
Bir meta veri görünümünü sorgulamak için görünüm adının önüne projenin Information Schema'sını ekleyin; örneğin, Information_Schema.view_name.
Örneğin, myproject1 projesindeki tüm tabloların meta verilerini sorgulamak için aşağıdaki komutu çalıştırın.
odps@myproject1>select * from Information_Schema.tables;Information Schema, mevcut projedeki iş geçmişini sorgulamak için iş geçmişi görünümleri de içerir. Sonuçları filtrelemek için tarih bölümü ekleyebilirsiniz.
odps@myproject1>select * from Information_Schema.tasks_history where ds='yyyymmdd' limit 100;Yetkilendirme
Information Schema'daki görünümler, proje düzeyindeki tüm kullanıcı verilerini içerir. Varsayılan olarak bu verilere yalnızca proje sahibi erişebilir. Diğer kullanıcıların veya rollerin erişmesi gerekiyorsa yetki verilmelidir. Daha fazla bilgi için bakın: Paket kullanarak projeler arasında kaynaklara erişme.
Yetkilendirme vermek için söz dizimi aşağıdaki gibidir:
grant <actions> on package Information_Schema.systables to user <user_name>;
grant <actions> on package Information_Schema.systables to role <role_name>;actions: Verilecek izin. Değer read olmalıdır.
-
user_name: Projedeki bir Alibaba Cloud hesabı veya RAM kullanıcısı.
Kullanıcı hesaplarını listelemek için MaxCompute istemcisinde
list users;komutunu çalıştırabilirsiniz. -
role_name: Projedeki bir rol.
Rol adlarını listelemek için MaxCompute istemcisinde
list roles;komutunu çalıştırabilirsiniz.
Örnek:
grant read on package Information_Schema.systables to user RAM$Bob@aliyun.com:user01;Meta veri görünümleri
Meta verileri sorgulamak için Information_Schema meta veri görünümlerini kullanın.
Information_Schema'daki bilgi görünümlerini kullanarak kaynak tüketimi, çalışma süresi ve işlenen veri miktarı gibi ölçümleri analiz edin; böylece işleri optimize edebilir veya kaynak kapasitesini planlayabilirsiniz.
Her görünümün belirli bir saklama süresi vardır; bu sürenin ardından verilere erişilemez. Geçmiş verileri daha uzun süre korumak için Information_Schema içinden yerel bir tabloya düzenli olarak aktarın.
Aşağıdaki faturalama kuralları geçerlidir:
Kullandıkça öde hesaplama kaynakları kullanan projelerde, Information Schema görünümleri üzerinde yapılan sorgular taranan veri miktarına göre ücretlendirilir. Sorgu performansını artırmak için bu görünümler, taranan veri miktarını azaltmak üzere
range clustered tablesile optimize edilmiştir. TASKS_HISTORY ve TUNNELS_HISTORY görünümlerini sorgularken taranan veriyi en aza indirmek ve ücretleri düşürmek için önceki günün verilerini saat 06:00:00'dan sonra sorgulayın ve o günün verilerini sorgulamaktan kaçının.Abonelik tabanlı hesaplama kaynakları kullanan projelerde, Information Schema görünümleri üzerinde yapılan sorgular satın aldığınız CU'ları tüketir.
Information Schema görünümleri için depolama ücreti alınmaz.
Verileri dışa aktarırken görünümdeki sütun adlarını açıkça seçin. Yeni sütunlar eklendiğinde yedekleme hatalarını önlemek için insert into select * from information_schema.*** kullanmaktan kaçının.
Bu tabloda meta veri görünümleri listelenmektedir.
Kategori | Görünüm | Güncellik ve saklama | Gecikme süresi |
Meta veri bilgileri | Neredeyse gerçek zamanlı görünüm | Bu görünümlerdeki veriler, çevrimiçi verilerin yaklaşık 3 saat gerisindedir. | |
Neredeyse gerçek zamanlı görünüm | |||
Neredeyse gerçek zamanlı görünüm | |||
Neredeyse gerçek zamanlı görünüm | |||
Neredeyse gerçek zamanlı görünüm | |||
Neredeyse gerçek zamanlı görünüm | |||
Neredeyse gerçek zamanlı görünüm | |||
Neredeyse gerçek zamanlı görünüm | |||
Neredeyse gerçek zamanlı görünüm | |||
Neredeyse gerçek zamanlı görünüm | |||
Neredeyse gerçek zamanlı görünüm | |||
Neredeyse gerçek zamanlı görünüm | |||
Neredeyse gerçek zamanlı görünüm | |||
Neredeyse gerçek zamanlı görünüm | |||
Neredeyse gerçek zamanlı görünüm | |||
Neredeyse gerçek zamanlı görünüm | |||
Neredeyse gerçek zamanlı görünüm | |||
Neredeyse gerçek zamanlı görünüm | |||
Neredeyse gerçek zamanlı görünüm | |||
Neredeyse gerçek zamanlı görünüm | |||
Kullanım bilgileri | Çalışan işlerin gerçek zamanlı anlık görüntüsü. | Bu görünüm saniye düzeyinde gecikme süresine sahiptir. Önizleme özelliği olarak SLA kapsamında değildir ve kademeli olarak sunulmaktadır. | |
Son 14 güne ait ayrıntıları saklayan neredeyse gerçek zamanlı bölümlenmiş tablo. | Bu görünümlerdeki verilerin gecikme süresi yaklaşık 3 saattir. | ||
Son 14 güne ait ayrıntıları saklayan neredeyse gerçek zamanlı bölümlenmiş tablo. |
Tables
Bir projedeki tablolarla ilgili ayrıntıları sağlar.
Sütun | Veri türü | Açıklama |
table_catalog | STRING | Değer sabit olarak |
table_schema | STRING | Proje adı. |
table_name | STRING | Tablo adı. |
table_type | STRING | Tablo türü. Geçerli değerler:
|
is_partitioned | BOOLEAN | Tablonun bölümlenmiş bir tablo olup olmadığını belirtir. |
owner_id | STRING | Tablo sahibinin ID'si. |
owner_name | STRING | İsteğe bağlı. Tablo sahibinin Alibaba Cloud hesap adı. |
create_time | DATETIME | Tablonun oluşturulma zamanı. |
last_modified_time | DATETIME | Tablo verilerinin en son değiştirilme zamanı. |
data_length | BIGINT | Bölümlenmemiş bir tablo için bu değer tablonun veri boyutudur. Bölümlenmiş bir tablo için MaxCompute toplam tablo boyutunu hesaplamadığından bu değer NULL olur. Her bölümün veri boyutunu PARTITIONS görünümünde bulabilirsiniz. Birim: bayt. |
table_comment | STRING | Tablo açıklaması. |
life_cycle | BIGINT | İsteğe bağlı. Tablonun yaşam döngüsü. |
is_archived | BOOLEAN | Gelecekteki kullanım için ayrılmıştır. |
table_exstore_type | STRING | Gelecekteki kullanım için ayrılmıştır. |
cluster_type | STRING | MaxCompute tablosunun kümeleme türü. Geçerli değerler HASH veya RANGE'dir. |
number_buckets | BIGINT | İsteğe bağlı. Kümelenmiş bir tablodaki paket sayısı. 0 değeri, MaxCompute'ün paket sayısını çalışma zamanında belirlediği anlamına gelir. |
view_original_text | STRING | VIRTUAL_VIEW türündeki tablolar için bu sütun, görünümü tanımlayan SQL deyimini içerir. |
MaxCompute konsolu tabloları boyuta göre sıralamayı desteklemez. Tabloları boyuta göre sorgulamak ve sıralamak veya depolama alanını yönetmek için Information Schema üzerinde SQL sorguları çalıştırın. Sorguları çalıştırmadan önce aşağıdaki komutla şema desteğini etkinleştirin:
SET odps.namespace.schema=true;-
Bölümlenmemiş tabloların boyutunu sorgulayın ve azalan düzende sıralayın:
SELECT * FROM SYSTEM_CATALOG.INFORMATION_SCHEMA.Tables ORDER by data_length DESC; -
Bölümlenmiş tablolardaki bölümlerin boyutunu sorgulayın ve azalan düzende sıralayın:
SELECT * FROM SYSTEM_CATALOG.INFORMATION_SCHEMA.PARTITIONS ORDER by data_length DESC;
Depolama alanını boşaltmak için büyük tabloları veya bölümleri belirlemek ve gerekli olmayan verileri silmek amacıyla sorgu sonuçlarını kullanın.
Bu SQL deyimlerini çalıştırırken bir izin hatası almanız, Information Schema'nın projenizde yüklü olmadığını veya gerekli proje düzeyindeki izinlere sahip olmadığınızı gösterir. Bu sorunu çözmek için yükleme ve izin verme talimatları için Information Schema hizmetini etkinleştirin bölümüne bakın. Daha kapsamlı meta verilere erişmek veya bu tür izin sorunlarından kaçınmak için kiracı düzeyindeki Information Schema'yı da yapılandırabilirsiniz.
Partitions
Bir projedeki tablo bölümlerini açıklar.
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Columns
Bir proje alanındaki tabloların sütunlarını açıklar.
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
UDFs
Projedeki UDF'ler hakkında bilgi sağlar.
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Resources
Projedeki kaynakların niteliklerini açıklar.
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
UDF_RESOURCES
Bir projedeki UDF'ler için kaynak bağımlılıklarını listeler.
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Users
Proje alanındaki kullanıcıların listesini sağlar.
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Roles
Aşağıdaki alanlar projedeki bir rolü tanımlar.
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
USER_ROLES
Projedeki kullanıcılara atanmış rolleri açıklar.
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
PACKAGE_OBJECTS
Bir proje içindeki bir Package'taki nesneleri açıklar.
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
INSTALLED_PACKAGES
Projede yüklü olan paketleri listeler.
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
SCHEMA_PRIVILEGES
Bir projedeki şemalar üzerindeki yetkileri listeler.
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
TABLE_PRIVILEGES
Bir projedeki tablolar üzerindeki yetkileri açıklar.
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
COLUMN_PRIVILEGES
Bir projedeki tablolar için sütun düzeyindeki yetkileri listeler.
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
UDF_PRIVILEGES
Bir projedeki UDF'ler üzerindeki yetkiler hakkında bilgi sağlar.
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Resource privileges
Projedeki kaynaklar için yetkileri listeler.
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Table labels
Projedeki tablolar için etiketleri listeler.
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
COLUMN_LABELS
Bir projedeki tablolar için sütun etiketleri hakkında bilgi sağlar.
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
TABLE_LABEL_GRANTS
TABLE_LABEL_GRANTS görünümü, projedeki tablolar üzerindeki etiket yetkilendirmelerini açıklar.
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
COLUMN_LABEL_GRANTS
Bir projedeki tablo sütunları için etiket atamalarını listeler.
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Tasks
Bu görünüm, canlı izleme için işlerin anlık görüntülerini sağlar.
TASKS görünümü şu anda özel ön izlemededir. Alanlar ve içerikleri değişebilir. Bu görünüm bir Hizmet Düzeyi Sözleşmesi (SLA) kapsamında değildir. Dikkatli kullanın. Yayın durumuyla ilgili güncellemeler için Duyurular bölümüne bakın.
Field | Type | Description |
project_name | STRING | Proje adı. |
task_name | STRING | İş adı. |
task_type | STRING | İş türü. Geçerli değerler:
|
inst_id | STRING | Örnek kimliği. |
status | STRING | Anlık görüntü alındığı sıradaki iş durumu. Geçerli değerler |
owner_id | STRING | İşi gönderen cloud hesabının kimliği. |
owner_name | STRING | İşi gönderen cloud hesabının adı. |
start_time | DATETIME | İşin başlangıç zamanı. |
priority | BIGINT | İşin önceliği. Bu sadece abonelik kaynaklarını kullanan işler için geçerlidir. |
signature | STRING | İşin imzası. |
queue_name | STRING | Hesaplama kuyruğunun adı. |
cpu_usage | BIGINT | Mevcut CPU kullanımı. Değer |
mem_usage | BIGINT | Mevcut bellek kullanımı (MB cinsinden). |
gpu_usage | BIGINT | Mevcut GPU kullanımı. Değer |
total_cpu_usage | BIGINT | Kümülatif CPU kullanımı. Değer |
total_mem_usage | BIGINT | Kümülatif bellek kullanımı. Değer |
total_gpu_usage | BIGINT | Kümülatif GPU kullanımı. Değer |
cpu_min_ratio | BIGINT | İşin mevcut CPU kullanımının hesaplama kuyruğunun garanti edilen kaynak düzeyine oranı. Bu sadece abonelik kaynaklarını kullanan işler için geçerlidir. |
mem_min_ratio | BIGINT | İşin mevcut bellek kullanımının hesaplama kuyruğunun garanti edilen kaynak düzeyine oranı. Bu sadece abonelik kaynaklarını kullanan işler için geçerlidir. |
gpu_min_ratio | BIGINT | İşin mevcut GPU kullanımının hesaplama kuyruğunun garanti edilen kaynak düzeyine oranı. Bu sadece abonelik kaynaklarını kullanan işler için geçerlidir. |
cpu_max_ratio | BIGINT | İşin mevcut CPU kullanımının hesaplama kuyruğunun maksimum esnek kaynak düzeyine oranı. Bu sadece abonelik kaynaklarını kullanan işler için geçerlidir. |
mem_max_ratio | BIGINT | İşin mevcut bellek kullanımının hesaplama kuyruğunun maksimum esnek kaynak düzeyine oranı. Bu sadece abonelik kaynaklarını kullanan işler için geçerlidir. |
gpu_max_ratio | BIGINT | İşin mevcut GPU kullanımının hesaplama kuyruğunun maksimum esnek kaynak düzeyine oranı. Bu sadece abonelik kaynaklarını kullanan işler için geçerlidir. |
settings | STRING | DataWorks gibi üst düzey hizmetlerden gelen özel zamanlama ayarları. |
additional_info | STRING | Ek bilgiler. Bu ayrılmış bir alandır. |
TASKS_HISTORY
Bir MaxCompute projesinde tamamlanan işlerin 14 günlük geçmişini içerir.
Field | Type | Value |
task_catalog | STRING | Sabit değer olarak |
task_schema | STRING | Proje adı. |
task_name | STRING | İş adı. |
task_type | STRING | İş türü. Geçerli değerler:
|
inst_id | STRING | Örnek kimliği. |
status | STRING | Veri toplama sırasındaki iş durumu (gerçek zamanlı değildir). Olası değerler:
|
owner_id | STRING | Hesap kimliği. |
owner_name | STRING | Cloud hesap adı. |
result | STRING | Yalnızca bir SQL işi başarısız olduğunda hata mesajıyla doldurulur. |
start_time | DATETIME | İşin başlangıç zamanı. |
end_time | DATETIME | İşin bitiş zamanı. Veri toplama sırasında iş hala çalışıyorsa bu değer NULL olur. |
input_records | BIGINT | İş tarafından okunan kayıt sayısı. |
output_records | BIGINT | İş tarafından yazılan kayıt sayısı. |
input_bytes | BIGINT | Taranan veri miktarı. Bu değer Logview'de gösterilen değerle eşleşir. |
output_bytes | BIGINT | Yazılan veri miktarı. |
input_tables | STRING | İş için giriş tabloları [proje.tablo1, proje.tablo2] biçiminde. SQLCost gibi belirli iş türleri için bu bilgi kullanılamayabilir. |
output_tables | STRING | İş için çıkış tabloları [proje.tablo1, proje.tablo2] biçiminde. |
operation_text | STRING | Sorgu ifadesinin source_xml değeri. Boyutu 256 KB'yi aşarsa bu alan NULL olur. |
signature | STRING | İsteğe bağlı. İş imzası. |
complexity | DOUBLE | İsteğe bağlı. İş karmaşıklığı. Bu alan yalnızca SQL işleri için kullanılabilir. |
cost_cpu | DOUBLE | İşin CPU maliyeti; burada 100, 1 çekirdek-saniyeyi temsil eder. Örneğin, bir iş 5 saniye boyunca 10 çekirdek kullanırsa cost_cpu değeri 10 × 100 × 5 = 5000 olur. |
cost_mem | DOUBLE | İşin bellek maliyeti (MB-saniye cinsinden). |
settings | STRING | Kullanıcı tarafından sağlanan veya zamanlayıcı tarafından iletilen JSON formatındaki ayarlar. USERAGENT, BIZID, SKYNET_ID ve SKYNET_NODENAME gibi alanları içerebilir. |
ds | STRING | Veri toplama tarihi. Örneğin, 20190101. |
TUNNELS_HISTORY
Bu görünüm, Tunnel kullanan toplu yükleme ve indirme işlemlerine ait geçmiş verileri içerir. Veriler 14 gün boyunca saklanır.
Parametre | Tür | Değer |
tunnel_catalog | STRING |
|
tunnel_schema | STRING | Proje adı. |
session_id | STRING | Oturum ID'si. Biçim şu şekildedir: |
operate_type | STRING | İşlem türü. Geçerli değerler:
|
tunnel_type | STRING | Tunnel türü. Geçerli değerler |
request_id | STRING | İstek ID'si. |
object_type | STRING | Nesne türü. Geçerli değerler |
object_name | STRING | Tablo adı veya örnek ID'si. |
partition_spec | STRING | Bölüm belirtimi. Örneğin, |
data_size | BIGINT | Bayt cinsinden veri boyutu. |
block_id | BIGINT | Bir Tunnel yüklemesi için blok ID'si. Bu alan yalnızca işlem türü |
offset | BIGINT | Bir indirme işlemi için başlangıç kaydını belirten, 0 tabanlı ofset. |
length | BIGINT | Yüklenen veya indirilen kayıt sayısı (kayıt sayısına eşdeğer). İndirme işlemleri için bu değeri kullanıcı belirtir. |
owner_id | STRING | Alibaba Cloud hesap ID'si. |
owner_name | STRING | Alibaba Cloud hesap adı. |
start_time | DATETIME | İstek başlangıç zamanı. |
end_time | DATETIME | İstek bitiş zamanı. |
client_ip | STRING | Tunnel isteğini başlatan istemci IP adresi. |
user_agent | STRING | Tunnel isteğini başlatan istemcinin User-Agent dizesi. Örneğin, bu dize Java sürümü ve işletim sistemi bilgilerini içerebilir. |
columns | STRING | Bir Tunnel indirme işlemi için belirtilen sütunlar. |
ds | STRING | Veri toplama tarihi. Örneğin, |
SSS
TABLE_ACCESS_INFO içindeki erişim sayısı
Hayır. TABLE_ACCESS_INFO içindeki erişim sayısı, bir işin okuma ve yazma gibi erişim işlemlerinin toplam sayısını ifade eder. Bu sayı belirli işlem türlerini ayırt etmez; bu nedenle sorgu sayısını ayrı olarak görüntüleyemezsiniz.