Hash Clustering tabloları verileri düzenlemek için karıştırma (shuffle) ve sıralama özelliklerini kullanır. MaxCompute bu özellikleri yürütme planlarını optimize etmek, verimliliği artırmak ve kaynak tasarrufu sağlamak amacıyla değerlendirir. Bu konuda MaxCompute'da Hash Clustering tablolarının nasıl kullanılacağı açıklanmaktadır.
Genel bilgiler
MaxCompute sorgularında tabloların birleştirilmesi yaygın bir senaryodur. Örneğin aşağıdaki sorgu basit bir iç birleştirme (inner join) işlemi gerçekleştirir. Sorgu t1 ve t2 tablolarını id sütunu üzerinden birleştirir.
SELECT t1.a, t2.b FROM t1 JOIN t2 ON t1.id = t2.id;MaxCompute birleştirmeleri uygulamak için üç temel yöntem kullanır:
-
Broadcast Hash Join
Birleştirmedeki tablolardan biri küçük olduğunda MaxCompute bu yöntemi kullanarak küçük tabloyu tüm birleştirme görev örneklerine yayınlar. Ardından büyük tablo ile hash join işlemi gerçekleştirir.
-
Shuffle Hash Join
Birleştirilecek tablolar büyükse yayınlanamazlar. Bunun yerine MaxCompute birleştirme anahtarına göre her iki tabloda da hash karıştırma (hash shuffle) işlemi uygular. Aynı anahtar değerine sahip kayıtlar aynı hash sonucunu üretir; bu sayede aynı anahtara sahip kayıtlar aynı birleştirme görev örneğine gönderilir. Her örnek daha küçük veri kümesi için bir hash tablosu oluşturur ve daha büyük veri kümesiyle sıralı okuma birleştirmesi yapar.
-
Sort Merge Join
Birleştirme tabloları çok büyük olduğunda hash tablosu oluşturmak için yeterli bellek kalmadığından Shuffle Hash Join yöntemi kullanılamaz. Bu yöntem önce birleştirme anahtarı üzerinde hash karıştırma işlemi uygulayıp verileri birleştirme anahtarına göre sıralar ardından birleştirmenin iki tarafını birleştirir. Aşağıdaki şekil bu süreci göstermektedir.
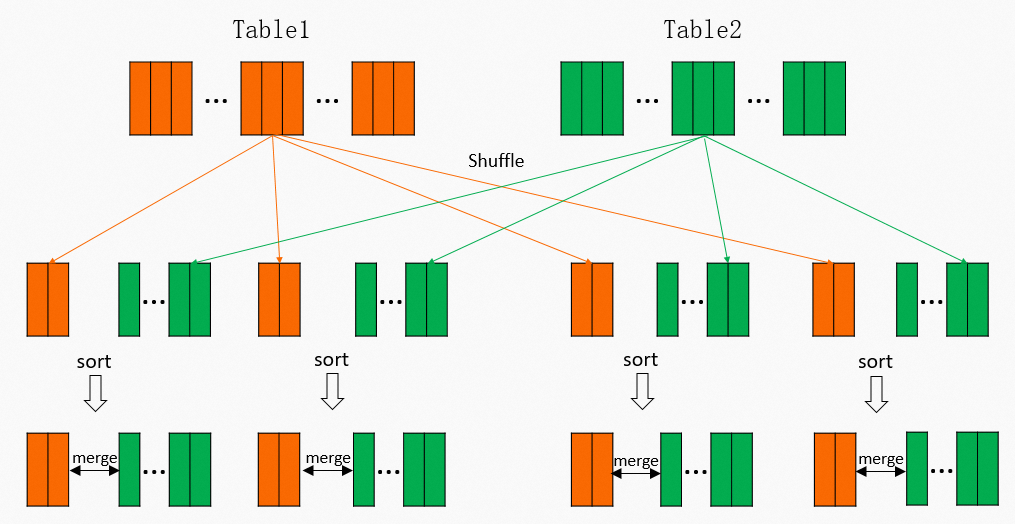 MaxCompute'da karşılaşılan tipik veri hacimleri ve ölçekler göz önüne alındığında Sort Merge Join çoğu durumda kullanılır. Ancak bu oldukça maliyetli bir işlemdir. Şekilde görüldüğü gibi karıştırma işlemi hesaplama gerektirir ve ara sonuçların diske yazılması gerekir. Sonraki reducer'ın bu verileri okuyup sıralaması gerekir.
Mmapper veRreducer içeren bir senaryoda bu durumM × RG/Ç okuma işlemi anlamına gelir. İlgili Fuxi fiziksel yürütme planı aşağıda gösterilmiştir. Bu plan iki Mapper aşaması ve bir Join aşaması gerektirir. Kırmızı kısımlar karıştırma ve sıralama işlemlerini belirtir.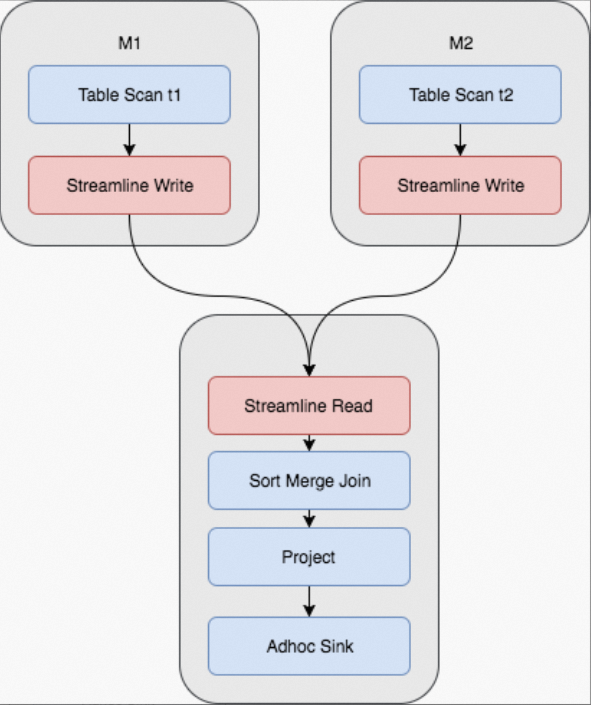 Ayrıca bazı birleştirmeler tekrarlı olarak gerçekleşebilir. Örneğin sorgu şu şekilde değiştirildiğinde:
SELECT t1.c, t2.d FROM t1 JOIN t2 ON t1.id = t2.id;Seçilen sütunlar farklı olsa da birleştirme işlemi aynıdır. Karıştırma ve sıralama sürecinin tamamı da değişmez.
Veya sorgu şu şekilde değiştirilirse:
SELECT t1.c, t3.d FROM t1 JOIN t3 ON t1.id = t3.id;Bu sorgu t1 ve t3 tablolarını birleştirir. t1 tablosu için karıştırma ve sıralama sürecinin tamamı yine aynı kalır.
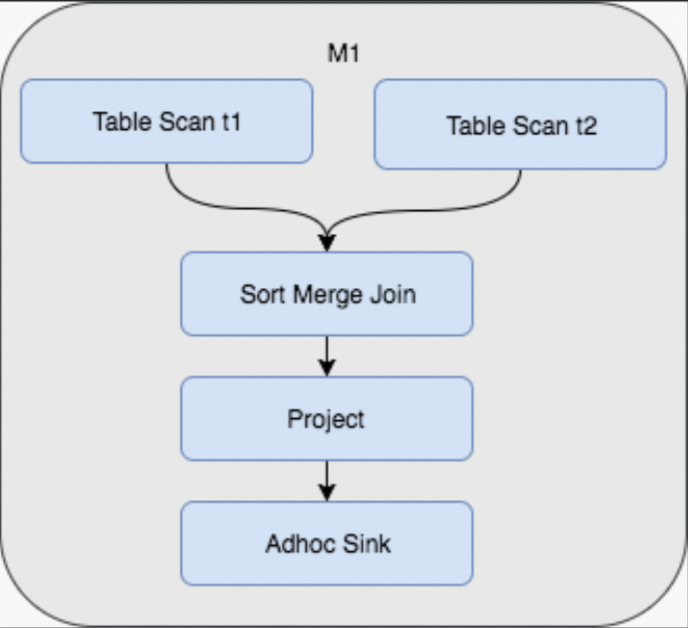
Bu nedenle başlangıçtaki tablo verileri hash karıştırma ve sıralama yöntemiyle depolanırsa sonraki sorgular verileri yeniden karıştırmaktan ve sıralamaktan kaçınabilir. Böylece tablo oluşturma sırasında tek seferlik bir maliyet ödenerek sonraki sorgularda tekrarlayan karıştırma ve birleştirme maliyetlerinden tasarruf edilir. Birleştirme işleminin Fuxi fiziksel yürütme planı aşağıdaki şekilde gösterildiği gibi değişir. Bu değişiklik yalnızca karıştırma ve sıralama işlemlerinden tasarruf sağlamakla kalmaz sorguyu üç aşamadan tek bir aşamaya düşürür.
Kullanım notları
Hash Clustering tablosu oluşturun
Bir Hash Clustering tablosu oluşturmak için aşağıdaki deyimi kullanabilirsiniz. Hash anahtarı olan bir kümeleme anahtarı ve hash paketlerinin sayısını belirtmeniz gerekir. Sıralama isteğe bağlıdır. Ancak en iyi performans için çoğu durumda sıralama anahtarını kümeleme anahtarıyla aynı ayarlamanız önerilir.
-
Sözdizimi
CREATE TABLE [IF NOT EXISTS] <table_name> [(<col_name> <data_type> [comment <col_comment>], ...)] [comment <table_comment>] [PARTITIONED BY (<col_name> <data_type> [comment <col_comment>], ...)] [CLUSTERED BY (<col_name> [, <col_name>, ...]) [SORTED BY (<col_name> [ASC | DESC] [, <col_name> [ASC | DESC] ...])] INTO <number_of_buckets> BUCKETS] [AS <select_statement>] -
Örnekler
-
Bölümlenmemiş tablo
CREATE TABLE T1 (a string, b string, c bigint) CLUSTERED BY (c) SORTED by (c) INTO 1024 BUCKETS; -
Bölümlenmiş tablo
CREATE TABLE T1 (a string, b string, c bigint)
       PARTITIONED BY (dt string)
       CLUSTERED BY (c)
       SORTED by (c) INTO 1024 BUCKETS;
-
-
Özellikler
-
CLUSTERED BY
Hash anahtarını belirtir. MaxCompute belirtilen sütunlarda hash işlemi gerçekleştirir ve verileri hash değerlerine göre paketlere dağıtır. Veri eğrilmesini önlemek, sıcak noktaların oluşmasını engellemek ve iyi bir paralel yürütme sağlamak için
CLUSTERED BYyan tümcesinde geniş bir değer aralığına sahip ve az yinelenen anahtar değeri içeren sütunları seçin. Birleştirmeleri optimize etmek için geleneksel veritabanlardaki birincil anahtarlara benzer şekilde sık kullanılan birleştirme veya toplama anahtarlarını da seçebilirsiniz. -
SORTED BY
Bir paket içindeki alanların sıralama düzenini belirtir. Daha iyi performans elde etmek için
SORTED BYanahtarınıCLUSTERED BYanahtarıyla aynı ayarlayın.SORTED BYyan tümcesi belirtildiğinde MaxCompute otomatik olarak bir dizin oluşturur ve bunu sorguları hızlandırmak için kullanır. -
INTO number_of_buckets BUCKETS
Hash paketlerinin sayısını belirtir. Bu sayı zorunludur ve veri hacmine bağlıdır. Paket sayısı arttıkça eşzamanlılık artar ve iş çalışma süreleri kısalabilir. Ancak çok fazla paket aşırı sayıda küçük dosya oluşturabilir ve yüksek eşzamanlılık CPU süresini artırabilir. Her paketin boyutunun 500 MB ile 1 GB arasında olacak şekilde paket sayısını ayarlamanız önerilir. Çok büyük tablolar için bu sayı daha büyük olabilir. Karıştırma ve sıralama adımlarını kaldırarak birleştirmeleri optimize etmek için iki tablonun paket sayısının birbirinin katı olması gerekir; örneğin
256ve512. Paket sayısı için 512, 1024, 2048 veya 4096 gibi 2'nin kuvveti olan bir sayı kullanmanız önerilir. Bu sistemin hash paketlerini otomatik olarak bölmesine ve birleştirmesine olanak tanır ayrıca karıştırma ve sıralama adımlarını kaldırır.
-
Tablonun Hash Clustering özelliklerini değiştirin
Bir bölümlemeli tablo için Hash Clustering özelliklerini eklemek veya kaldırmak üzere ALTER TABLE deyimini kullanabilirsiniz.
-
Deyimler
-- Change the table to a Hash Clustering table ALTER TABLE <table_name> [CLUSTERED BY (<col_name> [, <col_name>, ...]) [SORTED BY (<col_name> [ASC | DESC] [, <col_name> [ASC | DESC] ...])] INTO <number_of_buckets> BUCKETS]; -- Change a Hash Clustering table to a non-Hash Clustering table ALTER TABLE <table_name> NOT CLUSTERED; -
Notlar
ALTER TABLEdeyimi kümeleme özelliklerini yalnızca bölümlemeli tablolar için değiştirir. Bölümlenmemiş tablolar için kümeleme özellikleri ayarlandıktan sonra değiştirilemez.ALTER TABLEdeyimi yalnızca bölümlemeli tablonun yeni bölümlerini,INSERT OVERWRITEile oluşturulan bölümler dahil olmak üzere etkiler. Yeni bölümler yeni kümeleme özellikleriyle depolanır. Mevcut veri bölümleri değişmeden kalır.Deyim yalnızca yeni bölümleri etkilediğinden deyimde
PARTITIONyan tümcesini belirtmeyin.
ALTER TABLE deyimi mevcut tablolar için uygundur. Yeni kümeleme özellikleri eklendikten sonra yeni bölümler Hash Clustering kullanılarak depolanır.
Tablo özelliklerini doğrulayın
Bir Hash Clustering tablosu oluşturduktan sonra özelliklerini görüntülemek için aşağıdaki komutu çalıştırabilirsiniz. Hash Clustering özellikleri Extended Info bölümünde görüntülenir.
DESC EXTENDED <table_name>;Dönüş sonucuna bir örnek aşağıda verilmiştir.
| Owner: ALIYUN$                          | Project:
| TableComment:
|
| CreateTime:               2017-06-19 14:10:55
| LastDDLTime:              2017-06-19 14:10:55
| LastModifiedTime:         2017-06-19 14:13:13
|
| InternalTable: YES    | Size: 21680295746
|
| Native Columns:
|
| Field           | Type    | Label | Comment
|
| l_orderkey      | bigint  |       |
| l_partkey       | bigint  |       |
| l_suppkey       | bigint  |       |
| l_linenumber    | bigint  |       |
| l_quantity      | double  |       |
| l_extendedprice | double  |       |
| l_discount      | double  |       |
| l_tax           | double  |       |
| l_returnflag    | string  |       |
| l_linestatus    | string  |       |
| l_shipdate      | string  |       |
| l_commitdate    | string  |       |
| l_receiptdate   | string  |       |
| l_shipinstruct  | string  |       |
| l_shipmode      | string  |       |
| l_comment       | string  |       |
|
| Extended Info:
|
| TableID:
| IsArchived:          false
| PhysicalSize:        65040887238
| FileNum:             1001
| ClusterType:         hash
| BucketNum:           1000
| ClusterColumns:      [l_orderkey]
| SortColumns:         [l_orderkey ASC]
Bölümlenmiş bir tablo için tablo özelliklerini görüntüledikten sonra bölüm özelliklerini görüntülemek üzere aşağıdaki komutu çalıştırabilirsiniz.
DESC EXTENDED <table_name> partition(<pt_spec>);Dönüş sonucuna bir örnek aşağıda verilmiştir.
| PartitionSize: 754

| CreateTime:               2017-07-07 14:01:03
| LastDDLTime:              2017-07-07 14:01:03
| LastModifiedTime:         2017-07-07 14:01:03

| IsExstore:                false
| IsArchived:               false
| PhysicalSize:             2262
| FileNum:                  2
| ClusterType:              hash
| BucketNum:                500
| ClusterColumns:           [c1]
| SortColumns:              [c1 ASC]
Hash Clustering'in faydaları
Paket budama ve dizin optimizasyonu
CREATE TABLE t1 (id bigint,
                 a string,
                 b string)
             CLUSTERED BY (id)
             SORTED BY (id) into 1000 BUCKETS;
...
SELECT t1.a, t1.b FROM t1 WHERE t1.id=12345;idid
Sorgu
12345değeri için ilgili hash paketini bulur. Bu işlem 1.000 paketin tamamını taramak yerine yalnızca bir paketi taramayı gerektirir. Bu sürece paket budama (bucket pruning) denir.Paket içindeki veriler
idalanına göre sıralandığından MaxCompute otomatik olarak bir dizin oluşturur. MaxCompute ardından ilgili kayıtları doğrudan konumlandırmak için dizin araması kullanır.
Bu optimizasyon yalnızca mapper sayısını büyük ölçüde azaltmakla kalmaz mapper'ların dizini kullanarak veri sayfasını doğrudan konumlandırmasına da olanak tanır. Bu sayede yüklenen ve okunan veri miktarı önemli ölçüde azalır.
Örneğin büyük veri görevi 1.111 mapper başlatmış ve 26 eşleşen kaydı bulmak için 42,7 milyar kayıt okumuştur. Toplam çalışma süresi 1 dakika 48 saniyedir. Hash Clustering tablosu kullanıldığında aynı verideki aynı sorgu tek bir paketi doğrudan konumlandırabilir ve dizini kullanarak yalnızca sorgu verilerini içeren sayfaları okuyabilir. Bu işlem yalnızca 4 mapper kullanır 10.000 kayıt okur ve yalnızca 6 saniye sürer.
Toplama optimizasyonu
Aşağıdaki sorgu için:
SELECT department, SUM(salary) FROM employee GROUP BY (department);Genellikle bu sorgu department sütunundaki verileri karıştırıp sıralar ve ardından her bir department grubunu saymak için akış toplamı (stream aggregation) gerçekleştirir. Ancak tablo verileri zaten department alanına göre kümelenmiş ve sıralanmışsa karıştırma ve sıralama işlemlerine gerek kalmaz.
Depolama optimizasyonu
Hesaplama optimizasyonları göz önünde bulundurulmasa bile tablo verilerini depolama amacıyla karıştırıp sıralamak bile önemli ölçüde alan tasarrufu sağlar. MaxCompute alt katmanda sütun deposu kullanır. Sıralama aynı veya benzer anahtar değerlerine sahip kayıtları bir araya getirir. Bu durum sıkıştırma ve kodlamanın etkinliğini artırarak daha yüksek sıkıştırma oranlarına yol açar. Testlerde sıralı bir tablo bazı uç durumlarda sıralanmamış bir tabloya göre %50'ye kadar daha az depolama alanı kullanabilmektedir. Uzun yaşam döngüsüne sahip tablolar için depolama amacıyla Hash Clustering kullanımı değerli bir optimizasyondur.
Aşağıdaki deneyde TPC-H veri setinden 100 GB'lık lineitem tablosu kullanılmıştır. Tablo int, double ve string gibi çeşitli veri türleri içerir. Aynı veriler ve sıkıştırma yöntemi kullanılarak Hash Clustering uygulanan ve uygulanmayan bir tablonun depolama boyutu karşılaştırılmıştır. Aşağıdaki şekillerde gösterildiği gibi Hash Clustering uygulanan tablo yaklaşık %10 daha az depolama alanı kullanmıştır.
-
Hash Clustering olmadan
odps@xxx>desc tpch_lineitem; +------------------------------------------------------------------------------------+ | Owner: xxx | Project: xxx | | TableComment: | +------------------------------------------------------------------------------------+ | CreateTime: 2016-04-17 21:48:08 | | LastDDLTime: 2016-04-17 21:48:08 | | LastModifiedTime: 2016-04-17 21:50:10 | +------------------------------------------------------------------------------------+ | InternalTable: YES | Size: 23573055432 | +------------------------------------------------------------------------------------+ | Native Columns: | +------------------------------------------------------------------------------------+ | Field | Type | Label | Comment | +------------------------------------------------------------------------------------+ | l_orderkey | bigint | | | | l_partkey | bigint | | | | l_suppkey | bigint | | | | l_linenumber | bigint | | | | l_quantity | double | | | | l_extendedprice | double | | | | l_discount | double | | | | l_tax | double | | | | l_returnflag | string | | | | l_linestatus | string | | | | l_shipdate | string | | | | l_commitdate | string | | | | l_receiptdate | string | | | | l_shipinstruct | string | | | | l_shipmode | string | | | | l_comment | string | | | +------------------------------------------------------------------------------------+ -
Hash Clustering ile
odps@ xxx      >desc tpch_lineitem_hash_500;

| Owner:          xxx               | Project:    xxx
| TableComment:

| CreateTime:          2017-07-13 14:40:11
| LastDDLTime:         2017-07-13 14:40:11
| LastModifiedTime:    2017-07-13 15:05:04

| InternalTable: YES  | Size: 21658913950

| Native Columns:

| Field            | Type      | Label | Comment

| l_orderkey       | bigint    |       |
| l_partkey        | bigint    |       |
| l_suppkey        | bigint    |       |
| l_linenumber     | bigint    |       |
| l_quantity       | double    |       |
| l_extendedprice  | double    |       |
| l_discount       | double    |       |
| l_tax            | double    |       |
| l_returnflag     | string    |       |
| l_linestatus     | string    |       |
| l_shipdate       | string    |       |
| l_commitdate     | string    |       |
| l_receiptdate    | string    |       |
| l_shipinstruct   | string    |       |
| l_shipmode       | string    |       |
| l_comment        | string    |       |
Test verileri ve analiz
Hash Clustering'in genel performans faydaları standart TPC-H test seti kullanılarak ölçülmüştür. Testte 1 TB veri ve tüm tablolar için 500 paket kullanılmıştır. İki küçük tablo olan nation ve region hariç diğer tüm tablolar ilk sütunu kümeleme ve sıralama anahtarı olarak kullanmıştır. Genel test sonuçları Hash Clustering kullanıldıktan sonra toplam CPU süresinin yaklaşık %17,3 azaldığını ve toplam iş çalışma süresinin yaklaşık %12,8 azaldığını göstermektedir.
TPC-H'deki tüm sorguların kümeleme özelliğini kullanamayabileceğini unutmayın. Özellikle en uzun süren iki sorgu bu özelliği kullanamaz. Bu nedenle genel verimlilik artışı çarpıcı değildir. Ancak kümeleme özelliğini kullanabilen sorgular için faydalar önemlidir. Örneğin Q4 yaklaşık %68 daha hızlı Q12 yaklaşık %62 daha hızlı ve Q10 yaklaşık %47 daha hızlı çalışmıştır.
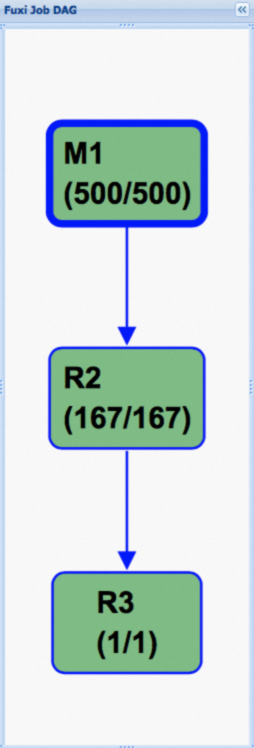
Aşağıdaki şekil standart bir tabloda TPC-H Q4 için Fuxi yürütme planını göstermektedir: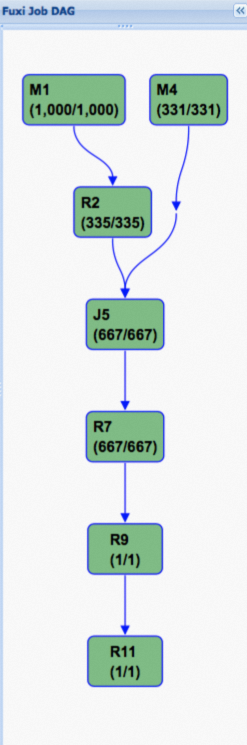 Aşağıdaki şekil Hash Clustering kullanıldıktan sonraki yürütme planını göstermektedir. Görüldüğü gibi Yönlendirilmiş Döngüsüz Çizge (DAG) büyük ölçüde sadeleşmiştir. Bu önemli performans iyileştirmesinin temel nedenidir.