Bu konu, Spark on MaxCompute geliştirme ortamının nasıl kurulacağını açıklar.
Windows işletim sistemi yüklüyse Windows geliştirme ortamı kurulumu bölümüne gidin.
Ön koşullar
Spark on MaxCompute geliştirme ortamını kurmadan önce Linux işletim sisteminizde aşağıdaki yazılımların yüklü olduğundan emin olun:
Bu konuda belirtilen yazılım sürüm numaraları ve yükleme yolları yalnızca referans amaçlıdır. İndirip yüklemeniz gereken gerçek yazılım sürümü, işletim sisteminize göre değişir.
-
JDK
Aşağıdaki örnek komutlar, Linux işletim sisteminde JDK'nın nasıl yükleneceğini gösterir. JDK paket adı duruma göre değişir.
sudo yum -y list java*komutunu çalıştırarak JDK paket adını öğrenebilirsiniz.sudo yum install -y java-1.8.0-openjdk-devel.x86_64 -
Python
Aşağıdaki örnek komutlar, Linux işletim sisteminde Python'ın nasıl yükleneceğini gösterir. Python paket adı duruma göre değişir.
# Obtain the Python package. sudo wget https://www.python.org/ftp/python/2.7.10/Python-2.7.10.tgz # Decompress the Python package. sudo tar -zxvf Python-2.7.10.tgz # Switch to the path to which the Python package is decompressed and specify the installation path. cd Python-2.7.10 sudo ./configure --prefix=/usr/local/python2 # Compile and install the Python package. sudo make sudo make install -
Maven
Aşağıdaki örnek komutlar, Linux işletim sisteminde Maven'ın nasıl yükleneceğini gösterir. Maven paketinin yolu duruma göre değişir.
# Obtain the Maven package. sudo wget https://dlcdn.apache.org/maven/maven-3/3.8.7/binaries/apache-maven-3.8.7-bin.tar.gz # Decompress the Maven package. sudo tar -zxvf apache-maven-3.8.7-bin.tar.gz -
Git
Aşağıdaki örnek komutlar, Linux işletim sisteminde Git'in nasıl yükleneceğini gösterir.
# Obtain the Git package.
sudo wget https://github.com/git/git/archive/v2.17.0.tar.gz
# Decompress the Git package.
sudo tar -zxvf v2.17.0.tar.gz
# Install the dependencies that are required for compiling the source code of Git.
sudo yum install curl-devel expat-devel gettext-devel openssl-devel zlib-devel gcc perl-ExtUtils-MakeMaker
# Switch to the path to which the Git package is decompressed.
cd git-2.17.0
# Compile the source code of Git.
sudo make prefix=/usr/local/git all
# Install Git in the /usr/local/git path.
sudo make prefix=/usr/local/git install
Spark on MaxCompute istemci paketini indirin ve paketi işletim sisteminize yükleyin
Spark on MaxCompute istemci paketi, MaxCompute kimlik doğrulama özelliği ile birlikte yayınlanır. Bu özellik, Spark on MaxCompute'un spark-submit betiğini kullanarak işleri MaxCompute projenize gönderen bir istemci olarak hizmet vermesini sağlar. MaxCompute; Spark 1.x, Spark 2.x ve Spark 3.x için yayın paketleri sunar. Bu paketleri aşağıdaki bağlantılardan indirebilirsiniz:
Spark-1.6.3: Spark 1.x uygulamaları geliştirmek için kullanılır.
Spark-2.3.0: Spark 2.x uygulamaları geliştirmek için kullanılır.
Spark-2.4.5: Spark 2.x uygulamaları geliştirmek için kullanılır. Spark 2.4.5 kullanımına ilişkin dikkat edilmesi gereken noktalar hakkında daha fazla bilgi için Spark 2.4.5 kullanımına ilişkin dikkat edilmesi gereken noktalar bölümüne bakın.
Spark-3.1.1: Spark 3.x uygulamaları geliştirmek için kullanılır. Spark 3.1.1 kullanımına ilişkin dikkat edilmesi gereken noktalar hakkında daha fazla bilgi için Spark 3.1.1 kullanımına ilişkin dikkat edilmesi gereken noktalar bölümüne bakın.
Spark on MaxCompute istemci paketini Linux işletim sisteminize yükleyin ve paketi açın. Spark on MaxCompute istemci paketinin bulunduğu dizine giderek paketi açmak için aşağıdaki komutu çalıştırabilirsiniz:
sudo tar -xzvf spark-2.3.0-odps0.33.0.tar.gzOrtam değişkenlerini yapılandırın
Bu bölümde ortam değişkenlerini yapılandırmak için kullanılan komutları yalnızca yönetici izinlerine sahip kullanıcılar çalıştırabilir.
Linux işletim sisteminizin CLI'sında ortam değişkenlerini yapılandırmanız gerekir. Aşağıdaki içerik, ortam değişkenlerinin nasıl yapılandırılacağını açıklar ve ilgili bilgileri sağlar.
-
Java ortam değişkenlerini yapılandırın.
-
Java yükleme yolunu bulun. Örnek komutlar:
# If you use yum to install Java, Java is installed in the /usr path by default. You can run the following command to query the Java installation path. If you use a custom installation path, the actual path prevails.
whereis java
ls -lrt /usr/bin/java
ls -lrt /etc/alternatives/java

# The following result is returned. In the result, /usr/lib/jvm/java-1.8.0-openjdk-1.8.0.322.b06-1.1.al7.x86_64 is the Java installation path.
/etc/alternatives/java -> /usr/lib/jvm/java-1.8.0-openjdk-1.8.0.322.b06-1.1.al7.x86_64/jre/bin/java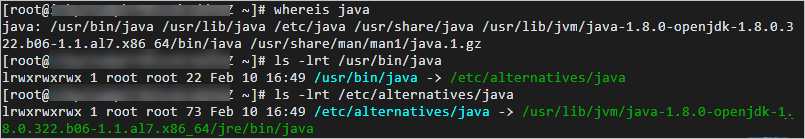
-
Java ortam değişkenlerini düzenleyin. Örnek komutlar:
# Edit the configuration file for environment variables.
vim /etc/profile

# Press i to enter the edit mode and add environment variables to the end of the configuration file.
# Set JAVA_HOME to the actual Java installation path.
export JAVA_HOME=/usr/lib/jvm/java-1.8.0-openjdk-1.8.0.322.b06-1.1.al7.x86_64
export CLASSPATH=.:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar
export PATH=$JAVA_HOME/bin:$PATH
# Press the Esc key to exit the edit mode and enter :wq to close the configuration file.

# Run the following command to make the modification take effect:
source /etc/profile

# Check whether the Java environment variables are successfully configured.
java -version
# The following result is returned:
openjdk version "1.8.0_322"
OpenJDK Runtime Environment (build 1.8.0_322-b06)
OpenJDK 64-Bit Server VM (build 25.322-b06, mixed mode)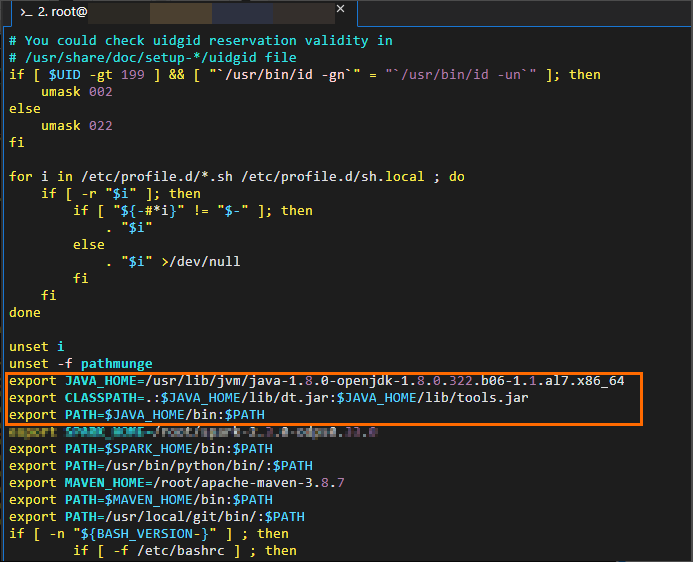
-
-
Spark ortam değişkenlerini yapılandırın.
Spark on MaxCompute istemci paketinin açıldığı dizini bulun. Aşağıdaki görselde dizinin
/home/spark-2.3.0-odps0.33.0olduğu gösterilmektedir. Açma dizini ve paket adı duruma göre değişir.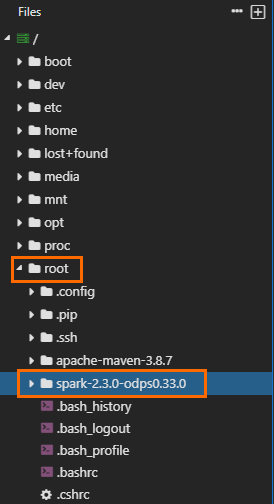
-
Spark ortam değişkenlerini düzenleyin. Örnek komutlar:
# Edit the configuration file for environment variables.
vim /etc/profile
# Press i to enter the edit mode and add environment variables to the end of the configuration file.
# Set SPARK_HOME to the actual path to which the Spark on MaxCompute client package is decompressed.
export SPARK_HOME=/home/spark-2.3.0-odps0.33.0
export PATH=$SPARK_HOME/bin:$PATH
# Press the Esc key to exit the edit mode and enter :wq to close the configuration file.

# Run the following command to make the modification take effect:
source /etc/profile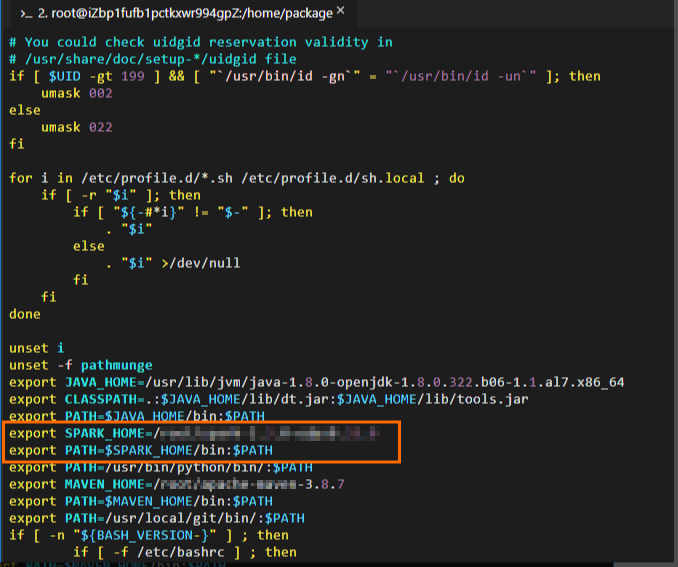
-
Python ortam değişkenlerini yapılandırın.
PySpark kullanıyorsanız Python ortam değişkenlerini yapılandırmanız gerekir.
Python yükleme yolunu bulun. Örnek komut:

-
Python ortam değişkenlerini düzenleyin. Örnek komutlar:
# Edit the configuration file for environment variables.
vim /etc/profile

# Press i to enter the edit mode and add environment variables to the end of the configuration file.
# Set PATH to the actual Python installation path.
export PATH=/usr/bin/python/bin/:$PATH
# Press the Esc key to exit the edit mode and enter :wq to close the configuration file.

# Run the following command to make the modification take effect:
source /etc/profile

# Check whether the Python environment variables are successfully configured.
python --version
# The following result is returned:
Python 2.7.5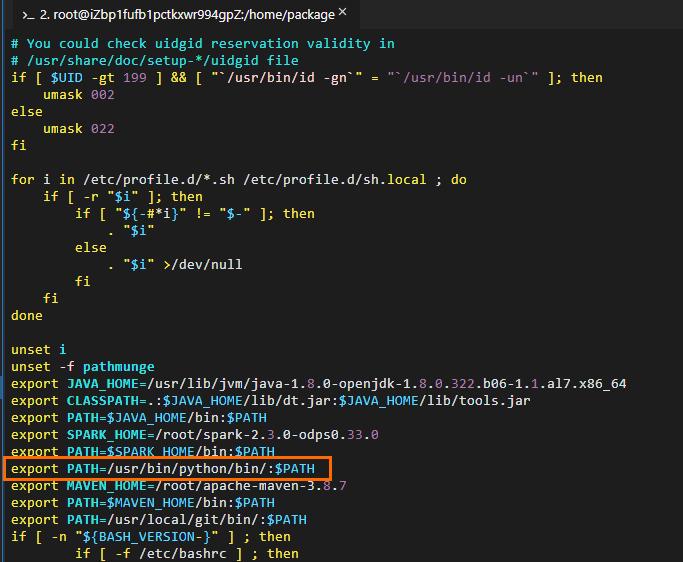
-
Maven ortam değişkenlerini yapılandırın.
Maven paketinin açıldığı dizini bulun. Aşağıdaki görselde dizinin
/home/apache-maven-3.8.7olduğu gösterilmektedir. Açma dizini ve paket adı duruma göre değişir.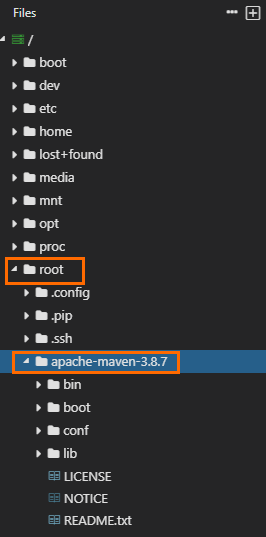
-
Maven ortam değişkenlerini düzenleyin. Örnek komutlar:
# Edit the configuration file for environment variables.
vim /etc/profile

# Press i to enter the edit mode and add environment variables to the end of the configuration file.
# Set MAVEN_HOME to the actual path to which the Maven package is decompressed.
export MAVEN_HOME=/home/apache-maven-3.8.7
export PATH=$MAVEN_HOME/bin:$PATH
# Press the Esc key to exit the edit mode and enter :wq to close the configuration file.
# Run the following command to make the modification take effect:
source /etc/profile

# Check whether the Maven environment variables are successfully configured.
mvn -version
# The following result is returned:
Apache Maven 3.8.7 (9b656c72d54e5bacbed989b64718c159fe39b537)
Maven home: /home/apache-maven-3.8.7
Java version: 1.8.0_322, vendor: Red Hat, Inc., runtime: /usr/lib/jvm/java-1.8.0-openjdk-1.8.0.322.b06-1.1.al7.x86_64/jre
Default locale: en_US, platform encoding: UTF-8
OS name: "linux", version: "4.19.91-25.1.al7.x86_64", arch: "amd64", family: "unix"
-
Git ortam değişkenlerini yapılandırın.
-
Git yükleme yolunu bulun. Örnek komutlar:
whereis git
-
Git ortam değişkenlerini düzenleyin. Örnek komutlar:
# Edit the configuration file for environment variables.
vim /etc/profile

# Press i to enter the edit mode and add environment variables to the end of the configuration file. # Set PATH to the actual Git installation path.
export PATH=/usr/local/git/bin/:$PATH
# Press the Esc key to exit the edit mode and enter :wq to close the configuration file.

# Run the following command to make the modification take effect:
source /etc/profile

# Check whether the Git environment variables are successfully configured.
git --version
# The following result is returned:
git version 2.24.4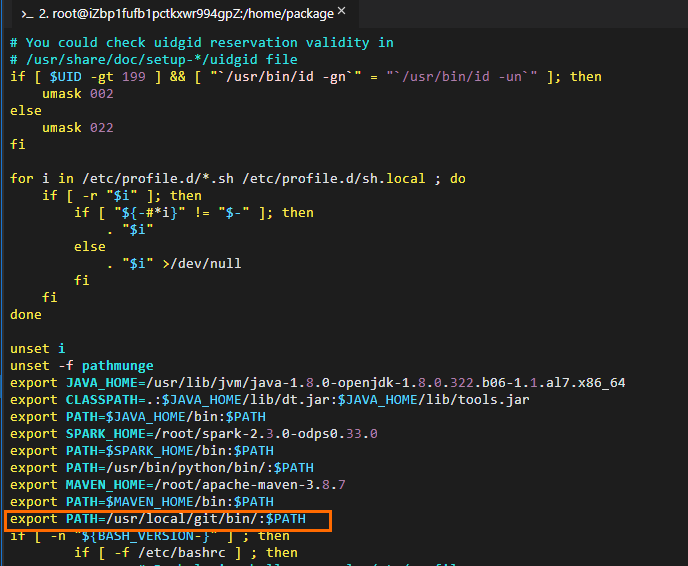
-
spark-defaults.conf dosyasını yapılandırın
Spark on MaxCompute istemcisini ilk kez kullanıyorsanız, Spark on MaxCompute istemci paketinin açılma yolundaki spark-defaults.conf.template dosyasının adını conf klasöründe spark-defaults.conf olarak değiştirin. Ardından dosyadaki bilgileri yapılandırın. Dosyanın adını değiştirmezseniz yapılandırma etkili olmaz. Örnek komutlar:
# Switch to the path to which the Spark on MaxCompute client package is decompressed and go to the conf folder. The actual path prevails.
cd /home/spark-2.3.0-odps0.33.0/conf

# Rename the spark-defaults.conf.template file.
mv spark-defaults.conf.template spark-defaults.conf

# Edit the spark-defaults.conf file.
vim spark-defaults.conf
# Press i to enter the edit mode and add the following configuration to the end of the configuration file.
spark.hadoop.odps.project.name = <MaxCompute_project_name>
spark.hadoop.odps.access.id = <AccessKey_id>
spark.hadoop.odps.access.key = <AccessKey_secret>
spark.hadoop.odps.end.point = <Endpoint>   # The endpoint that is used to connect the Spark on MaxCompute client to your MaxCompute project. You can modify the endpoint based on your business requirements. For more information, see Endpoint.
# For Spark 2.3.0, set spark.sql.catalogImplementation to odps. For Spark 2.4.5, set spark.sql.catalogImplementation to hive.
spark.sql.catalogImplementation={odps|hive}
# Retain the following configurations:
spark.hadoop.odps.task.major.version = cupid_v2
spark.hadoop.odps.cupid.container.image.enable = true
spark.hadoop.odps.cupid.container.vm.engine.type = hyper
spark.hadoop.odps.moye.trackurl.host = http://jobview.odps.aliyun.com-
MaxCompute_project_name: Erişmek istediğiniz MaxCompute projesinin adı.
Bu parametre, MaxCompute projesine karşılık gelen DataWorks çalışma alanı yerine MaxCompute projenizin adını belirtir. MaxCompute konsolu üzerinde oturum açın. Üst gezinme çubuğunda bir bölge seçin. Sol gezinme bölmesinde Workspace > Projects seçeneğine giderek MaxCompute projesinin adını görüntüleyin.
-
AccessKey_id: MaxCompute projesine erişmek için kullanılan AccessKey ID.
AccessKey ID'yi AccessKey Pair sayfasından alabilirsiniz.
-
AccessKey_secret: AccessKey ID'ye karşılık gelen AccessKey secret.
AccessKey secret'i AccessKey Pair sayfasından alabilirsiniz.
-
Endpoint: MaxCompute projenizin bulunduğu bölgenin genel uç noktası.
Her bölgenin genel uç noktası hakkında daha fazla bilgi için Bölgelere göre uç noktalar (İnternet) bölümüne bakın.
-
VPC_endpoint: MaxCompute projenizin bulunduğu bölgenin VPC uç noktası.
Her bölgenin VPC uç noktası hakkında daha fazla bilgi için Bölgelere göre uç noktalar (VPC) bölümüne bakın.
Diğer yapılandırma parametreleri özel senaryolar ve özellikler için gereklidir. Daha fazla bilgi için Spark on MaxCompute yapılandırma ayrıntıları bölümüne bakın.
Bir proje hazırlayın
Spark on MaxCompute, bir demo proje şablonu sağlar. Uygulamanızı geliştirmek için şablonu indirmenizi ve kopyalamanızı öneririz.
Demo projede, Spark on MaxCompute için bağımlılık kapsamı sağlanır. Bu kapsamı değiştirmeyin. Aksi takdirde, gönderdiğiniz iş beklendiği gibi çalışmayabilir.
Linux işletim sisteminde bir proje hazırlayın.
-
Spark 1.x şablonunu indirin ve derleyin.
git clone https://github.com/aliyun/MaxCompute-Spark.git cd MaxCompute-Spark/spark-1.x mvn clean package -
Spark 2.x şablonunu indirin ve derleyin.
git clone https://github.com/aliyun/MaxCompute-Spark.git cd MaxCompute-Spark/spark-2.x mvn clean package -
Spark 3.x şablonunu indirin ve derleyin.
git clone https://github.com/aliyun/MaxCompute-Spark.git
cd MaxCompute-Spark/spark-3.x
mvn clean package
Yukarıdaki komutları çalıştırdıktan sonra ortam yapılandırmalarının geçersiz olduğunu belirten bir hata mesajı görürseniz talimatları izleyerek yapılandırmaları kontrol edin. Geçersiz yapılandırmalar bulursanız bunları düzeltin.
Bağımlılıkları yapılandırın
Hazırladığınız Spark on MaxCompute projesinde bağımlılıkları yapılandırın. Örnek komutlar:
-
MaxCompute projenizdeki tablolara erişmek için gereken bağımlılıkları yapılandırın.
-
Spark-1.x şablonu kullanılır.
# Go to the spark-1.x folder. cd MaxCompute-Spark/spark-1.x # Edit the POM file to add the odps-spark-datasource dependency. <dependency> <groupId>com.aliyun.odps</groupId> <artifactId>odps-spark-datasource_2.10</artifactId> <version>3.3.8-public</version> </dependency> -
Spark-2.x şablonu kullanılır.
# Go to the spark-2.x folder.
cd MaxCompute-Spark/spark-2.x

# Edit the POM file to add the odps-spark-datasource dependency.
<dependency>
    <groupId>com.aliyun.odps</groupId>
    <artifactId>odps-spark-datasource_2.11</artifactId>
    <version>3.3.8-public</version>
</dependency>
-
-
Object Storage Service (OSS) erişimi için gereken bağımlılığı yapılandırın.
İşinizin OSS'ye erişmesi gerekiyorsa aşağıdaki bağımlılığı ekleyin:
<dependency>
    <groupId>com.aliyun.odps</groupId>
    <artifactId>hadoop-fs-oss</artifactId>
    <version>3.3.8-public</version>
</dependency>
Spark-1.x, Spark-2.x veya Spark-3.x şablonu kullanıldığında gereken bağımlılıklar hakkında daha fazla bilgi için Spark-1.x pom, Spark-2.x pom veya Spark-3.x pom bölümlerine bakın.
Harici dosyalara başvurun
Aşağıdaki türlerdeki Spark işlerini geliştiriyorsanız harici dosyalara başvurmanız gerekir:
Belirli yapılandırma dosyalarından veri okuması gereken Spark işleri.
JAR dosyaları veya Python kütüphaneleri gibi ek kaynak paketleri veya üçüncü taraf kütüphaneleri gerektiren Spark işleri.
Pratik uygulamada, dosyalara başvurmadan önce harici dosyaları yüklemeniz gerekir. Harici dosyaları aşağıdaki yöntemlerden birini kullanarak yükleyebilirsiniz:
-
Yöntem 1: Harici dosyaları Spark parametrelerini kullanarak yükleyin.
Spark on MaxCompute, Apache Spark tarafından tanımlanan şu parametreleri destekler:
--jars,--py-files,--filesve--archives. İşleri gönderirken bu parametreleri yapılandırarak harici dosyaları yükleyebilirsiniz. İşleri çalıştırdığınızda bu harici dosyalar çalışma dizinlerinize yüklenir.-
Spark on MaxCompute istemcisinde dosya yüklemek için spark-submit betiğini kullanın.
Not--jars: Bu parametre, sürücünün ve her yürütücünün geçerli çalışma dizinlerine yüklemek istediğiniz JAR paketlerini belirtir. Paket adları virgül (,) ile ayrılır. Bu JAR paketleri, sürücünün ve her yürütücünün sınıf yollarına eklenir. Bu paketleri belirtmek için Spark işlerinin yapılandırmalarında"./your_jar_name"kullanabilirsiniz. Bu durum Apache Spark'ta da geçerlidir.--filesve--py-files: Bu iki parametre, sürücünün ve her yürütücünün geçerli çalışma dizinlerine yüklemek istediğiniz ortak dosyaları veya Python dosyalarını belirtir. Dosya adları virgül (,) ile ayrılır. Bu dosyaları belirtmek için Spark işlerinin yapılandırmalarında"./your_file_name"kullanabilirsiniz. Bu durum Apache Spark'ta da geçerlidir.--archives: Bu parametre, Apache Spark tarafından tanımlanan parametreden biraz farklıdır. Bu parametreyixxx#yyybiçiminde yapılandırın ve dosya adlarını virgül (,) ile ayırın. --archives parametresini yapılandırdıktan sonra belirttiğiniz arşiv dosyaları (ZIP dosyaları gibi) sürücünün ve her yürütücünün geçerli çalışma dizinlerinin alt dizinlerine açılır. Örneğin, bu parametrexx.zip#yyolarak ayarlanırsa arşiv dosyasındaki içeriğe başvurmak için"./yy/xx/"kullanmanız gerekir. Bu parametrexx.zipolarak ayarlanırsa arşiv dosyasındaki içeriğe başvurmak için"./xx.zip/xx/"kullanmanız gerekir. Arşiv dosyasını doğrudan geçerli çalışma dizinine açmak için"./xxx/"kullanmanız gerekiyorsaspark.hadoop.odps.cupid.resourcesparametresini kullanmanız gerekir.
-
Bir iş için gereken kaynakları eklemek üzere DataWorks'ü kullanın. Daha fazla bilgi için MaxCompute kaynakları oluşturma ve kullanma bölümüne bakın.
NotDataWorks konsolunda boyutu en fazla 200 MB olan dosyaları yükleyebilirsiniz. Yüklemek istediğiniz dosyaların boyutu 200 MB'ı aşarsa bu dosyaları MaxCompute kaynağı olarak yüklemek ve bunları DataWorks konsolundaki DataStudio sayfasına eklemek için MaxCompute istemcisi kullanmanız gerekir. MaxCompute kaynakları hakkında daha fazla bilgi için MaxCompute kaynaklarını yönetme bölümüne bakın.
-
-
Yöntem 2: Dosyaları MaxCompute kaynağı olarak yükleyin.
Spark on MaxCompute,
spark.hadoop.odps.cupid.resourcesparametresini sağlar. Bu parametre, MaxCompute'daki kaynaklara doğrudan başvurmanıza olanak tanır. Bir işi çalıştırdığınızda başvurulan kaynaklar çalışma dizinlerinize yüklenir. Dosyaları MaxCompute kaynağı olarak yüklemek için aşağıdaki adımları uygulayın:MaxCompute istemcisine giriş yapın ve dosyaları kaynak olarak MaxCompute projenize yükleyin. Yükleyebileceğiniz bir dosyanın maksimum boyutu 500 MB'dır.
-
Spark işinizin yapılandırmalarına
spark.hadoop.odps.cupid.resourcesparametresini ekleyin. Bu parametre, Spark işini çalıştırmak için gereken MaxCompute kaynaklarını belirtir. Bu parametreyi<projectname>.<resourcename>biçiminde yapılandırın. Birden çok dosyaya başvurmanız gerekiyorsa dosya adlarını virgül (,) ile ayırın. Aşağıdaki yapılandırma bir örneği göstermektedir.spark.hadoop.odps.cupid.resources=public.python-python-2.7-ucs4.zip,public.myjar.jarBelirtilen kaynak dosyası, sürücünün ve her yürütücünün geçerli çalışma dizinlerine indirilir. İndirilen dosya varsayılan olarak
<projectname>.<resourcename>biçiminde adlandırılır.Dosyayı
<projectname>.<resourcename>:<newresourcename>biçiminde yeniden adlandırabilirsiniz. Aşağıdaki yapılandırma bir örneği göstermektedir.spark.hadoop.odps.cupid.resources=public.myjar.jar:myjar.jarÖnemlispark.hadoop.odps.cupid.resources parametresi yalnızca bu parametreyi spark-defaults.conf dosyasında veya DataWorks konsolunda yapılandırdığınızda etkili olur. Bu parametre kodda yazılırsa etkili olmaz.
Dosyaları yukarıdaki yöntemlerden birini kullanarak yükledikten sonra kodda harici dosyalara başvurabilirsiniz. Aşağıdaki kod bir örneği gösterir:
val targetFile = "File name"
val file = Source.fromFile(targetFile)
for (line <- file.getLines)
    println(line)
file.close
SparkPi duman testi gerçekleştirin
Yukarıdaki işlemleri tamamladıktan sonra Spark on MaxCompute'un uçtan uca bağlantısını kontrol etmek için duman testi gerçekleştirin. Örneğin, bir Spark 2.x uygulaması için SparkPi duman testi gerçekleştirmek üzere aşağıdaki komutları çalıştırabilirsiniz:
# /path/to/MaxCompute-Spark Configure a valid path for the compiled JAR package of the application.
cd $SPARK_HOME
bin/spark-submit \
--class com.aliyun.odps.spark.examples.SparkPi \
--master yarn \
--deploy-mode cluster \
/path/to/your/spark-examples_2.11-1.0.0-SNAPSHOT-shaded.jar

# If the following log information is displayed, smoke testing is successful.
19/06/11 11:57:30 INFO Client:
         client token: N/A
         diagnostics: N/A
         ApplicationMaster host: 11.222.166.90
         ApplicationMaster RPC port: 38965
         queue: queue
         start time: 1560225401092
         final status: SUCCEEDED
IntelliJ IDEA kullanarak yerel modda Spark on MaxCompute çalıştırma notları
Çoğu durumda, kod yerel hata ayıklama başarılı olduktan sonra küme modunda çalıştırılır. Ancak Spark on MaxCompute, IntelliJ IDEA kullanarak kodu yerel modda çalıştırmanıza olanak tanır. IntelliJ IDEA kullanarak kodu yerel modda çalıştırırken aşağıdaki noktalara dikkat edin:
-
Kodda spark.master parametresini belirtin.
val spark = SparkSession .builder() .appName("SparkPi") .config("spark.master", "local[4]") // The code can run after you set spark.master to local[N]. N indicates the number of concurrent Spark jobs. .getOrCreate() -
IntelliJ IDEA'ya aşağıdaki Spark on MaxCompute istemci bağımlılığını ekleyin.
<dependency>
    <groupId>org.apache.spark</groupId>
    <artifactId>spark-core_${scala.binary.version}</artifactId>
    <version>${spark.version}</version>
    <scope>provided</scope>
</dependency>
pom.xml dosyasında scope parametresi provided olarak ayarlanır. Bu ayar, kodu çalıştırdığınızda "NoClassDefFoundError" hatasına neden olabilir.
Exception in thread "main" java.lang.NoClassDefFoundError: org/apache/spark/sql/SparkSession$
    at com.aliyun.odps.spark.examples.SparkPi$.main(SparkPi.scala:27)
    at com.aliyun.odps.spark.examples.Spa. r. kPi.main(SparkPi.scala)
Caused by: java.lang.ClassNotFoundException: org.apache.spark.sql.SparkSession$
    at java.net.URLClassLoader.findClass(URLClassLoader.java:381)
    at java.lang.ClassLoader.loadClass(ClassLoader.java:424)
    at sun.misc.Launcher$AppClassLoader.loadClass(Launcher.java:335)
    at java.lang.ClassLoader.loadClass(ClassLoader.java:357)
    ... 2 more
Aşağıdaki adımları uygulayarak IntelliJ IDEA proje şablonuna Spark on MaxCompute üzerindeki --jars parametresiyle belirtilen dizini manuel olarak ekleyebilirsiniz. Bu şekilde,
scope=providedyapılandırması korunabilir ve IntelliJ IDEA kullanarak yerel modda kodu çalıştırdığınızda "NoClassDefFoundError" hatası alınmaz.IntelliJ IDEA ana menü çubuğunda File > Project Structure… seçeneğine gidin.
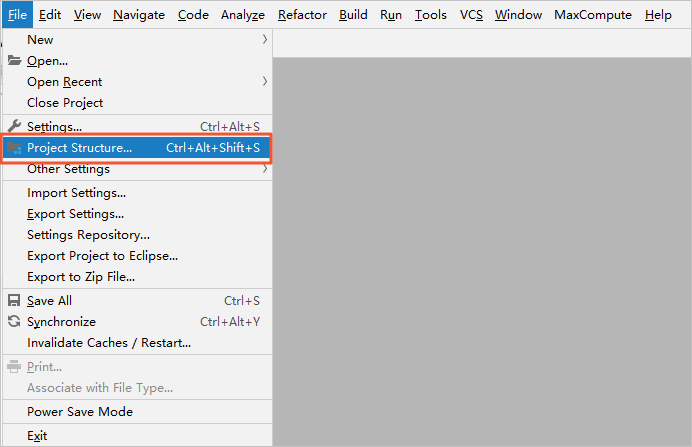
Project Structure sayfasında sol gezinme bölmesinden Modules seçeneğine tıklayın. Ardından kaynak paketini seçin ve kaynak paketi için Dependencies sekmesine tıklayın.
Dependencies sekmesinde sol alt köşedeki artı işaretine (+) tıklayın ve Spark on MaxCompute üzerindeki --jars parametresiyle belirtilen dizini eklemek için JARs or directories… seçeneğini belirleyin.
-
spark-defaults.conf dosyasına kodu yerel modda çalıştırırken doğrudan başvurulamaz. İlgili parametreleri kodda manuel olarak yapılandırmanız gerekir.
İşleri spark-submit betiğini kullanarak gönderirseniz sistem yapılandırmaları spark-defaults.conf dosyasından okur. İşleri yerel modda gönderirseniz ilgili parametreleri kodda manuel olarak yapılandırmanız gerekir. Aşağıdaki kod, yerel modda MaxCompute tablolarından veri okumak için Spark SQL'in nasıl kullanılacağını gösterir.
val spark = SparkSession
      .builder()
      .appName("SparkPi")
      .config("spark.master", "local[4]") // The code can run after you set spark.master to local[N]. N indicates the number of concurrent Spark jobs.
      .config("spark.hadoop.odps.project.name", "****")
      .config("spark.hadoop.odps.access.id", "****")
      .config("spark.hadoop.odps.access.key", "****")
      .config("spark.hadoop.odps.end.point", "http://service.cn.maxcompute.aliyun.com/api")
      .config("spark.sql.catalogImplementation", "odps")
      .getOrCreate()
Spark 2.4.5 kullanımına ilişkin dikkat edilmesi gereken noktalar
-
Spark 2.4.5 kullanarak iş gönderme
Bir Yarn kümesinde iş gönderin. Daha fazla bilgi için Küme modu bölümüne bakın.
DataWorks konsolunda
spark.hadoop.odps.spark.versionparametresini spark-2.4.5-odps0.33.0 olarak ayarlayın. DataWorks'teki özel kaynak gruplarının Spark sürümü Spark 2.4.5'e güncellenmemişse işleri zamanlamak için paylaşılan kaynak gruplarını kullanabilir veya Spark sürümünü güncellemek için MaxCompute teknik destek ekibiyle iletişime geçebilirsiniz.
-
Spark 2.4.5 kullanımı değişiklikleri
Bir Yarn kümesinde iş gönderiyorsanız SPARK_HOME ortam değişkenini eklemek için
export HADOOP_CONF_DIR=$SPARK_HOME/confkomutunu çalıştırmanız gerekir.-
Yerel modda hata ayıklama yapıyorsanız
$SPARK_HOME/confyolunda odps.conf adlı bir dosya oluşturmanız ve aşağıdaki yapılandırmaları dosyaya eklemeniz gerekir:odps.project.name = odps.access.id = odps.access.key = odps.end.point =
-
Spark 2.4.5 parametre ayarları değişiklikleri
spark.sql.catalogImplementation: Bu parametrehiveolarak ayarlanır.spark.sql.sources.default: Bu parametrehiveolarak ayarlanır.spark.sql.odps.columnarReaderBatchSize: Vektörleştirilmiş okuyucunun tek seferde kaç satır veri okuduğunu belirtir. Varsayılan değer: 4096.spark.sql.odps.enableVectorizedReader: Vektörleştirilmiş okuyucunun etkin olup olmadığını belirtir. Varsayılan değer: True.spark.sql.odps.enableVectorizedWriter: Vektörleştirilmiş yazıcının etkin olup olmadığını belirtir. Varsayılan değer: True.spark.sql.odps.split.size: Bu parametre, MaxCompute tablolarındaki veri okuma işlemlerinin eşzamanlılığını ayarlamak için kullanılabilir. Varsayılan olarak bu parametre her bölüm için 256 olarak ayarlanır. Birim: MB.
Spark 3.1.1 kullanımına ilişkin dikkat edilmesi gereken noktalar
-
Spark 3.1.1 kullanarak iş gönderme
Bir Yarn kümesinde iş gönderin. Daha fazla bilgi için Küme modu bölümüne bakın.
-
3.1.1 sürümündeki Spark işlerini göndermek istiyorsanız ve işler Scala veya Java ile yazılmışsa spark-defaults.conf dosyasına aşağıdaki yapılandırmaları ekleyebilirsiniz:
spark.hadoop.odps.cupid.resources = public.__spark_libs__3.1.1-odps0.33.0.zip,[projectname].[Main JAR Package],[projectname].[Other JAR Package] spark.driver.extraClassPath = ./public.__spark_libs__3.1.1-odps0.33.0.zip/* spark.executor.extraClassPath = ./public.__spark_libs__3.1.1-odps0.33.0.zip/*Not3.1.1 sürümündeki Spark işlerini göndermek istiyorsanız gerekli tüm kaynakları spark.hadoop.odps.cupid.resources parametresinde belirtmeniz gerekir. Gerekli kaynaklar ana JAR paketini içerir. Aksi takdirde ilgili Java sınıfı bulunamayabilir.
Yukarıdaki yöntemleri kullanarak PySpark işleri gönderemezsiniz.
-
Spark 3.1.1 kullanımı değişiklikleri
Bir Yarn kümesinde iş gönderiyorsanız SPARK_HOME ortam değişkenini eklemek için
export HADOOP_CONF_DIR=$SPARK_HOME/confkomutunu çalıştırmanız gerekir.-
Bir Yarn kümesinde PySpark işleri gönderiyorsanız Python 3 için Spark kullanmak amacıyla spark-defaults.conf dosyasına aşağıdaki yapılandırmaları eklemeniz gerekir:
spark.hadoop.odps.cupid.resources = public.python-3.7.9-ucs4.tar.gz spark.pyspark.python = ./public.python-3.7.9-ucs4.tar.gz/python-3.7.9-ucs4/bin/python3 -
Yerel modda hata ayıklama yapıyorsanız aşağıdaki işlemleri gerçekleştirmeniz gerekir:
-
$SPARK_HOME/confdizininde bir odps.conf dosyası oluşturmanız ve aşağıdaki yapılandırmaları dosyaya eklemeniz gerekir:odps.project.name = odps.access.id = odps.access.key = odps.end.point = -
Koda
spark.hadoop.fs.defaultFS = file:///eklemeniz gerekir. Örnek kod:val spark = SparkSession .builder() .config("spark.hadoop.fs.defaultFS", "file:///") .enableHiveSupport() .getOrCreate()
-
-
Spark 3.1.1 parametre ayarları değişiklikleri
spark.sql.defaultCatalog: Bu parametreodpsolarak ayarlanır.spark.sql.catalog.odps: Bu parametreorg.apache.spark.sql.execution.datasources.v2.odps.OdpsTableCatalogolarak ayarlanır.spark.sql.sources.partitionOverwriteMode: Bu parametredynamicolarak ayarlanır.spark.sql.extensions: Bu parametreorg.apache.spark.sql.execution.datasources.v2.odps.extension.OdpsExtensionsolarak ayarlanır.spark.sql.odps.enableVectorizedReader: Vektörleştirilmiş okuyucunun etkin olup olmadığını belirtir. Varsayılan değer: True.spark.sql.odps.enableVectorizedWriter: Vektörleştirilmiş yazıcının etkin olup olmadığını belirtir. Varsayılan değer: True.spark.sql.catalog.odps.splitSizeInMB: Bu parametre, MaxCompute tablolarındaki veri okuma işlemlerinin eşzamanlılığını ayarlamak için kullanılabilir. Varsayılan olarak bu parametre her bölüm için 256 olarak ayarlanır. Birim: MB.