Spark on MaxCompute; yerel, küme ve DataWorks çalıştırma modlarını destekler.
Yerel mod
Spark on MaxCompute, yerel Spark'ta kullanılan yerel modda işleri hata ayıklamanıza olanak tanır.
Yerel mod, YARN küme moduna benzer. Yerel modu kullanmak için aşağıdaki hazırlıkları yapmanız gerekir:
Bir MaxCompute projesi oluşturun ve MaxCompute projesine erişmek için kullanılabilecek hesabın AccessKey ID'sini ve AccessKey secret değerini edinin.
Spark on MaxCompute istemcisini indirin.
Ortam değişkenlerini hazırlayın.
spark-defaults.conf dosyasını yapılandırın.
Bir demo proje şablonu indirin ve derleyin.
Daha fazla bilgi için bkz. Linux geliştirme ortamı kurma.
Spark on MaxCompute istemcisinde spark-submit betiğini çalıştırarak bir iş gönderebilirsiniz. Aşağıdaki kod bir örnek sağlar:
## Java/Scala
cd $SPARK_HOME
./bin/spark-submit --master local[4] --class com.aliyun.odps.spark.examples.SparkPi \
/path/to/odps-spark-examples/spark-examples/target/spark-examples-2.0.0-SNAPSHOT-shaded.jar
## PySpark
cd $SPARK_HOME
./bin/spark-submit --master local[4] \
/path/to/odps-spark-examples/spark-examples/src/main/python/odps_table_rw.py
Önlemler
Yerel modda, MaxCompute tablolarından veri okumak ve bu tablolara veri yazmak için Tunnel kullanılır. Bu nedenle, yerel moddaki okuma ve yazma işlemleri YARN küme modundakilere göre daha yavaştır.
-
Yerel modda, Spark on MaxCompute şirket içi makinenizde çalıştırılır. Bu nedenle, yerel modda çalışan Spark on MaxCompute'e sanal özel cloud (VPC) üzerinden erişebilir ancak YARN küme modunda çalışan Spark on MaxCompute'e VPC üzerinden erişemeyebilirsiniz.
Yerel modda ağ izole edilmez. Ancak YARN küme modunda ağ izole edilir ve VPC üzerinden erişim için gerekli parametreleri yapılandırmanız gerekir.
Yerel modda, VPC üzerinden Spark on MaxCompute'e erişmek için genel bir uç nokta kullanmanız gerekir. Ancak YARN küme modunda, VPC üzerinden Spark on MaxCompute'e erişmek için dahili bir uç nokta kullanmanız gerekir. MaxCompute uç noktaları hakkında daha fazla bilgi için bkz. Uç Noktalar.
IntelliJ IDEA'da Spark on MaxCompute'i yerel modda çalıştırırsanız ilgili yapılandırmaları kodda belirtmeniz gerekir. Ancak IntelliJ IDEA'da Spark on MaxCompute'i YARN küme modunda çalıştırmak isterseniz bu yapılandırmaların koddan silinmesi gerekir.
IntelliJ IDEA'da Spark on MaxCompute'i yerel modda çalıştırma
Spark on MaxCompute, N iş parçacığı kullanarak IntelliJ IDEA'da kodu doğrudan yerel modda çalıştırmanıza olanak tanır. Bu sayede kodu Spark on MaxCompute istemcisinde göndermekten kurtulursunuz. Kodu çalıştırırken aşağıdaki öğelere dikkat edin:
-
IntelliJ IDEA'da yerel modda kodu çalıştırırken ana/kaynak dizinindeki
odps.confdosyasında ilgili yapılandırmaları manuel olarak belirtmeniz gerekir. Yapılandırmalara spark-defaults.conf dosyasından doğrudan başvuramazsınız. Aşağıdaki kod bir örnek sağlar:NotSpark 2.4.5 ve sonraki sürümler için
odps.confdosyasında yapılandırma öğelerini belirtmeniz gerekir.dops.access.id="" odps.access.key="" odps.end.point="" odps.project.name="" -
IntelliJ IDEA'da Spark on MaxCompute istemcisi için
jarsklasörüne gerekli bağımlılıkları manuel olarak eklemeniz gerekir. Aksi takdirde aşağıdaki hata raporlanır:the value of spark.sql.catalogimplementation should be one of hive in-memory but was odpsBağımlılıkları yapılandırmak için aşağıdaki adımlara bakabilirsiniz:
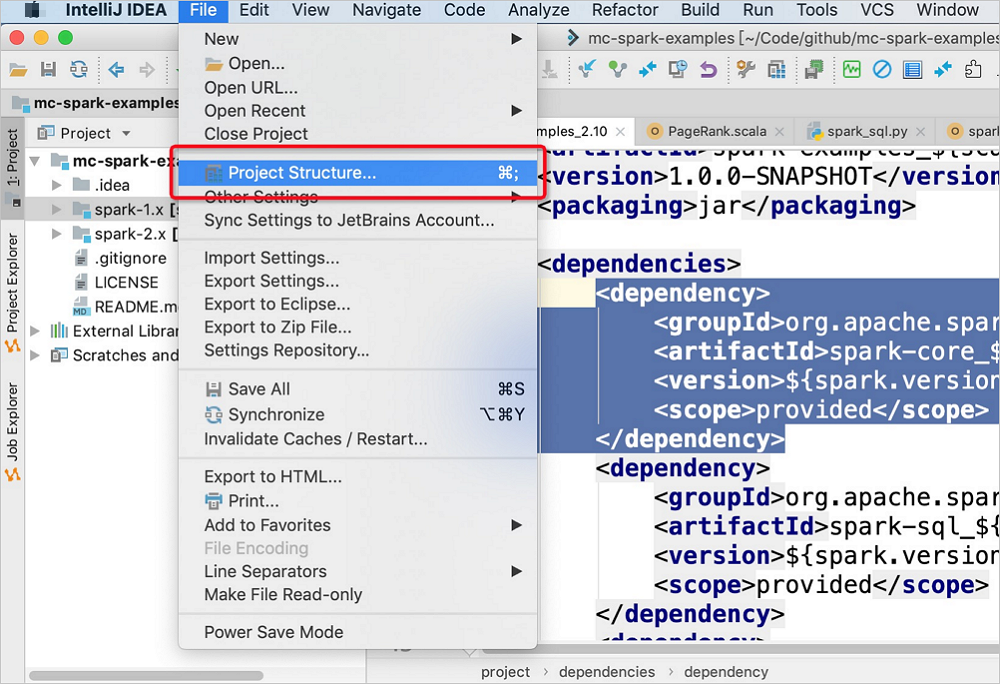
IntelliJ IDEA'nın üst menü çubuğunda seçeneğini belirleyin.
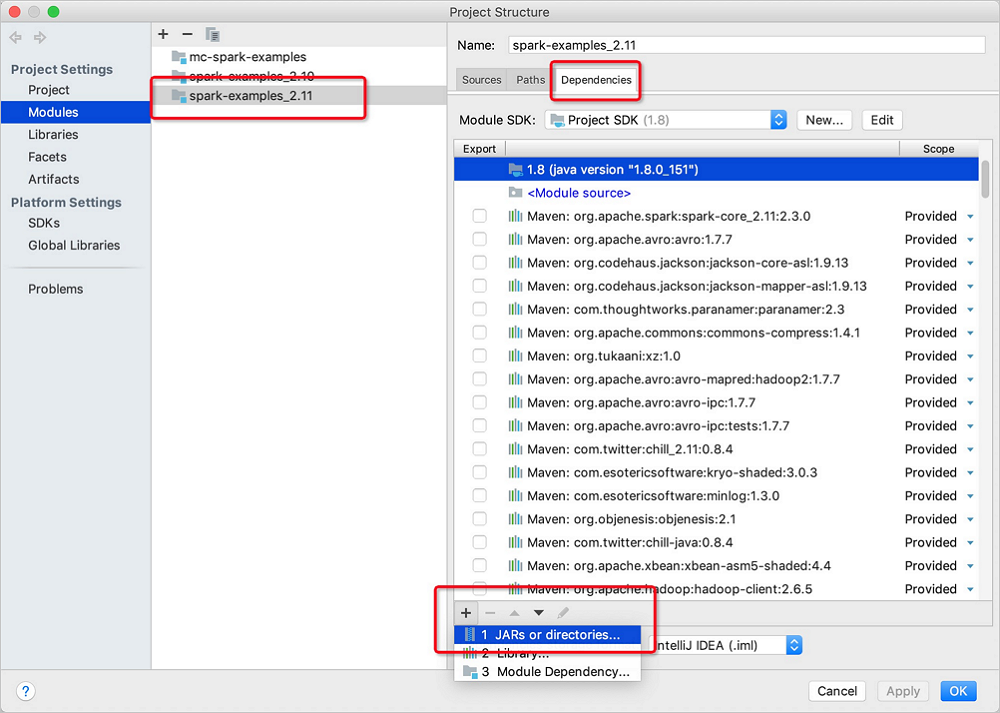
Project Structure sayfasında sol gezinme bölmesinde Modules öğesine tıklayın. Görünen sekmede spark-examples_2.11 seçeneğine tıklayın. Görünen panelde Dependencies sekmesine tıklayın. Ardından sol alt köşedeki
 simgesine tıklayıp JARS or directories öğesini seçin.
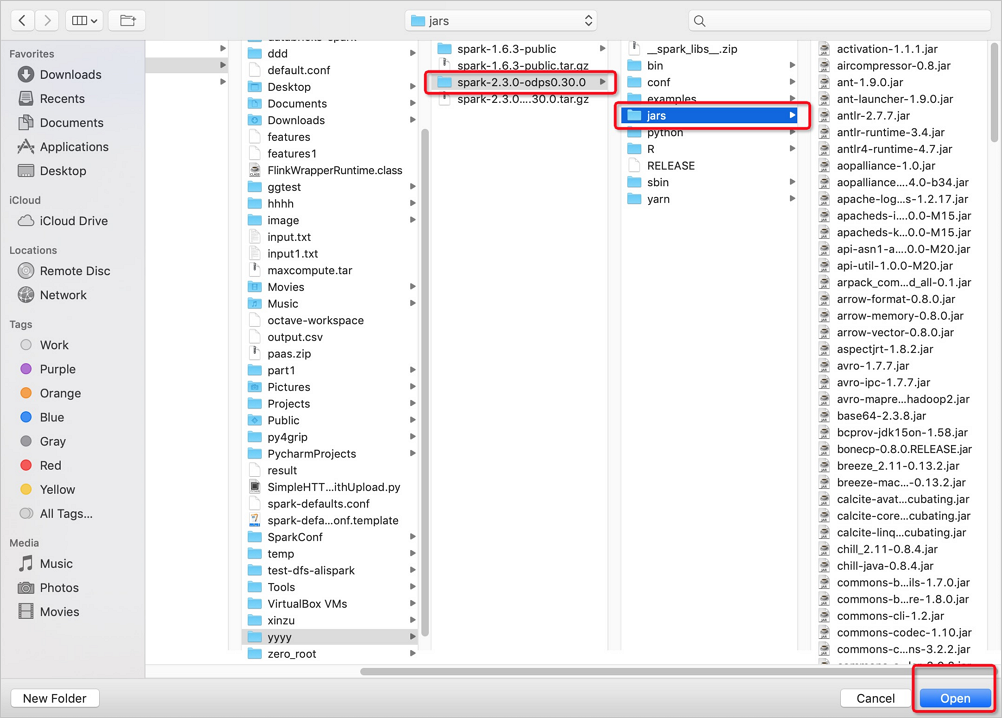
jars klasöründe gerekli Spark on MaxCompute paketi sürümünü > jars > gerekli JAR dosyasını seçin ve sağ alt köşede Open seçeneğine tıklayın.
OK seçeneğine tıklayın.
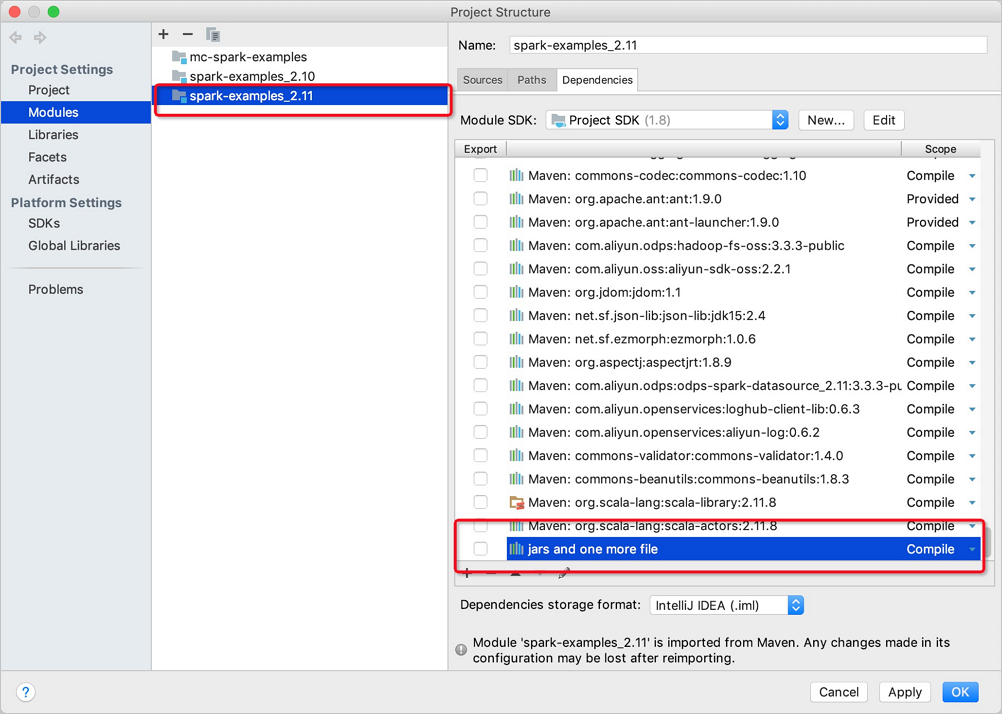
Yapılandırmaları IntelliJ IDEA'da gönderin.
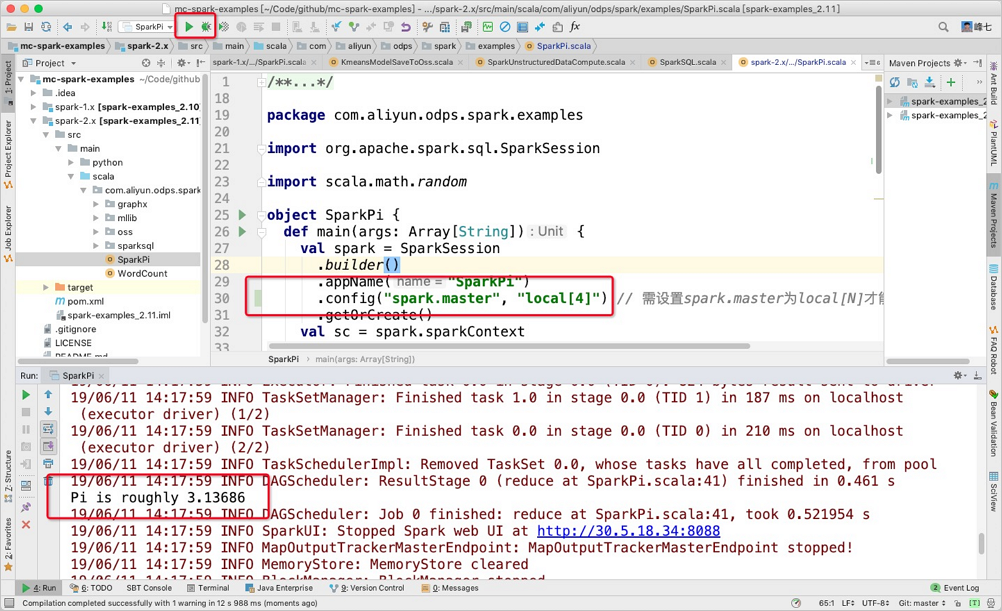
Küme modu
Küme modunda, özel bir uygulamanın giriş noktası olarak Main yöntemini belirtmeniz gerekir. Bir Spark işi, Main yöntemi başarılı olduğunda veya başarısız olduğunda sonlanır. Bu mod çevrimdışı işler için uygundur. Bu modda Spark on MaxCompute'i işleri zamanlamak için DataWorks ile birlikte kullanabilirsiniz. Aşağıdaki kod, bu modda Spark on MaxCompute'i çalıştırmak için komut satırlarının nasıl kullanılacağına ilişkin bir örnek sağlar:
# /path/to/MaxCompute-Spark: the path where the compiled application JAR package is saved.
cd $SPARK_HOME
bin/spark-submit --master yarn-cluster --class com.aliyun.odps.spark.examples.SparkPi \
/path/to/MaxCompute-Spark/spark-2.x/target/spark-examples_2.11-1.0.0-SNAPSHOT-shaded.jar
DataWorks modu
Diğer düğüm türlerini entegre etmek ve zamanlamak için Spark on MaxCompute'in çevrimdışı işlerini DataWorks'te küme modunda çalıştırabilirsiniz.
Aşağıdaki adımları gerçekleştirin:
-
Bir DataWorks iş akışında gerekli kaynakları yükleyin ve Submit simgesine tıklayın.
Oluşturulan iş akışında, Data Analytics bölümünden ODPS Spark öğesini seçin.
-
İş akışındaki ODPS Spark düğümüne çift tıklayın ve Spark işi için parametreleri yapılandırın. ODPS Spark düğümü için Spark Version parametresinin üç seçeneği ve Language parametresinin iki seçeneği vardır. Yapılandırmanız gereken diğer parametreler Language parametresine göre değişir. Parametreleri istemlere göre yapılandırabilirsiniz. Daha fazla bilgi için bkz. MaxCompute Spark görevi geliştirme. Şunlar dahildir:
Main JAR Resource: iş tarafından kullanılan kaynak dosyası. Bu işlemi gerçekleştirmeden önce kaynak dosyasını DataWorks'e yüklemeniz gerekir.
-
Configuration Items: işi göndermek için gereken yapılandırma öğeleri.
spark.hadoop.odps.access.id,spark.hadoop.odps.access.keyvespark.hadoop.odps.end.pointyapılandırmalarını belirtmeniz gerekmez. Bu yapılandırma öğelerinin varsayılan değerleri MaxCompute projesinin değerleriyle aynıdır. Ayrıca bu yapılandırma öğelerini açıkça belirtip varsayılan değerlerinin üzerine yazabilirsiniz.spark-defaults.confdosyasındaki yapılandırmaları ODPS Spark düğümünün yapılandırma öğelerine tek tek eklemeniz gerekir. Yapılandırmalar arasında yürütücü sayısı, bellek boyutu vespark.hadoop.odps.runtime.end.pointbulunur.ODPS Spark düğümünün kaynak dosyası ve yapılandırma öğeleri, aşağıdaki tabloda açıklandığı gibi spark-submit komutunun parametrelerine ve öğelerine eşlenir. spark-defaults.conf dosyasını yüklemeniz gerekmez. Bunun yerine, spark-defaults.conf dosyasındaki yapılandırmaları ODPS Spark düğümünün yapılandırma öğelerine tek tek eklemeniz gerekir.
ODPS Spark düğümü
spark-submit
Main JAR Resource ve Main Python Resourceapp jar or python file
Configuration Items--conf PROP=VALUE
Main Class--class CLASS_NAME
Arguments[app arguments]
JAR Resources--jars JARS
Python Resources--py-files PY_FILES
File Resources--files FILES
Archive Resources--archives ARCHIVES
-
ODPS Spark düğümünü çalıştırın, işin çalışma günlüklerini görüntüleyin ve daha fazla analiz ve teşhis için günlüklerden Logview ve Jobview URL'lerini edinin.
Spark işi tanımlandıktan sonra iş akışında farklı türdeki hizmetleri düzenleyebilir ve zamanlayabilirsiniz.