PyODPS, Python için MaxCompute yazılım geliştirme setidir (SDK). Python kullanarak MaxCompute işleri yazmak, tabloları ve görünümleri sorgulamak ve kaynakları yönetmek için basit bir programlama arayüzü sunar. PyODPS; dosya yükleme ve indirme, tablo oluşturma ve ODPS SQL sorguları çalıştırma gibi ODPS komut satırı arabirimine benzer özellikler sağlar. Ayrıca MapReduce işlerini gönderme ve MaxCompute kullanıcı tanımlı işlevlerini (UDF) kullanma gibi gelişmiş özellikler de içerir. Bu konuda PyODPS kullanım senaryoları, desteklenen araçlar ve dikkate alınması gereken önemli hususlar açıklanmaktadır.
İşlev tanıtımı
PyODPS aşağıdaki senaryolarda kullanılır:
Desteklenen araçlar
PyODPS yerel ortamlarda, DataWorks'te ve PAI Notebooks'ta çalışır.
Kullandığınız araçtan bağımsız olarak, PyODPS işlerini çalıştırmak için tüm verileri yerel makinenize indirmekten kaçının. Bu yaklaşım büyük miktarda bellek tüketebilir ve bellek yetersizliği (OOM) hatasına neden olabilir. Bunun yerine, işleri dağıtılmış yürütme için MaxCompute'a gönderin. Karşılaştırma için bkz. Notlar: Tüm verileri yerel makineye indirmeyin ve PyODPS çalıştırmayın.
Yerel ortam: PyODPS'yi yerel ortamınıza yükleyip kullanabilirsiniz. Daha fazla bilgi için bkz. PyODPS'yi yerel ortamda kullanma.
DataWorks: PyODPS, DataWorks'teki PyODPS düğümlerinde önceden yüklüdür. Bu düğümlerde PyODPS işlerini doğrudan geliştirebilir ve periyodik olarak çalıştırabilirsiniz. Daha fazla bilgi için bkz. PyODPS'yi DataWorks'te kullanma.
PAI Notebooks: PyODPS'yi PAI Python ortamına yükleyip çalıştırabilirsiniz. PyODPS, PAI-Designer'ın özel Python bileşeni gibi yerleşik PAI görüntülerinde önceden yüklüdür ve kullanıma hazırdır. PAI Notebooks'ta PyODPS kullanımı, standart kullanıma benzer. Daha fazla bilgi için bkz. Temel işlemlere genel bakış ve DataFrame (önerilmez).
Notlar: Tüm verileri yerel makineye indirmeyin ve PyODPS çalıştırmayın
PyODPS; PC'ler, Data Studio'daki DataWorks PyODPS düğümleri ve PAI Notebook ortamları dahil olmak üzere çeşitli istemcilerde çalışan bir SDK'dır.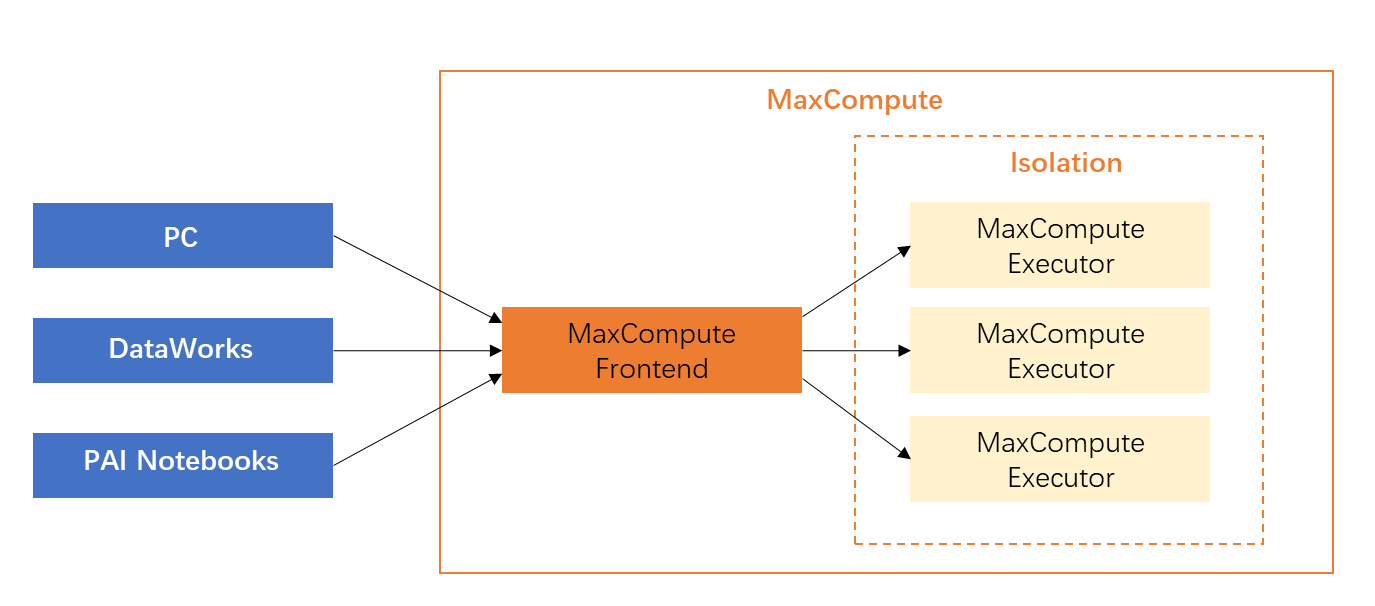 PyODPS, verileri yerel makineye çekmek için
tunnel download, execute ve to_pandas işlemleri gibi birkaç kullanışlı işlem sağlar. Sonuç olarak, birçok yeni kullanıcı verileri yerel olarak çekmeye, işlemeye ve ardından MaxCompute'a geri yüklemeye çalışır. Ancak bu yöntem genellikle oldukça verimsizdir. Verileri yerel olarak çekmek, MaxCompute'ın büyük ölçekli paralel hesaplama yeteneklerinden yararlanmanızı engeller.
|
Veri işleme yöntemi |
Açıklama |
Örnek senaryo |
|
İşlemek için verileri yerel makineye çekme (Önerilmez. OOM hatalarına neden olabilir.) |
Örneğin, DataWorks'teki bir PyODPS düğümü yerleşik bir PyODPS paketi ve gerekli Python ortamını içerir. Bu düğüm, kaynağı kısıtlı bir istemci çalışma zamanı konteyneridir. MaxCompute hesaplama kaynaklarını kullanmaz ve sıkı bellek sınırlarına sahiptir. |
PyODPS, MaxCompute verilerini doğrudan bir pandas DataFrame'e dönüştürmek için |
|
İşleri dağıtılmış yürütme için MaxCompute'a gönderme (Önerilir) |
PyODPS'nin dağıtılmış DataFrame özelliğini kullanın. Büyük hesaplamaları PyODPS istemci düğümünde indirip işlemek yerine, dağıtılmış yürütme için MaxCompute'a gönderin. PyODPS'yi doğru kullanmanın anahtarı budur. Not
SQL yürütme sonuçlarını bir DataFrame'e dönüştürmek istiyorsanız, önce sonuçları bir MaxCompute tablosuna kaydetmek için
|
Veri işlemek için PyODPS DataFrame arayüzünü kullanın. Her satırı işleyip tabloya geri yazma veya bir satırı birden fazla satıra bölme gibi yaygın görevler için PyODPS DataFrame'deki Bu arayüzler kodunuzu SQL'e dönüştürerek MaxCompute hesaplama kümesinde dağıtılmış yürütme sağlar. Bu yaklaşım neredeyse hiç yerel bellek tüketmez ve tek makineli hesaplamaya kıyasla performansı önemli ölçüde artırır. |
Aşağıdaki belirteçleştirme örneği, her iki yöntem için kodu karşılaştırır.
-
Örnek senaryo
Günlük log dizelerini analiz ederek bilgi çıkarmanız gerekmektedir. Dize türünde tek bir sütun içeren bir tablonuz vardır. Çince metni belirteçlere ayırmak, istediğiniz anahtar kelimeleri bulmak ve bu anahtar kelimeleri bir bilgi tablosunda depolamak için jieba kitaplığını kullanmalısınız.
-
Verimsiz işleme kodu demosu
import jieba
t = o.get_table('word_split')
out = []
with t.open_reader() as reader:
    for r in reader:
        words = list(jieba.cut(r[0]))
        #
        # Processing logic to generate processed_data
        #
        out.append(processed_data)
out_t = o.get_table('words')
with out_t.open_writer() as writer:
    writer.write(out)
Bu yaklaşım tek makineli işleme zihniyetini takip eder: verileri satır satır okur, satır satır işler ve ardından hedef tabloya satır satır yazar. Tüm süreç, veri indirme ve yükleme için çok fazla zaman harcar. Komut dosyasını çalıştıran makinenin ayrıca tüm verileri işlemek için büyük miktarda belleğe ihtiyacı vardır. DataWorks düğüm kullanıcıları için bu yaklaşım, varsayılan olarak ayrılan belleği aşarak kolayca OOM hatasına neden olabilir.
-
Verimli işleme kodu demosu
from odps.df import output
out_table = o.get_table('words')
df = o.get_table('word_split').to_df()

# Assume the following fields and types need to be returned
out_names = ["word", "count"]
out_types = ["string", "int"]

@output(out_names, out_types)
def handle(row):
    import jieba
    words = list(jieba.cut(row[0]))
    #
    # Processing logic to generate processed_data
    #
    yield processed_data
df.apply(handle, axis=1).persist(out_table.name)
Dağıtılmış yürütme için apply yöntemini kullanın:
Karmaşık mantık handle işlevine yerleştirilir. Bu işlev, UDF olarak kullanılmak üzere sunucu tarafına otomatik olarak serileştirilir, burada çağrılır ve yürütülür. Handle işlevi sunucu tarafında yürütme sırasında verileri satır satır işlediğinden mantık aynıdır. Fark şudur ki, bu program MaxCompute'da yürütülmek üzere gönderildiğinde, birden fazla makine verileri aynı anda işler. Bu da çok fazla zaman kazandırır.
Persist arayüzünün çağrılması, oluşturulan verileri doğrudan başka bir MaxCompute tablosuna yazar. Tüm veri üretimi ve tüketimi MaxCompute kümesi içinde gerçekleşir. Bu sayede yerel ağ ve bellek kaynaklarından tasarruf edilir.
Bu örnek ayrıca üçüncü taraf bir paket de kullanır. MaxCompute, UDF'lerde bu örnekteki
jiebagibi üçüncü taraf paketleri destekler. Bu nedenle kod değişikliklerinin maliyeti konusunda endişelenmenize gerek yoktur. Ana mantığınızda neredeyse hiçbir değişiklik yapmadan MaxCompute'ın büyük ölçekli hesaplama yeteneklerinden yararlanabilirsiniz.
Sınırlamalar
Sandbox kısıtlamaları nedeniyle, pandas hesaplama arka ucunu kullanarak yerel olarak hata ayıkladığınız bazı programlar MaxCompute'da hata ayıklanamaz.