Bu dokümanda, Alibaba Cloud MaxCompute üzerinde MaxFrame AI işlevinin nasıl kullanılacağı açıklanmakta ve büyük dil modelleriyle çevrimdışı çıkarım uygulamalarına giriş için kullanım örnekleri sunulmaktadır.
Genel Bakış
MaxFrame AI işlevi, Alibaba Cloud MaxCompute platformunda büyük dil modeli (LLM) çevrimdışı çıkarımı için uçtan uca bir çözümdür. Veri işlemeyi yapay zeka yetenekleriyle sorunsuz bir şekilde entegre ederek kurumsal düzeyde büyük dil modellerinin benimsenmesini kolaylaştırır.
Tasarım felsefesi: "Veri girer, sonuç çıkar." Bu yaklaşım sayesinde MaxFrame Python çerçevesini ve pandas tarzı API'ları kullanarak veri hazırlama ve işlemeden model çıkarımına ve sonuçların depolanmasına kadar tüm iş akışını MaxCompute ekosistemi içinde tamamlayabilirsiniz.
Kullanım alanları: Bu işlev, günlük analizi ve kullanıcı davranışı günlükleri gibi yapılandırılmış verilerin yanı sıra metin çevirisi, belge özetleme ve vektörleştirme gibi görevler için yapılandırılmamış verilerin işlenmesi için idealdir. Dağıtık hesaplama mimarisi sayesinde düşük gecikme süresi ve doğrusal ölçeklenebilirlik sağlayarak tek bir işte petabayt ölçeğinde verileri işleyebilir. Metinden yapılandırılmış bilgileri ayıklamak, içeriği düzenlemek ve özetlemek, özetler oluşturmak, dilleri çevirmek, metin kalitesini değerlendirmek ve duygu analizi yapmak için kullanabilirsiniz. Bu sayede büyük dil modelleri için veri işleme süreci büyük ölçüde basitleşir ve sonuçların kalitesi artar.
-
Mimari
MaxFrame AI işlevi, esnek ve genel amaçlı
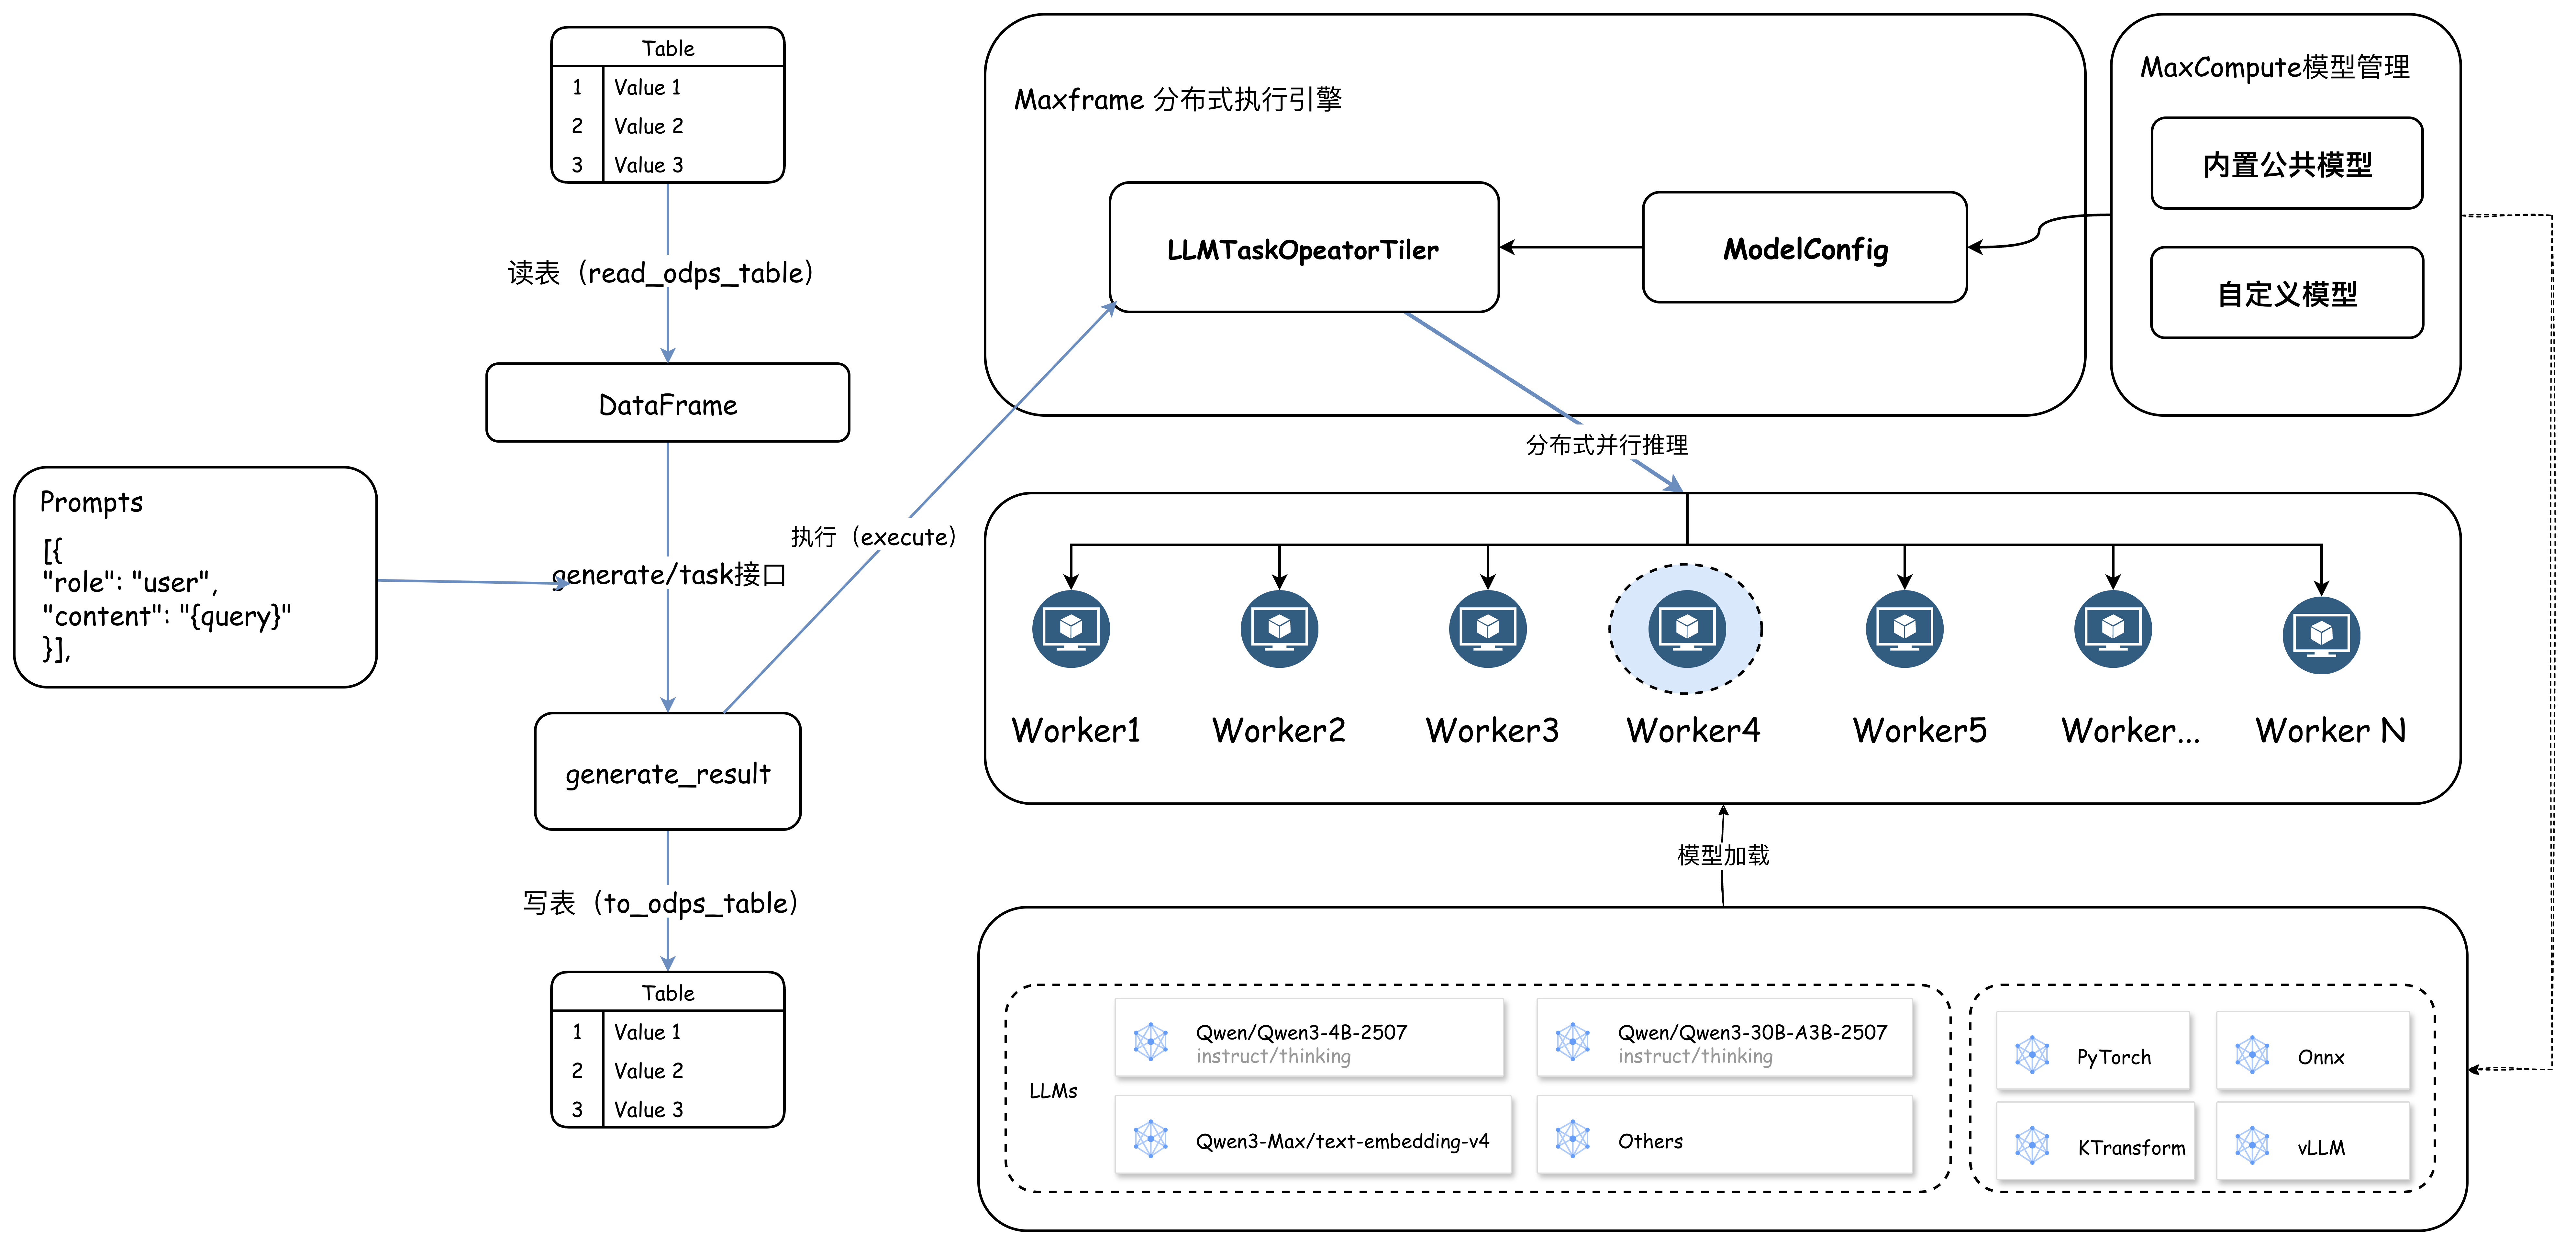
generatearabirimini; metin çevirisi, yapılandırılmış veri ayıklama ve vektörleştirme gibi senaryolar için özelleştirilmiş ve concisetaskarabirimlerini sunar. Bir model seçip giriş olarak bir MaxCompute tablosu ve istemler sağlarsınız.Bir arabirimi çağırdığınızda MaxFrame önce giriş tablosunda veri parçalama işlemi gerçekleştirir. Veri hacmine göre uygun bir eşzamanlılık düzeyi belirleyerek bir grup çalışan başlatabilir ve hesaplama işini yürütebilirsiniz. Her çalışan, sağlanan istem şablonunu kullanarak veri satırlarından model girişlerini oluşturur, çıkarım işini çalıştırır ve sonuçları ile başarı durumunu MaxCompute'a geri yazar.
Aşağıdaki şekil mimariyi ve iş akışını göstermektedir.
-
Temel avantajlar:
Kullanım kolaylığı: Tanıdık Python API'ları, hazır model kütüphanesi ve sıfır dağıtım maliyeti.
Ölçeklenebilirlik: MaxCompute CU kotası, GU kotası ve Inference Quota kaynaklarından yararlanarak büyük ölçekli paralel işlemeyi destekler ve genel token aktarım hızını artırır.
Veri ve yapay zeka entegrasyonu: Veri okuma ve işlemeden yapay zeka çıkarımına ve sonuçların depolanmasına kadar tüm iş akışınızı tek bir platformda tamamlayın. Bu yaklaşım veri geçiş maliyetlerini azaltır ve geliştirme verimliliğini artırır.
Geniş senaryo kapsamı: Çeviri, yapılandırılmış veri ayıklama ve vektörleştirme dahil olmak üzere 10'dan fazla yaygın kullanım durumunu kapsar.
Gereksinimler
-
Desteklenen bölgeler:
China (Hangzhou), China (Shanghai), China (Beijing), China (Ulanqab), China (Shenzhen), China (Chengdu), China (Hong Kong), China (Hangzhou) Finance Cloud ve China (Shanghai) Finance Cloud.
Desteklenen Python sürümü: 3.11.
-
Desteklenen SDK sürümü: MaxFrame SDK sürümünüzün 2.7.1 veya üzeri olduğundan emin olun. Sürümü aşağıdaki komutlardan birini çalıştırarak kontrol edebilirsiniz:
// For Windows
pip list | findstr maxframe

// For Linux
pip list | grep maxframe
Sürümünüz eskiyse, en son sürüme yükseltmek için
pip install --upgrade maxframekomutunu çalıştırın.
Desteklenen modeller
MaxFrame,Qwen 3,DeepSeek-R1-Distill-Qwen ve Qwen3-embedding dahil olmak üzere bir dizi yerleşik büyük dil modeli için hazır destek sunar. Ayrıca Model Studio'daki ticari amiral gemisi modellerini, çok modlu modeller qwen3.7-max,qwen3.6-plus,qwen3.6-flash,deepseek-v4-pro,deepseek-v4-flash ve qwen3-vl-embedding ile metin modeli text-embedding-v4 gibi modelleri çağırmanıza olanak tanır. Tüm modeller MaxCompute platformu içinde çevrimdışı olarak barındırılır. Bu sayede model indirme, dağıtım veya API eşzamanlılık sınırlarını yönetmenize gerek kalmaz. Modelleri basit API çağrıları yaparak kullanabilir ve MaxCompute'ın devasa hesaplama kaynaklarından yararlanarak yüksek genel token aktarım hızı ve eşzamanlılıkla çevrimdışı çıkarım görevlerini tamamlayabilirsiniz.
Desteklenen modeller
Model türü | Model adı | Kota |
Model Studio ticari modelleri |
|
|
Qwen 3 serisi açık kaynak modelleri |
|
|
Qwen Embedding açık kaynak modelleri |
|
|
Deepseek-R1-Distill-Qwen serisi açık kaynak modelleri |
|
|
Deepseek-R1-0528-Qwen3 açık kaynak modelleri |
|
|
Kota kaynak türleri
MaxFrame, model boyutuna ve iş gereksinimlerinize en uygun seçeneği belirlemeniz için üç kaynak türünü destekler.
CU kota kaynakları
Compute Unit (CU), küçük modeller ve küçük ölçekli çıkarım görevleri için uygun olan genel amaçlı CPU hesaplama kaynağıdır (1 vCPU ve 4 GB bellek).
Yapılandırma:
# Use CU quota compute resources.
options.session.quota_name = "mf_cpu_quota"
GU kota kaynakları
GPU Unit (GU), LLM çıkarımı için optimize edilmiş GPU hesaplama kaynağıdır. Daha büyük modelleri destekler ve 8B parametre veya üzeri modellerle yapılan çıkarım görevleri için uygundur.
Yapılandırma:
# Use GU quota compute resources.
options.session.gu_quota_name = "mf_gpu_quota"
Inference Quota kaynakları (token bazlı faturalama)
Bu seçenek,qwen3-max ve text-embedding-v4 gibi Model Studio'daki ticari büyük dil modellerini çağırmanıza olanak tanır. Faturalandırma, gerçek token tüketimine göre yapılır. Bu yaklaşım, CU veya GU kaynaklarını sağlamaya ve alttaki altyapıyı yönetmeye gerek bırakmadan esnek, kullanışlı ve maliyet etkin bir çözüm sunar.
API referansı
MaxFrame AI işlevi, esneklik ile kullanım kolaylığını dengelemek için iki arabirim sunar: genel amaçlı generate arabirimi ve göreve özel task arabirimleri.
Genel: generate
**generate arabirimi
Temel parametreler
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Göreve özel: task
Senaryoya özel arabirim: Task
Önceden tanımlanmış, standartlaştırılmış görev arabirimleri yaygın kullanım durumları için geliştirmeyi basitleştirir. Şu anda desteklenen task arabirimleri arasında translate,extract ve embed bulunur.
-
Temel parametreler
Parametre
Zorunlu
Açıklama
model_name
Evet
Kullanılacak modelin adı.
df
Evet
Bir DataFrame içinde paketlenmiş, analiz edilecek metin veya veriler.
task arabirimi
Evet
translate: dil çevirisi gerçekleştirir.extract: yapılandırılmış veri ayıklama gerçekleştirir.embed: vektörleştirme gerçekleştirir.
-
Kullanım örneği
from maxframe.learn.contrib.llm.models.managed import ManagedTextLLM

llm = ManagedTextLLM(name="<model_name>")

# Translate text.
translated_df = llm.translate(
    df["english_column"],
    source_language="english",
    target_language="Chinese",
    examples=[("Hello", "你好"), ("Goodbye", "再见")],
)

translated_df.execute()
Kullanım örnekleri
GU kotası
GU kotası senaryoları
Dil çevirisi
Senaryo: Çok uluslu bir şirket, 100.000 İngilizce sözleşmeyi Çinceye çevirmeli ve ana maddeleri açıklamalıdır.
import os
import maxframe.dataframe as md
from maxframe import new_session
from maxframe.config import options
from maxframe.udf import with_running_options
from odps import ODPS

options.dag.settings = {
    "engine_order": ["DPE", "MCSQL"]
}

o = ODPS(
    os.getenv('ALIBABA_CLOUD_ACCESS_KEY_ID'),
    os.getenv('ALIBABA_CLOUD_ACCESS_KEY_SECRET'),
    project='your-default-project',
    endpoint='your-end-point',
)

# Initialize the MaxFrame session.
session = new_session(o)

# Print the Logview URL for the job.
print(session.get_logview_address())

# 1. Use GU quota compute resources.
options.session.gu_quota_name = "mf_gu_quota"

# 2. Use the Qwen3-1.7B model.
from maxframe.learn.contrib.llm.models.managed import ManagedTextLLM

llm = ManagedTextLLM(name="Qwen3-1.7B")

# 3. Prepare the data. You can skip this step if you already have data.
# o.execute_sql("""
#   CREATE TABLE IF NOT EXISTS raw_contracts (
#       en STRING
#   );
#   """)
#
# o.execute_sql("""
#   INSERT INTO raw_contracts VALUES
#   ('This agreement is governed by the laws of the State of California.'),
#   ('The tenant shall pay rent on the first day of each month.'),
#   ('Either party may terminate this contract with 30 days written notice.'),
#   ('All intellectual property rights shall remain with the original owner.'),
#   ('The warranty period for this product is twelve months from the date of purchase.');
#   """)

df = md.read_odps_table("raw_contracts")

# 4. Define the prompt template.
messages = [
    {
        "role": "system",
        "content": "You are a document translation expert who can fluently translate English text into Chinese.",
    },
    {
        "role": "user",
        "content": "Translate the following English text into Chinese. Output only the translated text, with no other content.\n\n Example:\nInput: Hi\nOutput: 你好。\n\n Text to translate:\n\n{en}",
    },
]

# 5. Call the `generate` interface, define the prompt, and reference the corresponding data column.
result_df = llm.generate(
    df,
    prompt_template=messages,
    params={
        "temperature": 0.7,
        "top_p": 0.8,
    },
).execute()

# 6. Write the results to a MaxCompute table.
result_df.to_odps_table("raw_contracts_result")
Anahtar kelime ayıklama
Senaryo: Bu kullanım örneği, MaxFrame AI işlevinin yapılandırılmamış verileri nasıl işlediğini göstermektedir. Yapılandırılmamış verilerin büyük bir kısmı metin ve görsellerden oluşur ve bu durum büyük veri analitiği için önemli zorluklar yaratır. Aşağıdaki örnek, AI işlevinin bu süreci nasıl basitleştirdiğini göstermektedir.
Aşağıdaki kod, AI işlevini kullanarak bir özgeçmişten adayın iş deneyimini nasıl ayıklayacağınızı göstermektedir. Örnek, rastgele oluşturulan özgeçmiş metnini giriş olarak kullanır. Ayrıntılı geliştirme uygulamaları ve demolar için bkz. GU'da AI İşlevi Geliştirme Uygulamaları.
import maxframe.dataframe as md
from maxframe import new_session
from maxframe.config import options
from maxframe.udf import with_running_options
from odps import ODPS

options.dag.settings = {
    "engine_order": ["DPE", "MCSQL"]
}

o = ODPS(
    os.getenv('ALIBABA_CLOUD_ACCESS_KEY_ID'),
    os.getenv('ALIBABA_CLOUD_ACCESS_KEY_SECRET'),
    project='your-default-project',
    endpoint='your-end-point',
)

# Initialize the MaxFrame session.
session = new_session(o)

# Print the Logview URL for the job.
print(session.get_logview_address())

# 1. Use GU quota compute resources.
options.session.gu_quota_name = "mf_gu_quota"

# 2. Use the Qwen3-4B model.
from maxframe.learn.contrib.llm.models.managed import ManagedTextLLM

llm = ManagedTextLLM(name="Qwen3-4B-Instruct-2507-FP8")

df = md.read_odps_table("traditional_chinese_medicine", index_col="index")

# Specify four concurrent partitions.
parallel_partitions = 4
df = df.mf.rebalance(num_partitions=parallel_partitions)

# 3. Use the preset `extract` task interface.
result_df = llm.extract(
    df["text"],
    description="Please extract structured data from the following medical record in order. Return the final output in strict JSON format according to the schema.",
    schema=MedicalRecord,
    examples=[(example_input, example_output)],
)
result_df.execute()
Inference kotası
Inference kotası senaryoları
Metin vektörleştirme: text-embedding-v4
Senaryo: Model Studio ticari modeli text-embedding-v4 kullanarak vektörleştirme görevleri gerçekleştirin. Faturalandırma token tüketimine göre yapılır ve alttaki hesaplama kaynaklarını yönetmenize gerek kalmaz. Bu senaryo, büyük modeller veya Model Studio'daki ticari büyük dil modelleri gerektiren karmaşık metin analizi ve yüksek kaliteli çıkarım görevleri için uygundur.
Görüntü anlama: qwen3.6-plus
Senaryo: Bu senaryo, büyük modeller veya Model Studio'daki ticari büyük dil modelleri gerektiren yüksek kaliteli çıkarım ve karmaşık metin analizi veya çok modlu veri işleme görevleri için uygundur. Kaynaklar ihtiyaca göre tüketilir ve bu sayede maliyetlerinizi kontrol etmenize yardımcı olur.
Performans optimizasyonu
Paralel çıkarım
MaxFrame,paralel hesaplama kullanarak büyük ölçekli çevrimdışı çıkarım çalıştırır:
Veri parçalama:
rebalancearabirimi, belirtilen bölüm sayısına (num_partitions) göre giriş veri tablosunu birden çok çalışan düğümüne eşit şekilde dağıtır.Paralel model yükleme: Her çalışan, modeli bağımsız olarak yükler ve önceden ısıtır. Bu sayede model yüklemesinden kaynaklanan soğuk başlatma gecikmesi önlenir.
Sonuç toplama: Çıktı sonuçları bölümlere göre bir MaxCompute tablosuna yazılır ve bu durum sonraki veri analizini destekler.
İnce ayar önerileri
-
Heterojen hesaplama kaynaklarına geçiş
Büyük modeller (8B parametre veya üzeri) için CPU çıkarımı verimsizdir. Çıkarım için GU kotası veya Inference Quota kaynaklarına geçiş yapmanızı öneririz.
-
Veri bölümlerini paralel işleme
Büyük ölçekli çıkarım işleri için, veri dağılımınıza göre paralel işleme amacıyla verileri parçalamak üzere
rebalancearabirimini kullanın.