Bu konuda, MaxCompute tarafından desteklenen MapReduce programlama arabirimleri ve bunların sınırlamaları açıklanmaktadır.
MapReduce nedir?
MapReduce tipik bir dağıtık hesaplama çerçevesidir. Böl ve yönet yaklaşımını kullanarak büyük veya karmaşık sorunları daha küçük, yönetilebilir alt sorunlara ayırır. Bu alt sorunları çözer ve nihai çözümü elde etmek için sonuçları birleştirir. MapReduce, geleneksel paralel programlama çerçevelerine kıyasla yüksek hata toleransı, kullanım kolaylığı ve iyi genişletilebilirlik gibi avantajlar sunar. MapReduce'da paralel programlar geliştirirken veri depolama veya düğümler arasındaki iletişim mekanizmaları gibi dağıtık kümenin temel ayrıntılarını dikkate almanız gerekmez. Bu durum dağıtık programlamayı basitleştirir.
Aşağıdaki şekilde MapReduce iş akışı gösterilmektedir.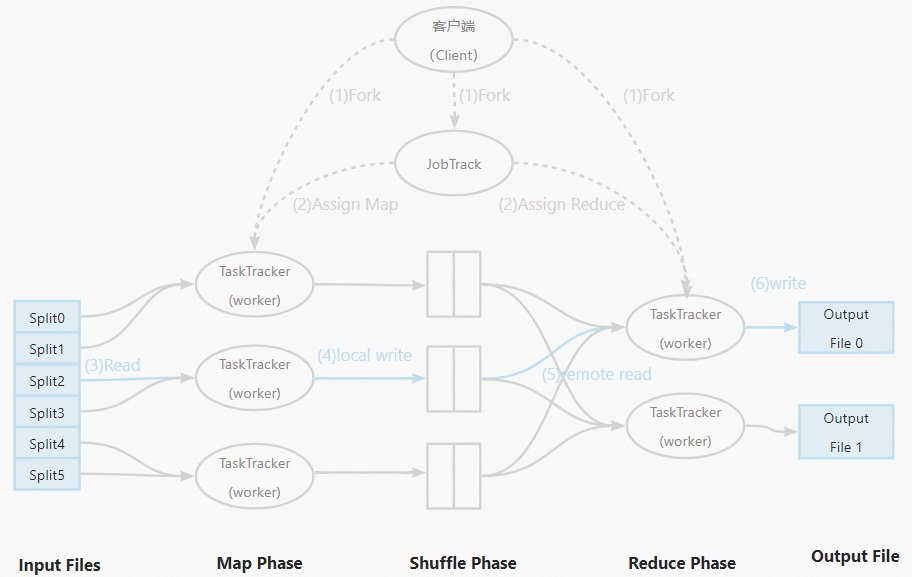
MaxCompute iki MapReduce programlama arabirimi sağlar:
MaxCompute MapReduce: Yerel MaxCompute API'sidir. Dosya sistemini açığa çıkarmadığı için bu sürüm hızlı çalışır ve geliştirmeyi basitleştirir.
Genişletilmiş MaxCompute MapReduce (MR2): Daha karmaşık iş zamanlama mantığını destekler ve uygulaması yerel MaxCompute arabirimiyle tutarlıdır. Geleneksel MapReduce ile karşılaştırıldığında bu genişletilmiş model, iş çalıştırma sırasında gereksiz G/Ç işlemlerinden kaçınmak için temel zamanlama ve G/Ç modellerini değiştirir.
Bu sürümler; Terimler, İş Gönderimi, Giriş ve Çıkış ve Kaynak Kullanımı açısından çoğunlukla tutarlıdır ancak Java SDK'ları farklılık gösterir. Daha fazla bilgi için bkz. Hadoop Map/Reduce Eğitimi.
Bir foreign table içindeki verileri okumak veya yazmak için MapReduce kullanamazsınız.
MapReduce
Senaryolar
MapReduce aşağıdaki senaryoları destekler:
Arama: Web tarama, ters dizinler ve PageRank.
-
Web erişim günlüklerinin analizi:
Kişiselleştirilmiş öneriler sunmak için göz atma ve alışveriş gibi kullanıcı davranışlarını analiz eder ve madencilik yapar.
Kullanıcı erişim kalıplarını analiz eder.
-
Metinlerin istatistiksel analizi:
Popüler romanların kelime sayısı ve terim frekansı-ters belge frekansı (TF-IDF) analizi.
Akademik makalelerin ve patent belgelerinin istatistiksel analizi ve atıf analizi.
Wikipedia veri analizi.
Yapılandırılmamış veriler, uzamsal-zamansal veriler ve görüntü verileri gibi büyük miktarda verinin madenciliği.
Makine öğrenimi: Denetimli öğrenme, denetimsiz öğrenme ve karar ağaçları ile destek vektör makineleri (SVM'ler) gibi sınıflandırma algoritmaları.
-
Doğal Dil İşleme:
Büyük verilere dayalı eğitim ve tahmin.
Bir derlemeye dayalı kelime eş oluşum matrisleri oluşturma, sık öğe kümelerini bulma ve yinelenen belgeleri tespit etme.
Reklam önerileri: Tıklama oranlarının (CTR) ve dönüşüm oranlarının (CVR) tahmini.
MapReduce işlem açıklaması
MapReduce programı verileri iki ana aşamada işler: Bir map aşamasının ardından bir reduce aşaması gelir. Bu aşamalar için işleme mantığını tanımlayabilirsiniz ancak bunun MapReduce çerçevesinin kurallarına uygun olması gerekir. MapReduce'un tam veri işleme akışı şu şekildedir:
Giriş verileri: Map işleminden önce giriş verileri eşit boyutlu veri bloklarına bölünür. Her veri bloğu bir map çalışanı için giriş olarak kullanılır. Bu, birden çok map çalışanının eşzamanlı olarak çalışmasına olanak tanır.
-
Map aşaması: Her map çalışanı kendisine atanan veri bloğunu okur ve işler. Ardından her çıkış kaydına bir anahtar atar. Bu anahtar, kaydın hangi reduce çalışanına gönderileceğini belirler.
NotAynı anahtara sahip veri kayıtları aynı reduce çalışanına gönderilir. Tek bir reduce çalışanı farklı anahtarlara sahip veri kayıtlarını alabilir.
Shuffle aşaması: Reduce aşamasından önce MapReduce çerçevesi verileri Anahtara göre sıralar; bu işlem aynı Anahtara sahip verileri gruplandırır. Bir Combine Operation (Combiner) belirtirseniz çerçeve aynı Anahtara sahip verileri toplamak için Combiner'ı çağırır. Combiner mantığını özelleştirebilirsiniz. MaxCompute'te klasik MapReduce çerçeve protokolünün aksine Combiner'ın giriş ve çıkış parametreleri Reduce aşamasındakilerle tutarlı olmalıdır. Bu sürecin bu bölümüne genellikle Shuffle da denir.
Reduce aşaması: Aynı anahtara sahip veri kayıtları aynı reduce çalışanına gönderilir. Tek bir reduce çalışanı birden çok map çalışanından veri alabilir. Her reduce çalışanı aynı anahtara sahip veri kayıtları üzerinde bir reduce işlemi gerçekleştirerek bunları tek bir değere dönüştürür.
Çıkış verileri: Sonuçlar oluşturulur.
Bu bölümde MapReduce çerçevesine kısa bir giriş yapılmaktadır. Daha fazla bilgi için bkz. İşlev Tanıtımı.
Aşağıdaki bölümde MaxCompute MapReduce'teki her aşamanın kavramlarını açıklamak için WordCount örneği kullanılmaktadır.
a.txt adlı bir dosyanın olduğunu ve dosyanın her satırında tek bir rakam bulunduğunu varsayalım. Amaç her rakamın kaç kez geçtiğini saymaktır. Bu bağlamda her rakam bir 'kelime'dir ve geçiş sayısı 'count'tur. Bunu başarmak için MaxCompute MapReduce aşağıdaki şekilde gösterilen süreci izler.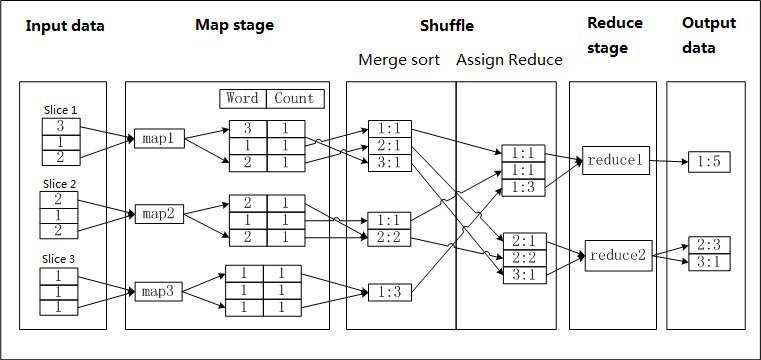
Procedure
Giriş verileri: Metin dosyası bölümlere ayrılır. Her bölümdeki veri bir map çalışanı için giriş olarak kullanılır.
Map aşaması: Map çalışanı girişi işler. Aldığı her rakam için sayıyı 1 olarak ayarlar ve bir <Word, Count> çifti çıkarır. Kelime çıkış verileri için anahtar olarak kullanılır.
Shuffle > Birleştirme ve sıralama: Erken shuffle aşamasında her map çalışanının çıktısı öncelikle anahtara (kelimeye) göre sıralanır. Sıralamadan sonra bir birleştirici (combiner) işlemi gerçekleştirilir. Aynı anahtar (kelime) için sayılar toplanarak yeni bir <Word, Count> çifti oluşturulur. Bu sürece birleştirme ve sıralama denir.
Shuffle > Reducer'lara atama: Geç shuffle aşamasında veriler reducer'lara gönderilir. Bir reduce çalışanı veriyi aldıktan sonra veriyi tekrar anahtara göre sıralar.
Reduce aşaması: Her reduce çalışanı birleştiriciyle aynı mantığı kullanarak verileri işler. Nihai sonucu elde etmek için aynı anahtar (kelime) için sayıları toplar.
Çıkış verileri.
Tüm MaxCompute verileri tablolar halinde saklanır. Bu nedenle MaxCompute MapReduce'un girişi ve çıkışı tablo olmalıdır. Çıkış biçimini belirtemezsiniz. Dosya sistemi benzeri arabirimler sağlanmaz.
Sınırlamalar
MapReduce sınırlamaları için bkz. Sınırlama özeti.
MapReduce'u yerel olarak çalıştırma ile ilgili sınırlamalar için bkz. Yerel ortamda ve dağıtık ortamda çalıştırma arasındaki farklar.
Genişletilmiş MapReduce (MR2)
Yerel MaxCompute MapReduce ile karşılaştırıldığında MR2'de Map ve Reduce gibi işlevleri yazma biçiminiz çoğunlukla aynıdır. Temel fark işlerin nasıl çalıştırıldığındadır. Örnek için bkz. İşlem Hattı Örneği.
MR2 modelinin arka planı
Geleneksel MapReduce modeli her MapReduce işlemi turundan sonra ortaya çıkan verilerin Hadoop Dağıtık Dosya Sistemi (HDFS) veya bir MaxCompute tablosu gibi dağıtık bir dosya sisteminde saklanmasını gerektirir. Bir MapReduce iş akışı genellikle birden çok MapReduce işinden oluşur. Her iş tamamlandıktan sonra ara veriler bir diske yazılmalıdır. Ancak sonraki bir map görevi bir sonraki shuffle aşamasından önce bu verileri yalnızca bir kez okumak isteyebilir. Bu süreç gereksiz disk G/Ç işlemleri yaratır.
MaxCompute'ün hesaplama ve zamanlama mantığı daha karmaşık programlama modellerini destekler. Bu durumu ele almak için MaxCompute ara bir map işlemi olmadan bir reduce işleminden hemen sonra başka bir reduce işlemi çalıştırmanıza olanak tanır. Bu nedenle MaxCompute bir map işleminden sonra birden çok reduce işleminin zincirlenmesini destekleyen (örneğin Map > Reduce > Reduce) genişletilmiş bir MapReduce modeli sağlar.
Hadoop Chain Mapper ve ChainReducer ile karşılaştırma
Hadoop Chain Mapper ve ChainReducer da benzer seri map veya reduce işlemlerini destekler. Ancak bunlar MaxCompute'ün genişletilmiş MapReduce (MR2) modelinden temelde farklıdır.
Chain Mapper ve ChainReducer geleneksel MapReduce modeline dayanır. Bunlar yalnızca orijinal map veya reduce işleminden sonra bir veya daha fazla map işlemi eklemenize olanak tanır. Bir reduce işlemi ekleyemezsiniz. Bu yaklaşımın avantajı mevcut mapper iş mantığını yeniden kullanarak bir map veya reduce işlemini birden çok mapper aşamasına bölebilmenizdir. Ancak bu durum temel zamanlama ve G/Ç modellerini temelden değiştirmez.