PyODPS kurulumu, içe aktarımı ve kullanımı hakkında sıkça sorulan sorular (SSS).
Yükleme sırasında hata: "Warning: XXX not installed"
Neden: Gerekli bir bileşen eksik.Çözüm: Hata mesajındaki XXX yer tutucusundan eksik bileşeni belirleyin ve pip komutunu çalıştırarak bu bileşeni yükleyin.
Yükleme sırasında hata: "Project Not Found"
Bu hata aşağıdaki nedenlerden biriyle oluşur:
Hatalı uç nokta yapılandırması: Uç nokta yanlış yapılandırılmıştır. Hedef proje için uç noktayı kullanın. Uç noktalar hakkında daha fazla bilgi için bkz. Uç Noktalar.
Hatalı parametre konumu: MaxCompute giriş nesnesi için parametreler yanlış konumlarda belirtilmiştir. Parametrelerin doğru girildiğini doğrulayın. MaxCompute giriş nesnesi parametreleri hakkında daha fazla bilgi için bkz. PyODPS düğümlerini DataWorks'ten şirket içi ortama taşıma.
Yükleme sırasında hata: "Syntax Error"
Bu hata, Python sürümünün çok eski olmasından kaynaklanır. PyODPS, Python 2.6, 2.7.6 veya üzeri ya da 3,3 veya üzeri sürümleri gerektirir. Python 2.5 ve önceki sürümler desteklenmez.
macOS'ta yükleme hatası: "Permission Denied"
PyODPS'i yüklemek için aşağıdaki komutu çalıştırın: sudo pip install pyodps.
macOS'ta yükleme hatası: "Operation Not Permitted"
Bu hata Sistem Bütünlüğü Koruması (SIP) nedeniyle oluşur. Bu sorunu çözmek için cihazınızı yeniden başlatın ve Kurtarma Moduna girmek için başlatma sırasında ⌘+R tuşlarına basın. Ardından Terminal'i açın ve aşağıdaki komutları çalıştırın.
csrutil disable
reboot
Daha fazla bilgi için bkz. Operation Not Permitted when on root - El Capitan (rootless disabled).
İçe aktarma hatası: "No Module Named ODPS"
ODPS paketi yüklenemiyor. Olası nedenler şunlardır:
-
Neden 1: Arama yolunda ad çakışması
Arama yolu (genellikle geçerli dizin),
odps.pyveyainit.pyadlı bir dosya veya odps adlı bir dizin içeriyor. Bu durum, yüklü PyODPS paketiyle çakışmaya neden olur.Çözüm:Çakışan ada sahip bir dizin varsa bunu yeniden adlandırın.
Daha önce odps adlı farklı bir Python paketi yüklediyseniz,
sudo pip uninstall odpskomutunu çalıştırarak kaldırın.
-
Neden 2: Birden çok Python sürümü yüklü
Betiğiniz PyODPS'in yüklü olmadığı bir Python ortamında çalışıyor olabilir.Çözüm: PyODPS'in yüklü olduğu doğru Python yorumlayıcısını kullandığınızdan emin olun veya şu anda kullandığınız sürüm için PyODPS'i yükleyin.
-
Neden 3: PyODPS yüklü değil
Paket mevcut Python ortamına hiç yüklenmemiş.Çözüm: PyODPS'i yükleyin. Daha fazla bilgi için bkz. PyODPS Yükleme.
İçe aktarma hatası: "Cannot Import Name ODPS"
Geçerli çalışma dizininizde odps.py adlı bir dosya olup olmadığını kontrol edin. Varsa, içe aktarma ifadesini tekrar çalıştırmadan önce dosyayı yeniden adlandırın.
İçe aktarma hatası: "Cannot Import Module odps"
Bu hata genellikle PyODPS kurulumunuzla ilgili bir bağımlılık sorununu gösterir. PyODPS teknik destek DingTalk grubuna katılmak ve yardım almak için grup yöneticisiyle iletişime geçmek üzere bu bağlantıyı tıklayın.
IPython veya Jupyter'de "ImportError"
Kodunuzun başlangıcına from odps import errors eklemeyi deneyin. Sorun devam ederse bu durum eksik bir IPython bağımlılığından kaynaklanıyor olabilir. Sorunu çözmek için sudo pip install -U jupyter komutunu çalıştırın.
size niteliği
size niteliği, tablonun fiziksel boyutunu temsil eder.
Tunnel uç noktası nasıl ayarlanır?
Tunnel uç noktasını ayarlamak için options.tunnel.endpoint kullanın. Daha fazla bilgi için aliyun-odps-python-sdk seçenekleri belgelerine bakın.
CPython üçüncü taraf paketlerini kullanma
Bunları Wheel formatında paketlemenizi öneririz. Daha fazla bilgi için bkz. MaxCompute'te kullanılabilecek crcmod paketi oluşturma.
DataFrame'in veri işleme sınırı
PyODPS DataFrame'in işleyebileceği verilerde sınır yoktur çünkü işlemler MaxCompute görevlerine dönüştürülür. Ancak yerel pandas DataFrame'i makinenizin kullanılabilir belleğiyle sınırlıdır.
DataFrame'de max_pt nasıl kullanılır?
MaxCompute yerleşik işlevlerini çağırmak için odps.df.func modülünü kullanın.
from odps.df import func
df = o.get_table('your_table').to_df()
df[df.ds == func.max_pt('your_project.your_table')]  # ds is a partition column.
open_writer() ile write_table() arasındaki fark nedir?
write_table() çağrısının her biri sunucuda yeni bir dosya oluşturur ve bu durum önemli bir ek yük getirir. Çok sayıda küçük dosya sorgu performansını düşürür ve sunucuda bellek yetersizliği hatalarına neden olabilir. Birden çok veri toplu işini aynı anda yazmanızı veya bir üretici nesnesi iletmenizi öneririz. Örnek için bkz. Tabloya veri yazma.
Buna karşılık, open_writer() verileri bloklar halinde yazmanıza olanak tanıyan bir oturum oluşturur; bu yöntem akış veya yinelemeli yüklemeler için daha verimlidir.
DataWorks ve yerel betik arasında veri tutarsızlığı
Varsayılan olarak Instance Tunnel DataWorks'te devre dışıdır. Bu durumda instance.open_reader 10.000 kayıtla sınırlı olan Result API'sini kullanır.
Instance Tunnel'ı etkinleştirdikten sonra toplam kayıt sayısını almak için reader.count kullanabilirsiniz. Tüm veriler üzerinde yineleme yapmak için options.tunnel.limit_instance_tunnel = False ayarını yaparak limiti devre dışı bırakmanız gerekir.
Bir DataFrame'den gerçek sayı nasıl alınır?
-
PyODPS'i yükledikten sonra MaxCompute tablosundan bir DataFrame oluşturmak için Python ortamınızda aşağıdaki komutu çalıştırın.
iris = DataFrame(o.get_table('pyodps_iris')) -
Toplam satır sayısını almak için DataFrame üzerinde
count()yöntemini çağırın.iris.count() -
DataFrame üzerindeki işlemler tembel yürütülür.
execute()gibi bir eylem yöntemini açıkça çağırana kadar çalışmazlar.count()işleminin hemen çalışmasını zorlamak için bunuexecute()yöntemiyle zincirleyin.df.count().execute()
Gerçek değerler döndüren yöntemler hakkında daha fazla bilgi için bkz. Toplama işlemleri. PyODPS'te tembel yürütme hakkında daha fazla bilgi için bkz. Sonuçları yürütme ve alma.
"sourceIP is not in the white list" hatası
Erişmeye çalıştığınız MaxCompute projesi bir IP izin listesi tarafından korunmaktadır. Makinenizin IP adresini izin listesine eklemek için proje sahibiyle iletişime geçin. Daha fazla bilgi için bkz. IP izin listesini yönetme.
options.sql.settings ortamı ayarlayamıyor
-
Belirti
PyODPS kullanarak bir SQL sorgusu çalıştırmadan önce MaxCompute çalışma zamanı ortamını yapılandırmak için aşağıdaki kodu kullanırsınız.
from odps import options
options.sql.settings = {'odps.sql.mapper.split.size': 32}
Görevi çalıştırdıktan sonra yalnızca altı eşleyici başlatılır; bu durum ayarın etkili olmadığını gösterir. İstemcide
set odps.stage.mapper.split.size=32komutunu çalıştırdığınızda görev bir dakika içinde tamamlanır. -
Neden
PyODPS'te kullanılan parametre adı, istemcide kullanılan addan farklıdır. İstemci parametresi
odps.stage.mapper.split.sizeiken PyODPS parametresiodps.sql.mapper.split.sizeşeklindedir. -
Çözüm
Kodunuzdaki parametre adını
odps.stage.mapper.split.sizeolarak değiştirin.
head() çağrılırken "IndexError"
list[index] mevcut olmadığından veya list[index] aralık dışında olduğundan kaynaklanır.
pandas DataFrame MaxCompute'e yüklenirken hata: "ODPSError"
-
Belirti
Bir pandas DataFrame'i MaxCompute'e yüklediğinizde aşağıdaki hata döndürülür.
ODPSError: ODPS entrance should be provided. -
Neden
Genel bir MaxCompute nesne giriş noktası eksik.
-
Çözüm
Genel bir giriş noktası yapılandıran Room mekanizmasını
%enterkullanın.MaxCompute nesne giriş noktanızda
to_global()yöntemini çağırın.ODPS nesnesini doğrudan bir parametre olarak iletin:
DataFrame(pd_df).persist('your_table', odps=odps).
"lifecycle is not specified" hatası
-
Belirti
DataFrame kullanarak bir tabloya veri yazdığınızda aşağıdaki hata döndürülür.
table lifecycle is not specified in mandatory mode -
Neden
Hedef projede tüm tablolar için bir yaşam döngüsü belirtilmesi gerekir ancak siz belirtmediniz.
-
Çözüm
Yazma işlemini gerçekleştirmeden önce betiğinizde tablo yaşam döngüsünü belirtin.
from odps import options
options.lifecycle = 7  # Specify the lifecycle value. The value is an integer in days.
"datastream from server is crushed" hatası
Bu hata genellikle kirli verilerden kaynaklanır. Verilerinizin hedef tablo ile aynı sayıda sütuna sahip olduğunu doğrulayın.
"Project is protected" hatası
Proje üzerindeki bir güvenlik ilkesi tablo verilerini okumanızı engeller. Tam veri kümesine erişmek için aşağıdaki yöntemlerden birini kullanın:
Proje sahibiyle iletişime geçerek erişiminiz için bir istisna kuralı eklemesini isteyin.
Verilerin hassasiyetini gidermek, bunları korumalı olmayan bir projeye dışa aktarmak ve ardından oradan okumak için DataWorks veya başka bir araç kullanın.
Verilerin yalnızca bir alt kümesini görüntülemek için aşağıdaki yöntemlerden birini kullanın (10.000 kayıt sınırı geçerlidir):
execute_sql yöntemini kullanın:
o.execute_sql('select * from <table_name>').open_reader().Tabloyu bir DataFrame'e dönüştürün:
o.get_table('<table_name>').to_df().
Aralıklı "ConnectionError: timed out" hatası
Bu hatanın aşağıdaki nedenleri olabilir:
-
Bağlantı zaman aşımı: PyODPS için varsayılan bağlantı zaman aşımı 5 saniyedir. Ağ kararsızsa bağlantı başarısız olabilir. Aşağıdaki çözümlerden birini kullanabilirsiniz:
-
Betikinizin başlangıcına aşağıdaki kodu ekleyerek zaman aşımı aralığını artırın.
# Workaround to increase timeout
from odps import options
options.connect_timeout = 30
Özel durumu işlemek için kodunuzda bir yeniden deneme mekanizması uygulayın.
-
Sandbox kısıtlamaları: Sandbox ortamları ağ erişimi kısıtlamalarına sahip olabilir. Bu sorunu çözmek için görevi çalıştırmak üzere özel bir zamanlama kaynak grubu kullanmanızı öneririz.
get_sql_task_cost() için "is not defined" hatası
-
Belirti
get_sql_task_cost işlevini çalıştırdığınızda aşağıdaki hata döndürülür.
NameError: name 'get_task_cost' is not defined. -
Neden
İşlev adı yanlış.
-
Çözüm
get_sql_task_cost yerine execute_sql_cost kullanın.
PyODPS günlüklerinde Çince karakterler nasıl doğru şekilde görüntülenir?
Bu sorunu print ("My name is %s" % ('abc')) gibi bir print biçim dizesi kullanarak çözebilirsiniz. Bu sorun genellikle yalnızca Python 2'de oluşur.
instance tunnel devre dışı bırakıldığında DATETIME STRING'e dönüşür
Open_Reader çağrıldığında PyODPS varsayılan olarak eski Result arabirimini kullanır. Sonuç olarak sunucudan döndürülen veriler CSV formatındadır ve tüm DATETIME değerleri STRING türündedir.
Bu sorunu çözmek için options.tunnel.use_instance_tunnel = True ayarını yaparak Instance Tunnel'ı etkinleştirin. Bu işlem PyODPS'in özgün veri türlerini koruyan Instance Tunnel hizmetini kullanmasını sağlar.
Python ile gelişmiş özellikleri uygulama
-
Yeniden kullanılabilir Python işlevleri yazma
Öklid veya Manhattan mesafesi gibi farklı yöntemlerle iki nokta arasındaki mesafeyi hesaplama gibi yaygın hesaplamalar için bir dizi işlev tanımlayabilirsiniz. Daha sonra ihtiyaca göre uygun işlevi çağırabilirsiniz.
def euclidean_distance(from_x, from_y, to_x, to_y):
    return ((from_x - to_x) ** 2 + (from_y - to_y) ** 2).sqrt()

def manhattan_distance(from_x, from_y, to_x, to_y):
   return (from_x - to_x).abs() + (from_y - to_y).abs()
Örnek çağrı:
In [42]: df from_x from_y to_x to_y 0 0.393094 0.427736 0.463035 0.105007 1 0.629571 0.364047 0.972390 0.081533 2 0.460626 0.530383 0.443177 0.706774 3 0.647776 0.192169 0.244621 0.447979 4 0.846044 0.153819 0.873813 0.257627 5 0.702269 0.363977 0.440960 0.639756 6 0.596976 0.978124 0.669283 0.936233 7 0.376831 0.461660 0.707208 0.216863 8 0.632239 0.519418 0.881574 0.972641 9 0.071466 0.294414 0.012949 0.368514 In [43]: euclidean_distance(df.from_x, df.from_y, df.to_x, df.to_y).rename('distance') distance 0 0.330221 1 0.444229 2 0.177253 3 0.477465 4 0.107458 5 0.379916 6 0.083565 7 0.411187 8 0.517280 9 0.094420 In [44]: manhattan_distance(df.from_x, df.from_y, df.to_x, df.to_y).rename('distance') distance 0 0.392670 1 0.625334 2 0.193841 3 0.658966 4 0.131577 5 0.537088 6 0.114198 7 0.575175 8 0.702558 9 0.132617 -
Python'ın koşullu ve döngü deyimlerini kullanma
Bir yapılandırmaya göre tablo alanlarını işlemek ve ardından tüm tablolar arasında UNION veya JOIN gerçekleştirmek için SQL karmaşık olabilir. PyODPS DataFrame'leri bu süreci basitleştirir.
Örneğin, 30 tabloyu tek bir tabloda birleştirmek için 30 UNION ALL yan tümcesi içeren bir SQL sorgusu yazmanız gerekir. PyODPS ile aynı sonucu aşağıdaki kodla elde edebilirsiniz.
table_names = ['table1', ..., 'tableN']
dfs = [o.get_table(tn).to_df() for tn in table_names]
reduce(lambda x, y: x.union(y), dfs)

# The reduce statement is equivalent to the following code.
df = dfs[0]
for other_df in dfs[1:]:
    df = df.union(other_df)
pandas arka ucunu kullanarak yerel olarak nasıl hata ayıklanır?
Yerel hata ayıklamayı iki şekilde gerçekleştirebilirsiniz. Başlatma yöntemi farklıdır ancak sonraki kod aynıdır:
Bir pandas DataFrame'inden oluşturulan bir PyODPS DataFrame'i pandas kullanarak yerel hesaplamalar gerçekleştirebilir.
Bir MaxCompute tablosundan oluşturulan bir DataFrame MaxCompute üzerinde çalışır.
Aşağıdaki örnek kod, yerel hata ayıklama ile MaxCompute üzerinde tam yürütme arasında nasıl geçiş yapılacağını gösterir.
df = o.get_table('movielens_ratings').to_df()
DEBUG = True
if DEBUG:
    # Use a small subset of data for local debugging
    df = df[:100].to_pandas(wrap=True)
Kodunuzu yazdıktan sonra hızlı yineleme için yerel olarak test edin. Test tamamlandığında tam hesaplamayı MaxCompute üzerinde çalıştırmak için DEBUG değerini False olarak değiştirin.
Yerel PyODPS programlarında hata ayıklamak için MaxCompute Studio'yu kullanmanızı öneririz.
İç içe döngülerde yavaş çalıştırmadan nasıl kaçınılır?
Döngü sonuçlarını bir Python dict veya listesinde toplayın ve DataFrame nesnesini döngü dışında oluşturun. df=XXX gibi DataFrame oluşturma kodunu dış döngünün içine yerleştirmek her yinelemede yeni bir DataFrame nesnesi oluşturur ve bu da yürütmeyi önemli ölçüde yavaşlatır.
Verilerin yerel makineye indirilmesinden nasıl kaçınılır?
Daha fazla bilgi için bkz. Verilerin yerel makineye indirilmesini önlemek için PyODPS düğümü kullanma.
Yerel işlem için veri indirme zamanı
Aşağıdaki senaryolarda PyODPS verilerini yerel işlem için indirin:
Veri miktarı küçüktür ve yerel makinenizin belleğine sığabilir.
-
Bir satırı birden çok satıra genişleten satır satır işlemler gerçekleştirmeniz veya her satıra karmaşık bir Python işlevi uygulamanız gerekir. PyODPS DataFrame'i MaxCompute paralel hesaplamadan yararlanarak bunu verimli bir şekilde yönetir.
Örneğin, anahtar-değer çiftlerine göre her JSON nesnesini birden çok satıra genişletmek istediğinizde JSON dizeleri içeren bir sütununuz varsa aşağıdaki kodu kullanabilirsiniz.
In [12]: df
               json
0  {"a": 1, "b": 2}
1  {"c": 4, "b": 3}

In [14]: from odps.df import output

In [16]: @output(['k', 'v'], ['string', 'int'])
    ...: def h(row):
    ...:     import json
    ...:     for k, v in json.loads(row.json).items():
    ...:         yield k, v
    ...:

In [21]: df.apply(h, axis=1)
   k  v
0  a  1
1  b  2
2  c  4
3  b  3
open_reader ile 10.000'den fazla kayıt nasıl alınır?
SQL sorgusunun sonucunu yeni bir tabloya kaydetmek için CREATE TABLE ... AS SELECT ... kullanın ve ardından o tablodan tam verileri okumak için table.open_reader kullanın.
Yerleşik operatörler ve UDF'ler
Kullanıcı tanımlı bir işlev (UDF), yerleşik bir operatörden çok daha yavaştır. Bu nedenle mümkün olduğunca yerleşik bir operatör kullanın.
Bir milyon satırlık bir veri kümesinde yapılan bir testte, her satıra bir UDF uygulamak yürütme süresini 7 saniyeden 27 saniyeye çıkardı.
DataFrame şemasından boş bölüm değeri
Bu durum bir DataFrame'in bölüm sütunlarını ve normal sütunları aynı şekilde ele almasından kaynaklanır. Sonuç olarak, bir DataFrame nesnesindeki schema.partitions temel tablonun bölüm sütunları hakkında bilgi sağlamaz. Bölüm sütununu normal bir sütun olarak kullanarak verileri filtreleyebilirsiniz.
df = o.get_table('your_table').to_df()
print(df[df.ds == 'your_partition_value'].execute())
Bölüm meta verileriyle çalışmak için tablo nesnesi tarafından sağlanan yöntemleri kullanmanızı öneririz. Daha fazla bilgi için bkz. Tablolar.
PyODPS DataFrame ile Kartezyen çarpım nasıl yapılır?
Daha fazla bilgi için bkz. PyODPS DataFrame'de Kartezyen çarpımı işleme.
PyODPS'te Jieba Çince kelime bölme nasıl uygulanır?
Daha fazla bilgi için bkz. Jieba ile Çince kelime bölme gerçekleştirmek için PyODPS düğümü kullanma.
PyODPS kullanılarak tam veri kümeleri nasıl indirilir?
Varsayılan olarak PyODPS bir Instance'tan okunan verileri sınırlamaz. Ancak korumalı MaxCompute projeleri için Tunnel indirmeleri kısıtlanmıştır. options.tunnel.limit_instance_tunnel ayarlanmamışsa bir veri boyutu sınırı otomatik olarak etkinleştirilir ve indirilebilecek kayıt sayısı MaxCompute yapılandırmasıyla (genellikle 10.000 kayıt) sınırlanır. Tüm verileri yinelemeli olarak almak için Instance Tunnel özelliğini genel olarak etkinleştirmek ve limit özelliğini devre dışı bırakmak için aşağıdaki ifadeleri kullanarak limit özelliğini devre dışı bırakın.
options.tunnel.use_instance_tunnel = True
options.tunnel.limit_instance_tunnel = False  # Disable the limit to read all data.

with instance.open_reader() as reader:
    # You can read the full dataset through the Instance Tunnel.
Null oranı hesaplaması için execute_sql ve DataFrame
DataFrame toplamalar için daha iyi performans sağlar. Toplama işlemlerini gerçekleştirmek için DataFrame kullanmanızı öneririz.
PyODPS'te veri türleri nasıl yapılandırılır?
PyODPS'te yeni veri türlerini aşağıdaki yöntemlerden birini kullanarak etkinleştirin:
execute_sqlyöntemini kullanarak yeni veri türlerini etkinleştirmek içino.execute_sql('set odps.sql.type.system.odps2=true;query_sql', hints={"odps.sql.submit.mode" : "script"})komutunu çalıştırın.-
persist,executeveyato_pandasgibi DataFrame işlemleri için yeni veri türlerini etkinleştirmek amacıylahintsparametresini kullanabilirsiniz. Bu şekilde belirtilen ayarlar yalnızca tek bir görev için geçerlidir.from odps.df import DataFrame users = DataFrame(o.get_table('odps2_test')) users.persist('copy_test',hints={'odps.sql.type.system.odps2':'true'})Ayarları tüm DataFrame işlemleri için genel olarak etkinleştirmek için
options.sql.use_odps2_extension = Trueseçenek parametresini ayarlayın.
Decimal türüyle "ValueError"
Bu sorunu aşağıdaki yollardan biriyle çözebilirsiniz:
SDK'yı V0.8.4 veya üzeri bir sürüme yükseltin.
-
Kodunuza aşağıdaki ifadeleri ekleyin:
from odps.types import Decimal
Decimal._max_precision=38
PyODPS'te yavaş SQL yürütmesi nasıl giderilir?
PyODPS bir SQL görevi göndermeden önce yoğun işlemler gerçekleştirmez. Çoğu durumda yavaş SQL yürütmesi PyODPS ile ilgili değildir. Nedeni belirlemek için şu adımları izleyin:
-
Ağ ve sunucu gecikme sürelerini kontrol etme
Görev gönderiminin geçtiği proxy sunucusundaki veya ağ bağlantısındaki gecikmeleri kontrol edin.
Görev kuyruğa alma gecikmeleri gibi sunucu tarafı sorunlarını kontrol edin.
-
Veri okuma verimliliğini değerlendirme
SQL yürütmeniz büyük miktarda veri okumayı içeriyorsa okuma hızının büyük veri hacmi veya aşırı sayıda veri parçası nedeniyle yavaş olup olmadığını kontrol edin. Aşağıdaki adımları gerçekleştirin:
Görev gönderimini veri okumadan ayırmayı deneyebilirsiniz. Bunun için run_sql kullanarak görevi gönderin, instance.wait_for_success kullanarak görevin tamamlanmasını bekleyin ve ardından instance.open_reader kullanarak verileri okuyun ve her ifadenin neden olduğu gecikmeyi belirleyin. Aşağıda bu ayrımın bir örneği verilmiştir:
-
Ayrılmadan önce:
with o.execute_sql('select * from your_table').open_reader() as reader: for row in reader: print(row) -
Ayrıldıktan sonra:
inst = o.run_sql('select * from your_table')
inst.wait_for_success()
with inst.open_reader() as reader:
    for row in reader:
        print(row)
-
-
DataWorks görev durumunu doğrulama (varsa)
DataWorks'te gönderilen görevler için özellikle PyODPS sürümü 0.11.6'dan düşükken başarılı bir şekilde gönderilen ancak Logview oluşturamayan SQL görevlerini kontrol edin. Bu görevler genellikle execute_sql veya run_sql yöntemleri kullanılarak gönderilir.
-
Yerel ortam faktörlerini analiz etme
Sorunun yerel ortamınızla ilgili olup olmadığını belirlemek için hata ayıklama günlüğünü etkinleştirmenizi öneririz. PyODPS tüm istekleri ve yanıtları yazdırır; bu sayede gecikmenin nerede oluştuğunu tespit edebilirsiniz.
Örnek:
import datetime
import logging
from odps import ODPS

logging.basicConfig(level=logging.DEBUG, format='%(asctime)s - %(name)s - %(levelname)s - %(message)s')
o = ODPS(...)  #  Enter your credentials here. Ignore this if a MaxCompute entry is already provided in the environment.
# Print the local time to determine when the local operation was initiated.
print("Check time:", datetime.datetime.now())
# Submit the task.
inst = o.run_sql("select * from your_table")
Standart çıktı aşağıdakine benzer olmalıdır:
Check time: 2025-01-24 15:34:21.531330
2025-01-24 15:34:21,532 - odps.rest - DEBUG - Start request.
2025-01-24 15:34:21,532 - odps.rest - DEBUG - POST: http://service.<region>.maxcompute.aliyun.com/api/projects/<project>/instances
2025-01-24 15:34:21,532 - odps.rest - DEBUG - data: b'<?xml version="1.0" encoding="utf-8"?>\n<Instance>\n  <Job>\n    <Priority>9</Priority>\n    <Tasks>\n      <SQL>\n        ....
2025-01-24 15:34:21,532 - odps.rest - DEBUG - headers: {'Content-Type': 'application/xml'}
2025-01-24 15:34:21,533 - odps.rest - DEBUG - request url + params /api/projects/<project>/instances?curr_project=<project>
2025-01-24 15:34:21,533 - odps.accounts - DEBUG - headers before signing: {'Content-Type': 'application/xml', 'User-Agent': 'pyodps/0.12.2 CPython/3.7.12', 'Content-Length': '736'}
2025-01-24 15:34:21,533 - odps.accounts - DEBUG - headers to sign: OrderedDict([('content-md5', ''), ('content-type', 'application/xml'), ('date', 'Fri, 24 Jan 2025 07:34:21 GMT')])
2025-01-24 15:34:21,533 - odps.accounts - DEBUG - canonical string: POST

application/xml
Fri, 24 Jan 2025 07:34:21 GMT
/projects/maxframe_ci_cd/instances?curr_project=maxframe_ci_cd
2025-01-24 15:34:21,533 - odps.accounts - DEBUG - headers after signing: {'Content-Type': 'application/xml', 'User-Agent': 'pyodps/0.12.2 CPython/3.7.12', 'Content-Length': '736', ....
2025-01-24 15:34:21,533 - urllib3.connectionpool - DEBUG - Resetting dropped connection: service.<region>.maxcompute.aliyun.com
2025-01-24 15:34:22,027 - urllib3.connectionpool - DEBUG - http://service.<region>.maxcompute.aliyun.com:80 "POST /api/projects/<project>/instances?curr_project=<project> HTTP/1.1" 201 0
2025-01-24 15:34:22,027 - odps.rest - DEBUG - response.status_code 201
2025-01-24 15:34:22,027 - odps.rest - DEBUG - response.headers:
{'Server': '<Server>', 'Date': 'Fri, 24 Jan 2025 07:34:22 GMT', 'Content-Type': 'text/plain;charset=utf-8', 'Content-Length': '0', 'Connection': 'close', 'Location': ....
2025-01-24 15:34:22,027 - odps.rest - DEBUG - response.content: b''
Bu çıktı kodun görevi başlattığı zamanı (2025-01-24 15:34:21.531), isteğin gönderildiği zamanı (2025-01-24 15:34:21.533) ve sunucunun yanıt döndürdüğü zamanı (2025-01-24 15:34:22.027) gösterir. Bu sayede her aşamanın zaman maliyetini belirleyebilirsiniz.
PyODPS kullanılarak bir MaxCompute tablosunun dosya sayısı ve son değiştirilme zamanı nasıl alınır?
-
Sorun açıklaması
MaxCompute istemcisi (odpscmd) veya bir DataWorks MaxCompute SQL düğümü üzerinden DESC EXTENDED table_name ya da DESC EXTENDED table_name PARTITION (xxx='xxx') çalıştırıldığında dosya sayısı (file_num), fiziksel boyut ve son değiştirilme zamanı gibi ayrıntılı tablo meta verileri döndürülür.
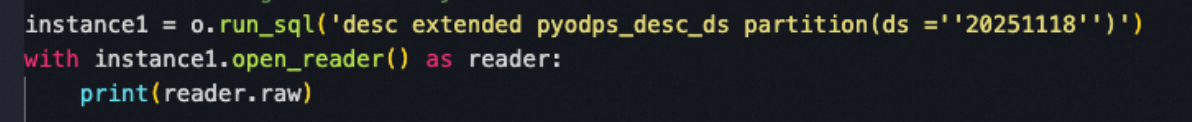
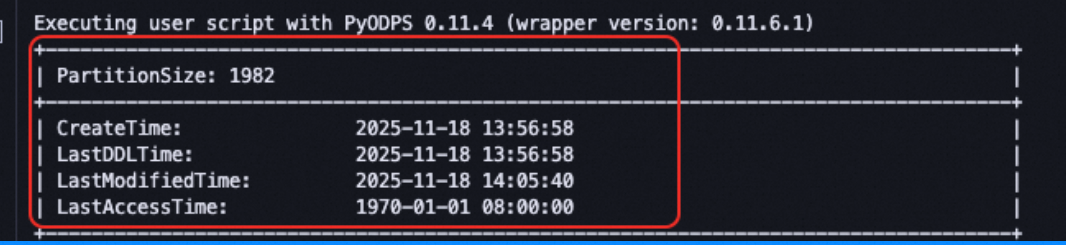
Ancak PyODPS run_sql() veya execute_sql() yöntemi üzerinden DESC EXTENDED çalıştırıldığında genişletilmiş bilgiler (file_num gibi) tam olarak döndürülmez; bu da bu ölçümlerin yapılandırılmış bir şekilde çıkarılmasını imkansız kılar.
-
Çözüm
Bu istatistikleri almak için table.reload_extend_info() veya partition.reload() gibi PyODPS yerel SDK arabirimlerini kullanın. Kaynak kodunu görüntülemek için bağlantıyı tıklayın.
Aşağıdaki örnek her bölümün dosya sayısının nasıl alınacağını gösterir:
from odps.models import Partition

  # Replace with the actual table name
  table_name = 'your_real_table_name'

  # ========== 1. Get the table object ==========
  try:
      # Assume that o is an initialized ODPS object
      # In a DataWorks PyODPS node, uncomment the following line
      # o = odps
      table = o.get_table(table_name)
      print(f"Table object obtained: {table_name}")
  except Exception as e:
      print(f"Error: Failed to obtain table '{table_name}'. Cause: {str(e)}")
      raise

  # ========== 2. Check whether the table is partitioned ==========
  if not table.table_schema.partitions:
      print(f"Table '{table_name}' is not a partitioned table. Partition query
  is not supported.")
  else:
      print(f"Table '{table_name}' is a partitioned table. Iterating over all
  partitions...")
      print("=" * 60)

      # ========== 3. Iterate over partitions by using table.partitions
  ==========
      partition_count = 0
      try:
          for partition in table.partitions:
              try:
                  part_spec = partition.spec
                  if not part_spec:
                      part_spec = 'Unknown partition'

                  # partition.reload() loads detailed partition metadata
                  # This triggers one or more API calls to MaxCompute Metastore
                  partition.reload()

                  print(f"Partition Spec: {part_spec}")
                  print(f"  - Creation Time      : {partition.creation_time}")
                  print(f"  - Last Modified Time :
  {partition.last_data_modified_time}")
                  print(f"  - Physical Size      : {partition.physical_size}
  bytes")
                  print(f"  - File Count         : {partition.file_num}")
                  print(f"  - Is Archived        : {partition.is_archived}")
                  print("-" * 60)

                  partition_count += 1

              except Exception as e_inner:
                  print(f"Warning: Failed to load details for partition
  {partition.spec or ''}. Cause: {str(e_inner)}")
                  print("-" * 60)
                  continue

          print(f"Iteration complete: {partition_count} partitions processed.")

      except Exception as e_outer:
          print(f"Fatal error during partition iteration. Cause:
  {str(e_outer)}")