Bu konu, açık kaynak Elasticsearch hakkında sıkça sorulan soruları yanıtlar.
Genel Bakış
Dizinler için iş parçacığı havuzu boyutunu nasıl yapılandırırım?
Bir dizini sorgularken "statusCode: 500" hatası görüntüleniyor. Ne yapmalıyım?
auto_create_index parametresinin değerini nasıl değiştiririm?
OSS'te depolanan bir anlık görüntü oluşturmak ne kadar sürer?
Kibana konsolunda veri görselleştirme için saat dilimini nasıl değiştiririm?
Elasticsearch terim sorgularını hangi tür veriler üzerinde çalıştırabilirim?
Elasticsearch'te takma ad kullanırken dikkat edilmesi gereken noktalar nelerdir?
Sorgu sırasında too_many_buckets_exception hatası döndürülürse ne yapmalıyım?
script.painless.regex.enabled parametresinin değerini değiştirebilir miyim?
Bir alanın toplanabilir olup olmadığını nasıl kontrol ederim?
Büyük ölçekli veri alma işlemleri için Elasticsearch kaydırma sorgularını nasıl kullanırım?
Kibana'da rol yönetimi girişini nasıl bulurum veya dizin eşlemelerini nasıl değiştiririm?
Dizinler için iş parçacığı havuzu boyutunu nasıl yapılandırırım?
İş parçacığı havuzu boyutunu değiştirmeden önce yazma iş parçacığı havuzunun baskı altında olup olmadığını doğrulayın. Kontrol etmek için aşağıdaki komutu çalıştırın:
GET /_cat/thread_pool?v=true&h=id,name,queue,active,rejected,completedYazma iş parçacığı havuzundaki reddedilen görevlerin tamamlananlara oranının yüksek olması, kuyruk boyutunun artırılması gerektiğini gösterir.
İş parçacığı havuzu boyutunu yapılandırmak için kümenizin YAML yapılandırma dosyasında thread_pool.write.queue_size parametresini ayarlayın. Daha fazla bilgi için bkz. YML dosyasını yapılandırma.
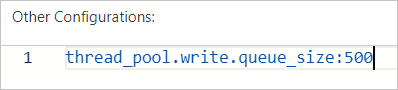
6.X sürümünden önceki Elasticsearch kümeleri için bunun yerine thread_pool.index.queue_size parametresini kullanın.
Bellek Yetersizliği (OOM) hatası alırsam ne yapmalıyım?
Önbelleği temizlemek için aşağıdaki komutu çalıştırın. Ardından nedeni analiz edin ve Elasticsearch kümenizin yapılandırmasını yükseltin veya iş yükünüzü ayarlayın.
curl -u elastic:<password> -XPOST "localhost:9200/<index_name>/_cache/clear?pretty"| Parametre | Açıklama |
|---|---|
<password> |
Elasticsearch kümenize erişmek için kullanılan parola. Küme oluşturma veya Kibana başlatma sırasında ayarlanır. |
<index_name> |
Önbelleğini temizlemek istediğiniz dizinin adı. |
Yükseltme talimatları için bkz. Küme yapılandırmasını yükseltme.
Bir parçayı manuel olarak nasıl yönetirim?
Reroute API'sini veya Cerebro aracını kullanın. Reroute API'siyle ilgili ayrıntılar için bkz. Cluster reroute API.
Elasticsearch için önbellek temizleme ilkeleri nelerdir?
Elasticsearch üç önbellek temizleme kapsamını destekler:
-
Tüm dizinlerin önbelleğini temizleme:
curl localhost:9200/_cache/clear?pretty -
Belirli bir dizinin önbelleğini temizleme:
curl localhost:9200/<index_name>/_cache/clear?pretty -
Birden fazla dizinin önbelleğini aynı anda temizleme:
curl localhost:9200/<index_name1>,<index_name2>,<index_name3>/_cache/clear?pretty
Dizin parçalarını nasıl yeniden yönlendiririm?
Parçalar kaybolursa veya yanlış tahsis edilirse bunları taşımak veya yeniden tahsis etmek için aşağıdaki komutu çalıştırın:
curl -XPOST 'localhost:9200/_cluster/reroute' -d '{
    "commands" : [ {
        "move" :
            {
              "index" : "test", "shard" : 0,
              "from_node" : "node1", "to_node" : "node2"
            }
        },
        {
          "allocate" : {
              "index" : "test", "shard" : 1, "node" : "node3"
          }
        }
    ]
}'
Bir dizini sorgularken "statusCode: 500" hatası görüntüleniyor. Ne yapmalıyım?
Aynı dizini sorgulamak için Cerebro gibi bir üçüncü taraf araç kullanın:
Sorgu Cerebro'da başarılı olursa dizin adı geçersizdir. Dizini yeniden adlandırın. Dizin adları yalnızca harf, alt çizgi (
_) ve rakam içerebilir.Sorgu Cerebro'da başarısız olursa sorun dizinde veya kümenin kendisindedir. Kümenin dizini içerip içermediğini ve normal çalışıp çalışmadığını kontrol edin.
auto_create_index parametresinin değerini nasıl değiştiririm?
Aşağıdaki komutu çalıştırın:
PUT /_cluster/settings
{
    "persistent" : {
        "action": {
          "auto_create_index": "false"
        }
    }
}auto_create_index varsayılan değeri false değeridir; bu, Elasticsearch'ün dizinleri otomatik olarak oluşturmasını engeller. Bu değeri değiştirmekten kaçının — değiştirirseniz Elasticsearch beklentilerinize uymayan eşlemeler veya ayarlarla aşırı sayıda dizin oluşturabilir.
OSS'te depolanan bir anlık görüntü oluşturmak ne kadar sürer?
Parça sayısı, bellek kullanımı, disk kullanımı ve CPU kullanımı normal düzeylerde olduğunda 80 GB dizin verisi için bir anlık görüntü oluşturmak yaklaşık 30 dakika sürer.
Bir dizin oluştururken parça sayısını nasıl belirlerim?
Toplam veri boyutunu her bir parçanın veri boyutuna bölerek parça sayısını elde edebilirsiniz. Her bir parçanın veri boyutunu 30 GB ile sınırlamanızı öneririz. Her bir parçanın veri boyutu 50 GB'ı aşarsa sorgu performansı ciddi şekilde etkilenir.
Dizin oluşturmayı hızlandırmak için parça sayısını uygun şekilde artırabilirsiniz. Parça sayısının az veya çok olması sorgu performansını etkiler.
Çok fazla parça — daha fazla dosya tanıtıcısı ve düğümler arası iletişim ek yükü, bu da sorguları yavaşlatır.
Çok az parça — her parça daha fazla veri tutar, bu da sorguları yavaşlatır.
Kendi yönettiğim Elasticsearch kümesinden veri geçişi yapmak için elasticsearch-repository-oss eklentisini kullandığımda bir hata görüntüleniyor. Ne yapmalıyım?
Hata mesajı:
ERROR: This plugin was built with an older plugin structure. Contact the plugin author to remove the intermediate "elasticsearch" directory within the plugin zip.Çözüm: ZIP paketini elasticsearch adından elasticsearch-repository-oss adına yeniden adlandırın, ardından plugins dizinine kopyalayın.
Kibana konsolunda veri görselleştirme için saat dilimini nasıl değiştiririm?
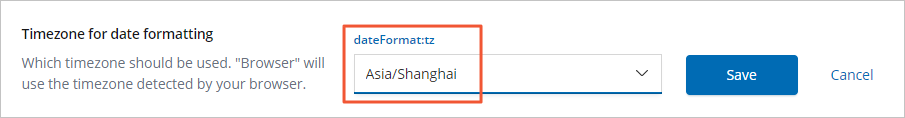
Saat dilimini doğrudan Kibana konsolunda değiştirin. Aşağıdaki örnek bir Elasticsearch 6.7.0 kümesini kullanır.
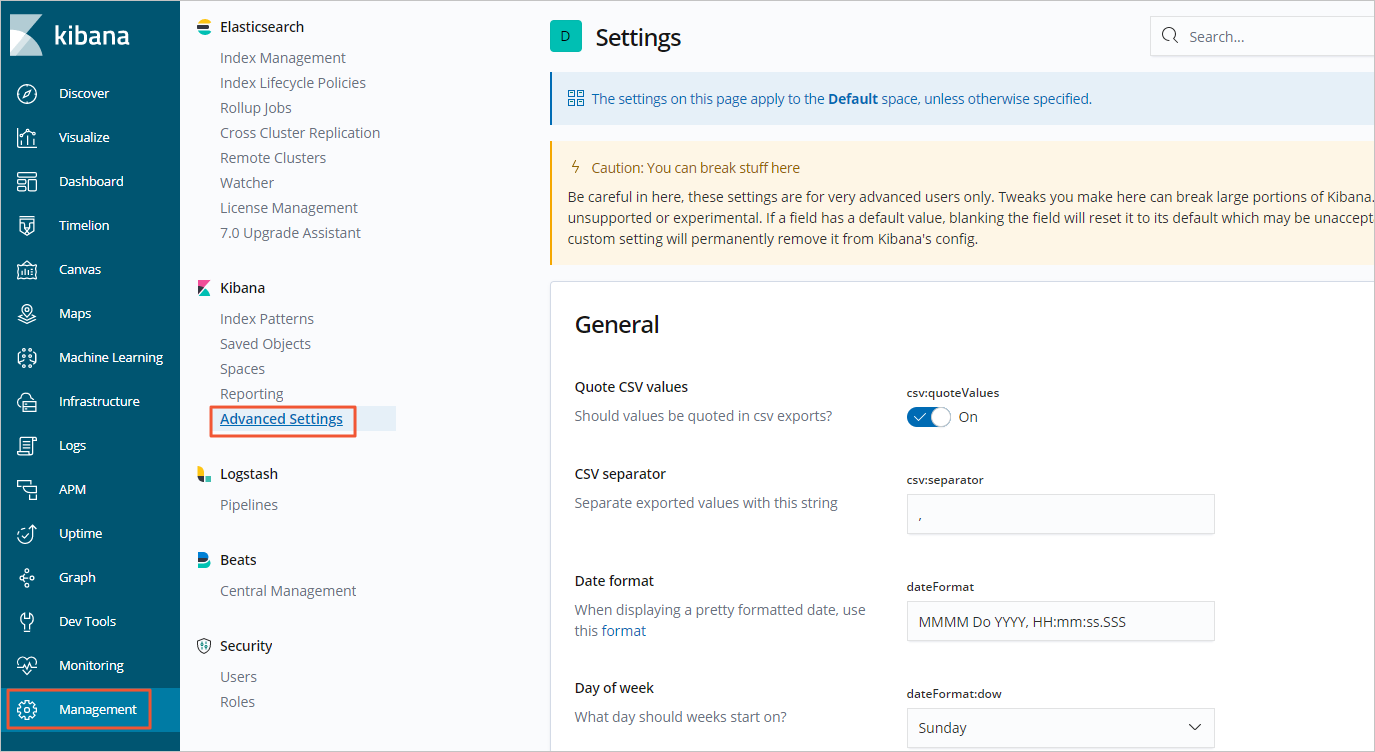
Aşağıdaki şekil seçilen saat dilimini gösterir.
Elasticsearch terim sorgularını hangi tür veriler üzerinde çalıştırabilirim?
Terim sorguları, yapılandırılmış veriler üzerinde çalışan kelime düzeyindeki sorgulardır: sayılar, tarihler ve anahtar sözcük alanları. Metni belirteçlere ayırmadan doğrudan ters dizinlerde arama yaparlar.
Metin alanları için tam metin sorguları kullanın — tam metin sorguları aramadan önce girişi belirteçlere ayırır.
Elasticsearch'te takma ad kullanırken dikkat edilmesi gereken noktalar nelerdir?
Aynı takma adı paylaşan tüm dizinlerdeki toplam parça sayısı 1.024'ten az olmalıdır.
Sorgu sırasında too_many_buckets_exception hatası döndürülürse ne yapmalıyım?
Hata mesajı:
"type": "too_many_buckets_exception", "reason": "Trying to create too many buckets. Must be less than or equal to: [10000] but was [10001]"10.000 kovaya olan sınırı aşmamak için kovaya dayalı toplamalarınızda size parametresini azaltın. Ayrıntılar için bkz. Limit the number of buckets that can be created in an aggregation. Ayrıca Increasing max_buckets for specific visualizations adresinde açıklanan yaklaşımı da izleyebilirsiniz.
Birden fazla dizini aynı anda nasıl silerim?
Elasticsearch varsayılan olarak toplu dizin silmeye izin vermez. Bunu etkinleştirmek için şunu çalıştırın:
PUT /_cluster/settings
{
  "persistent": {
     "action.destructive_requires_name": false
  }
}
Bu ayar etkili olduktan sonra birden fazla dizini aynı anda silmek için joker karakter kullanın.
script.painless.regex.enabled parametresinin değerini değiştirebilir miyim?
Varsayılan değer false değeridir. Painless betiklerindeki düzenli ifadeler önemli kaynak tüketir, bu nedenle betiklerinizde özellikle regex desteğine ihtiyaç duymadığınız sürece bu ayarı devre dışı bırakın.
Düzenli ifadeleri etkinleştirmek için elasticsearch.yml yapılandırma dosyasında script.painless.regex.enabled değerini true olarak ayarlayın.
Bir dizin için eşleme yapılandırmalarını, birincil parça sayısını veya çoğaltma parçası sayısını nasıl değiştiririm?
Eşleme yapılandırmaları
Mevcut bir dizinin eşlemesini değiştirmek yeniden indeksleme gerektirir. Desteklenen alan türleri için bkz. Data field type.
Birincil parçalar
Birincil parça sayısı, bir dizin oluşturulduktan sonra değiştirilemez. Mevcut sayı artık ihtiyaçlarınızı karşılamıyorsa verileri doğru parça sayısına sahip yeni bir dizine aktarmak için reindex API'sini kullanın.
Çoğaltma parçaları
Her bir birincil parça için çoğaltma parçası sayısını değiştirmek için şunu çalıştırın:
PUT test/_settings
{
  "number_of_replicas": 0
}Daha sonra maliyetli yeniden indekslemelerden kaçınmak için bir dizin oluşturmadan önce hem birincil hem de çoğaltma parça sayısını planlayın.
Bir alanın değerlerini nasıl depolarım?
Elasticsearch varsayılan olarak tek tek alan değerlerini depolamaz — yalnızca tam özgün JSON belgesini içeren ve sorgu zamanında herhangi bir alanı almanıza olanak tanıyan _source alanını depolar.
Belirli bir alanın değerlerini ayrı olarak depolamak için alanın eşlemesinde store: true ayarını yapın:
PUT /my_index
{
  "mappings": {
    "properties": {
      "my_field": {
        "type": "text",
        "store": true
      }
    }
  }
}Alan düzeyinde depolamayı etkinleştirmek disk kullanımını artırır. Alan değerlerini ayrı olarak depolamak için belirli bir nedeniniz yoksa bunun yerine _source kullanın.
Bir alanın toplanabilir olup olmadığını nasıl kontrol ederim?
Bir alanın toplanabilir olup olmadığı veri türüne ve temel alan verilerinin (doc_values veya fielddata) etkin olup olmamasına bağlıdır.
Varsayılan olarak toplanabilir alanlar
Sayısal, tarih ve anahtar sözcük alanları, sıralama, toplama ve betik oluşturma için optimize edilmiş sütun yönelimli bir depolama modeli kullanan doc_values aracılığıyla toplamayı destekler.
Metin alanları (varsayılan olarak toplanabilir değil)
Metin alanlarını toplamak için eşlemede fielddata'yı etkinleştirin:
PUT /my_index
{
  "mappings": {
    "properties": {
      "my_text_field": {
        "type": "text",
        "fielddata": true
      }
    }
  }
}Fielddata'yı etkinleştirmek, o alan için tüm metin verilerini JVM yığın belleğine yükler; bu da bellek kullanımını önemli ölçüde artırır.
Bir alan için toplamayı devre dışı bırakma
Bir alanın toplanmasını önlemek için:
Eşlemede alan için
enabled: falseayarını yapın.Alanı belgeden tamamen hariç tutun.
Elasticsearch'ü yapılandırırken "Unknown char_filter type [stop] for **" hatası görüntülenirse ne yapmalıyım?
stop türü bir karakter filtresi değil, bir belirteç filtredir. Bunu char_filter bölümüne yerleştirmek bu hataya neden olur.
stop yapılandırmasını çözümleyicinizin char_filter bölümünden filter bölümüne taşıyın:
"settings": {
  "analysis": {
    "analyzer": {
      "my_custom_analyzer": {
        "type": "custom",
        "tokenizer": "standard",
        "filter": [
          "lowercase",
          "stop"
        ]
      }
    },
    "filter": {
      "stop": {
        "type": "stop",
        "stopwords": "_english_"
      }
    }
  }
}
Ayrıca char_filter, tokenizer ve filter içinde belirtilen tüm bileşen türlerinin geçerli Elasticsearch filtre türleri olduğunu doğrulayın.
Elasticsearch alma işlem hattımın bir default_pipeline mi yoksa final_pipeline mi olduğunu nasıl belirlerim?
Elasticsearch, alma işlem hatlarını yapılandırmak için iki dizin düzeyinde ayar sağlar: index.default_pipeline ve index.final_pipeline. Bu ayarlar işleme aşaması ve geçersiz kılma davranışı açısından farklılık gösterir.
default_pipeline
index.default_pipeline ayarı, açıkça bir işlem hattı belirtmeyen indeksleme isteklerine uygulanan alma işlem hattını belirtir. Bir istek ?pipeline= parametresini içeriyorsa istekte belirtilen işlem hattı varsayılan işlem hattına göre öncelik kazanır.
final_pipeline
index.final_pipeline ayarı, her zaman en son çalışan alma işlem hattını belirtir. Bu işlem hattı hem varsayılan işlem hattından hem de istekte belirtilen herhangi bir işlem hattından sonra uygulanır. Varsayılan işlem hattının aksine, son işlem hattı istek düzeyindeki parametrelerle geçersiz kılınamaz.
Geçerli işlem hattı yapılandırmasını kontrol etme
Belirli bir dizin için hangi alma işlem hatlarının yapılandırıldığını kontrol etmek için aşağıdaki komutu çalıştırın:
GET /<index_name>/_settings?filter_path=*.settings.index.default_pipeline,*.settings.index.final_pipelineÖrnek yanıt:
{
  "<index_name>": {
    "settings": {
      "index": {
        "default_pipeline": "my_default_pipeline",
        "final_pipeline": "my_final_pipeline"
      }
    }
  }
}
Yanıtta ne default_pipeline ne de final_pipeline döndürülürse dizin için yapılandırılmış bir alma işlem hattı yok demektir.
Büyük ölçekli veri alma işlemleri için Elasticsearch kaydırma sorgularını nasıl kullanırım?
Kaydırma API'si, tek bir arama isteğinden çok sayıda sonuç alır. Normal aramanın aksine kaydırma, bir zaman noktası anlık görüntüsünü korur; bu da onu toplu veri dışa aktarma veya toplu işleme için uygun kılar. Kaydırma bağlamları küme kaynaklarını tükettiği ve düşük gecikme süreli sorgular için optimize edilmediğinden kaydırmayı gerçek zamanlı, kullanıcıya yönelik arama istekleri için kullanmayın.
Adım 1: İlk kaydırma isteğini başlatma
Kaydırma bağlamının ne kadar süreyle etkin kalacağını belirtmek için scroll parametresiyle bir arama isteği gönderin. Örneğin, 1m bağlamı bir dakika boyunca etkin tutar.
POST /<index_name>/_search?scroll=1m
{
  "size": 1000,
  "query": {
    "match_all": {}
  }
}
Yanıt bir _scroll_id ve ilk sonuç grubunu içerir. Sonraki istekler için _scroll_id değerini kaydedin.
Adım 2: Sonraki grupları alma
Sonraki sonuç grubunu almak için önceki yanıttaki _scroll_id değerini kullanın.
POST /_search/scroll
{
  "scroll": "1m",
  "scroll_id": "<scroll_id_from_previous_response>"
}
Her yanıt yeni bir _scroll_id döndürür. Bir sonraki istek için her zaman en güncel _scroll_id değerini kullanın.
Adım 3: Tüm veriler alınana kadar tekrar etme
Yanıttaki hits.hits dizisi boş olana kadar en son _scroll_id ile kaydırma API'sini çağırmaya devam edin. Boş bir dizi, eşleşen tüm belgelerin alındığını gösterir.
Adım 4: Kaydırma bağlamını temizleme
Tüm veriler alındıktan sonra küme kaynaklarını serbest bırakmak için kaydırma bağlamını açıkça temizleyin.
DELETE /_search/scroll
{
  "scroll_id": "<scroll_id>"
}Kaydırma bağlamları küme belleğini tüketir. Artık ihtiyaç duyulmadığında kaydırma bağlamlarını her zaman temizleyin ve kaynak kullanımını en aza indirmek için en kısa pratik kaydırma zaman aşımını ayarlayın.
Kibana'da rol yönetimi girişini nasıl bulurum veya dizin eşlemelerini nasıl değiştiririm?
Rol yönetimi
Kibana'da rolleri yönetmek için Alibaba Cloud Elasticsearch örneğinizin Kibana konsoluna görsel konsol üzerinden oturum açın. Kibana sol gezinme bölmesinde Stack Management > Security > Roles yolunu izleyerek roller oluşturun veya düzenleyin.
Dizin eşlemelerini değiştirme
Standart Elasticsearch örnekleri (Gelişmiş Sürüm olmayan) için dizin eşlemeleri doğrudan Alibaba Cloud Elasticsearch konsolunda değiştirilemez. Bir dizin eşlemesine yeni alanlar eklemek için aşağıdaki adımları gerçekleştirin:
Alibaba Cloud Elasticsearch örneğinizin Kibana konsoluna görsel konsol üzerinden oturum açın.
Kibana sol gezinme bölmesinde Stack Management > Index Management yolunu izleyin ve hedef dizini bulun.
Kibana sol gezinme bölmesinde Dev Tools öğesini açın.
-
Dizine yeni alanlar eklemek için bir
PUTeşleme isteği çalıştırın. Örnek:PUT /<index_name>/_mapping { "properties": { "new_field_name": { "type": "keyword" } } }
Elasticsearch mevcut bir eşlemeye yalnızca yeni alanlar eklemeyi destekler. Mevcut bir alanın veri türünü değiştirmek desteklenmez. Bir alan türünü değiştirmek için doğru eşlemeye sahip yeni bir dizin oluşturun ve verileri orijinal dizinden yeniden indeksleyin.