Bazı düğümlerin diğerlerinden önemli ölçüde daha fazla trafiği işlemesi durumunda küme yük dengesizliği ortaya çıkar. Bu durum sorguların yavaşlamasına, dizinleme gecikmelerine veya düğüm arızalarına neden olabilir. Bu konuda, bir Alibaba Cloud Elasticsearch kümesindeki yük dengesizliğinin dört temel nedeni ve her birinin nasıl çözüleceği açıklanmaktadır.
Belirtiler
Yük dengesizliği genellikle iki şekilde kendini gösterir:
Disk kullanımı düğümler arasında yaklaşık olarak eşittir ancak belirli düğümlerde CPU utilization or load_1m değerlerinde ani artışlar gözlenir.
Disk kullanımı düğümler arasında önemli ölçüde farklılık gösterir ve CPU utilization or load_1m verileri bu dengesizliği doğrular.
Nedenler
Olasılıklarına göre sıralandığında:
Uygun olmayan parça ataması — en yaygın nedendir. Önce bunu kontrol edin.
Dengesiz segment boyutları — tek bir parçadaki büyük segmentler, o parça üzerindeki sorguları yavaşlatır.
Sıcak ve soğuk verilerin ayrılmaması — sorguların belirli düğümlere yönlendirilmesi yükü yoğunlaştırır.
Dengesiz kalıcı bağlantılar — nadir görülür; Server Load Balancer (SLB) kullanan çok alanlı dağıtımları etkiler.
Bu nedenlerden hiçbiri geçerli değilse Alibaba Cloud teknik desteği ile iletişime geçin.
Uygun olmayan parça ataması
Senaryo
Bir kümede 3 özel master düğümü ve 9 veri düğümü bulunur. Master düğümleri: 16 vCPU, 32 GiB bellek. Veri düğümleri: 32 vCPU, 64 GiB bellek. Yoğun saatlerde (16:21–18:00), küme yaklaşık 2.000 okuma QPS ve 1.000 yazma QPS işler. İki düğümdeki CPU kullanımı %100'e ulaşarak sorgu performansını düşürür.
Analiz
-
Elastic Compute Service (ECS) örneklerini ve ağ izlemeyi kontrol edin. Yoğun saatlerde, etkilenen düğümlerde sorgu QPS değerleri artar ve CPU kullanımı keskin bir şekilde yükselir. Bu durum, yüksek yüklü düğümlerin sorgu trafiğinin çoğunu işlediğini doğrular.
Parça dağıtımını kontrol etmek için
GET _cat/shards?vkomutunu çalıştırın. Çıktı,testdizinindeki parçaların yüksek yüklü düğümlerde yoğunlaştığını gösterir. Bu düğümlerdeki disk kullanımı da daha yüksektir. Dengesiz parça ataması depolama dengesizliğine yol açar ve daha fazla veri içeren düğümler daha fazla okuma ve yazma trafiğini işler.-
Dizin yapılandırmasını kontrol etmek için
GET _cat/indices?vkomutunu çalıştırın.testdizininde 5 birincil parça ve her birincil parça için 1 çoğaltma bulunur. Parçalar eşit dağıtılmamıştır ve bazı belgeler.delolarak işaretlenmiştir. Elasticsearch arama yaparken.delişaretli belgeleri tarar ve bunları filtreler; bu ek iş yükü arama verimliliğini azaltır. Bu belgeleri kaldırmak için yoğun olmayan saatlerde force merge işlemini uygulayın.pri rep docs.count docs.deleted store.size pri.store.size 1 1 8640 0 6.7mb 3.3mb 1 1 8639 0 6.7mb 3.3mb 1 1 8639 0 6.7mb 3.3mb 1 1 297847 488 688.7mb 344.8mb 1 1 93230 364 222.1mb 111mb 1 1 297803 588 693.5mb 346.1mb 1 1 297756 540 697.5mb 348.5mb 1 1 297852 536 687.9mb 343.4mb 1 1 297750 588 693.1mb 344.2mb 1 1 8639 0 6.7mb 3.3mb 1 1 8639 0 6.7mb 3.3mb 1 1 2 0 19.3kb 8.3kb 3 1 0 0 1.1kb 576b 3 1 71888299 15614684 124gb 64.6gb 3 1 0 0 1.1kb 576b 1 1 2661 0 2.2mb 1.1mb 1 1 8639 0 6.7mb 3.3mb 1 1 8639 0 6.6mb 3.3mb 1 1 297732 540 700.5mb 349.9mb 1 1 297795 540 691.6mb 344.7mb Küme günlüklerini ve yavaş logları inceleyin. Tüm sorgular normal terim sorgularıdır ve küme günlüklerinde hata yoktur. Kök neden, sorgu düzeyindeki sorunlar değil parça dağıtımıdır.
Kök neden
Dengesiz parça ataması, depolama ve trafiği düğümlerin bir alt kümesinde yoğunlaştırarak CPU dengesizliğine neden olur.
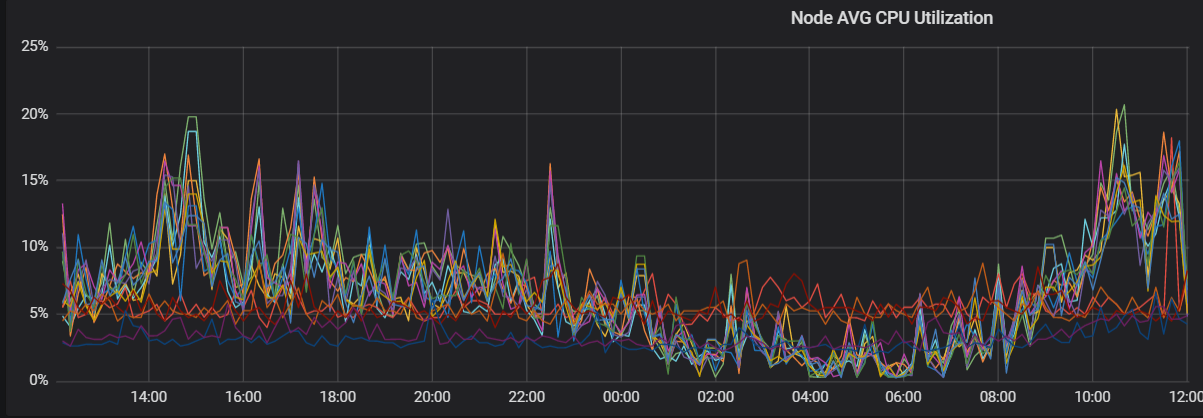
Parçaları yeniden dengeledikten sonra CPU kullanımı düğümler arasında eşitlenir:
Çözüm
Dizinleri oluşturmadan önce parça sayısını planlayın. Aşağıdaki Parça planlama yönergeleri bölümüne bakın.
Parça planlama yönergeleri
Parça sayısı ve boyutu küme kararlılığını ve performansını belirler. Her dizin için parçaları planlarken bu yönergeleri kullanın.
Elasticsearch 7.x öncesi sürümlerde varsayılan olarak 5 birincil parça ve her birincil parça için 1 çoğaltma bulunur. 7.x ve sonraki sürümlerde varsayılan olarak 1 birincil parça ve 1 çoğaltma bulunur.
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Yapılandırdığınız birincil parça sayısı ne kadar fazlaysa kümedeki performans ek yükü de o kadar yüksek olur.
Otomatik Dizin Oluşturma özelliğini etkinleştirdiyseniz, parça ayarlarını değiştirmek ve parçaların eşit dağıtılmasını sağlamak için senaryo tabanlı yapılandırma şablonu nu kullanın.
Dengesiz segment boyutları
Senaryo
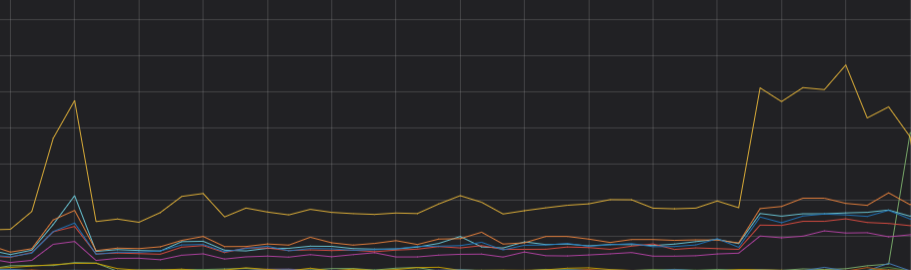
Kümedeki bir düğümde CPU kullanımında ani bir artış yaşanır ve bu durum sorgu performansını etkiler. test dizininde 3 birincil parça ve her birincil parça için 1 çoğaltma bulunur; bunlar düğümler arasında eşit dağıtılmıştır. Dizin, delete.doc olarak işaretlenmiş birçok belge içerir. ECS örneklerinin normal olduğu doğrulanmıştır.
Analiz
Sorgu gövdesine
"profile": trueekleyin. Profil oluşturma çıktısı,testdizininin 1 numaralı parçasının diğer parçalara göre daha uzun sorgulama süresi gerektirdiğini gösterir.**Her ikisi de
"profile": trueiçerenpreference=_primaryvepreference=_replicaile sorgular çalıştırın.** 1 numaralı parçanın birincil parçası, çoğaltmasından daha yavaştır. Bu durum, sorunun kaynağı olarak 1 numaralı parçayı izole eder.-
1 numaralı parçanın segmentlerini incelemek için aşağıdaki komutları çalıştırın:
Birincil parça ile çoğaltması arasındaki belge sayısı farkları iki nedenden kaynaklanabilir: - Senkronizasyon gecikmesi: Belgeler sürekli yazılıyorsa çoğaltma geçici olarak geride kalabilir. Yazma işlemleri durduğunda sayılar eşitlenir. - Otomatik oluşturulan belge kimlikleri ve eşzamanlı silme işlemleri: Otomatik oluşturulan kimlikler kullanarak belgeler yazarsanız ve yeni yazılan bir belge için Delete by Query isteği gönderirseniz silme işlemi, yazma işlemi çoğaltmaya yayılmadan önce birincil parçada çalışır. Çoğaltma daha sonra silme işlemi olmadan yazmayı alır ve bu da çoğaltmada daha fazla belgeyle sonuçlanır. Ayrıca birincil parçada
doc.deleteolarak işaretlenmiş belgeler birikir.GET _cat/segments/index?v&h=shard,segment,size,size.memory,ip GET _cat/shards?vÇıktı, 1 numaralı parçanın çoğaltma parçasına göre daha büyük segmentlere ve daha fazla belgeye sahip olduğunu gösterir. Segment boyutu farkı yük dengesizliğine neden olmaktadır.
Çözüm (birini seçin)
Yoğun olmayan saatlerde force merge çağrısı yaparak küçük segmentleri sıkıştırın ve
delete.docbelgelerini kaldırın.Birincil parçayı barındıran düğümü yeniden başlatın. Bu işlem, çoğaltmayı birincil olarak yükseltir ve ondan yeni bir çoğaltma oluşturur; böylece her iki parça da aynı segment yapısına sahip olur.
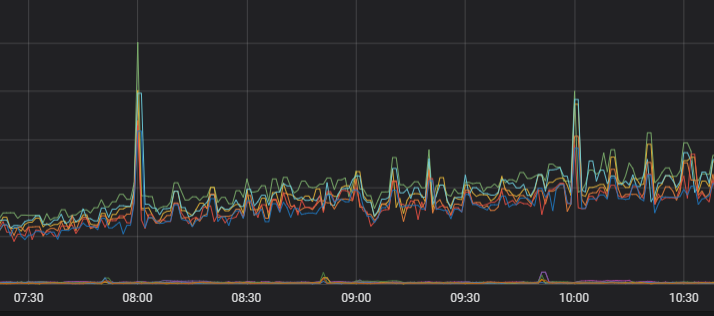
Optimizasyondan sonra yük düğümler arasında eşitlenir:
Dengesiz kalıcı bağlantılar
Bu neden nadirdir ve yalnızca çok alanlı dağıtımlar için geçerlidir.
Senaryo
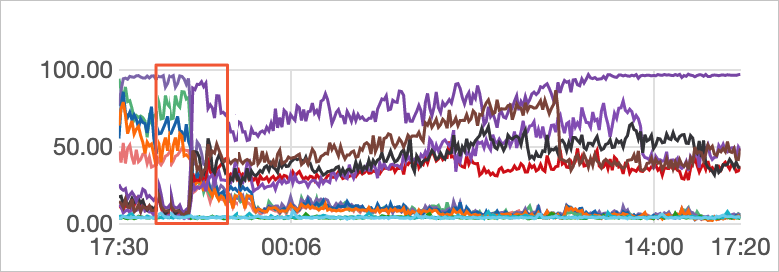
Bir küme iki alana dağıtılmıştır: Alan B ve Alan C. Alan C'deki düğümler tutarlı bir şekilde Alan B'deki düğümlerden daha yüksek yük taşır. Bu dengesizlik donanım farklılıklarından veya dengesiz veri dağıtımından kaynaklanmaz.
Analiz
-
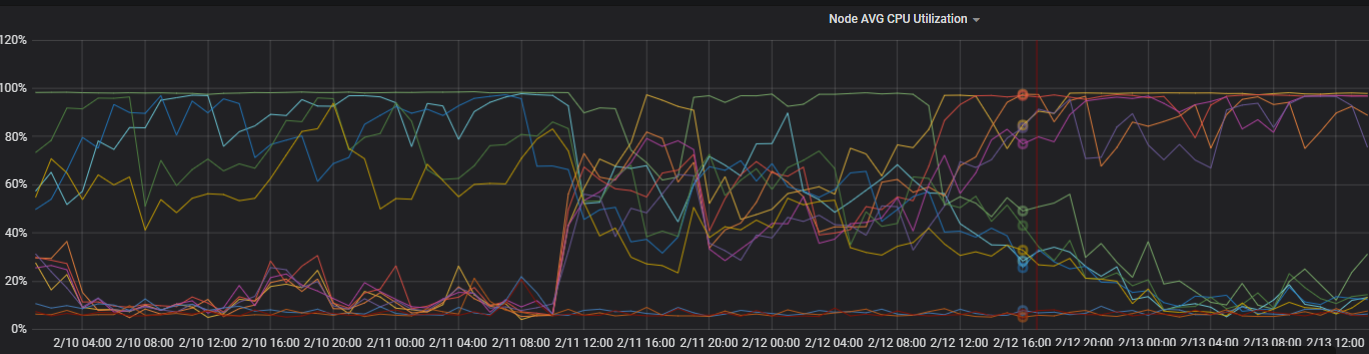
Son 4 gündeki CPU kullanımını görüntüleyin. İzleme verileri, belirli bir zaman noktasında CPU kullanımının önemli ölçüde değiştiğini gösterir.
-
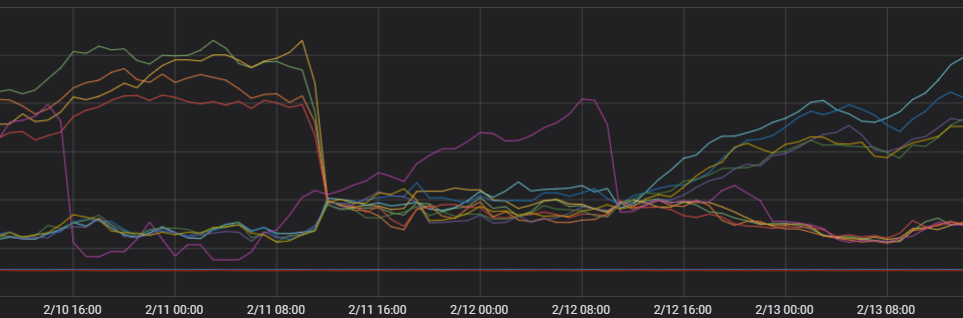
Her düğümdeki TCP bağlantılarını kontrol edin. Alan B ve Alan C arasında TCP bağlantı sayısı önemli ölçüde farklıdır; bu durum bir ağ bağlantısı dağıtım sorununa işaret eder.
İstemci bağlantı davranışını kontrol edin. İstemci kalıcı bağlantılar kullanır ve çok az yeni bağlantı oluşturur. Çok alanlı mimarilerde her zamanlama birimi bağlantı kurarken bağımsız olarak en uygun düğümü seçer. Yeni bağlantı hacmi düşük olduğunda birden fazla zamanlama birimi aynı düğümü seçebilir. Ayrıca Elasticsearch istemci düğümleri istekleri aynı alandaki düğümlere iletme eğilimindedir; bu da trafiği tek bir alanda yoğunlaştırır.
Çözüm (birini seçin)
-
İstemcide bir bağlantı yaşam süresi (TTL) ayarlayın.
httpClientBuilder.setConnectionTimeToLive()kullanarak periyodik bağlantı yenilemeyi zorlayın. Örneğin, 5 dakikalık bir TTL ayarlamak için:Bu amaçla
setConnectionTimeToLive()kullanın.setKeepAliveStrategy()bağlantıları yeniden dağıtmakta daha az etkilidir.httpClientBuilder.setConnectionTimeToLive(5, TimeUnit.MINUTES)Ayrıntılar için HttpAsyncClientBuilder adresine bakın.
İstemcileri eşzamanlı olarak yeniden başlatın ve tüm düğümlerde aynı anda yeni bağlantılar oluşturulmasını sağlayın.
Trafiği yönlendirmek için özel istemci düğümleri kullanın. İstemci düğümleri istekleri veri düğümlerine iletir ve yönlendirme katmanını depolama katmanından izole eder. İstemci düğümleri yoğun yüklense bile veri düğümleri etkilenmez.
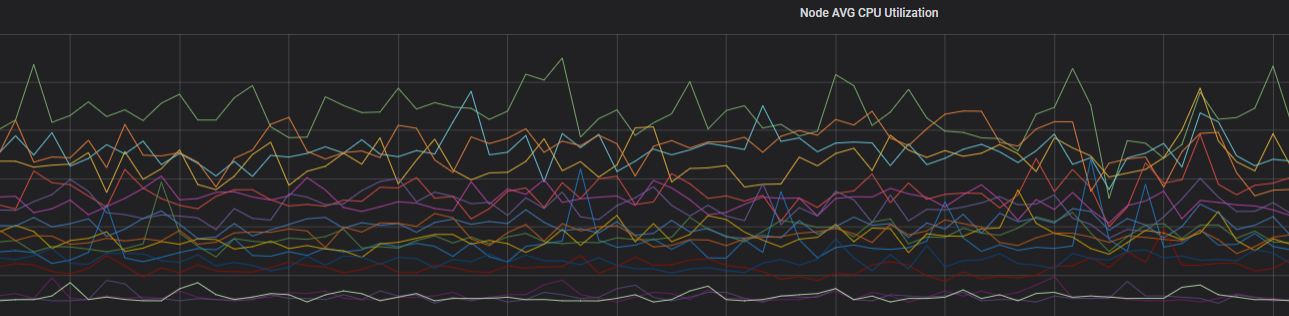
Optimizasyondan sonra yük alanlar arasında eşit dağılır:
Tek bir dizin için dengesiz parçalar
Senaryo
Parçalar düğümler arasında eşit dağıtılmış gibi görünse de yüksek yüklü düğümlerde belirli bir dizine ait daha fazla parça veya daha büyük parçalar bulunur.
Çözüm
Tek bir dizinden herhangi bir düğüme atanabilecek parça sayısını sınırlamak için index.routing.allocation.total_shards_per_node değerini ayarlayın.
Değeri şu şekilde hesaplayın: (birincil parçalar + çoğaltma parçaları) / veri düğümü sayısı. Sonuç tam sayı değilse yukarı yuvarlayın.
PUT index_name/_settings
{
  "index.routing.allocation.total_shards_per_node": "3"
}