Query Profile, StarRocks örneğinizdeki bir sorgunun çalıştırma ayrıntılarını kaydeder. Sorgu performansını tanılamak, darboğazları belirlemek ve bunları çözen optimizasyon tekniğini seçmek için Query Profile'ları kullanın.
Query Profile'a genel bakış
Query Profile görselleştirmesi
StarRocks Manager, Query Profile'lar için görsel analiz desteği sunar. Daha fazla bilgi için bkz. Query Profile tanıtımı.
Sorgu darboğazlarını belirleme
StarRocks Manager'daki Query Profile görselleştirmesinde, çalışması daha uzun süren operatörler daha koyu renklerde görünür. Çalıştırma süresi en uzun olan üç operatör vurgulanır; bu sayede sorgu darboğazlarını kolayca tespit edebilirsiniz 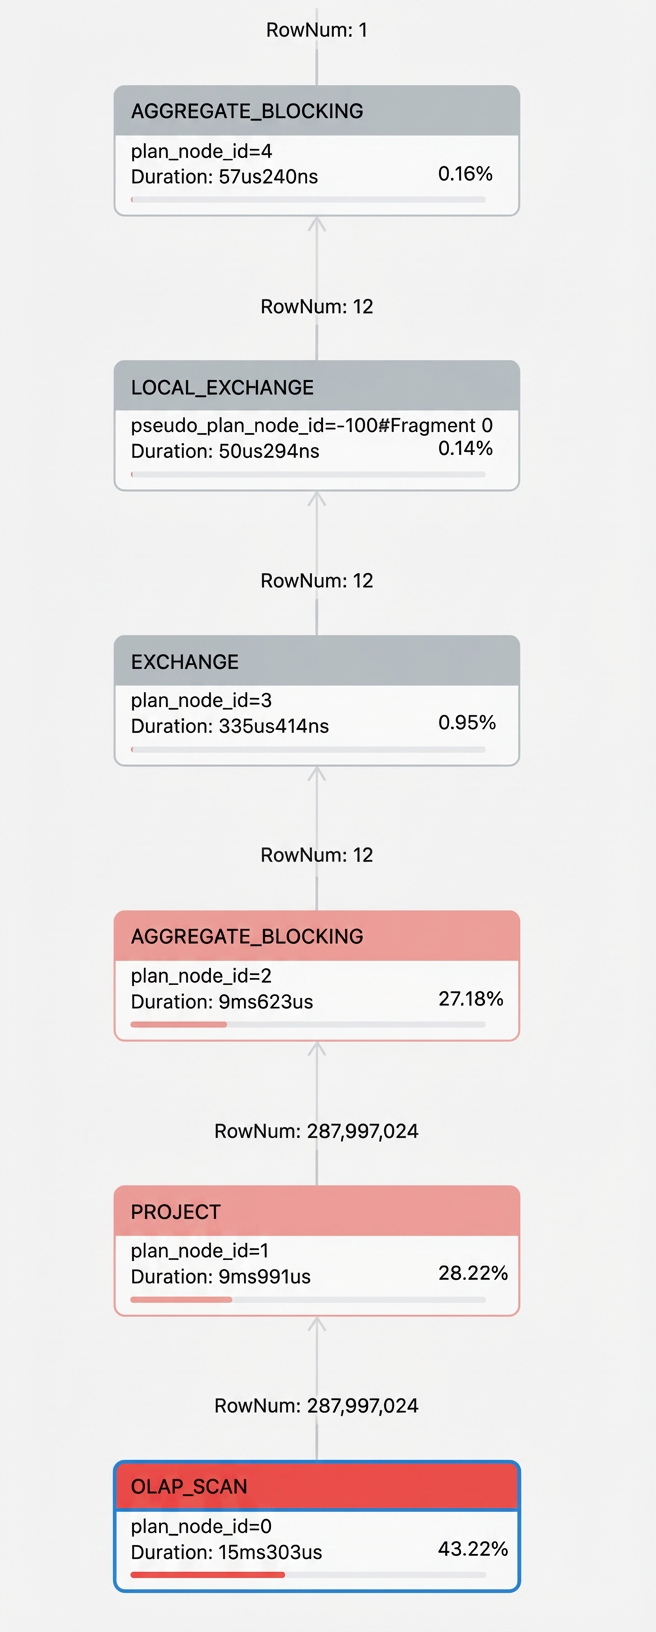
Optimizasyon kullanım örnekleri
Aşağıdaki bölümlerde, StarRocks'ta yaygın sorgu performans sorunlarının nasıl tanılanıp çözüleceği açıklanmaktadır:
Bellek yetersizliği (OOM) hatalarına neden olan büyük alanlı sorguları optimize etme
TEXT veya VARCHAR gibi büyük alanlar içeren bir tabloyu sorgularken, aşırı miktarda büyük alan verisi okumak veya işlemek bellek yetersizliği (OOM) hatasına yol açabilir. Bellek tüketimini azaltmak için aşağıdaki önlemleri uygulayın:
SELECT *kullanımından kaçının. Sadece ihtiyaç duyduğunuz sütunları açıkça belirtin; böylece taranan ve belleğe yüklenen veri hacmini düşürün.GROUP BYveDISTINCTgibi toplama işlemlerine büyük alanları dahil etmeyin; bu, ara sonuç kümelerinin aşırı büyümesini engeller.Oturum değişkeni
enable_spill=truedeğerini ayarlayarak diske dökme özelliğini etkinleştirin ve bellek baskısını hafifletin.Tablo şemasını optimize edin: Büyük metin alanlarını ayrı bir tabloya taşıyın ve ana tabloda yalnızca dizinleri ile küçük alanları tutun. Bu tablo bölme yaklaşımı, toplama senaryolarında etkili olmaz.
Bitmap dizini
Bitmap dizini, bit dizisi kullanan özel bir veritabanı dizini türüdür. Dizideki her bit, veri tablosundaki tek bir satıra karşılık gelir. Bitin değeri (0 veya 1), ilgili satırın değerine göre belirlenir.
Düşük kardinaliteye ve yüksek tekrar eden değer sayısına sahip sütunlarda (örneğin
gendersütunu) sorgu performansını artırmak için Bitmap dizini kullanın.Bir sorgunun Bitmap dizinine isabet edip etmediğini kontrol etmek için Query Profile'daki
BitmapIndexFilterRowsalanını görüntüleyin.
Dizin oluşturma
Tablo oluştururken Bitmap dizini oluşturun.
CREATE TABLE `student_info` (
  `s_stukey` bigint(20) NULL COMMENT "",
  `s_name` varchar(65533) NULL COMMENT "",
  `s_gender` varchar(65533) NULL COMMENT "",
  INDEX index1 (s_gender) USING BITMAP COMMENT 'index1'
) ENGINE=OLAP
DUPLICATE KEY(`s_stukey`)
COMMENT "OLAP"
DISTRIBUTED BY HASH(`s_stukey`);
INSERT INTO student_info
VALUES
    (001,'student#000000019','male'),
    (002,'student#000000020','male'),
    (003,'student#000000021','male'),
    (004,'student#000000022','female');
Mevcut bir tabloda
CREATE INDEXkullanarak Bitmap dizini oluşturun.
CREATE INDEX index_name ON table_name (column_name) [USING BITMAP] [COMMENT ''];Dizin oluşturma ilerlemesini kontrol etme
Dizin oluşturma görevinin ilerlemesini kontrol etmek için aşağıdaki komutu çalıştırın:
SHOW ALTER TABLE COLUMN [FROM db_name];Dizin görüntüleme
Bir tablodaki dizinleri görüntülemek için aşağıdaki komutu çalıştırın:
SHOW {INDEX[ES] | KEY[S] } FROM [db_name.]table_name [FROM db_name];Aşağıdaki çıktı döndürülür:
MySQL [db_test]> show index from student_info;
+------------------------+------------+----------+--------------+-------------+-----------+-------------+----------+--------+------+------------+---------+
| Table                  | Non_unique | Key_name | Seq_in_index | Column_name | Collation | Cardinality | Sub_part | Packed | Null | Index_type | Comment |
+------------------------+------------+----------+--------------+-------------+-----------+-------------+----------+--------+------+------------+---------+
| db_test.student_info   |            | index1   |              | s_gender    |           |             |          |        |      | BITMAP     | index1  |
+------------------------+------------+----------+--------------+-------------+-----------+-------------+----------+--------+------+------------+---------+
1 row in set (0.01 sec)
Dizin silme
Dizin silmek için aşağıdaki komutu çalıştırın:
DROP INDEX index_name ON [db_name.]table_name;Tek sütunlu sorguyu test etme
-
s_gendersütununu filtreleyen bir sorgu çalıştırın.select * from student_info where s_gender='male'; -
Profile'ı görüntüleyin.
OLAP_SCAN öğesine tıklayın, ardından sağ taraftaki Node Details sekmesine tıklayın.
Bitmapölçümlerini filtreleyerek Bitmap dizininin etkili olduğunu doğrulayın.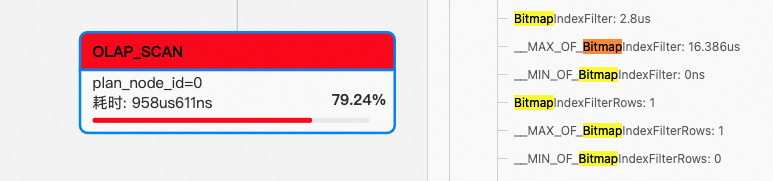
Bloom filtre dizini
Bloom filtre dizini, bir veri dosyasının hedef veriyi içerip içermediğini hızlıca belirler. İçermiyorsa dosya atlanır; bu da taranan veri hacmini azaltır. Bloom filtresi alan açısından verimlidir ve ID sütunları gibi yüksek kardinaliteli sütunlar için uygundur.
Primary Key modelinde ve Duplicate modelinde herhangi bir sütunda Bloom filtre dizini oluşturabilirsiniz. Aggregate modelinde ve Update modelinde ise yalnızca anahtar sütunlarda Bloom filtre dizini oluşturabilirsiniz.
TINYINT, FLOAT, DOUBLE veya DECIMAL veri türlerine sahip sütunlar için Bloom filtre dizinleri desteklenmez.
Bloom filtre dizini, yalnızca
inveya=koşulları içeren sorguların performansını iyileştirir. Örnekler:SELECT ... WHERE ... IN ()veSELECT ... WHERE column = ....Bir sorgunun Bloom filtre dizinine isabet edip etmediğini kontrol etmek için Query Profile'daki
BloomFilterFilterRowsalanını görüntüleyin.
Dizin oluşturma
Tablo oluştururken, PROPERTIES yan tümcesinde bloom_filter_columns belirterek Bloom filtre dizini oluşturabilirsiniz. Aşağıdaki örnek bunu nasıl yapacağınızı gösterir.
CREATE TABLE table1
(
  k1 BIGINT,
  k2 LARGEINT,
  v1 VARCHAR(2048) REPLACE,
  v2 SMALLINT DEFAULT "10"
)
ENGINE = olap
PRIMARY KEY(k1, k2)
DISTRIBUTED BY HASH (k1, k2) BUCKETS 10
PROPERTIES("bloom_filter_columns" = "k1,k2"); -- Separate multiple index columns with commas (,).
Dizin görüntüleme
Bir tablodaki dizinleri görüntülemek için aşağıdaki komutu çalıştırın:
SHOW CREATE TABLE table1;Dizin değiştirme
Örnek:
v1sütunu için Bloom filtre dizini ekleyin.
ALTER TABLE table1 SET ("bloom_filter_columns" = "k1,k2,v1");k2sütunu için Bloom filtre dizinini kaldırın.
ALTER TABLE table1 SET ("bloom_filter_columns" = "k1");table1üzerindeki tüm Bloom filtre dizinlerini silin.
ALTER TABLE table1 SET ("bloom_filter_columns" = "");Örnek
-
TPC-H'den
customertablosunu örnek alın. Sıralama anahtarı olmayan, yüksek kardinaliteli bir sütuna (örneğinc_phonesütunu) Bloom filtre dizini ekleyin.ALTER TABLE tpc_h_sf100.customer SET ("bloom_filter_columns" = "c_custkey, c_phone"); -
Bloom filtre dizininin eklendiğini onaylamak için dizini görüntüleyin.
SHOW CREATE TABLE tpc_h_sf100.customer;| customer | CREATE TABLE `customer` ( `c_custkey` bigint(20) NULL COMMENT "", `c_name` varchar(65533) NULL COMMENT "", `c_address` varchar(65533) NULL COMMENT "", `c_nationkey` bigint(20) NULL COMMENT "", `c_phone` varchar(65533) NULL COMMENT "", `c_acctbal` double NULL COMMENT "", `c_mktsegment` varchar(65533) NULL COMMENT "", `c_comment` varchar(65533) NULL COMMENT "", `Gender` varchar(65533) NULL DEFAULT "default_value" COMMENT "" ) ENGINE=OLAP DUPLICATE KEY(`c_custkey`) COMMENT "OLAP" DISTRIBUTED BY HASH(`c_custkey`) BUCKETS 24 PROPERTIES ( "replication_num" = "1", "bloom_filter_columns" = "c_custkey, c_phone", "in_memory" = "false", "storage_format" = "DEFAULT", "enable_persistent_index" = "false", "compression" = "LZ4" ); | -
c_phonesütununu filtreleyen bir sorgu çalıştırın.select * from tpc_h_sf100.customer where c_phone = "10-334-921-5346"; -
Profile'ı görüntüleyin.
OLAP_SCAN öğesine tıklayın, ardından sağ taraftaki Node Details sekmesine tıklayın. Bloom filtre dizininin etkin olduğunu onaylamak için
BloomFilterFilterRowsölçümünü bulun.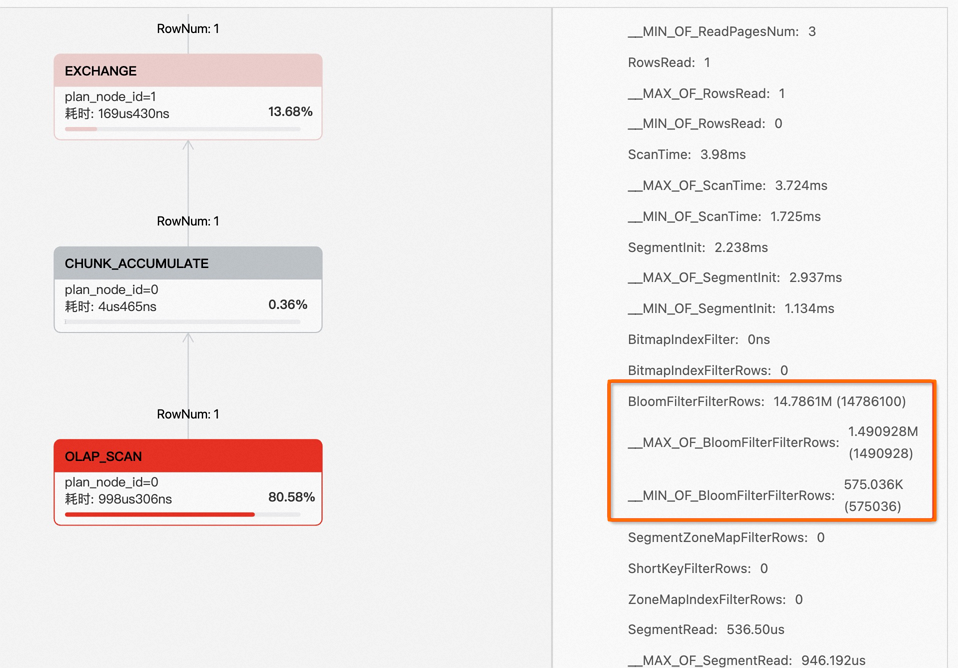
Veri eğriliğini optimize etme
Bu örnekte, TPC-H'den lineitem tablosu kullanılır ve dağıtım anahtarı olarak eşit olmayan değer dağılımına sahip bir sütun seçilerek veri eğriliği sorunu gösterilir. Örnekte, l_tag sütunu her satırda aynı değere sahiptir; bu durum aşırı veri eğriliğine neden olur.
-
Test verileri oluşturun. Dağıtım anahtarı olarak kullanmak üzere TPC-H'deki
lineitemtablosuna yeni bir sütun ekleyin.CREATE TABLE `lineitem_tag` ( `l_orderkey` bigint(20) NULL COMMENT "", `l_partkey` bigint(20) NULL COMMENT "", `l_suppkey` bigint(20) NULL COMMENT "", `l_linenumber` int(11) NULL COMMENT "", `l_quantity` double NULL COMMENT "", `l_extendedprice` double NULL COMMENT "", `l_discount` double NULL COMMENT "", `l_tax` double NULL COMMENT "", `l_returnflag` varchar(65533) NULL COMMENT "", `l_linestatus` varchar(65533) NULL COMMENT "", `l_shipdate` date NULL COMMENT "", `l_commitdate` date NULL COMMENT "", `l_receiptdate` date NULL COMMENT "", `l_shipinstruct` varchar(65533) NULL COMMENT "", `l_shipmode` varchar(65533) NULL COMMENT "", `l_comment` varchar(65533) NULL COMMENT "", `l_tag` varchar(65533) default 'false' COMMENT "" ) ENGINE=OLAP DUPLICATE KEY(`l_orderkey`) COMMENT "OLAP" DISTRIBUTED BY HASH(`l_tag`) BUCKETS 96 PROPERTIES ( "replication_num" = "1", "in_memory" = "false", "storage_format" = "DEFAULT", "enable_persistent_index" = "false" ); insert into lineitem_tag select *, 'false' as l_tag from tpc_h_sf100.lineitem; -
Tam tablo taraması yapan bir sorgu çalıştırın.
select count(1) from lineitem_tag; -
Profile'ı görüntüleyin.
OLAP_SCAN öğesine tıklayın ve sağ taraftaki Node sekmesine gidin. MaxTime ve MinTime altındaki SCAN sürelerini karşılaştırın. Süreler arasında birkaç kat fark varsa veri eğriliği oluşmuş olabilir.
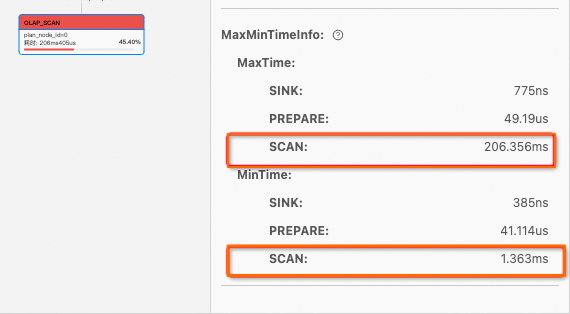
-
Dağıtım anahtarını yeniden tanımlayarak tablo şemasını optimize edin.
lineitem2adlı yeni bir tablo oluşturun ve bucketing anahtarınıl_tagyerinel_orderkeyolarak değiştirerek veri eğriliğini çözün. Aşağıdaki ifade tabloyu oluşturur; kritik değişiklikDISTRIBUTED BY HASH(kısmındadır.CREATE TABLE `lineitem2` ( `l_orderkey` bigint(20) NULL COMMENT "", `l_partkey` bigint(20) NULL COMMENT "", `l_suppkey` bigint(20) NULL COMMENT "", `l_linenumber` int(11) NULL COMMENT "", `l_quantity` double NULL COMMENT "", `l_extendedprice` double NULL COMMENT "", `l_discount` double NULL COMMENT "", `l_tax` double NULL COMMENT "", `l_returnflag` varchar(65533) NULL COMMENT "", `l_linestatus` varchar(65533) NULL COMMENT "", `l_shipdate` date NULL COMMENT "", `l_commitdate` date NULL COMMENT "", `l_receiptdate` date NULL COMMENT "", `l_shipinstruct` varchar(65533) NULL COMMENT "", `l_shipmode` varchar(65533) NULL COMMENT "", `l_comment` varchar(65533) NULL COMMENT "", `l_tag` varchar(65533) NULL DEFAULT "default_value" COMMENT "" ) ENGINE=OLAP DUPLICATE KEY(`l_orderkey`) COMMENT "OLAP" DISTRIBUTED BY HASH(`l_orderkey`) BUCKETS 96 PROPERTIES ( "replication_num" = "1", "bloom_filter_columns" = "l_orderkey", "in_memory" = "false", "storage_format" = "DEFAULT", "enable_persistent_index" = "false", "compression" = "LZ4" ); Profile'ı tekrar görüntüleyin. MaxTime ve MinTime altındaki SCAN sürelerini karşılaştırın. Veri eğriliği sorununun azaldığını görebilirsiniz.
Tek tablo materialized view
StarRocks'ta tek tablo materialized view (Rollup olarak da bilinir), doğrudan sorgulanamayan özel bir dizin türüdür. Veri ambarınızda çok sayıda karmaşık veya tekrarlayan sorgu varsa bunları hızlandırmak için tek tablo materialized view oluşturabilirsiniz.
Sorgu test etme
-
TPC-H'den
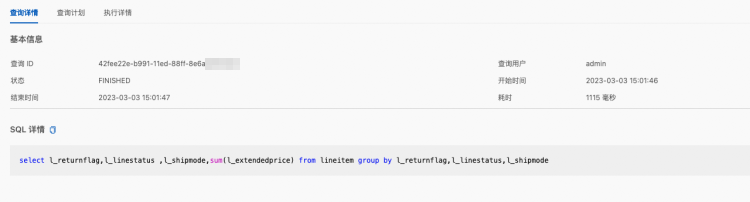
lineitemtablosunu örnek alın ve bir sorgu çalıştırın.select l_returnflag,l_linestatus,l_shipmode,sum(l_extendedprice) from lineitem group by l_returnflag,l_linestatus,l_shipmode; Materialized view oluşturulmadığından ilk sorgu 1115 ms sürer.
-
Profile'ı görüntüleyin.
OLAP_SCAN öğesine tıklayın ve sağ taraftaki Node sekmesine gidin. Rollup'ın
lineitemtablosunun kendisini taradığını görebilirsiniz.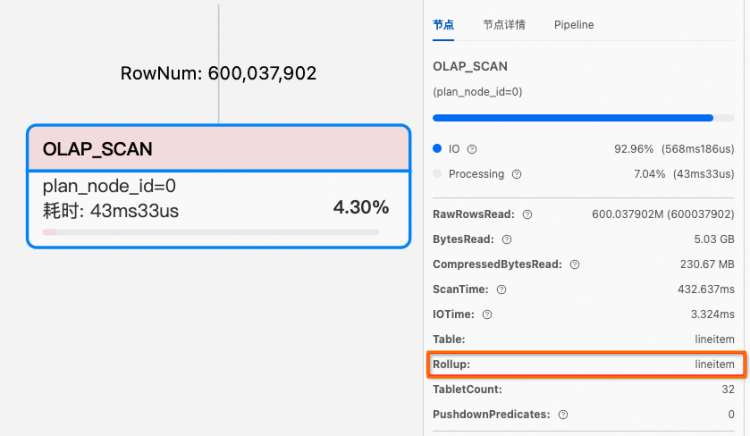
Materialized view oluşturma
Tek tablo materialized view oluşturmak için aşağıdaki komutu çalıştırın:
CREATE MATERIALIZED VIEW material_test AS select l_returnflag,l_linestatus ,l_shipmode,sum(l_extendedprice) from lineitem group by l_returnflag,l_linestatus,l_shipmode;Materialized view isabetini doğrulama
-
Sorgunun tek tablo materialized view'e isabet edip etmediğini kontrol etmek için
EXPLAINkomutunu kullanın.explain select l_returnflag,l_linestatus ,l_shipmode,sum(l_extendedprice) from lineitem group by l_returnflag,l_linestatus,l_shipmode;Dönen sonuçta,
rollup: material_testifadesi sorgununmaterial_testadlı materialized view'e isabet ettiğini gösterir.0:OlapScanNode TABLE: lineitem PREAGGREGATION: OFF. Reason: null partitions=1/1 rollup: material_test tabletRatio=96/96 tabletList=15646,15648,15650,15652,15654,15656,15658,15660,15662,15664 ... cardinality=600037902 avgRowSize=14.285666 numNodes=0 -
Profile'ı görüntüleyin.
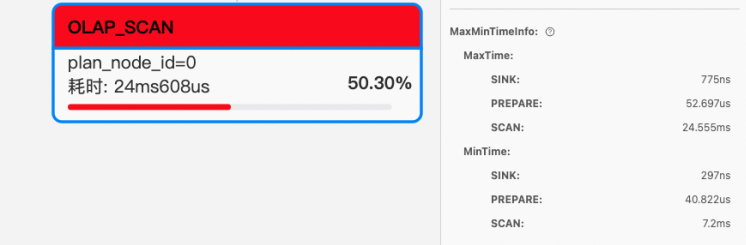
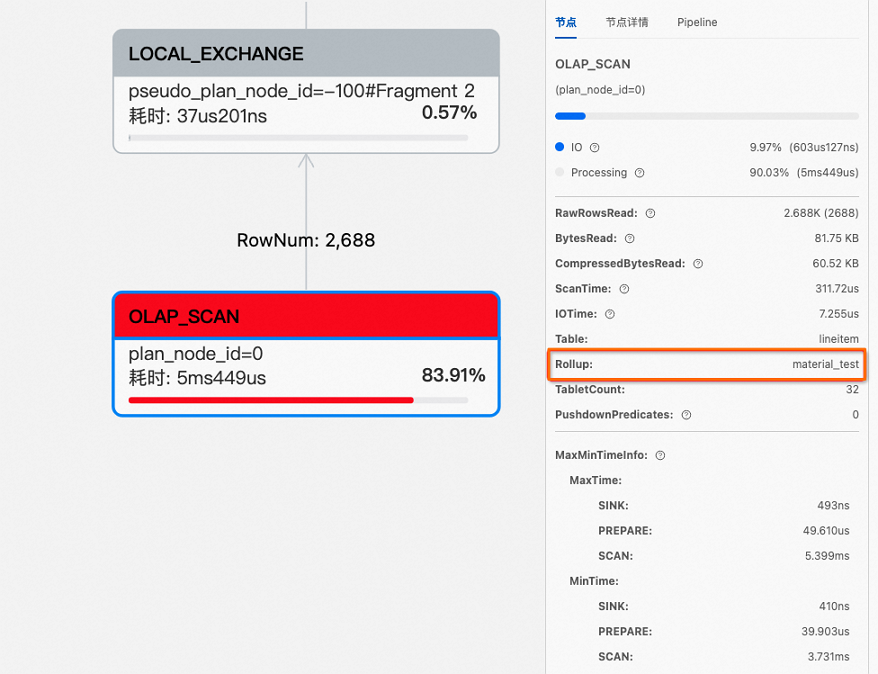
OLAP_SCAN öğesine tıklayın. Sağ taraftaki Node sekmesinde, sorgunun materialized view'e isabet ettiğini ve sorgu süresinin 0,05 ms'ye düştüğünü görebilirsiniz.
JoinRuntimeFilter'in etkin olup olmadığını doğrulama
Bir JOIN işleminde sağ tablo bir hash tablosu oluşturduğunda Runtime Filter oluşturulur. Bu filtre, sorgu ağacının sol tarafına gönderilir ve mümkün olduğunca scan operatörüne aşağı doğru itilir. Scan operatörünün Node Details sekmesinde JoinRuntimeFilter ile ilgili ölçümleri görüntüleyebilirsiniz.
-
TPC-DS'den
query72.sqldosyasını örnek alın.select i_item_desc, w_warehouse_name, d1.d_week_seq, sum(case when p_promo_sk is null then 1 else 0 end) no_promo, sum(case when p_promo_sk is not null then 1 else 0 end) promo, count(*) total_cnt from inventory join catalog_sales on (cs_item_sk = inv_item_sk) join warehouse on (w_warehouse_sk=inv_warehouse_sk) join item on (i_item_sk = cs_item_sk) join customer_demographics on (cs_bill_cdemo_sk = cd_demo_sk) join household_demographics on (cs_bill_hdemo_sk = hd_demo_sk) join date_dim d1 on (cs_sold_date_sk = d1.d_date_sk) join date_dim d2 on (inv_date_sk = d2.d_date_sk) join date_dim d3 on (cs_ship_date_sk = d3.d_date_sk) left outer join promotion on (cs_promo_sk=p_promo_sk) left outer join catalog_returns on (cr_item_sk = cs_item_sk and cr_order_number = cs_order_number) where d1.d_week_seq = d2.d_week_seq and inv_quantity_on_hand < cs_quantity and d3.d_date > (cast(d1.d_date AS DATE) + interval '5' day) and hd_buy_potential = '>10000' and d1.d_year = 1999 and cd_marital_status = 'D' group by i_item_desc,w_warehouse_name,d1.d_week_seq order by total_cnt desc, i_item_desc, w_warehouse_name, d1.d_week_seq limit 100; -
Profile'ı görüntüleyin.
OLAP_SCAN öğesine tıklayın, ardından sağ taraftaki Node Details sekmesine tıklayın. Scan operatörü
inventorytablosunu tararken JoinRuntimeFilter'in tetiklendiğini görebilirsiniz.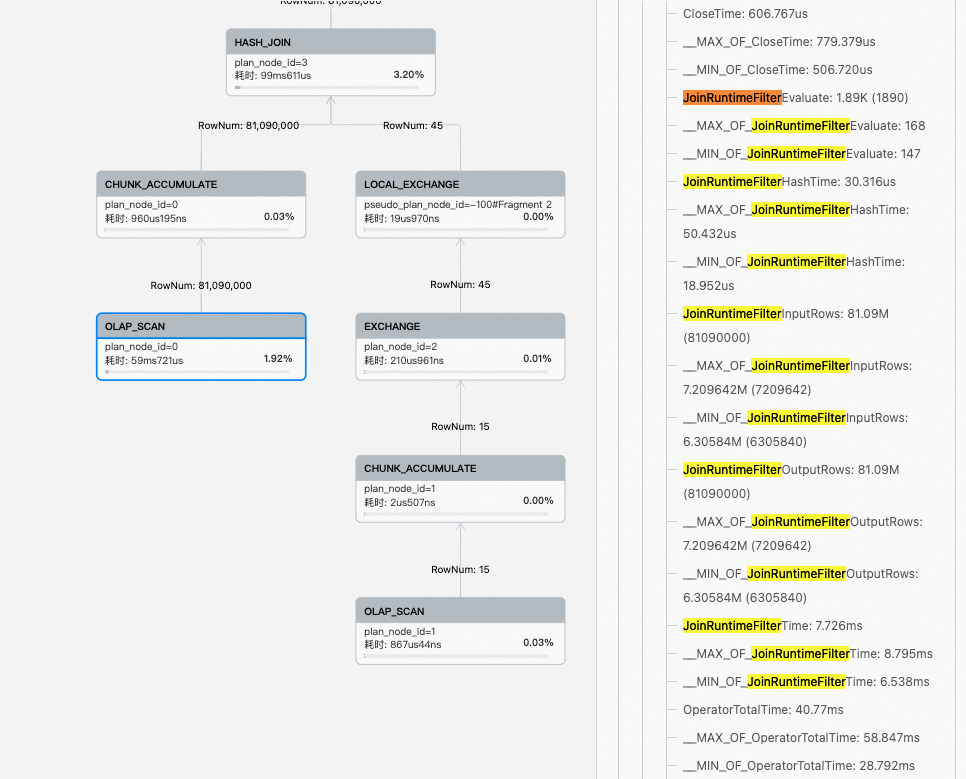
Colocate Join
StarRocks'ta Colocate Join kullanmak için tabloları oluştururken bir Colocation Group'a (CG) atayın. Aynı CG'deki tablolar, verilerinin aynı BE düğümleri kümesine dağıtılması için aynı Colocation Group Schema'yı (CGS) takip etmelidir. Join sütunu aynı zamanda bucketing anahtarı olduğunda, hesaplama düğümleri yalnızca yerel bir join gerçekleştirir; bu da düğümler arası veri aktarım süresini azaltır. Shuffle Join veya Broadcast Join'in aksine Colocate Join, ağ veri aktarımından kaçınır ve sorgu performansını iyileştirir.
Birlikte yerleştirilmiş tablo oluşturma
StarRocks, yalnızca aynı veritabanındaki tablolar üzerinde Colocate Join işlemlerini destekler.
Bir Colocation Group içinde tablo oluşturmak için aşağıdaki ifadeyi çalıştırın:
CREATE TABLE tbl (k1 int, v1 int sum)
DISTRIBUTED BY HASH(k1)
BUCKETS 8
PROPERTIES(
    "colocate_with" = "group1"
);
Colocation Group'un otomatik silinmesi
Bir gruptaki son tablo kalıcı olarak silindiğinde grup da otomatik olarak silinir. Kalıcı silme, tablonun Geri Dönüşüm Kutusu'ndan kaldırılması anlamına gelir. DROP TABLE komutunu kullanarak bir tabloyu sildikten sonra, tablo varsayılan olarak kalıcı olarak silinmeden önce bir gün boyunca Geri Dönüşüm Kutusu'nda kalır.
Grup bilgilerini görüntüleme
Örneğin, grup bilgilerini görüntülemek için aşağıdaki komutu çalıştırın.
SHOW PROC '/colocation_group';Komut aşağıdaki bilgileri döndürür.
+-------------+--------------+----------+------------+----------------+----------+----------+
| GroupId     | GroupName    | TableIds | BucketsNum | ReplicationNum | DistCols | IsStable |
+-------------+--------------+----------+------------+----------------+----------+----------+
| 11912.11916 | 11912_group1 | 11914    | 8          | 3              | int(11)  | true     |
+-------------+--------------+----------+------------+----------------+----------+----------+
Aşağıdaki tabloda sütunlar açıklanmıştır.
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Belirli bir grubun veri dağıtımını görüntülemek için aşağıdaki komutu çalıştırabilirsiniz.
SHOW PROC '/colocation_group/GroupId';
SHOW PROC '/colocation_group/11912.11916';
Komut aşağıdaki bilgileri döndürür.
+-------------+---------------------+
| BucketIndex | BackendIds          |
+-------------+---------------------+
| 0           | 10002, 10004, 10003 |
| 1           | 10002, 10004, 10003 |
| 2           | 10002, 10004, 10003 |
| 3           | 10002, 10004, 10003 |
| 4           | 10002, 10004, 10003 |
| 5           | 10002, 10004, 10003 |
| 6           | 10002, 10004, 10003 |
| 7           | 10002, 10004, 10003 |
+-------------+---------------------+
8 rows in set (0.00 sec)
Grup özelliklerini değiştirme
Bir tabloyu farklı bir Colocation Group'a taşımak için aşağıdaki ifadeyi çalıştırın:
ALTER TABLE tbl SET ("colocate_with" = "group_name");Örnek
-
TPC-H veri kümesindeki
ordersvelineitemtablolarını aynı Colocation Group'a atayın.use tpc_h_sf100; ALTER TABLE orders SET ("colocate_with" = "cg_tpc_orders"); ALTER TABLE lineitem SET ("colocate_with" = "cg_tpc_orders"); -
Aşağıdaki sorguyu çalıştırın.
select count(1) from orders as o join lineitem as l on o.o_orderkey = l.l_orderkey; -
StarRocks Manager kullanıcı arayüzünde sorgu için Query Plan sekmesinde Colocate Join'in etkin olup olmadığını kontrol edin.
colocatedeğeri true olduğunda Colocate Join etkili olur. Yürütme planında bu,colocate: trueolarak görünür. İlgili sorgu planı parçası şöyledir:
2:HASH JOIN
|  join op: INNER JOIN (COLOCATE)
|  colocate: true
|  equal join conjunct: 10: l_orderkey = 1: o_orderkey
|
|----1:OlapScanNode
|       TABLE: orders
|       PREAGGREGATION: ON
|       PREDICATES: 1: o_orderkey IS NOT NULL
|       partitions=1/1
|       rollup: orders
|       tabletRatio=96/96
|       tabletList=12403,12405,12407,12409,12411,12413,12415,12417,12419,12421 ...
|       cardinality=135000000
|       avgRowSize=1.0
|       numNodes=0
Bucket ve bölüm budamayı doğrulama
StarRocks Manager kullanıcı arayüzünde sorgunuz için Query Plan sekmesinde, bölüm budamanın veya bucket budamanın etkin olup olmadığını doğrulamak için partition veya tabletRatio parametresini görüntüleyebilirsiniz.
Sürekli yükselen ve bellek uyarısını tetikleyen FE belleğini nasıl gideririm?
FE belleği sürekli yükseldiğinde ve bellek uyarısını tetiklediğinde sorunu aşağıdaki sırayla giderin:
Meta veri şişkinliğini kontrol edin —
SHOW PROC '/statistic'komutunu çalıştırın ve toplamTabletNumdeğerini kontrol edin. ToplamTabletNumdeğeri 1.000.000'in üzerindeyse meta veri şişkinliği var demektir.Kaynak yoğun sorguları konumlandırın —
TabletNumdeğeri normalse denetim günlüğü tablosu_starrocks_audit_db_.starrocks_audit_tblüzerinde sorgu çalıştırın, kayıtları CPU veya bellek tüketimine göre sıralayın ve ardından yüksek yük oluşturan SQL ifadelerini optimize edin.Dengesiz yükü çözün — FE düğümleri arasında yük dengelemeyi sağlamak için SLB ve istemci tarafı bağlantı havuzu yapılandırın. Bu, bellek artışlarına ve sık GC'ye neden olan isteklerin tek bir FE Leader üzerinde yoğunlaşmasını önler.
Yazma yöntemini optimize edin — Kaynaktaki FE ayrıştırma darboğazlarını ortadan kaldırmak için büyük
VALUESekleme işlemlerini Stream Load ile değiştirin.