AnalyticDB for PostgreSQL, tablo verilerini tablo oluşturma sırasında seçtiğiniz bir dağıtım şemasına göre hesaplama düğümleri arasında dağıtır. Seçtiğiniz şema ve dağıtım anahtarı; kümenizdeki sorgu performansı, veri dengesi ve birleştirme (join) verimliliğini doğrudan etkiler.
Dağıtım şemaları
AnalyticDB for PostgreSQL üç dağıtım şemasını destekler:
CREATE TABLE <table_name> (...)
[ DISTRIBUTED BY (<column> [,..] ) | DISTRIBUTED RANDOMLY | DISTRIBUTED REPLICATED ]V4.3 yalnızca hash dağıtımı ve rastgele dağıtımı destekler. Çoğaltılmış dağıtım V6.0 sürümünde tanıtılmıştır.
| Şema | Sözdizimi | Nasıl çalışır? | Ne zaman kullanılır? |
|---|---|---|---|
| Hash dağıtımı (varsayılan) | DISTRIBUTED BY (column, [...]) |
Her satırı, dağıtım sütununun hash değerine göre bir hesaplama düğümüne atar. Aynı hash değerine sahip satırlar aynı düğüme gider. DISTRIBUTED yan tümcesi belirtilmezse tablo, birincil anahtarını dağıtım anahtarı olarak kullanır. Uygun bir anahtar yoksa rastgele dağıtıma geçer. |
Çoğu tablo için uygundur. Sorgular dağıtım anahtarını kullandığında birlikte yerleştirilmiş birleştirmelere (collocated joins) ve hesaplama düğümü filtrelemesine olanak tanır. |
| Rastgele dağıtım | DISTRIBUTED RANDOMLY |
Satırları round-robin algoritması kullanarak tüm hesaplama düğümlerine eşit şekilde dağıtır. Aynı hash değerine sahip satırlar farklı düğümlere düşebilir. | Yalnızca hash dağıtımı için uygun bir sütun olmadığında kullanın. Birlikte yerleştirilmiş birleştirmeleri veya hesaplama düğümü filtrelemesini desteklemez. |
| Çoğaltılmış dağıtım | DISTRIBUTED REPLICATED |
Tablonun tam bir kopyasını her hesaplama düğümünde saklar. | Sıkça büyük tablolarla birleştirilen küçük arama tabloları için kullanın. Birleştirme performansını artırır. |
Örnekler:
-- Hash distribution
CREATE TABLE products (
    name        varchar(40),
    prod_id     integer,
    supplier_id integer
) DISTRIBUTED BY (prod_id);

-- Random distribution
CREATE TABLE random_stuff (
    things  text,
    doodads text,
    etc     text
) DISTRIBUTED RANDOMLY;

-- Replicated distribution
CREATE TABLE replicated_stuff (
    things  text,
    doodads text,
    etc     text
) DISTRIBUTED REPLICATED;
Hash dağıtımının sorgu yönlendirmesini nasıl etkilediği
Bir sorgu dağıtım anahtarı üzerinde filtreleme yaptığında AnalyticDB for PostgreSQL, sorguyu yalnızca eşleşen satırları tutan hesaplama düğümlerine yönlendirir. Örneğin aşağıdaki sorgu tüm düğümleri taramak yerine yalnızca prod_id = 101 içeren düğüme gönderilir:
SELECT * FROM products WHERE prod_id = 101;Dağıtım anahtarı seçme
Hash dağıtımı için etkili bir dağıtım anahtarı seçmek üzere aşağıdaki adımları sırayla izleyin:
1. Adım: Verisi eşit dağılmış bir sütun seçin.
Eşit olmayan veri dağılımı, veri çarpıklığına (data skew) neden olur; bazı hesaplama düğümleri diğerlerinden çok daha fazla satır barındırarak yükü artırır ve sorguları yavaşlatır. Genellikle düşük kardinaliteye sahip olan ve çarpık dağılımlar üreten Boolean, saat ve tarih sütunlarından kaçının.
2. Adım: Birleştirme koşullarında sıkça kullanılan bir sütun seçin.
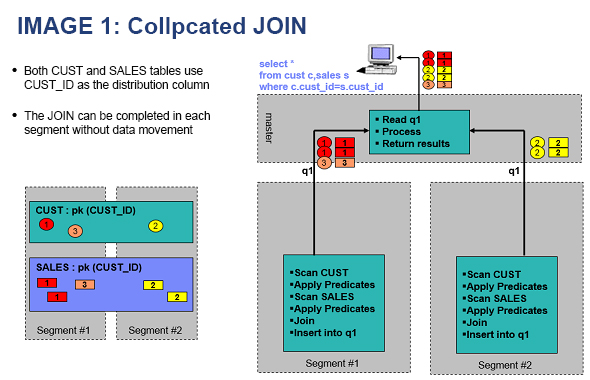
Birleştirme anahtarı dağıtım anahtarıyla eşleştiğinde AnalyticDB for PostgreSQL birlikte yerleştirilmiş birleştirme (collocated join) yapar: Her hesaplama düğümü yalnızca kendi yerel verilerini birleştirir ve düğümler arasında veri hareketi olmaz.
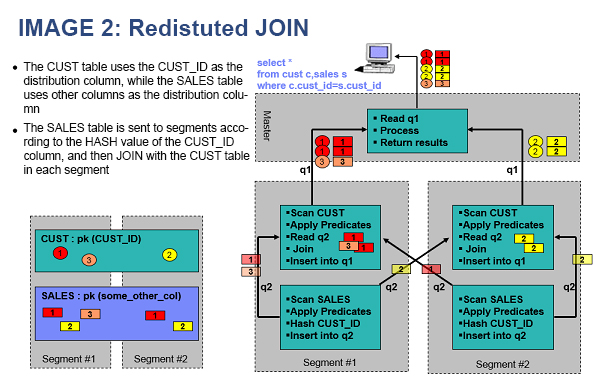
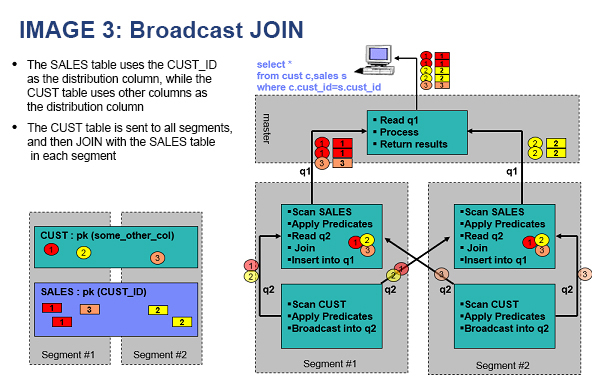
Birleştirme anahtarı dağıtım anahtarından farklı olduğunda sorgu motoru birleştirmeden önce yeniden dağıtma hareketi (redistribute motion) veya yayın hareketi (broadcast motion) yapmak zorunda kalır; her ikisi de birlikte yerleştirilmiş birleştirmeye kıyasla daha ağır ağ ek yükü getirir.
3. Adım: Sorgu filtresi olarak sıkça kullanılan bir sütun seçin.
Dağıtım anahtarı üzerinde filtreleme yapmak AnalyticDB for PostgreSQL'in ilgili satırları tutmayan hesaplama düğümlerini atlamasına olanak tanır ve sorgu başına taranan veri miktarını azaltır.
4. Adım: Benzersiz bir anahtarı tercih edin.
Birincil anahtar gibi benzersiz bir anahtar kardinaliteyi en üst düzeye çıkarır ve satırların düğümler arasında eşit yayılmasını sağlar. Tablonuzda bir birincil anahtar varsa bunu başlangıç noktası olarak kullanın.
5. Adım: Bileşik dağıtım anahtarını değerlendirin.
Yukarıdaki kriterleri karşılayan tek bir sütun yoksa iki veya daha fazla sütunu dağıtım anahtarı olarak birleştirin:
CREATE TABLE t1 (c1 int, c2 int) DISTRIBUTED BY (c1, c2);Dağıtım anahtarları üzerindeki sınırlamalar
Dağıtım anahtarı sütunları güncellenemez. Dağıtımı yeniden atamak için
ALTER TABLE ... SET DISTRIBUTED BYkullanın.-
Dağıtım anahtarı birincil anahtarın veya benzersiz anahtarın bir parçası olmalıdır. Aşağıdaki örnek başarısız olur çünkü
c2(dağıtım anahtarı) birincil anahtarc1içinde yer almaz:CREATE TABLE t1 (c1 int, c2 int, PRIMARY KEY (c1)) DISTRIBUTED BY (c2); -- ERROR: PRIMARY KEY and DISTRIBUTED BY definitions incompatible Geometri ve özel veri türü sütunları dağıtım anahtarı olarak kullanılamaz.
Veri çarpıklığını giderme
Veri çarpıklığı, bir veya daha fazla hesaplama düğümünün diğerlerinden önemli ölçüde daha fazla satır depolaması durumunda ortaya çıkar. Yaygın bir neden, durum bayrağı veya birçok satırın aynı değeri paylaştığı tarih sütunu gibi düşük kardinaliteli bir sütun seçmektir. Bu değere sahip tüm satırlar aynı düğüme hashlenir, bu da düğümü aşırı yüklerken diğerlerinin yetersiz kullanılmasına neden olur.
Veri çarpıklığını tespit etmek için hesaplama düğümü başına satır sayısını sorgulayın:
SELECT gp_segment_id, count(1)
FROM t1
GROUP BY 1
ORDER BY 2 DESC;

 gp_segment_id | count
---------------+--------
             2 | 131191
             0 |     72
             1 |     68
(3 rows)
Yukarıdaki çıktı ciddi bir çarpıklık göstermektedir: Düğüm 2 neredeyse tüm veriyi barındırmaktadır.
Veri çarpıklığını düzeltmek için dağıtım anahtarını değerleri daha eşit dağılmış bir sütunla değiştirin:
ALTER TABLE t1 SET DISTRIBUTED BY (c2);Yeniden dağıtımdan sonra veriler tüm hesaplama düğümlerine eşit şekilde yayılır.