ack-koordinator Descheduler, gerçek kaynak kullanımına göre aşırı yüklenmiş düğümleri tespit eder ve kümeyi yeniden dengelemek için Pod'ları tahliye eder.
Bu konuda, yeniden planlayıcının nasıl kurulacağı, hot spot farkındalıklı yeniden planlamanın nasıl etkinleştirileceği ve gelişmiş parametrelerinin nasıl yapılandırılacağı açıklanmaktadır.
Sınırlamalar
Yalnızca ACK yönetilen Pro kümeleri desteklenir.
-
Gerekli bileşen sürümleri:
Bileşen
Sürüm
ACK Scheduler
v1.22.15-ack-4.0 veya üzeri, v1.24.6-ack-4.0 veya üzeri
ack-koordinator
v1.1.1-ack.1 veya üzeri
Helm
v3.0 veya üzeri
Koordinator Descheduler yalnızca Pod'ları tahliye eder; yeniden planlama işlemini ACK Scheduler yönetir. Tahliye edilen Pod'ların tekrar hot spot düğümlere yerleşmesini önlemek için yeniden planlamayı yük farkındalıklı zamanlama ile birlikte kullanın.
Yeniden planlama sırasında, yeni Pod'lar oluşturulmadan önce eski Pod'lar tahliye edilir. Kullanılabilirliği korumak için uygulamanızın yeterli yedek çoğaltmaya sahip olduğundan emin olun.
Yeniden planlama, standart Kubernetes tahliye API'sini kullanır. Tahliye sonrası yeniden başlatmaların hizmetinizi kesintiye uğratmaması için Pod'larınızın yeniden giriş yapılabilir (re-entrant) olduğundan emin olun.
Faturalandırma
ack-koordinator'u kurmak ve kullanmak ücretsizdir. Aşağıdaki senaryolarda ek ücretler uygulanabilir:
Çalışan düğüm kaynakları: ack-koordinator, çalışan düğüm kaynaklarını tüketen kendi kendine yönetilen bir bileşendir. Kurulum sırasında her modül için kaynak isteklerini yapılandırın.
Prometheus özel ölçümleri: Enable Prometheus Monitoring for ACK-Koordinator seçeneğini etkinleştirir ve Managed Service for Prometheus kullanırsanız, sunulan ölçümler özel ölçümler olarak sayılır ve ücretlendirilir. Ücretler küme boyutuna ve uygulama sayısına bağlıdır. Bu özelliği etkinleştirmeden önce Prometheus örneklerinin faturalandırmasını inceleyin. Kaynak tüketiminizi izlemek için kullanım verilerini sorgulayın.
Nasıl çalışır
Çalıştırma döngüsü
Koordinator Descheduler periyodik olarak çalışır. Her çalıştırma döngüsü üç aşamadan oluşur:
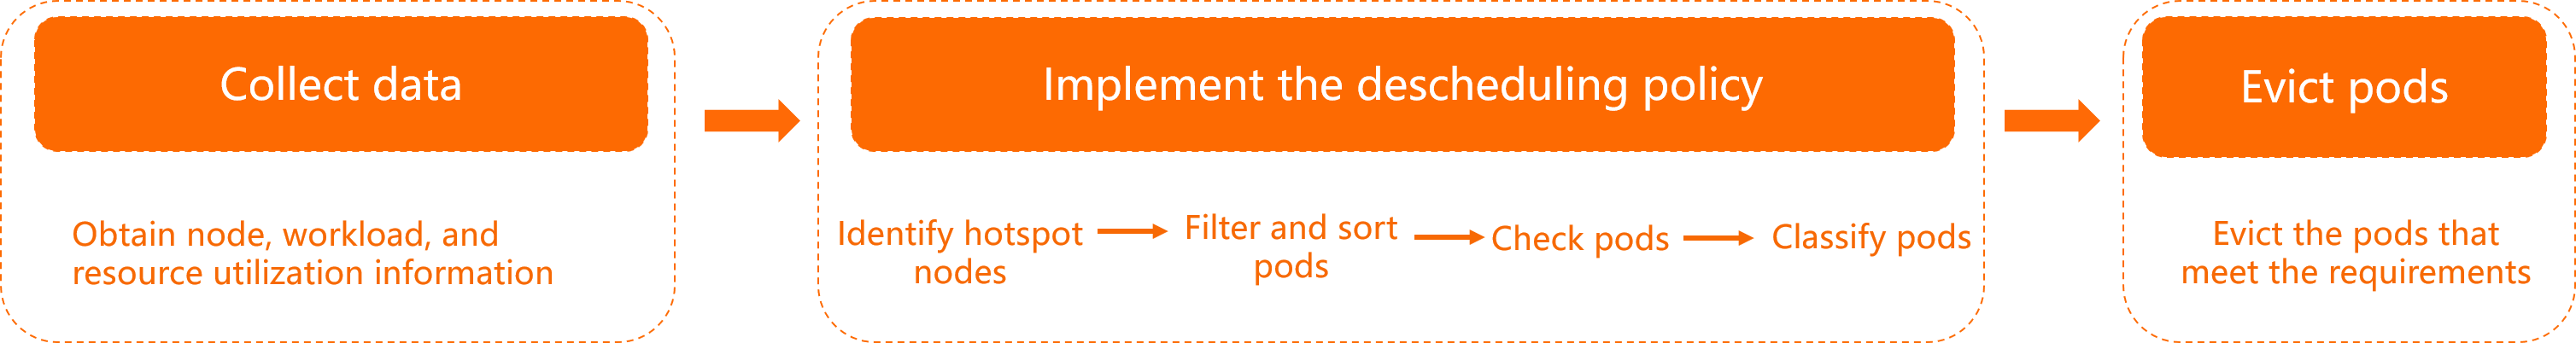
Veri toplama: Düğüm ve iş yükü bilgileri ile kaynak kullanım verilerini getirir.
-
Eklenti çalıştırması (LowNodeLoad örneği):
highThresholdsvelowThresholdsdeğerlerine göre hot spot düğümleri belirler.Tüm hot spot düğümleri tarar, uygun Pod'ları puanlar ve tahliye için sıralar. Bkz. Pod puanlama ilkesi.
Her aday Pod'u küme kapasitesi, kaynak kullanımı ve çoğaltma oranı sınırları gibi geçiş kısıtlamalarına göre kontrol eder. Bkz. Yük farkındalıklı hot spot yeniden planlama ilkeleri.
Kriterleri karşılayan Pod'ları geçiş adayı olarak işaretler, diğerlerini atlar.
Pod tahliyesi ve geçişi: Geçiş adaylarını tahliye API'si aracılığıyla tahliye eder.
Düğüm sınıflandırması
LowNodeLoad eklentisi, iki eşik değerine göre düğümleri üç kategoriye ayırır: lowThresholds (boşta kalma eşiği) ve highThresholds (hot spot eşiği).
lowThresholds = %45 ve highThresholds = %70 örneği:

Boşta düğüm: Kaynak kullanımı
lowThresholdsdeğerinin altındadır (< %45).Normal düğüm: Kaynak kullanımı
lowThresholdsvehighThresholdsarasındadır (%45–%70). Bu, hedef aralıktır.Hot spot düğüm: Kaynak kullanımı
highThresholdsdeğerini aşar (> %70). Düğüm yükü %70 veya altına düşene kadar Pod'lar tahliye edilir.
Kaynak kullanım verileri her dakika güncellenir ve 5 dakikalık ortalamayı yansıtır.
Tüm düğümlerlowThresholdsdeğerini aşarsa, bazı düğümlerhighThresholdsdeğerini aşsa bile küme yükünün yüksek olduğu kabul edilir ve yeniden planlama askıya alınır.
Yük farkındalıklı hot spot yeniden planlama ilkeleri
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Ön koşullar
Başlamadan önce aşağıdakilere sahip olduğunuzdan emin olun:
ACK Scheduler v1.22.15-ack-4.0 veya üzeri, ack-koordinator v1.1.1-ack.1 veya üzeri ve Helm v3.0 veya üzeri
Adım 1: ack-koordinator'da yeniden planlamayı etkinleştirin
Yeni kurulum: ack-koordinator'u yükleyin ve yapılandırma sayfasında Enable ACK-Koordinator Descheduling Module seçeneğini işaretleyin.
Mevcut kurulum: Yapılandırma sayfasında Enable ACK-Koordinator Descheduling Module seçeneğini işaretleyin. Bkz. ack-koordinator'u değiştirme.
Adım 2: LowNodeLoad eklentisini etkinleştirin
-
LowNodeLoad eklentisini etkinleştirmek için bir
koord-descheduler-config.yamlConfigMap oluşturun.# koord-descheduler-config.yaml apiVersion: v1 kind: ConfigMap metadata: name: koord-descheduler-config namespace: kube-system data: koord-descheduler-config: | # System configuration for koord-descheduler. Do not modify this section. apiVersion: descheduler/v1alpha2 kind: DeschedulerConfiguration leaderElection: resourceLock: leases resourceName: koord-descheduler resourceNamespace: kube-system deschedulingInterval: 120s # Execution interval. The descheduler runs every 120s. # Must not exceed detectorCacheTimeout (default: 5m). dryRun: false # Set to true to run in read-only mode (no evictions). # End of system configuration. profiles: - name: koord-descheduler plugins: balance: enabled: - name: LowNodeLoad # Enable the LowNodeLoad plugin for hot spot descheduling. evict: enabled: - name: MigrationController # Enable the eviction and migration controller. pluginConfig: - name: MigrationController args: apiVersion: descheduler/v1alpha2 kind: MigrationControllerArgs defaultJobMode: EvictDirectly - name: LowNodeLoad args: apiVersion: descheduler/v1alpha2 kind: LowNodeLoadArgs # A node is idle if usage of ALL resources is below lowThresholds. lowThresholds: cpu: 20 # 20% CPU utilization memory: 30 # 30% memory utilization # A node is a hot spot if usage of ANY resource exceeds highThresholds. highThresholds: cpu: 50 # 50% CPU utilization memory: 60 # 60% memory utilization # Scopes descheduling to specific namespaces. # include and exclude are mutually exclusive—configure only one. evictableNamespaces: include: - default # exclude: # - "kube-system" # - "koordinator-system" -
ConfigMap'i kümeye uygulayın.
kubectl apply -f koord-descheduler-config.yaml -
Yeni yapılandırmayı yüklemek için Koordinator Descheduler'ı yeniden başlatın.
kubectl -n kube-system scale deploy ack-koord-descheduler --replicas 0
kubectl -n kube-system scale deploy ack-koord-descheduler --replicas 1
Adım 3 (isteğe bağlı): Yük farkındalıklı zamanlamayı etkinleştirin
Optimal yük dengeleme için, ACK Scheduler'ın tahliye sonrası Pod'ları hot spot düğümlere yerleştirmemesini sağlamak amacıyla yük farkındalıklı zamanlamayı etkinleştirin.
loadAwareThreshold değerini highThresholds ile eşleşecek şekilde ayarlayın. Uyuşmazlık durumunda, özellikle benzer kullanıma sahip az sayıda düğüm varsa, tahliye edilen Pod'lar hot spot düğümlere yeniden planlanabilir.
Adım 4: Yeniden planlamayı doğrulayın
Bu örnekte, her düğümün 104 çekirdek ve 396 GiB belleğe sahip olduğu üç düğümlü bir küme kullanılmaktadır.
-
Aşağıdaki içeriğe sahip bir
stress-demo.yamldosyası oluşturun.apiVersion: apps/v1 kind: Deployment metadata: name: stress-demo namespace: default labels: app: stress-demo spec: replicas: 6 selector: matchLabels: app: stress-demo template: metadata: name: stress-demo labels: app: stress-demo spec: containers: - args: - '--vm' - '2' - '--vm-bytes' - '1600M' - '-c' - '2' - '--vm-hang' - '2' command: - stress image: polinux/stress imagePullPolicy: Always name: stress resources: limits: cpu: '2' memory: 4Gi requests: cpu: '2' memory: 4Gi restartPolicy: Always -
Stres testi iş yükünü dağıtın.
kubectl create -f stress-demo.yamlBeklenen çıktı:
deployment.apps/stress-demo created -
Pod'ların çalıştığını doğrulayın ve atanmış düğümlerini not edin.
kubectl get pod -o wideBeklenen çıktı:
NAME READY STATUS RESTARTS AGE IP NODE NOMINATED NODE READINESS GATES stress-demo-588f9646cf-s**** 1/1 Running 0 82s 10.XX.XX.53 cn-beijing.10.XX.XX.53 <none> <none> -
cn-beijing.10.XX.XX.53üzerindeki yükü artırın ve düğüm kullanımını kontrol edin.kubectl top nodeBeklenen çıktı:
NAME CPU(cores) CPU% MEMORY(bytes) MEMORY% cn-beijing.10.XX.XX.215 17611m 17% 24358Mi 6% cn-beijing.10.XX.XX.53 63472m 63% 11969Mi 3%cn-beijing.10.XX.XX.53düğümü, %50'lik hot spot eşiğini aşan %63 CPU kullanımına sahiptir.cn-beijing.10.XX.XX.215düğümü ise %20'lik boşta kalma eşiğinin altında olan %17 CPU kullanımına sahiptir. Adım 2: LowNodeLoad eklentisini etkinleştirin bölümünde açıklandığı gibi LowNodeLoad eklentisini etkinleştirin.
-
Pod değişikliklerini izleyin.
Varsayılan olarak, bir düğümün hot spot olarak sınıflandırılması için beş ardışık kontrolde (~120 saniyelik varsayılan aralıkla ~10 dakika)
highThresholdsdeğerini aşması gerekir.kubectl get pod -wBeklenen çıktı:
NAME READY STATUS RESTARTS AGE IP NODE NOMINATED NODE READINESS GATES stress-demo-588f9646cf-s**** 1/1 Terminating 0 59s 10.XX.XX.53 cn-beijing.10.XX.XX.53 <none> <none> stress-demo-588f9646cf-7**** 1/1 ContainerCreating 0 10s 10.XX.XX.215 cn-beijing.10.XX.XX.215 <none> <none> -
Tahliye olayını kontrol edin.
kubectl get event | grep stress-demo-588f9646cf-s****Beklenen çıktı:
2m14s   Normal   Evicting        podmigrationjob/00fe88bd-****   Pod "default/stress-demo-588f9646cf-s****" evicted from node "cn-beijing.10.XX.XX.53" by the reason "node is overutilized, cpu usage(68.53%)>threshold(50.00%)"
101s    Normal   EvictComplete   podmigrationjob/00fe88bd-****   Pod "default/stress-demo-588f9646cf-s****" has been evicted
2m14s   Normal   Descheduled     pod/stress-demo-588f9646cf-s****   Pod evicted from node "cn-beijing.10.XX.XX.53" by the reason "node is overutilized, cpu usage(68.53%)>threshold(50.00%)"
2m14s   Normal   Killing         pod/stress-demo-588f9646cf-s****   Stopping container stress
Hot spot düğümdeki Pod tahliye edilmiş ve
cn-beijing.10.XX.XX.215düğümüne taşınmıştır.
Gelişmiş yapılandırma
Tüm Koordinator Descheduler parametreleri, Adım 2'deki ConfigMap içinde yapılandırılır.
# koord-descheduler-config.yaml
apiVersion: v1
kind: ConfigMap
metadata:
  name: koord-descheduler-config
  namespace: kube-system
data:
  koord-descheduler-config: |
    # System configuration. Do not modify this section.
    apiVersion: descheduler/v1alpha2
    kind: DeschedulerConfiguration
    leaderElection:
      resourceLock: leases
      resourceName: koord-descheduler
      resourceNamespace: kube-system
    deschedulingInterval: 120s  # Execution interval. Must not exceed detectorCacheTimeout.
    dryRun: false               # Set to true for read-only mode (no evictions).
    # End of system configuration.

    profiles:
    - name: koord-descheduler
      plugins:
        deschedule:
          disabled:
            - name: "*"  # All plugins disabled by default (shown for reference only).
        balance:
          enabled:
            - name: LowNodeLoad
        evict:
          disabled:
            - name: "*"  # All plugins disabled by default (shown for reference only).
          enabled:
            - name: MigrationController

      pluginConfig:
      - name: MigrationController
        args:
          apiVersion: descheduler/v1alpha2
          kind: MigrationControllerArgs
          defaultJobMode: EvictDirectly
          maxMigratingPerNode: 1       # Max Pods migrating simultaneously per node. 0 = unlimited.
          maxMigratingPerNamespace: 1  # Max Pods migrating simultaneously per namespace.
          maxMigratingPerWorkload: 1   # Max Pods migrating simultaneously per workload (e.g., Deployment).
          maxUnavailablePerWorkload: 2 # Max unavailable replicas per workload during migration.
          evictLocalStoragePods: false # Whether to evict Pods using HostPath or emptyDir volumes.
          objectLimiters:
            workload:               # At most 1 replica migrated per workload within 5 minutes.
              duration: 5m
              maxMigrating: 1

      - name: LowNodeLoad
        args:
          apiVersion: descheduler/v1alpha2
          kind: LowNodeLoadArgs

          lowThresholds:
            cpu: 20
            memory: 30
          highThresholds:
            cpu: 50
            memory: 60

          anomalyCondition:
            consecutiveAbnormalities: 5  # Number of consecutive checks above highThresholds
                                          # before a node is classified as a hot spot.
                                          # Counter resets after eviction.

          detectorCacheTimeout: "5m"  # Cache duration for hot spot checks.
                                      # Must be >= deschedulingInterval.

          evictableNamespaces:
            include:
              - default
            # exclude:
            #   - "kube-system"
            #   - "koordinator-system"

          nodeSelector:  # Process only the specified nodes.
            matchLabels:
              alibabacloud.com/nodepool-id: np77f520e1108f47559e63809713ce****

          podSelectors:  # Process only the specified Pods.
          - name: lsPods
            selector:
              matchLabels:
                koordinator.sh/qosClass: "LS"
Koordinator Descheduler sistem yapılandırması
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Tahliye ve geçiş kontrolü yapılandırması
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
LowNodeLoad eklenti yapılandırması
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
SSS
Düğüm kullanımı eşiği aşıyor ancak Pod'lar tahliye edilmiyor
En yaygın neden, etkin olmayan bir yeniden planlayıcı yapılandırmasıdır. Sırasıyla kontrol edin:
Kapsam yapılandırılmadı: Yeniden planlayıcı yalnızca açıkça dahil edilen (veya hariç tutulmayan) ad alanlarını ve düğümleri işler.
evictableNamespacesvenodeSelectordeğerlerini doğrulayın.Yapılandırma değişikliğinden sonra yeniden planlayıcı yeniden başlatılmadı: Yapılandırma değişiklikleri yeniden başlatma gerektirir. Talimatlar için Adım 2 bölümüne bakın.
Aralık önbellek zaman aşımından uzun:
deschedulingInterval(varsayılan: 2 dk) değeridetectorCacheTimeout(varsayılan: 5 dk) değerini aşmamalıdır; aksi takdirde hot spot tespiti başarısız olur. Ayarlayın ve yeniden başlatın.Düğüm sürekli olarak eşiğin üzerinde değil: Yeniden planlayıcı yumuşatılmış bir ortalama kullanır. Bir düğüm,
highThresholdsdeğeriniconsecutiveAbnormalitiesardışık döngü boyunca (varsayılan: 5, ~10 dakika) aştığında hot spot olarak sınıflandırılır.kubectl top nodeyalnızca son dakikayı yansıtır; sürdürülebilir kullanımı onaylamak için daha uzun bir süre izleyin.Yetersiz küme kapasitesi: Bir Pod'u tahliye etmeden önce yeniden planlayıcı başka bir düğümün yeterli boş kapasiteye sahip olduğunu doğrular. Hiçbiri yoksa tahliye atlanır. Kapasiteyi artırmak için düğüm ekleyin.
Tek çoğaltmalı iş yükü: Tek çoğaltmalı Pod'lar varsayılan olarak tahliye edilmez. Geçersiz kılmak için Pod'a veya iş yükünün
spec.template.metadatabölümünedescheduler.alpha.kubernetes.io/evict: "true"açıklamasını ekleyin. ack-koordinator v1.3.0-ack1.6 ile v1.3.0-ack1.8 arasında desteklenmez. Bu özelliği kullanmak için en son sürüme yükseltin.Pod HostPath veya emptyDir kullanıyor: Varsayılan olarak yeniden planlamadan hariç tutulur. Tahliyeyi etkinleştirmek için MigrationController'da
evictLocalStoragePods: trueayarını yapın. Bkz. Tahliye ve geçiş kontrolü yapılandırması.Çok sayıda kullanılamayan veya geçen çoğaltma: Kullanılamayan veya geçen çoğaltmalar
maxUnavailablePerWorkloadveyamaxMigratingPerWorkloaddeğerine ulaşırsa, daha fazla tahliye engellenir. Devam eden tahliyeleri bekleyin veya bu sınırları artırın.Çoğaltma sayısı ≤ geçiş sınırı: Toplam çoğaltma sayısı
maxMigratingPerWorkloadveyamaxUnavailablePerWorkloaddeğerinden küçük veya buna eşitse iş yükü atlanır. Bu değerleri azaltın veya yüzde kullanın.
Yeniden planlayıcı sık sık yeniden başlıyor
Geçersiz veya eksik bir ConfigMap, yeniden başlatma döngülerine neden olur. ConfigMap formatını Gelişmiş yapılandırma bölümüne göre doğrulayın, ardından Adım 2 bölümünde açıklandığı gibi yeniden başlatın.
Yük farkındalıklı zamanlama ve hot spot yeniden planlama birlikte nasıl çalışır?
Optimal yük dengeleme için her iki özelliği de etkinleştirin. Yeniden planlama, aşırı yüklenmiş düğümlerden Pod'ları tahliye eder; yük farkındalıklı zamanlama ise yeniden planlanan Pod'ları daha düşük kullanıma sahip düğümlere yerleştirir.
loadAwareThreshold değerini highThresholds ile eşleşecek şekilde ayarlayın. Bkz. Yük farkındalıklı zamanlamayı kullanma ve Zamanlama ilkeleri.
Yeniden planlayıcı hangi kullanım verilerini kullanır?
Yeniden planlayıcı, birden çok döngü üzerinden yumuşatılmış bir ortalama hesaplar. Tahliye tetiklemesi yalnızca ortalama kullanımın yapılandırılan ardışık döngüler boyunca (varsayılan: ~10 dakika) highThresholds değerinin üzerinde kalması durumunda gerçekleşir.
Yeniden planlayıcı, bellek hesaplamalarında sayfa önbelleğini dışlar (işletim sistemi tarafından geri kazanılabilir). kubectl top node sayfa önbelleğini içerir; gerçek ölçümü görüntülemek için Managed Service for Prometheus kullanın.