Non-Uniform Memory Access (NUMA) mimarisinde, çoklu GPU içeren düğümlerdeki GPU yoğun iş yükleri, CPU ve GPU'ların farklı NUMA düğümlerine yerleşmesi durumunda performans kaybı yaşar. Düğüm arası bellek erişimi gecikme süresini artırır, bant genişliğini sınırlar ve aktarım hızını düşürür. ACK'nin NUMA topoloji farkındalıklı zamanlama özelliği, bir Pod'un CPU ve GPU kaynaklarını aynı NUMA düğümünde konumlandırarak gereksiz düğüm arası trafiği ortadan kaldırır.
Nasıl çalışır?
NUMA düğümü, bir NUMA sisteminin temel birimidir. Bir NUMA seti, kaynakları verimli tahsis etmek ve işlemci belleği çekişmesini azaltmak amacıyla tek bir worker düğümündeki birden fazla düğümü bir araya getirir. Sekiz GPU içeren worker düğümleri genellikle birden fazla NUMA düğümüne sahiptir. CPU ve GPU'ların aynı NUMA düğümünde birlikte konumlandırılmaması durumunda uygulamalar, CPU çekişmesi ve NUMA düğümleri arası iletişim ek yükü ile karşılaşır.
Yerel Kubernetes, tek düğüm kaynak bağlaması için kubelet'in CPU ve NUMA ilkelerini kullanır; ancak bu yaklaşım küme düzeyinde bazı eksiklikler içerir:
Zamanlayıcının farkındalık eksikliği: Zamanlayıcı, yerleştirme kararları verirken kalan NUMA kaynaklarını değerlendiremez. Bu durum Pod'ların
AdmissionErrordurumuna girmesine ve kümenin kararsız hale gelmesine neden olur.Kontrol edilemeyen yerleştirme: Topoloji ilkeleri düğüm düzeyinde parametrelerdir; bu nedenle küme genelinde birlikte konumlandırmayı kontrol etmek için düğüm uygunluğunu kullanamazsınız.
İlke esnekliğinin yetersizliği: Her düğüm yalnızca bir topoloji ilkesini destekler. Bu durum, manuel küme bölümleme ve etiketleme gerektirerek genel kaynak kullanımını azaltır.
ACK, Scheduler Framework aracılığıyla bu sınırlamaları çözer. ack-koordinator bileşenlerinin alt parçaları olan gputopo-device-plugin ve ack-koordlet, her düğümden CPU ve GPU topolojisini zamanlayıcıya bildirir. Bu sayede NUMA yerleştirme ilkelerini Pod düzeyinde tanımlayabilirsiniz.

Ön koşullar
Başlamadan önce aşağıdaki ön koşulları karşıladığınızdan emin olun:
Küme:
1,24 veya sonraki bir sürümde çalışan bir ACK Pro kümesi. Yükseltme yapmak için bkz. Küme yükseltme.
Düğümler:
sccgn7ex örnek ailesinden (GPU hızlandırmalı süper bilgi işlem kümeleri) düğümler veya Lingjun düğümleri. Örnek ailesi ayrıntıları için bkz. Örnek aileleri. Lingjun düğümleri hakkında bilgi edinmek için bkz. LINGJUN kümelerini ve Lingjun düğümlerini yönetme.
Topoloji farkındalıklı GPU zamanlaması istediğiniz her düğüme
ack.node.gpu.schedule=topologyetiketinin eklenmiş olması. Talimatlar için bkz. Zamanlama özelliklerini etkinleştirme.
Bileşenler:
kube-scheduler sürüm 6.4.4 veya üzeri. Yükseltmek için ACK konsoluna gidin, küme adınıza tıklayın ve Operations Management > Add-ons seçeneklerini seçin. Daha fazla bilgi için bkz. kube-scheduler.
-
Aşağıdaki yapılandırmayla kurulu olan ack-koordinator eklentisi (eski adıyla ack-slo-manager):
ACK Lingjun kümeleri: Ek yapılandırma olmadan ack-koordinator'u doğrudan yükleyin.
ACK Pro kümeleri: Kurulum sırasında
agentFeaturesÖzellik Kapısı içindekiNodeTopologyReportalanınıtrueolarak ayarlayın.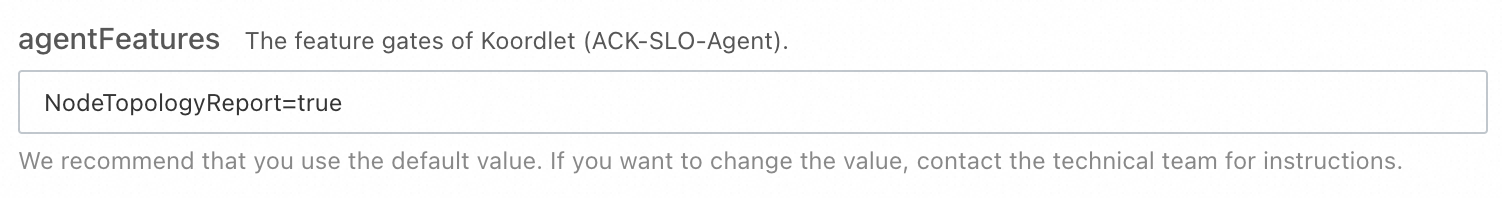
GPU topolojisi raporlama eklentisinin (gputopo-device-plugin) yüklü olması. Bu eklenti, GPU'dan CPU'ya NUMA topolojisi bilgilerini toplar ve kümeye bildirir. Yükleme talimatları için bkz. GPU topoloji farkındalıklı zamanlama eklentisini yükleme.
GPU topolojisi raporlama eklentisini ack-koordinator'dan önce yüklerseniz, ack-koordinator kurulumu tamamlandıktan sonra GPU topolojisi raporlama eklentisini yeniden başlatın.
Sınırlamalar
Uyumsuzluk:
Bu özellik, birleşik CPU ve GPU NUMA uygunluğu zamanlaması sağlar. Eski bağımsız zamanlama ilkeleriyle karşılıklı olarak özeliktir. Bu özelliği, zaten topoloji farkındalıklı CPU zamanlaması veya topoloji farkındalıklı GPU zamanlamasının eski bağımsız sürümünü kullanan iş yüklerinde etkinleştirmeyin.
Yalnızca CPU ve GPU birlikte konumlandırması desteklenir.
Kaynak teknik özellikleri gereksinimleri:
Bir Pod'daki tüm konteynerler için CPU talepleri tam sayı olmalıdır (birim: çekirdek) ve talepler limitlere eşit olmalıdır.
GPU kaynakları
nvidia.com/gpuyerinealiyun.com/gpukullanılarak talep edilmelidir. Yalnızca tam GPU kartları desteklenir.
Faturalama
Bu özellik, ek ücretlere neden olabilecek Cloud-Native AI Suite'i gerektirir. Ayrıntılar için bkz. Cloud-Native AI Suite faturalandırması.
Worker düğümü kaynakları: ack-koordinator, worker düğümlerinde kendi kendine yönetilen bir bileşen olarak çalışır ve CPU ile bellek tüketir. Kurulum sırasında her modül için kaynak taleplerini yapılandırın.
Prometheus izleme ölçümleri: Kurulum sırasında Enable Prometheus Metrics for ACK-Koordinator seçeneğini işaretler ve Alibaba Cloud Prometheus kullanırsanız, ölçümler özel ölçümler olarak sayılır ve küme boyutuna ve uygulama sayısına göre ücretlendirilir. Bu seçeneği etkinleştirmeden önce ücretsiz kota ve faturalandırma ayrıntıları için Prometheus faturalandırma belgelerine göz atın. Kullanımı faturalandırma ve kullanım sorguları aracılığıyla izleyin.
NUMA topoloji farkındalıklı zamanlamayı etkinleştirme
Pod spesifikasyonunuza aşağıdaki açıklamaları ekleyin. YAML içindeki yorumlar, her alan için geçerli olan tüm değerleri listeler.
apiVersion: v1
kind: Pod
metadata:
  name: example
  annotations:
    # Enables CPU binding. Only "required" is supported.
    cpuset-scheduler: required
    # numaTopologyPolicy controls placement scope:
    #   "SingleNUMANode" – all CPUs and GPUs on the same NUMA node (strict)
    #   "Restricted"     – all CPUs and GPUs within the same NUMA set (strict)
    #   "BestEffort"     – attempts same-node placement; falls back if unavailable
    # singleNUMANodeExclusive controls which NUMA node types are eligible:
    #   "Required" (default) – avoids NUMA nodes already used by pods with a different topology type
    #   "Preferred"          – no restriction on NUMA node type
    scheduling.alibabacloud.com/numa-topology-spec: |
      {
        "numaTopologyPolicy": "SingleNUMANode",
        "singleNUMANodeExclusive": "Preferred"
      }
spec:
  containers:
  - name: example
    image: ghcr.io/huggingface/text-generation-inference:1.4
    resources:
      limits:
        aliyun.com/gpu: '4'
        cpu: '24'
      requests:
        aliyun.com/gpu: '4'
        cpu: '24'
Yerleştirme ilkesi (numaTopologyPolicy)
numaTopologyPolicy parametresi, CPU ve GPU yerleştirme kapsamını kontrol eder.
| Değer | Davranış | İlke karşılanamadığında |
|---|---|---|
SingleNUMANode |
Tüm CPU ve GPU'ları aynı NUMA düğümüne yerleştirir | Pod zamanlanmaz |
Restricted |
Tüm CPU ve GPU'ları aynı NUMA seti içinde (tek bir worker üzerindeki birden fazla düğüm) yerleştirir | Pod zamanlanmaz |
BestEffort |
CPU ve GPU'ları aynı NUMA düğümüne yerleştirmeyi dener | Sonraki en iyi mevcut düğümü seçer |
Özel kullanımlılık ilkesi (singleNUMANodeExclusive)
singleNUMANodeExclusive parametresi, Pod'un hangi NUMA düğümü türlerini kullanabileceğini kontrol eder.
NUMA düğümleri, mevcut doluluk durumlarına göre kategorize edilir:
| NUMA düğümü türü | Açıklama |
|---|---|
idle |
Üzerinde çalışan Pod yok |
single |
Üzerinde yalnızca tek bir NUMA düğümüne bağlı Pod'lar çalışıyor |
shared |
Üzerinde yalnızca birden fazla NUMA düğümüne yayılmış Pod'lar çalışıyor |
| Değer | Yerleştirme kuralı |
|---|---|
Required (varsayılan) |
Tek NUMA Pod'ları yalnızca idle veya single düğümlere yerleşebilir. Çoklu NUMA Pod'ları yalnızca idle veya shared düğümlere yerleşebilir. |
Preferred |
NUMA düğümü türü üzerinde kısıtlama yok |
Performans karşılaştırması
Aşağıdaki test, NUMA topoloji farkındalıklı zamanlama etkinleştirilmeden önce ve sonra model yükleme süresini ölçer. Test, dört GPU kartında bir model yüklemek için text-generation-inference kullanır ve GPU yükleme hızını ölçmek için NVIDIA Nsight Systems'tan yararlanır.
Test ortamı: Lingjun düğümleri, text-generation-inference v1.4 (indirin), NVIDIA Nsight Systems (indirin)
Test sonuçları kullanılan araca ve ortama göre değişiklik gösterir. Aşağıdaki veriler NVIDIA Nsight Systems kullanılarak toplanmıştır; sizin sonuçlarınız farklı olabilir.
Aşağıdaki Deployment, standart nvidia.com/gpu kaynak taleplerini kullanır ve NUMA açıklamaları içermez.
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    app: tgi
  name: tgi-deployment-basic
  namespace: test
spec:
  replicas: 1
  selector:
    matchLabels:
      app: tgi
  template:
    metadata:
      labels:
        app: tgi
    spec:
      containers:
        - command:
            - sleep
            - 3600d
          image: ghcr.io/huggingface/text-generation-inference:1.4
          imagePullPolicy: IfNotPresent
          name: tgi
          ports:
            - containerPort: 80
              protocol: TCP
          resources:
            limits:
              cpu: '24'
              nvidia.com/gpu: '4'
            requests:
              cpu: '24'
              nvidia.com/gpu: '4'
          terminationMessagePath: /dev/termination-log
          terminationMessagePolicy: File
          volumeMounts:
            - mountPath: /llm
              name: volume-1710932083254
      restartPolicy: Always
      schedulerName: default-scheduler
      volumes:
        - name: volume-1710932083254
          persistentVolumeClaim:
            claimName: model
Model yükleme süresi: 15,9 saniye

Topoloji farkındalıklı zamanlama ile
Aşağıdaki Deployment, NUMA topoloji açıklamalarını ekler ve GPU kaynak talebini nvidia.com/gpu yerine aliyun.com/gpu olarak değiştirir. Bu değişiklik, ACK zamanlayıcısının GPU-CPU NUMA uygunluğunu tanımlamasına ve yönetmesine olanak tanır.
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    app: tgi-numa
  name: tgi-numa-deployment-basic
  namespace: yueming-test
spec:
  replicas: 1
  selector:
    matchLabels:
      app: tgi-numa
  template:
    metadata:
      annotations:
        cpuset-scheduler: required
        scheduling.alibabacloud.com/numa-topology-spec: |
          {
            "numaTopologyPolicy": "SingleNUMANode"
          }
      labels:
        app: tgi-numa
    spec:
      containers:
        - command:
            - sleep
            - 3600d
          image: ghcr.io/huggingface/text-generation-inference:1.4
          imagePullPolicy: IfNotPresent
          name: numa
          resources:
            limits:
              aliyun.com/gpu: '4'
              cpu: '24'
            requests:
              aliyun.com/gpu: '4'
              cpu: '24'
          volumeMounts:
            - mountPath: /llm
              name: volume-1710932083254
      restartPolicy: Always
      schedulerName: default-scheduler
      volumes:
        - name: volume-1710932083254
          persistentVolumeClaim:
            claimName: model
Model yükleme süresi: 5,4 saniye — temele kıyasla %66 iyileştirme.

Sonraki adımlar
Konteynerler için en yakın bellek erişimi hızlandırmayı etkinleştirin