模型壓縮通過量化等技術減小模型體積和計算複雜度,同時盡量保持預測效能。適用於GPU顯存有限或需要降低部署成本的情境。
簡介
PAI-Model Gallery支援基於Weight-only Quantization技術的模型量化,通過MinMax-8Bit或MinMax-4Bit策略將模型浮點數參數量化到8位或4位整數表示,減小模型體積、降低顯存佔用,同時保持較好的效能。
壓縮模型
篩選可壓縮的模型。從Model Gallery模型廣場頁面左側的支援操作篩選區域,選擇壓縮即可過濾出可壓縮的模型。
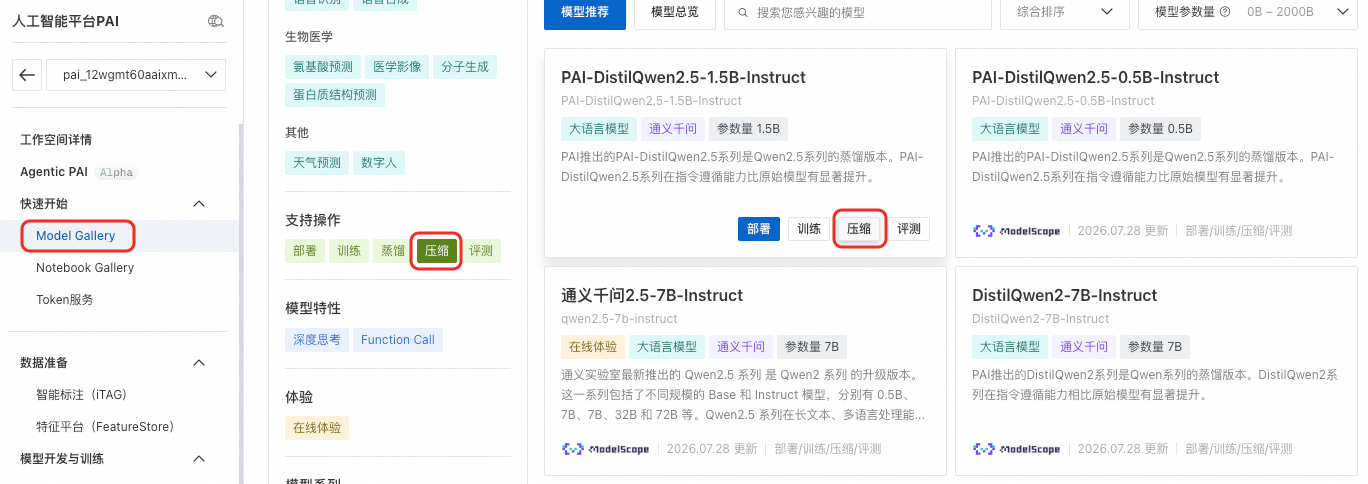
單擊目標模型卡片上的壓縮按鈕,配置壓縮任務。關鍵配置如下,其他參數按需配置。
參數
說明
壓縮方式
當前僅支援基於Weight-only Quantization技術的模型量化方法,即將模型的權重參數轉換到更低的bit位,降低模型推理的顯存佔用。
壓縮策略
MinMax-8Bit:使用最小值-最大值(min-max)縮放方法將模型量化到8位整數表示。
MinMax-4Bit:使用最小值-最大值(min-max)縮放方法將模型量化到4位整數表示。
完成配置後,單擊压缩。頁面跳轉到任务详情頁面,可查看壓縮任務的基本資料、即時狀態和任務日誌。
後續您可以在PAI-Model Gallery > 任务管理 > 压缩任务中可查看壓縮任務。
部署模型
模型壓縮任務成功後,在模型詳情頁右上方可單擊部署,部署壓縮後的模型。服務調用請參見通過共用網關調用(公網/內網)。
評測模型
模型部署完成後,您可以評測模型查看模型壓縮後的效果,詳情請參見模型評測(ModelEval)。