PAI-Model Gallery部署或微調模型時常見問題及解決方案。
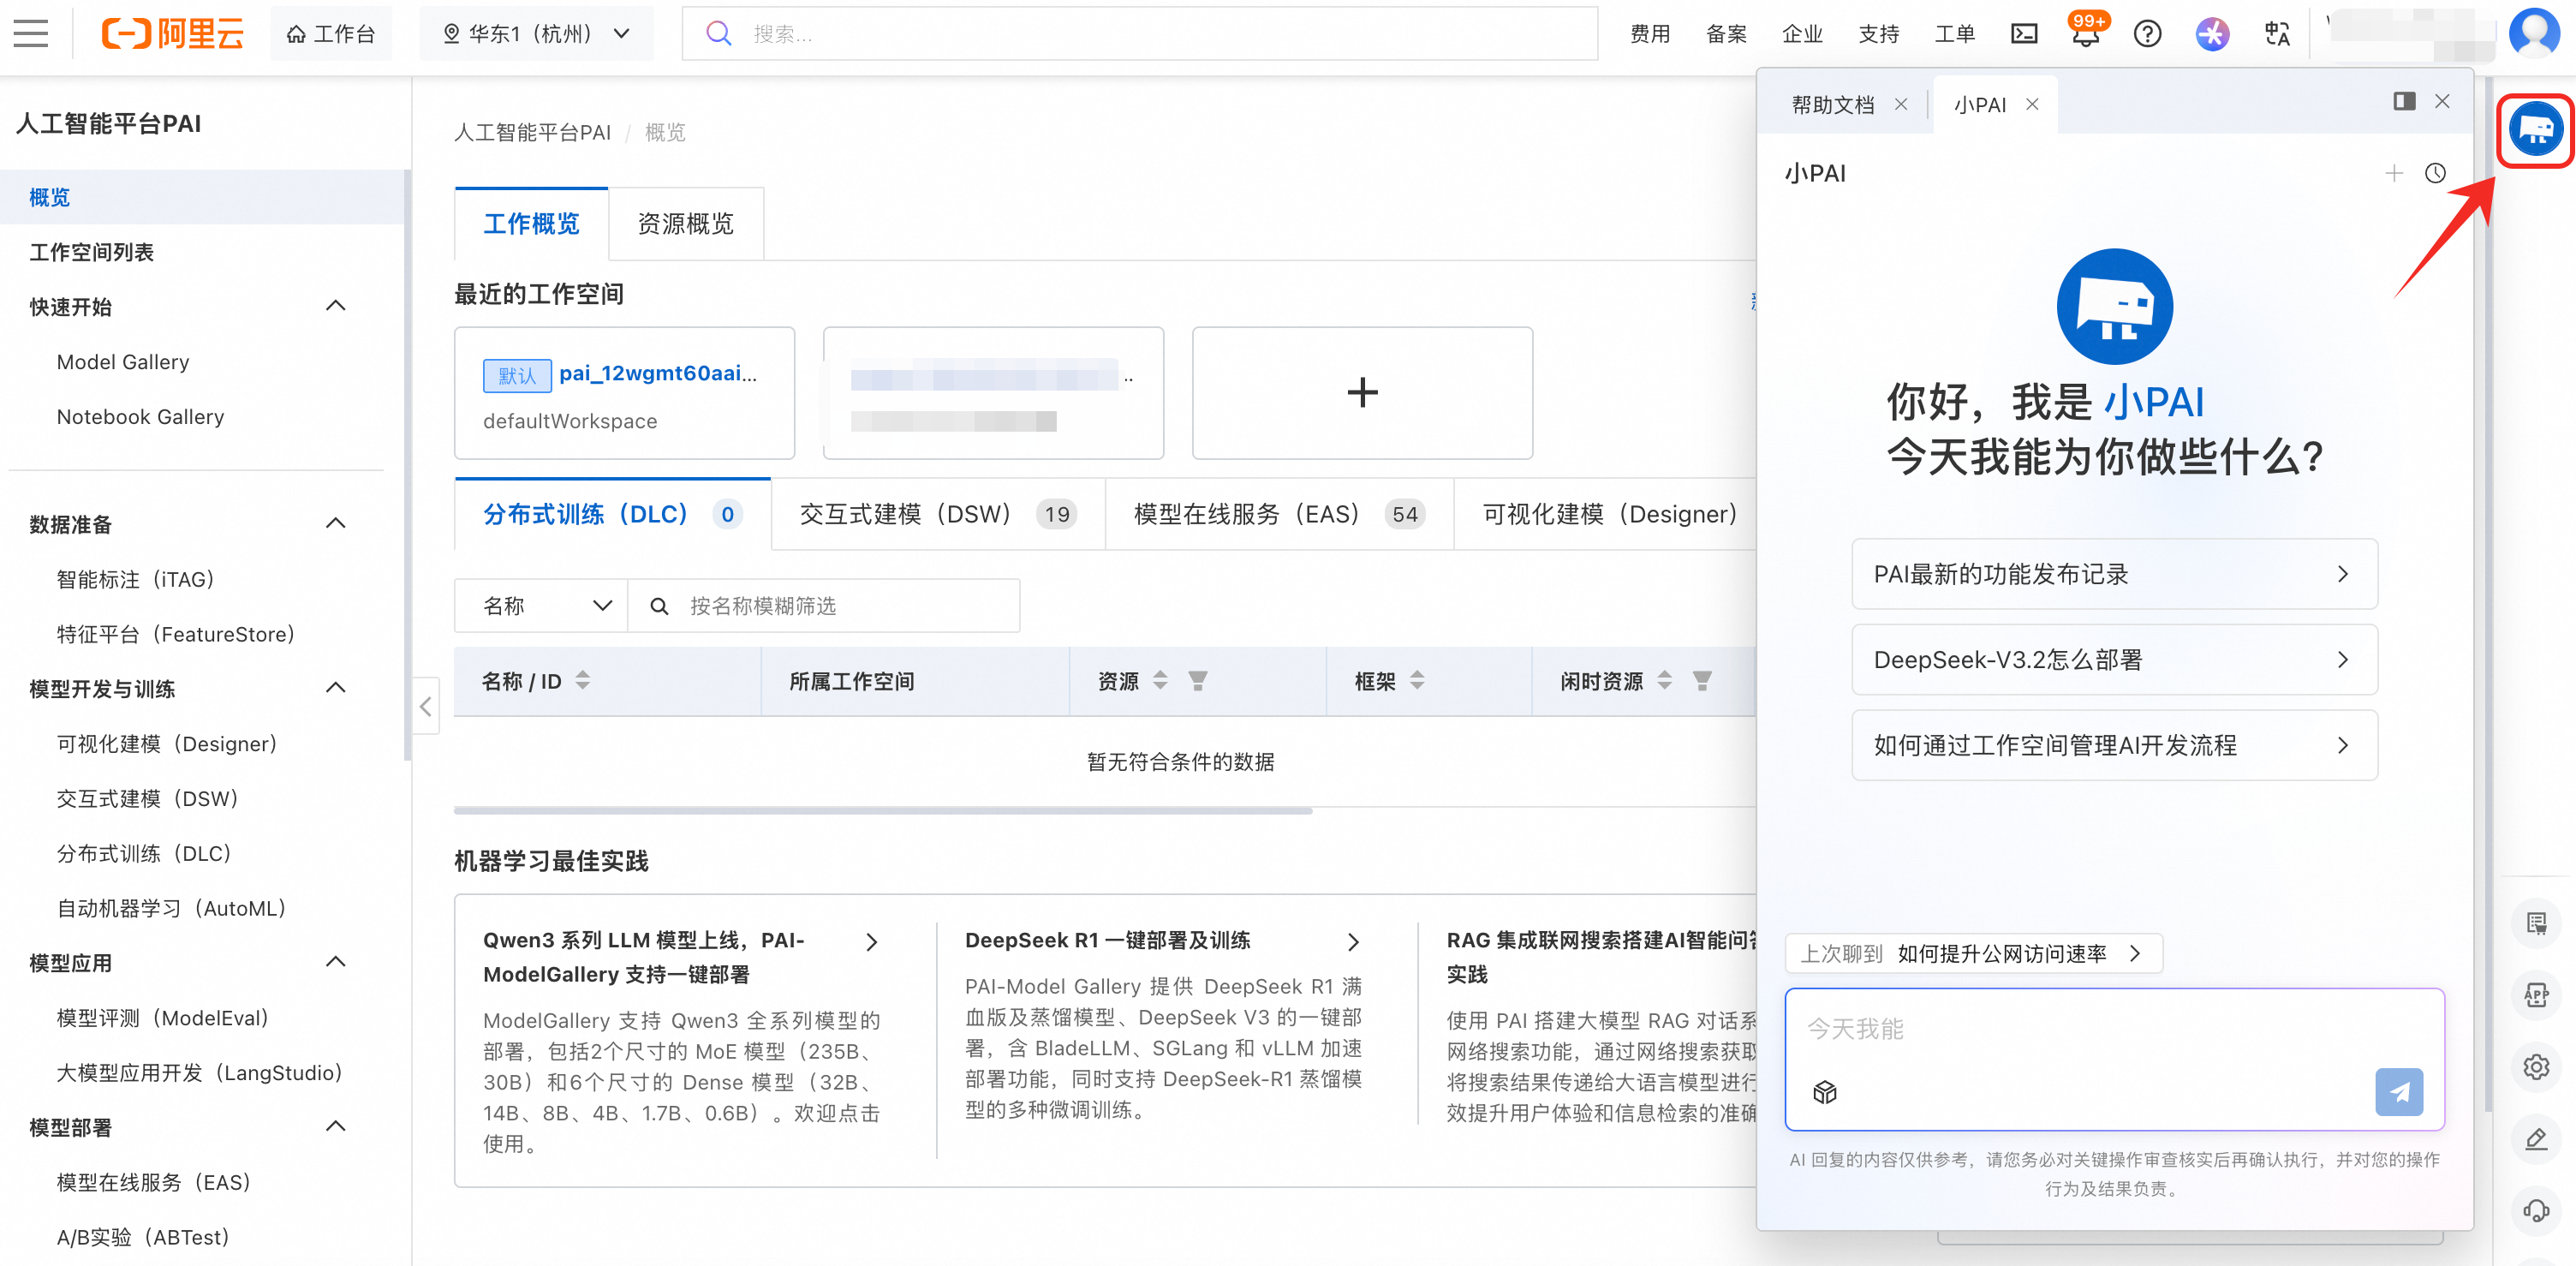
有問題先問小PAI
PAI智能助手(小PAI)提供PAI全鏈路產品的使用說明和操作指引,支援對DSW執行個體、DLC任務、EAS服務進行營運診斷,自動識別失敗原因並給出處理建議。
Q:Model Gallery的模型評測是開了深度思考嗎?
Model Gallery提供的模型和二次訓練後的模型,評測時使用Model Gallery預設部署配置。請根據模型介紹頁和預設部署配置判斷。
Q:如何部署Model Gallery訓練的模型
進入Model Gallery的任務管理,找到訓練任務並進入詳情頁,單擊右上方部署按鈕。部署後,模型會以線上服務方式運行。

Q:訓練任務失敗後,如何排查失敗原因?
訓練任務失敗的原因很多,例如資料集格式不符合要求。您可以按以下方式排查:
查看任務診斷:在PAI-Model Gallery > 任務管理 > 訓練任務中單擊指定任務,在任務詳情頁簽下將滑鼠移至上方在失敗上,系統顯示錯誤原因及解決辦法。

查看任務日誌:在任務管理 > 訓練任務中單擊指定任務,在任務日誌頁簽下查看錯誤資訊:

各錯誤資訊的解決方案如下:
錯誤類型
錯誤資訊
解決辦法
輸入/輸出錯誤相關
ValueError: output channel ${your OSS uri} must be directory
輸出路徑必須是檔案夾。請檢查當前路徑是否為檔案夾。
ValueError:train must be a file
輸入路徑必須是檔案。請檢查當前路徑是否為檔案。
FileNotFoundError
請檢查輸入路徑下是否存在符合要求的檔案。
JSONDecodeError
請檢查JSON檔案格式是否正確。
ValueError: Input data must be a json file or a jsonl file!
輸入檔案必須是JSON或JSONL檔案。請檢查檔案格式。
KeyError:${some key name}
該錯誤多見於JSON訓練集。請根據模型說明檢查訓練集檔案的key-value是否符合要求。
ValueError: Unrecognized model in /ml/input/data/model/.
PyTorch無法識別提供的模型檔案。
UnicodeDecoderError
請檢查輸入檔案編碼格式。
Input/output error
請確保輸入路徑可讀,輸出路徑可讀寫
NotADirectoryError: [Errno 20] Not a directory:
請檢查輸入和輸出路徑是否為檔案夾。
超參數配置相關
ERROR:torch.distributed.elastic.multiprocessing.api:failed (exitcode: -9) local_rank: 0 (pid: 51) of binary: /usr/bin/python(且沒有相關subprocess的日誌)
當前機型記憶體不足,載入模型時OOM(Out of Memory)。請選擇記憶體更大的機型。
torch.cuda.OutOfMemoryError: CUDA out of memory
當前機型顯存不足。請選擇顯存更大的GPU機型,或降低lora dim、batch size等超參數。
ValueError: No closing quotation
system prompt或其他參數中出現了單個
",導致演算法產生training command失敗。請刪除單個",或補全為成對引號。機型資源配置相關
Exception: Current loss scale already at minimum - cannot decrease scale anymore. Exiting run
該模型參數格式為BF16,建議使用Ampere或更新架構的GPU(如A10/A100)訓練。使用Ampere之前架構的GPU會將參數轉換為FP16格式。
RuntimeError: CUDA error: uncorrectable ECC error encountered
當前機型硬體錯誤。請更換機型,或切換到其他Region重試。
MemoryError: WARNING Insufficient free disk space
當前機型記憶體不足。請更換記憶體更大的機型。
使用者限制相關
failed to compose dlc job specs, resource limiting triggered, you are trying to use more GPU resources than the threshold
訓練任務最多同時運行2*GPU,超過會觸發資源限制。請等待運行中的任務完成後再啟動,或提交工單申請增加配額。
Q:如何線上調試已部署的模型?
模型部署成功後,在Model Gallery > 任務管理 > 部署任務中查看已部署服務。確認服務狀態正常後再調試。

在EAS頁面,單擊已部署服務操作列的線上調試。線上調試無需編寫用戶端代碼即可驗證模型介面。

配置線上調試請求參數。
在模型介紹頁查看對應部署方式的調用方法(從Model Gallery頁面單擊模型卡片進入)。例如,通過BladeLLM部署DeepSeek-R1-Distill-Qwen-7B後,向
/v1/chat/completions發送HTTP POST請求,請求樣本如下:

配置並發送請求。
在請求URL後追加
/v1/chat/completions,請求Body按上一步樣本填寫。
Q:線上調試時報錯“no healthy upstream”
線上調試時報錯,錯誤碼503,錯誤提示為“no healthy upstream”:

報錯原因:執行個體運行時CPU、記憶體或顯存被過度佔用,緩衝餘量不足。
解決方案:
公用資源建議在非高峰時段再調用,或更換資源規格和地區。
專屬資源(EAS資源群組)需為執行個體預留足夠的CPU、記憶體和顯存,建議至少保留20%空閑資源作為緩衝。
Q:模型訓練時報錯:SupportsDistributedTraining false, please set InstanceCount=1
報錯原因:當前訓練任務使用了多個執行個體(節點數大於1),但該模型不支援分布式訓練。
解決方案:將節點數設定為1。單節點訓練才能匹配該模型的訓練方式。

Q: 模型API調用報錯 404 - {'detail': 'Not Found'}
可能的原因:
模型服務不支援 API調用。Model Gallery部署的模型服務,有些只支援在服務詳情頁面通過 Web 應用程式 按鈕以網頁形式互動。該類型不對外提供 OpenAI 相容的 API 端點,不支援使用 OpenAI SDK 調用。比如
PAI-DistilQwen2.5-7B-Instruct。請求路徑不完整或錯誤。如對話介面,通常的路徑格式為
{domain}/api/predict/{service_name}/v1/chat/completions。
模型選擇FAQ
Q:PAI-DistilQwen2.5-7B-Instruct 與 DeepSeek-R1-Distill-Qwen-7B的區別?
PAI-DistilQwen2.5-7B-Instruct 和 DeepSeek-R1-Distill-Qwen-7B 均基於 Qwen2.5-7B 蒸餾訓練,但應用情境不同:
維度 | PAI-DistilQwen2.5-7B-Instruct | DeepSeek-R1-Distill-Qwen-7B |
基本模型 | Qwen2.5-7B-Instruct | Qwen2.5-7B + DeepSeek-R1 |
蒸餾方式 | 黑盒資料蒸餾 + 白盒 Logits 蒸餾 | 知識蒸餾(推理能力遷移) |
應用情境 | 通用指令遵循 | 數學與推理任務 |
特點 | 指令遵循能力相比原始模型有顯著提升。 | 針對數學類問題,建議在 prompt 中包含逐步推理的要求。 |
Q:Fun-CosyVoice 模型與舊版 CosyVoice 有何區別?
Fun-CosyVoice 3.0 是一個基於大型語言模型 (LLM) 的進階文本轉語音 (TTS) 系統,在內容一致性、說話人相似性和韻律自然性方面超越了其前身 (CosyVoice 2.0)。
Q:Qwen3 Embedding系列模型區別?
模型對比如下:
模型 | 模型權重 | 顯存佔用 | 最大嵌入維度 | 適用情境 |
Qwen3-Embedding-0.6B | 1.12 GiB | 2-4 GB | 1024 | 輕量檢索、記憶體敏感 |
Qwen3-Embedding-4B | 7.55 GiB | 10-14 GB | 2560 | 標準語義搜尋 |
Qwen3-Embedding-8B | 14.11 GiB | 18-24 GB | 4096 | 高精度、複雜語義 |
請根據使用情境,選擇合適的模型與GPU:
情境 | 推薦模型 | 推薦 GPU | 預算 |
個人開發/POC | 0.6B | RTX 3060 / 筆記本 | 低 |
中小企業 API | 4B | A10 (24G) | 中 |
企業級生產 | 8B | A100 40G/80G | 高 |
超大規模向量庫 | 0.6B 或 4B | A10 x 多執行個體 | 中 |
高精度語義搜尋 | 8B | H100 (80G) | 很高 |
Model Gallery支援一鍵部署Qwen3-Embedding系列模型,注意:
不指定
--max-model-len時,vLLM 預設讀模數型config.json的max_position_embeddings。該參數直接限制輸入文本的 Token 數上限,超限則截斷或報錯。Embedding 模型無自迴歸產生,但 vLLM 仍預分配全量 KV Cache,造成顯存浪費。建議根據實際業務長度顯式調小
--max-model-len,可顯著降低顯存佔用、提升並發,同時避免過度預分配導致的資源浪費。