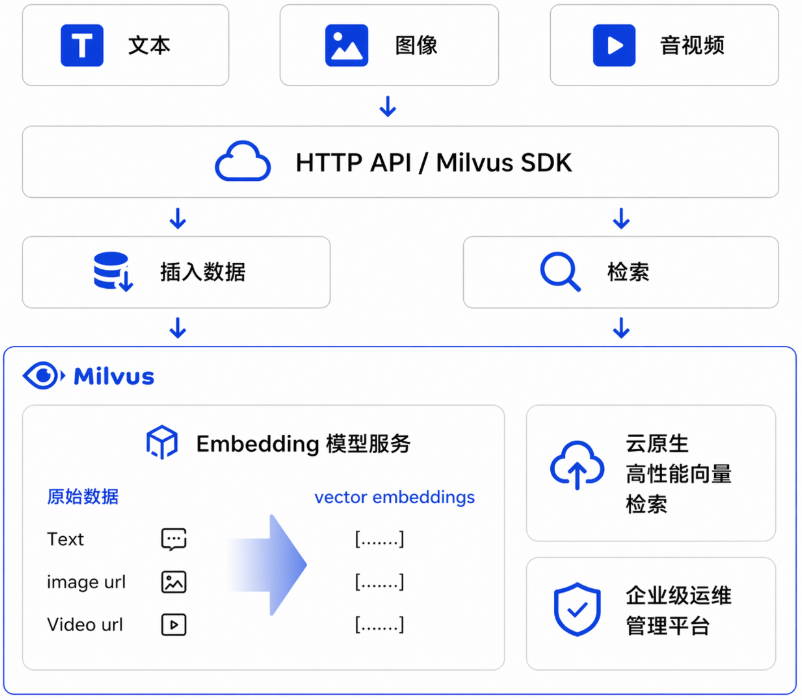
阿里雲 Milvus AI 中心是內建於 Milvus 的託管式模型服務能力。開通後,在資料寫入和檢索時可直接傳入原始文本或多模態資料(圖片、視頻),由系統自動完成向量產生,無需單獨部署 Embedding 推理服務。
功能概覽
功能 | 說明 |
控制台一站式管理 | 在控制台完成模型服務的查看、配置與調用樣本擷取,無需跳轉多個平台。 |
託管式模型能力 | 平台提供託管式模型推理服務,無需自建推理服務與營運基礎設施。 |
未經處理資料直接寫入和檢索 | 寫入、更新和查詢時直接傳入原始文本或多模態內容,系統自動完成向量化。 |
多模型靈活切換 | 提供多個向量化模型,可按業務情境在效果、時延和成本之間靈活選擇。 |
調用量與 Token 統計 | 按叢集和模型兩個維度統計 Token 用量與調用次數。 |
調用監控 | 支援查看請求成功率(Success Rate)與平均回應時間(Average RT)等運行指標。 |
除向量化外,AI 中心還統一提供重排序、文本產生、多模態理解、視頻編輯等模型能力,可直接用於語義檢索、RAG 知識庫、企業智能問答、內容推薦與多模態搜尋等情境。本文以向量化為例,介紹文本檢索與多模態檢索的完整接入流程。
使用步驟
查看可用的向量化模型
登入 Milvus 控制台,在左側導覽列選擇AI 中心,在模型服務頁簽下查看向量化分組,可擷取模型的輸入類型、輸出維度以及 API 樣本。
當前可選的向量化模型如下:
模型 | 支援的輸入 | 說明 |
| 文本 | 推薦使用的文本向量模型,預設維度 1024。 |
| 文本 | 多語言文本向量模型,支援自訂向量維度。 |
| 文本 | 通用文本向量模型。 |
| 文本 | 通用文本向量模型,即將下線,不建議在新業務中使用。 |
| 文本、圖片、視頻 | 推薦使用的多模態向量模型,預設維度 2560,可通過 |
| 文本、圖片、視頻 | 多模態向量模型。 |
AI 中心按地區獨立提供服務,切換地區後需在新地區重新查看和配置。
準備 Milvus 執行個體
向量化能力依賴 Milvus 2.6 版本執行個體。建立 2.6 版本執行個體後即可在 Collection 中直接聲明 Function 調用模型,無需單獨執行模型與執行個體的綁定操作。
如需從公網訪問執行個體,請在執行個體詳情頁的安全配置頁簽開啟公網訪問並配置公網訪問白名單。
查看用量與監控
進入AI 中心,單擊監控頁簽,可按按 Milvus 叢集或按模型兩種視角查看調用情況:
Token 用量 / 調用次數:按叢集和模型列出 Token 用量與調用次數明細。
Token 總量、文本輸入 Token 總量:所選範圍內的 Token 消耗匯總。
Success Rate:請求成功率。
Average RT:平均回應時間。
支援選擇叢集或模型、設定採樣間隔(interval),並按 1 小時、3 小時、6 小時、12 小時、1 天、7 天等快捷範圍或自訂時間視窗篩選。
案例一:文搜文語義檢索
情境說明
將一批原始文本寫入 Milvus,無需預先產生向量。查詢時直接輸入自然語言問題,Milvus 自動完成查詢向量化並返回語義最相關的結果。適用於知識庫問答、文檔搜尋、FAQ 檢索等情境。
操作步驟
建立 Collection,定義原始文字欄位
document和向量欄位dense。通過
Function綁定qwen3.7-text-embedding模型。插入測試文本資料,並調用
flush確保資料可檢索。使用自然語言問題發起檢索,返回最相關的文本片段。
插入資料後需調用 flush,否則緊接著執行檢索可能返回空結果。
範例程式碼
from pymilvus import MilvusClient, DataType, Function, FunctionType

client = MilvusClient(
    uri="http://c-xxxx.milvus.aliyuncs.com:19530",
    token='root:xxx',
)

# ========== 建立 Collection ==========
collection_name = 'demo1'
schema = client.create_schema()

schema.add_field("id", DataType.INT64, is_primary=True, auto_id=False)
schema.add_field("document", DataType.VARCHAR, max_length=9000)
schema.add_field("dense", DataType.FLOAT_VECTOR, dim=1024)
text_embedding_function = Function(
    name="dashscope_api_test123",
    function_type=FunctionType.TEXTEMBEDDING,
    input_field_names=["document"],
    output_field_names=["dense"],
    params={
        "provider": "aliyun_milvus",
        "model_name": "qwen3.7-text-embedding"
    }
)

schema.add_function(text_embedding_function)
index_params = client.prepare_index_params()

index_params.add_index(
    field_name="dense",
    index_type="AUTOINDEX",
    metric_type="COSINE"
)
client.drop_collection(collection_name)
client.create_collection(
    collection_name=collection_name,
    schema=schema,
    index_params=index_params
)

insert_data = []
record_id = 1

mock_texts = [
    "向量資料庫通過將文本轉換為高維向量來實現語義檢索,能夠理解查詢的真實意圖。",
    "深度學習模型可以從大量圖片資料中學習特徵表示,用於映像分類和目標檢測等任務。",
    "檢索增強產生通過召回相關文檔為大模型提供外部知識,減少幻覺並提升答案可靠性。",
    "在客服情境中,語義搜尋可以快速定位歷史工單,提高首次響應效率和問題解決率。",
    "相似性搜尋常用餘弦距離衡量向量方向接近程度,適合文本語義匹配任務。",
    "資料清洗是向量化前的重要步驟,去噪和統一格式能顯著提升召回品質。",
    "embedding 維度並非越高越好,需要在效果、延遲和儲存成本之間做平衡。",
    "通過分塊策略將長文檔切分為小段,可以提高檢索命中率並減少上下文冗餘。",
    "為每條知識添加來源欄位有助於結果可解釋性,方便在前端展示引用證據。",
    "多語言檢索可藉助統一向量空間實現跨語言匹配,提升國際化系統體驗。",
    "索引參數如 ef 和 M 會影響 HNSW 的召回率與查詢效能,需要結合業務調優。",
    "在上線前進行離線評測可以量化不同模型和參數組合的檢索品質差異。",
    "向量庫中的中繼資料過濾能夠與語義召回結合,實現更精準的範圍限定搜尋。",
    "對於高頻問題,可將檢索結果做短時緩衝以降低後端計算壓力和回應時間。",
    "語義檢索鏈路應記錄查詢日誌,便於後續分析零結果查詢並持續最佳化知識庫。",
    "當知識內容更新頻繁時,增量索引策略可以減少全量重建帶來的資源消耗。",
    "在問答系統中加入重排序模型可以提升前幾條結果的相關性和可讀性。",
    "為敏感性資料建立存取控制策略是企業級向量檢索系統的基礎安全要求。",
    "合理設定 topK 能在覆蓋率與雜訊之間取得平衡,避免返回過多低相關結果。",
    "將使用者反饋迴流到訓練與評估流程,可以持續改進檢索與問答整體效果。",
]

for text in mock_texts:
    insert_data.append({
        "id": record_id,
        "document": text,
    })
    record_id += 1

BATCH_SIZE = 30
print(f"準備插入 {len(insert_data)} 條資料,batch_size={BATCH_SIZE}...")
for batch_start in range(0, len(insert_data), BATCH_SIZE):
    batch = insert_data[batch_start:batch_start + BATCH_SIZE]
    client.insert(collection_name, batch)
    print(f"  已插入 {min(batch_start + BATCH_SIZE, len(insert_data))}/{len(insert_data)} 條")
client.flush(collection_name)
print("資料插入完成!\n")

# ========== 測試1:文搜文(通過 dense 欄位做純文字語義檢索) ==========
print("=" * 60)
print("測試1:文搜文 - 查詢與向量資料庫相關的內容")
print("=" * 60)
results = client.search(
    collection_name=collection_name,
    data=['什麼是語義檢索?向量資料庫如何工作?'],
    anns_field='dense',
    limit=3,
    output_fields=['document'],
)
for hits in results:
    for hit in hits:
        print(f"  id={hit['id']}, distance={hit['distance']:.4f}, document={hit['entity']['document'][:50]}")
運行結果
準備插入 20 條資料,batch_size=30...
  已插入 20/20 條
資料插入完成!

============================================================
測試1:文搜文 - 查詢與向量資料庫相關的內容
============================================================
  id=1, distance=0.8668, document=向量資料庫通過將文本轉換為高維向量來實現語義檢索,能夠理解查詢的真實意圖。
  id=13, distance=0.5989, document=向量庫中的中繼資料過濾能夠與語義召回結合,實現更精準的範圍限定搜尋。
  id=15, distance=0.5414, document=語義檢索鏈路應記錄查詢日誌,便於後續分析零結果查詢並持續最佳化知識庫。
檢索結果按語義相關性排序,與查詢意圖最接近的文本排在最前。實際的相似性分數會隨模型版本和資料內容變化。
案例二:多模態檢索
情境說明
在零售、電商和內容平台情境中,檢索對象除文本外還包括圖片和視頻。AI 中心的多模態向量模型支援將文本與視覺內容納入統一的向量化與檢索流程,實現文搜圖/視頻、圖搜圖/視頻等跨模態檢索能力。
本案例在同一個 Collection 中定義兩個向量欄位:dense 由文本模型產生,用於文本語義檢索;dense_mm 由多模態模型產生,用於跨模態檢索。
操作步驟
將圖片或視頻上傳至 OSS 等Object Storage Service,產生可被模型服務訪問的 URL。
建立 Collection,定義文字欄位
document、多媒體地址欄位url、文本向量欄位dense和多模態向量欄位dense_mm。分別為文本和多媒體欄位綁定
qwen3.7-text-embedding與qwen3-vl-embedding。插入測試素材及對應文本描述。
執行文搜文、文搜圖/視頻、圖搜圖/視頻等檢索驗證。
為多媒體欄位綁定多模態模型時,params 中必須設定 is_multimodal 為 true,否則建立 Collection 時會因模型無法解析輸入而報錯。dim 需與向量欄位聲明的維度一致。
多媒體欄位也可以直接寫入純文字,多模態模型會為其產生同一向量空間中的文本向量,從而支援圖文混合檢索。
範例程式碼
from pymilvus import MilvusClient, DataType, Function, FunctionType

client = MilvusClient(
    uri="http://c-xxxx.milvus.aliyuncs.com:19530",
    token='root:xxx',
)

# 替換為業務自有的圖片或視頻地址,需可被模型服務訪問
IMAGE_URL = "https://example.com/your-image.jpg"
VIDEO_URL = "https://example.com/your-video.mp4"

# ========== 建立 Collection ==========
collection_name = 'demo11'
schema = client.create_schema()

schema.add_field("id", DataType.INT64, is_primary=True, auto_id=False)
schema.add_field("document", DataType.VARCHAR, max_length=9000)
schema.add_field("url", DataType.VARCHAR, max_length=9000)
schema.add_field("dense", DataType.FLOAT_VECTOR, dim=1024)
schema.add_field("dense_mm", DataType.FLOAT_VECTOR, dim=1024)

text_embedding_function = Function(
    name="dashscope_api_test123",
    function_type=FunctionType.TEXTEMBEDDING,
    input_field_names=["document"],
    output_field_names=["dense"],
    params={
        "provider": "aliyun_milvus",
        "model_name": "qwen3.7-text-embedding"
    }
)
mm_embedding_function = Function(
    name="dashscope_api_mm123",
    function_type=FunctionType.TEXTEMBEDDING,
    input_field_names=["url"],
    output_field_names=["dense_mm"],
    params={
        "provider": "aliyun_milvus",
        "model_name": "qwen3-vl-embedding",
        "dim": "1024",
        "is_multimodal": "true"
    }
)

schema.add_function(text_embedding_function)
schema.add_function(mm_embedding_function)
index_params = client.prepare_index_params()

index_params.add_index(
    field_name="dense",
    index_type="AUTOINDEX",
    metric_type="COSINE"
)
index_params.add_index(
    field_name="dense_mm",
    index_type="AUTOINDEX",
    metric_type="COSINE"
)
client.drop_collection(collection_name)
client.create_collection(
    collection_name=collection_name,
    schema=schema,
    index_params=index_params
)

# ========== 插入資料:多媒體素材傳 URL,純文字直接傳文本 ==========
insert_data = [
    {"id": 1, "document": "一張服裝類商品圖片,展示人物穿著的上衣外觀細節。", "url": IMAGE_URL},
    {"id": 2, "document": "一段服裝展示短視頻,鏡頭展現衣物的動態穿著效果。", "url": VIDEO_URL},
    {"id": 3,
     "document": "向量資料庫通過將文本轉換為高維向量來實現語義檢索,能夠理解查詢的真實意圖。",
     "url": "向量資料庫通過將文本轉換為高維向量來實現語義檢索,能夠理解查詢的真實意圖。"},
    {"id": 4,
     "document": "深度學習模型可以從大量圖片資料中學習特徵表示,用於映像分類和目標檢測等任務。",
     "url": "深度學習模型可以從大量圖片資料中學習特徵表示,用於映像分類和目標檢測等任務。"},
    {"id": 5,
     "document": "服裝電商平台通常需要按款式、顏色和材質檢索商品主圖。",
     "url": "服裝電商平台通常需要按款式、顏色和材質檢索商品主圖。"},
]

print(f"準備插入 {len(insert_data)} 條資料...")
client.insert(collection_name, insert_data)
client.flush(collection_name)
print("資料插入完成!\n")

# ========== 測試1:文搜文(通過 dense 欄位做純文字語義檢索) ==========
print("=" * 60)
print("測試1:文搜文 - 查詢服裝商品相關的內容")
print("=" * 60)
results = client.search(
    collection_name=collection_name,
    data=['服裝商品的外觀展示'],
    anns_field='dense',
    limit=3,
    output_fields=['document', 'url'],
)
for hits in results:
    for hit in hits:
        print(f"  id={hit['id']}, distance={hit['distance']:.4f}, document={hit['entity']['document'][:40]}")

# ========== 測試2:文搜圖 / 視頻(用文字查詢匹配多媒體內容,過濾出 URL 記錄) ==========
print("\n" + "=" * 60)
print("測試2:文搜圖 / 視頻 - 用文本描述搜尋服裝相關的素材")
print("=" * 60)
results = client.search(
    collection_name=collection_name,
    data=['一件衣服的穿著展示'],
    anns_field='dense_mm',
    limit=3,
    filter='url like "http%"',
    output_fields=['document', 'url'],
)
for hits in results:
    for hit in hits:
        is_media = "媒體" if str(hit['entity']['url']).startswith('http') else "文本"
        print(f"  id={hit['id']}, distance={hit['distance']:.4f}, [{is_media}] document={hit['entity']['document'][:40]}")

# ========== 測試3:圖搜圖 / 視頻(用圖片地址查詢多媒體內容) ==========
print("\n" + "=" * 60)
print("測試3:圖搜圖 / 視頻 - 用圖片地址搜尋相似素材")
print("=" * 60)
results = client.search(
    collection_name=collection_name,
    data=[IMAGE_URL],
    anns_field='dense_mm',
    limit=3,
    output_fields=['document', 'url'],
)
for hits in results:
    for hit in hits:
        is_media = "媒體" if str(hit['entity']['url']).startswith('http') else "文本"
        print(f"  id={hit['id']}, distance={hit['distance']:.4f}, [{is_media}] document={hit['entity']['document'][:40]}")
運行結果
準備插入 5 條資料...
資料插入完成!

============================================================
測試1:文搜文 - 查詢服裝商品相關的內容
============================================================
  id=1, distance=0.6412, document=一張服裝類商品圖片,展示人物穿著的上衣外觀細節。
  id=5, distance=0.5901, document=服裝電商平台通常需要按款式、顏色和材質檢索商品主圖。
  id=2, distance=0.5689, document=一段服裝展示短視頻,鏡頭展現衣物的動態穿著效果。

============================================================
測試2:文搜圖 / 視頻 - 用文本描述搜尋服裝相關的素材
============================================================
  id=2, distance=0.1861, [媒體] document=一段服裝展示短視頻,鏡頭展現衣物的動態穿著效果。
  id=1, distance=0.1153, [媒體] document=一張服裝類商品圖片,展示人物穿著的上衣外觀細節。

============================================================
測試3:圖搜圖 / 視頻 - 用圖片地址搜尋相似素材
============================================================
  id=1, distance=1.0000, [媒體] document=一張服裝類商品圖片,展示人物穿著的上衣外觀細節。
  id=2, distance=0.0732, [媒體] document=一段服裝展示短視頻,鏡頭展現衣物的動態穿著效果。
  id=3, distance=0.0294, [文本] document=向量資料庫通過將文本轉換為高維向量來實現語義檢索,能夠理解查詢的真實意圖。
測試3 中查詢圖片與庫中同一張圖片的相似性為 1.0000,說明圖搜圖鏈路生效。跨模態檢索(文字查詢多媒體)的相似性量級通常低於同模態檢索,屬於正常現象,業務側應按同一檢索情境內的相對排序來判斷效果,而非跨情境比較絕對分值。