JOIN是分布式系統中常見的操作,同時也是一個耗時、耗資源的操作,因為其涉及到的Shuffle操作尤其在海量資料情境下,會耗費較多的資源和時間。針對Shuffle操作,MaxCompute可以利用JOIN本身的等值串連屬性進行最佳化。
最佳化思路
一個典型的包含JOIN的SQL語句如下:
SELECT * FROM (table1) A JOIN (table2) B ON A.a = B.b;在小資料量情境下,Dynamic Filter 需配合 MergeJoin 方可生效。為確保正確執行,建議設定以下Flag:
set odps.optimizer.enable.conditional.mapjoin=false;set odps.optimizer.cbo.rule.filter.black=hj;
基於JOIN等值串連的特性,MaxCompute可以通過表A的資料產生一個過濾器,在Shuffle或JOIN之前提前過濾表B的資料,甚至可以將過濾器下推到底層儲存,在源頭過濾資料。這種在作業運行時動態產生過濾器的功能稱為動態過濾器DF(Dynamic Filter)。
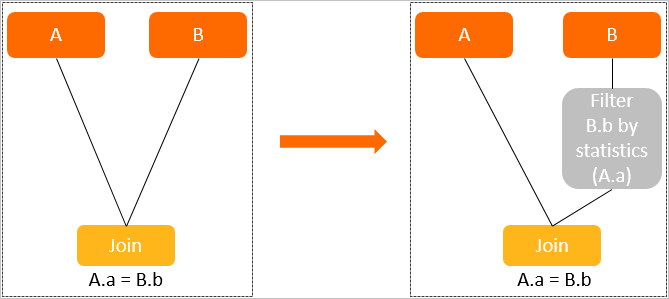
上述SQL語句在開啟動態過濾器前後的執行計畫示意圖如下。
應用情境
動態過濾器功能是利用等值JOIN的特性,基於運行時動態產生過濾器,以便在Shuffle或JOIN之前提前過濾資料,實現加速查詢運行。該功能適用於維度資料表和事實表執行JOIN的情境。
動態範圍過濾器或布隆過濾器(Dynamic Range|Bloom Filter)
從上圖可知,在原始的執行計畫中不存在過濾器,過濾器是由系統根據JOIN的特性自動產生的,它的作用就是判斷B表中的元素是否存在於A表產生的集合中,如不存在,則過濾掉。
從空間和時間效率上看,Bloom Filter正是上述功能的有效選擇。但在實現中,動態過濾器不僅可以使用Bloom Filter,還可以使用基於[min, max]值的Range Filter和IN predicate等方法來過濾資料。
動態過濾器是一個典型的生產者和消費者模式,示意圖如下。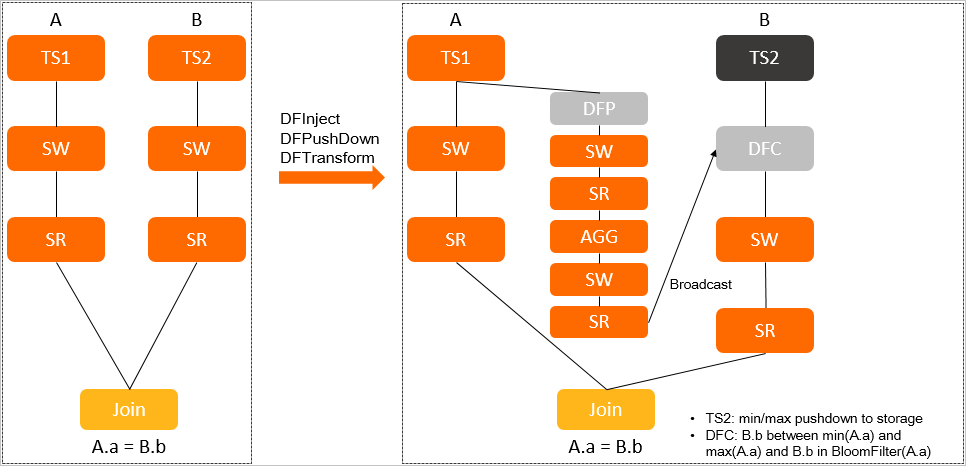
DFP(Dynamic Filter Producer)運算元:動態過濾器的生產者(Producer),利用小表側的資料產生Bloom Filter及擷取JOIN Key對應的
min、max值(Range Filter),然後發送至DFC。DFC(Dynamic Filter Consumer)運算元:動態過濾器的消費者(Consumer),利用Bloom Filter和Range Filter過濾大表側的資料。Range Filter會儘可能將過濾條件下推到底層儲存,以便從源頭過濾資料。
對於不同類型的JOIN語義,JOIN對象可擔任的角色不同:
A JOIN B:A或B都能作為生產者、消費者。
A LEFT JOIN B:A只能作為生產者,B只能作為消費者。
A RIGHT JOIN B:A只能作為消費者,B只能作為生產者。
A FULL OUTER JOIN B:無法使用動態過濾器功能。
動態過濾器的使用方法請參見動態過濾器的使用方法。
動態分區裁剪(Dynamic Partition Pruning)
上述Bloom Filter或Range Filter的例子是基於非分區表的最佳化,即JOIN Key是非分區列。當JOIN Key為分區列時,動態範圍過濾器或布隆過濾器(Dynamic Range|Bloom Filter)仍然可用,但MaxCompute會讀取完整個分區的資料後再過濾資料,讀取分區資料的過程可以進一步最佳化。即在讀取資料前,將無用的分區裁剪掉,即動態分區裁剪DPP(Dynamic Partition Pruning)功能。
例如包含JOIN的SQL語句如下:
-- A為非分區表,表中a列的值為20200701。
-- B為分區表,表中ds列的值包含3個分區20200701、20200702、20200703。
SELECT * FROM (table1) A JOIN (table2) B ON A.a= B.ds;
開啟動態分區裁剪功能後,最佳化器會根據表是否是分區表來決定是否採用動態分區裁剪功能。動態分區裁剪功能生效後,MaxCompute會採集小表側資料產生Bloom Filter,然後過濾大表側的分區列表,再把需要讀取的分區列表彙總,裁剪掉不需要掃描的分區。如果一個運行進程所有待讀的分區都被裁剪了,則該進程不被調度。
在上述樣本中,由於A表中的a列值只有20200701,因而開啟動態分區裁剪功能後,B表中的20200702和20200703分區會被裁剪掉,既節省了資源,也降低了作業運行時間長度。
動態分區裁剪功能的使用方法請參見動態分區裁剪的使用方法。
動態過濾器的使用方法
MaxCompute提供了如下開啟動態過濾器的方式:
方式一:在Session層級通過開關強制開啟動態過濾器,與SQL語句一起提交執行。
set odps.optimizer.force.dynamic.filter=true;說明該屬性也支援在Project層級設定,但推薦您在Session層級設定。由於Project層級開啟後,對所有JOIN作業都會啟用動態過濾器,當JOIN無法過濾資料時,處理效率反而更低。
使用該方式時,對所有能開啟動態過濾器的JOIN,都插入動態過濾器。
方式二:在Session層級通過開關智能開啟動態過濾器。
set odps.optimizer.enable.dynamic.filter=true;使用該方式時,最佳化器會智能地估計插入動態過濾器是否有足夠的資源或時間獲益,如果有收益則插入動態過濾器,否則不會插入。
說明該方式依賴中繼資料統計,例如ndv,更多中繼資料統計資訊,請參見最佳化器資訊收集。因為中繼資料統計是最佳化器的估算結果,可能不準確,因此會存在無法如預期地插入動態過濾器。
方式三:在SQL語句中通過HINT方式開啟動態過濾器。
HINT格式為
/*+dynamicfilter(Producer, Consumer1[, Consumer2,...])*/,允許一個生產者過濾多個消費者。命令樣本如下:select /*+dynamicfilter(A, B)*/ * from table1 A join table2 B on A.a= B.b;
動態分區裁剪的使用方法
在Session層級通過開關開啟動態分區裁剪功能,與SQL語句一起提交執行。
set odps.optimizer.dynamic.filter.dpp.enable=true;該屬性也支援在Project層級設定,但推薦您在Session層級設定。由於Project層級開啟後,對所有JOIN作業中涉及到的分區表都會啟用動態分區裁剪功能,當JOIN無法過濾資料時,處理效率反而更低。
驗證方法
如果您已按照動態過濾器的使用方法或動態分區裁剪的使用方法完成配置,可根據如下方法判斷其是否生效:
動態過濾器生效驗證
運行SQL作業後,查看作業的Logview資訊。如果Logview中出現類似DynamicFilterConsumer1的運算元,說明動態過濾器已生效。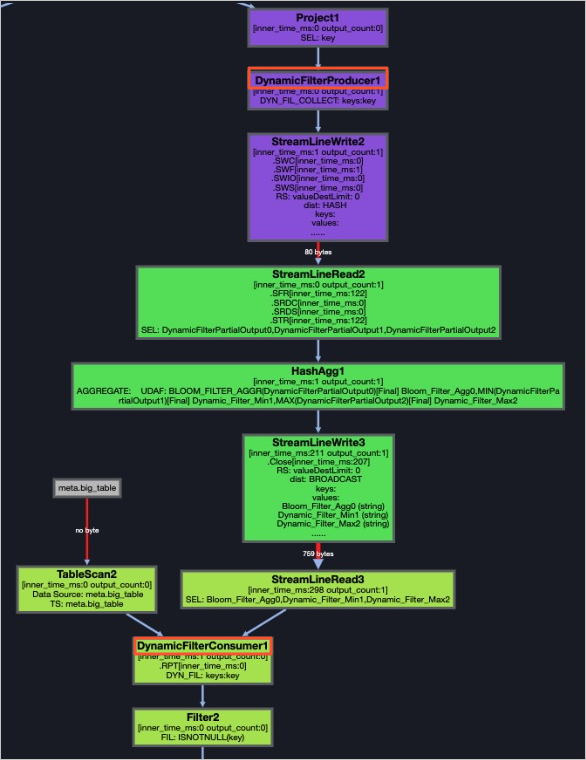
動態分區裁剪生效驗證
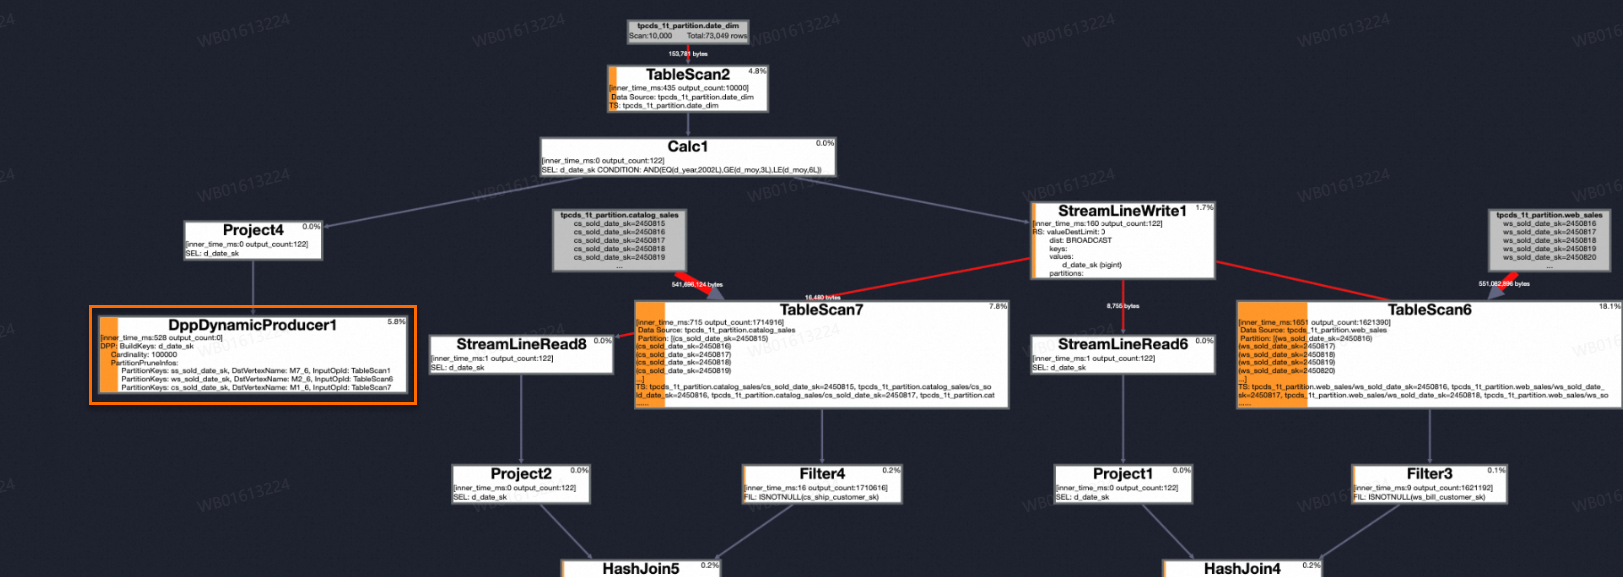
運行SQL作業後,查看作業的Logview資訊。如果Logview中出現類似DppDynamicProducer的運算元,其中包含PartitionPruneInfos,說明動態分區裁剪已生效。