布隆過濾器(Bloomfilter,簡稱BF)是一種高效的機率型資料結構,MaxCompute支援使用Bloomfilter index處理大規模資料點查情境,減少查詢過程中不必要的資料掃描,從而提高整體的查詢效率和效能。本文為您介紹Bloomfilter index的使用說明及樣本。
背景資訊
大規模點查是一種常見的數倉使用情境,通常會通過指定不定列的值對大量資料進行檢索,得到條件匹配的結果。在巨量資料情境下,結果資料可能分散在海量的檔案中,因此高效能的大規模點查需要極強的檢索能力。
MaxCompute是按照表或分區讀取資料,儲存層謂詞下推能力會根據表或分區下檔案的本地中繼資料資訊(參考ANALYZE)過濾資料,如果資料分散,則根據本地中繼資料資訊過濾資料(例如基於某列的MIN或MAX值進行過濾)的效果就比較有限。
如果查詢的列是固定的,可以使用聚簇表,並將Clustering Key作為過濾條件,這樣可以快速排除掉不需要讀取的分桶,在分桶內也可以過濾掉不需要讀取的資料,加快查詢速度。如果在條件欄位上彙總或者和其他表進行關聯等操作,可以利用聚簇附帶的Shuffle Removal能力,進一步發揮聚簇表優勢,但是聚簇表在以下幾方面仍有不足:
對於Hash聚簇表,只有當查詢條件包含了所有的Clustering Key之後才能進行資料過濾;對於Range聚簇表,只有當查詢條件中包含了Clustering Key的首碼過濾條件,並且按照Clustering Key的順序從左至右進行匹配時,才能有較好的過濾效果,如果不包含首碼過濾條件則效果不佳。
如果查詢條件不包含Clustering Key,則沒有過濾效果,因而對於查詢無固定條件的表來說,聚簇表可能無效。
資料寫入時需要按照指定的欄位進行Shuffle,會導致成本增加,如果遇到個別傾斜的Key,會導致任務長尾。
因此MaxCompute引入布隆過濾器索引(Bloomfilter index)應對大規模資料點查的情境。
前提條件
已建立MaxCompute專案。具體操作請參見建立MaxCompute專案。
專案已支援Schema Evolution操作。若您的專案未支援Schema Evolution操作,需要在專案層級設定
setproject odps.schema.evolution.enable=true;,以確保後續操作成功執行。否則會出現類似於Failed to run ddltask - Schema evolution DDLs is not enabled in project:default的報錯。
功能介紹
點查本質上是檢索某一個元素是否存在於一個集合中,而Bloomfilter可以用極高的效率實現該目標,因而在資料庫以及資料湖技術中都引入了Bloomfilter index,以便支援更細粒度的資料或檔案裁剪。
不同於資料庫中的索引(如BTree、RTree等)用來具體定位到某一行記錄,巨量資料下基於索引構建、維護代價的考慮,更多的是引入更輕量級的索引,而空間效率和查詢效率都非常高的Bloomfilter很適合在點查情境進行檔案的裁剪,因此MaxCompute中也引入了該索引。
相對聚簇表,Bloomfilter index的優勢如下:
高效。能以極小的代價過濾無效資料。
擴充性高。可以對錶的一列或者多列建立BF索引,並且可以和聚簇索引配合使用,即可以對非Clustering Key建立BF索引。
在高基數、資料分布緊湊的情境下有很好的過濾效果。
Bloomfilter index的優缺點
優點
效率高,插入和查詢操作的資源消耗都比普通索引低。
節省空間的,採用位元組,232=4294967296,可以看到42億長度的位元組只需佔用512 MB的記憶體空間。
說明位元組佔用的記憶體空間計算方式:
4294967296/8/1024/1024=512 MB。
缺點
有一定誤判率,可能會把不屬於該集合的元素誤判為存在於該集合,但是對大多數情境而言,消耗一點資源讀取無資料的檔案並不影響整體效率,且結果不影響最終的業務準確性。
Bloomfilter index適用情境
以表中的一列或多列作為條件進行點查過濾,則在有明顯過濾效果的查詢列上構建Bloomfilter index。
對聚簇表Clustering Key之外的欄位進行點查過濾,則在查詢列上構建Bloomfilter index。
聚簇表的Clustering Key、Sorted Key、Zorder函數排序後,在插入的資料列上再構建Bloomfilter index,可以獲得進一步的過濾效果。
Bloomfilter index使用限制
只適合等值判斷(包括
=、in),不支援>、>=、<、<=等範圍查詢及IS NULL、IS NOT NULL查詢。過濾效果的好壞依賴於資料分布,如果資料分布比較離散,即使使用Bloomfilter index,也可能無法有效地過濾資料。
不支援在DECIMAL、INTERVAL_DAY_TIME、INTERVAL_YEAR_MONTH,或複雜類型STRUCT、MAP、ARRAY、JSON上建立Bloomfilter index。
費用說明
索引構建後會佔用儲存空間,並且是由儲存在Pangu上的儲存計量進行統計,因此這部分計量按普通儲存收費。
索引的構建和使用會觸發額外的計算任務,一次查詢首先基於索引檔案計算查詢所需資料所在的檔案資訊,然後基於索引計算結果,進一步在查詢執行計畫階段過濾減少輸入資料量,並最終計算得到結果。索引計算和查詢都會產生計算費用。
使用索引,可以讓預付費客戶的作業運行得更快,同時,構建和運行索引計算的資源也是基於使用者的預付費資源,所以商業化不會對預付費作業的費用產生影響。
SQL操作觸發的索引相關任務說明如下:
SQL操作
觸發任務
索引相關任務的輸入資料量
計費情況
CREATE
DDL操作不會觸發索引構建任務。
無
不收費
REBUILD
索引構建。
已有索引:執行REBUILD操作會觸發索引重建。
無現有索引:執行REBUILD操作會觸發索引建立。
由於重建索引時,索引列和其他列同時進行讀寫操作,所以輸入資料量為重建索引查詢條件過濾後的全量資料。
索引計費方式:
SQL後付費單價*複雜度1*索引相關任務輸入資料量。SQL查詢計費方式:採用正常SQL後付費邏輯。
INSERT
對新插入的資料構建索引。
SELECT部分的查詢。
SELECT查詢的表中,帶有索引的列的資料量。
SELECT
使用索引計算的查詢任務,輸出下一步SELECT部分用於過濾資料的資訊。
基於已構建的索引執行SELECT查詢。
索引檔案的資料量。
使用說明
產生Bloomfilter index、使用Bloomfilter index、查看Bloomfilter index、刪除Bloomfilter index及更改Bloomfilter index屬性的方法如下:
產生Bloomfilter index
建立Bloomfilter index
文法如下:
CREATE BLOOMFILTER INDEX <index_name>
ON TABLE <table_name>
FOR COLUMNS(<column_name>)
IDXPROPERTIES('numitems'='xxx', 'fpp' = 'xx')
[COMMENT 'idxcomment']
;
參數說明如下:
參數 | 描述 |
index_name | 指定的索引名稱。 |
table_name | 索引所在的表名。 |
column_name | 要建立索引的列名。 |
numitems | Bloomfilter中儲存的元素數量的預估值,用於指定Bloomfilter的容量大小,以便在建立時分配足夠的記憶體空間來儲存預期數量的元素。該設定會影響Bloomfilter中使用的總位元,對過濾品質很重要。
該值必須大於0,您可根據構建索引列的非重複值數量進行預估,最大不能超過1000萬。 |
fpp | 誤判率。取值範圍為 |
目前僅支援一次對錶中的一個列建立Bloomfilter index,您可以為表的多個列分別建立Bloomfilter index。
彙總Bloomfilter index
對於增量資料不需要任何額外操作,執行資料的插入語句即可彙總Bloomfilter index。
文法如下:
INSERT OVERWRITE TABLE <table_name> [PARTITION <partition_spec>]
SELECT ......
參數說明如下:
table_name:索引所在的表名。
pt_spec:需要插入資料的分區資訊,不允許使用函數等運算式,只能是常量。格式為
(partition_col1 = partition_col_value1, partition_col2 = partition_col_value2, ...)。
在構建了Bloomfilter index的表中插入新資料,會增量產生資料檔案的本地Bloomfilter索引資料,支援儲存層謂詞下推,然後啟動BloomfilterAutoMergeTask自動彙總成新的Bloomfilter index索引檔案,支援在planning階段進行過濾,更準確地啟動任務所需資源。此時Logview中Json Summary出現如下關鍵字則說明Bloomfilter index彙總成功: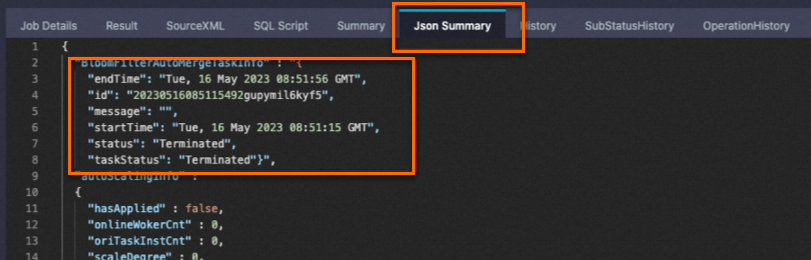
此時,您可通過Logview中的SubStatusHistory查看Bloomfilter index彙總所耗費的時間:
無論Bloomfilter index彙總任務成功與否,寫入資料的任務都會正常完成。
Bloomfilter index因為系統原因彙總失敗,會導致新增資料無法在planning階段過濾資料,新增資料的本地Bloomfilter索引資料仍然能夠支援儲存層謂詞下推進行過濾。您可以通過執行計畫判斷是否利用到了Bloomfilter index,如果沒有,可以對查詢時索引不生效的分區索引進行REBUILD。
動態分區暫時不支援自動Merge,需要在資料寫入完成後,手動對更新的分區進行REBUILD。
如果上圖中自動Merge任務狀態返回顯示執行失敗,則需要顯式執行如下Merge命令,但注意一次只能對一個分區索引進行REBUILD:
ALTERTABLE <table_name> [PARTITION <partition_spec>] REBUILD BLOOMFILTER INDEX;
使用Bloomfilter index
在查詢前執行如下語句,啟用布隆過濾器索引功能:
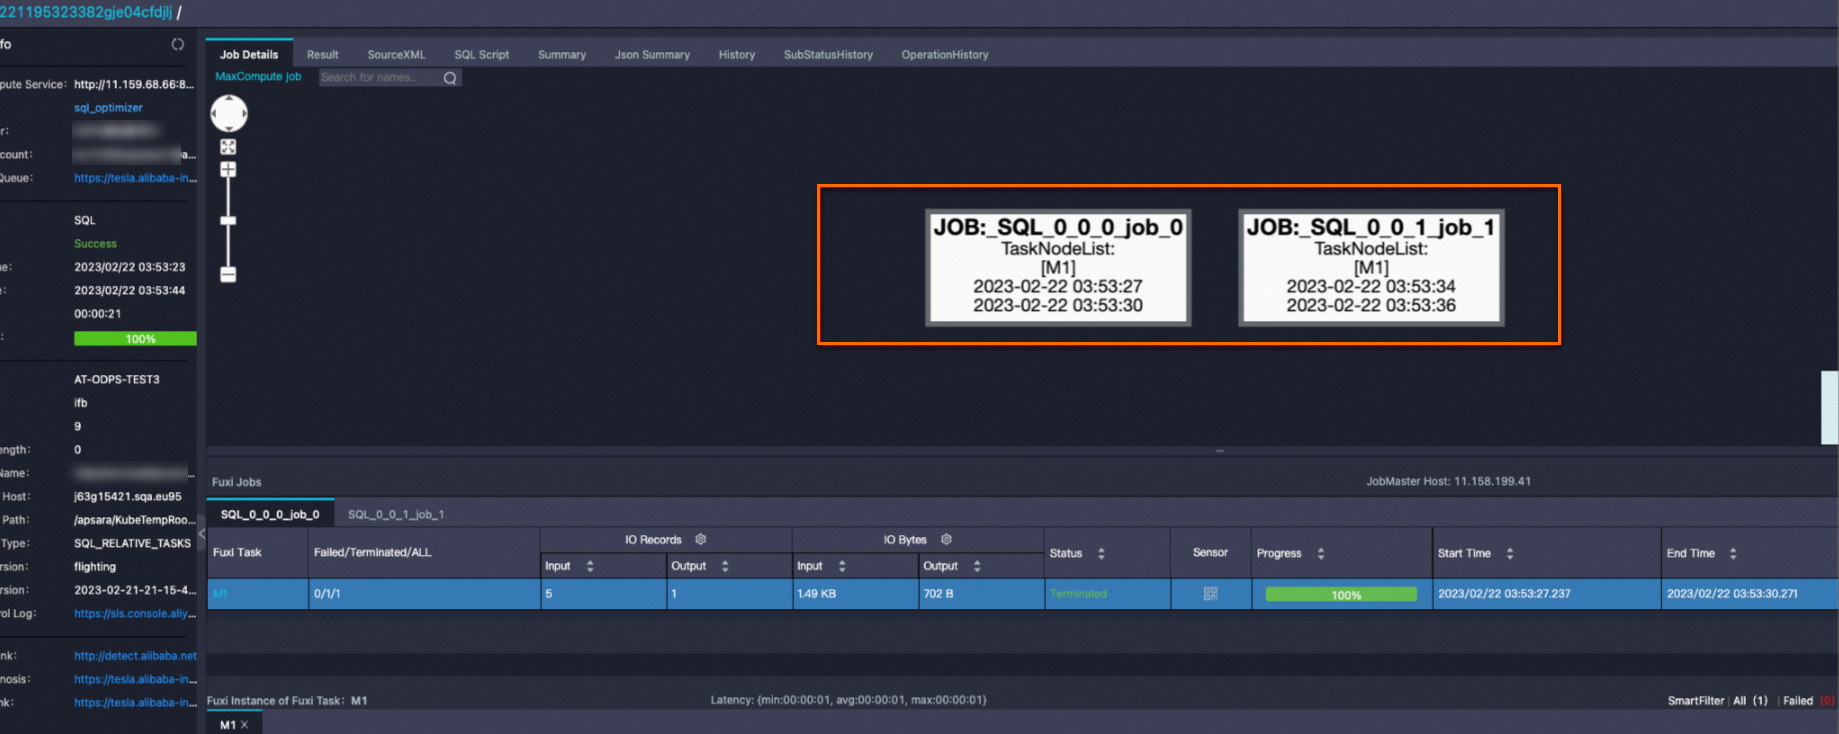
SET odps.sql.enable.bloom.filter.index=true;Bloomfilter index生效後,query中會增加一個job進行檔案裁剪,裁剪後的檔案即為任務需要讀取的資料。
如果沒有設定該參數(Beta發布期間預設值為false,後續會根據線上使用方式將預設值置為true),則無法在planning階段裁剪檔案,但此時仍可以利用儲存層謂詞下推能力,基於Bloomfilter本地索引資料進行資料的過濾。
如果Bloomfilter index的過濾效果不顯著(例如:結果檔案分散在多個檔案中,無法通過裁剪明顯過濾檔案),則設定該參數需要多執行一個索引檢索任務,有可能導致任務效能回退,此時可以置為false。
Bloomfilter index生效的任務樣本如下:
SET odps.sql.enable.bloom.filter.index=true;
SELECT * FROM bloomfilter_index_test WHERE key=392 AND value="val_392";
查看Logview可知,下圖中的job_1即為使用Bloomfilter index進行檔案裁剪的job(稱為index job)。
Summary中攜帶bf尾碼的是虛擬表,對應Bloomfilter index檔案。
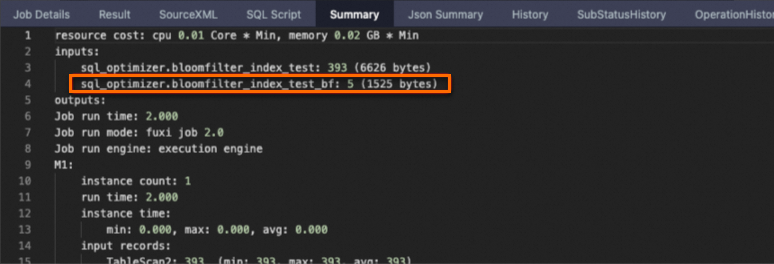
海量資料下產生的BF檔案可能會非常大,因此MaxCompute啟動了一個分布式作業進行檔案的裁剪。
查看錶的Bloomfilter index
SHOW INDEXES ON <table_name>;參數說明如下。
table_name:索引所在的表名。
刪除Bloomfilter index
DROP INDEX [IF EXISTS] <idx_name> ON TABLE <table_name>;參數說明如下。
idx_name:索引名稱。
table_name:索引所在的表名。
更改Bloomfilter index屬性
ALTER INDEX <idx_name> ON <table_name>
SET IDXPROPERTIES(['comment' = 'a'], ['fpp' = '0.01']);
參數說明如下。
idx_name:索引名稱。
table_name:索引所在的表名。
使用樣本
樣本1:基於普通分區表建立Bloomfilter index
資料準備。
SET odps.namespace.schema=true;
SELECT * FROM bigdata_public_dataset.TPCDS_10G.call_center;
建立分區測試表call_center_test。
CREATE TABLE IF NOT EXISTS call_center_test(
    cc_call_center_sk BIGINT NOT NULL, cc_call_center_id CHAR(16) NOT NULL,
    cc_rec_start_date DATE, cc_rec_end_date DATE,
    cc_closed_date_sk BIGINT, cc_open_date_sk BIGINT,
    cc_name VARCHAR(50), cc_class VARCHAR(50),
    cc_employees BIGINT, cc_sq_ft BIGINT,
    cc_hours CHAR(20), cc_manager VARCHAR(40),
    cc_mkt_id BIGINT, cc_mkt_class CHAR(50),
    cc_mkt_desc VARCHAR(100), cc_market_manager VARCHAR(40),
    cc_division BIGINT, cc_division_name VARCHAR(50),
    cc_company BIGINT, cc_company_name CHAR(50),
    cc_street_number CHAR(10), cc_street_name VARCHAR(60),
    cc_street_type CHAR(15), cc_suite_number CHAR(10),
    cc_city VARCHAR(60), cc_county VARCHAR(30),
    cc_state CHAR(2), cc_zip CHAR(10),
    cc_country VARCHAR(20), cc_gmt_offset DECIMAL(5,2),
    cc_tax_percentage DECIMAL(5,2)
)
PARTITIONED BY (ds STRING )
;
建立索引。
CREATE BLOOMFILTER INDEX call_center_test_idx01
ON table call_center_test
FOR columns(cc_call_center_sk)
IDXPROPERTIES('fpp' = '0.03', 'numitems'='1000000')
COMMENT 'cc_call_center_sk index';
匯入資料。
將公用資料集中的
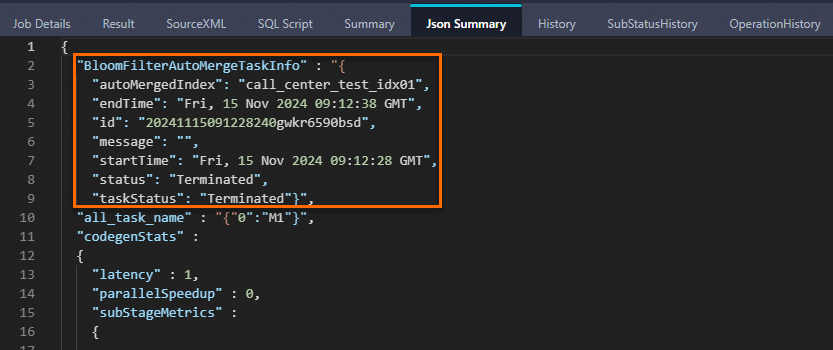
bigdata_public_dataset.TPCDS_10G.call_center表資料匯入至call_center_test。SET odps.namespace.schema=true; INSERT OVERWRITE TABLE call_center_test PARTITION (ds='20241115') SELECT * FROM bigdata_public_dataset.TPCDS_10G.call_center LIMIT 10000;Logview中Json Summary出現如下關鍵字則說明Bloomfilter index彙總成功:
查詢資料。
SET odps.sql.enable.bloom.filter.index=true;
SELECT * FROM call_center_test WHERE cc_call_center_sk =10 AND ds='20241115';
返回結果如下:
+-------------------+-------------------+-------------------+-----------------+-------------------+-----------------+---------------+------------+--------------+------------+------------+----------------+------------+----------------------------+---------------------------------------------------------------------------------------+-------------------+-------------+------------------+------------+-----------------+------------------+----------------+----------------+-----------------+------------+---------------+------------+------------+---------------+---------------+-------------------+------------+
| cc_call_center_sk | cc_call_center_id | cc_rec_start_date | cc_rec_end_date | cc_closed_date_sk | cc_open_date_sk | cc_name       | cc_class   | cc_employees | cc_sq_ft   | cc_hours   | cc_manager     | cc_mkt_id  | cc_mkt_class               | cc_mkt_desc                                                                           | cc_market_manager | cc_division | cc_division_name | cc_company | cc_company_name | cc_street_number | cc_street_name | cc_street_type | cc_suite_number | cc_city    | cc_county     | cc_state   | cc_zip     | cc_country    | cc_gmt_offset | cc_tax_percentage | ds         |
+-------------------+-------------------+-------------------+-----------------+-------------------+-----------------+---------------+------------+--------------+------------+------------+----------------+------------+--------------+-------------+---------------------------------------------------------------------------------------+-------------------+-------------+------------------+------------+-----------------+------------------+----------------+----------------+-----------------+------------+---------------+------------+------------+---------------+---------------+-------------------+------------+
| 10                | AAAAAAAAKAAAAAAA  | 1998-01-01        | 2000-01-01      | NULL              | 2451050         | Hawaii/Alaska | large      | 187          | 95744      | 8AM-8AM    | Gregory Altman | 2          | Just back responses ought  | As existing eyebrows miss as the matters. Realistic stories may not face almost by a  | James Mcdonald    | 3           | pri              | 3          | pri             | 457              | 1st            | Boulevard      | Suite B         | Midway     | Walker County | AL         | 31904      | United States | -6            | 0.02              | 20241115   |
+-------------------+-------------------+-------------------+-----------------+-------------------+-----------------+---------------+------------+--------------+------------+------------+----------------+------------+----------------------------+---------------------------------------------------------------------------------------+-------------------+-------------+------------------+------------+-----------------+------------------+----------------+----------------+-----------------+------------+---------------+------------+------------+---------------+---------------+-------------------+------------+
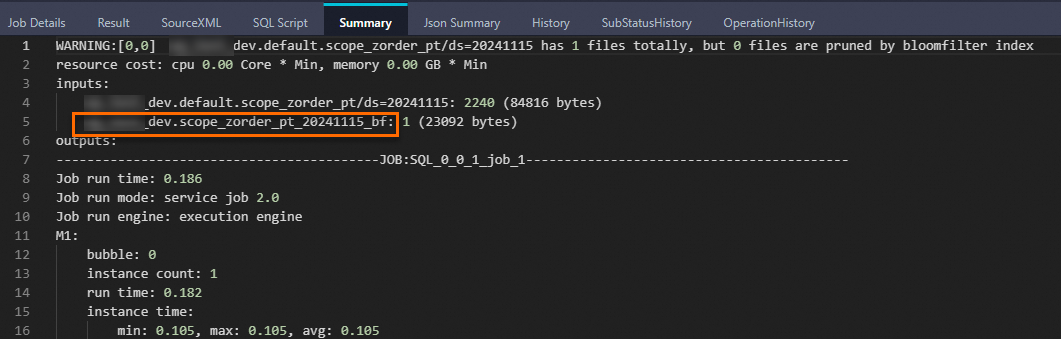
Logview中顯示如下資訊,表示Bloomfilter index已經生效,攜帶
bf尾碼的是虛擬表,對應Bloomfilter index檔案。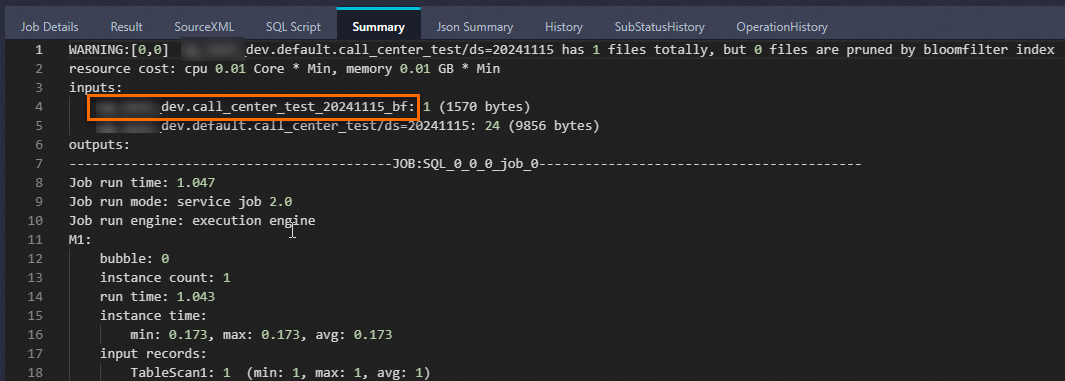
查看錶的Bloomfilter index。
SHOW INDEXES ON call_center_test;返回結果如下:
ID = 20241115093930589g9biyii****
{"Indexes": [{
            "id": "aabdaeb10a7b4e99a94716dabad8****",
            "indexColumns": [{"name": "cc_call_center_sk"}],
            "name": "call_center_test_idx01",
            "properties": {
                "comment": "cc_call_center_sk index",
                "fpp": "0.03",
                "numitems": "1000000"},
            "type": "BLOOMFILTER"}]}

OK
更改Bloomfilter index屬性。
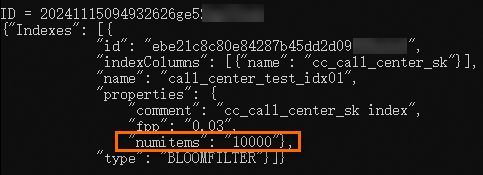
由上一步可知,原始
numitems屬性值為1000000,執行以下命令,將其屬性值更改為10000。-- 更改屬性 ALTER INDEX call_center_test_idx01 ON call_center_test SET IDXPROPERTIES('fpp' = '0.03', 'numitems'='10000'); -- 查看屬性 SHOW INDEXES ON call_center_test;返回結果如下:
樣本2:基於Hash Cluster分區表建立Bloomfilter index
資料準備。
建立scope_tmp表。
CREATE TABLE if NOT EXISTS scope_tmp( phone STRING, card STRING, machine STRING, geohash STRING);在MaxCompute用戶端(odpscmd)中使用Tunnel命令向scope_tmp表中上傳資料。以scope2.csv檔案為例,假設scope2.csv檔案位於MaxCompute用戶端(odpscmd)的
bin目錄下,Tunnel命令如下:Tunnel upload scope2.csv scope_tmp;
建立分區測試表scope_hash_pt。
CREATE TABLE scope_hash_pt (
    phone STRING,
    card STRING,
    machine STRING,
    geohash STRING
)
PARTITIONED BY (ds STRING)
clustered by (phone)
sorted by (card)
into 512 buckets;
為分區表scope_hash_pt建立索引。
CREATE BLOOMFILTER INDEX scope_hash_pt_index01
ON TABLE scope_hash_pt
FOR columns(card)
IDXPROPERTIES('fpp' = '0.03', 'numitems'='1000000')
COMMENT 'card index';
匯入資料。
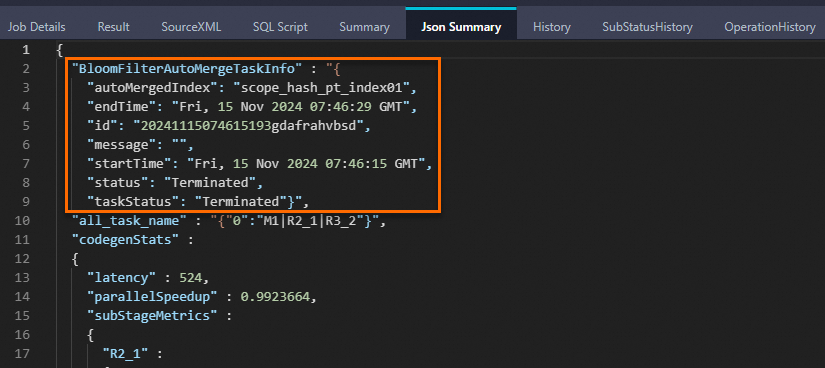
INSERT OVERWRITE TABLE scope_hash_pt PARTITION (ds='20241115') SELECT * FROM scope_tmp;Logview中Json Summary出現如下關鍵字則說明Bloomfilter index彙總成功:
查詢scope_hash_pt表的資料。
SET odps.sql.enable.bloom.filter.index=true;
SELECT * FROM scope_hash_pt WHERE card='073415764266290' and ds='20241115';
返回結果如下:
+-------------+-----------------+----------------+------------+------------+
| phone       | card            | machine        | geohash    | ds         |
+-------------+-----------------+----------------+------------+------------+
| 1576426**** | 073415764266290 | 51133960245770 | fWbDDsf    | 20241115   |
+-------------+-----------------+----------------+------------+------------+
Logview中顯示如下資訊,表示Bloomfilter index已經生效,攜帶
bf尾碼的是虛擬表,對應Bloomfilter index檔案。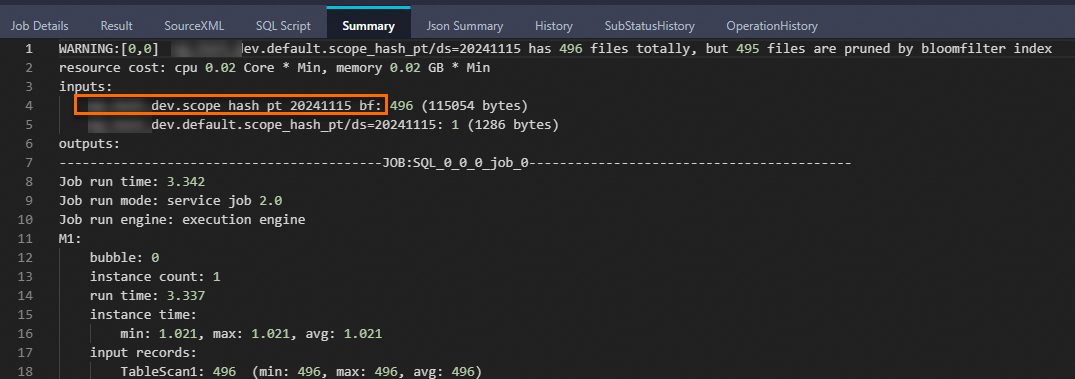
樣本3:基於Zorder資料重分布的分區表建立Bloomfilter index
資料準備。具體操作請參見Hash BloomFilter資料準備。
建立分區測試表scope_zorder_pt。
CREATE TABLE scope_zorder_pt(
    phone STRING,
    card STRING,
    machine STRING,
    geohash STRING,
    zvalue BIGINT
)
PARTITIONED BY (ds STRING)
;
建立索引。
CREATE BLOOMFILTER INDEX scope_zorder_pt_index01
ON TABLE scope_zorder_pt
FOR COLUMNS (card)
IDXPROPERTIES('fpp' = '0.05', 'numitems'='1000000')
COMMENT 'idxcomment';
匯入資料。
下載以下兩個JAR包,並將其存放在本地(假設存放路徑為
D:\)。執行以下命令將其上傳為JAR資源。
-- 添加資源
ADD JAR D:\odps-zorder-1.0-SNAPSHOT.jar;
ADD JAR D:\odps-zorder-1.0-SNAPSHOT-jar-with-dependencies.jar;
建立函數,命令如下:
CREATE FUNCTION zorder AS 'com.aliyun.odps.zorder.evaluateZValue2WithSize' USING ' odps-zorder-1.0-SNAPSHOT-jar-with-dependencies.jar';使用函數寫入資料至分區測試表scope_zorder_pt。
-- ORDER BY放開LIMIT限制
SET odps.sql.validate.orderby.limit=false;

--寫入資料
INSERT OVERWRITE TABLE scope_zorder_pt PARTITION (ds='20241115') SELECT *,zorder(HASH(phone), 100000000, HASH(card), 100000000) AS zvalue FROM scope_tmp ORDER BY zvalue;
Logview中Json Summary出現如下關鍵字則說明Bloomfilter index彙總成功:
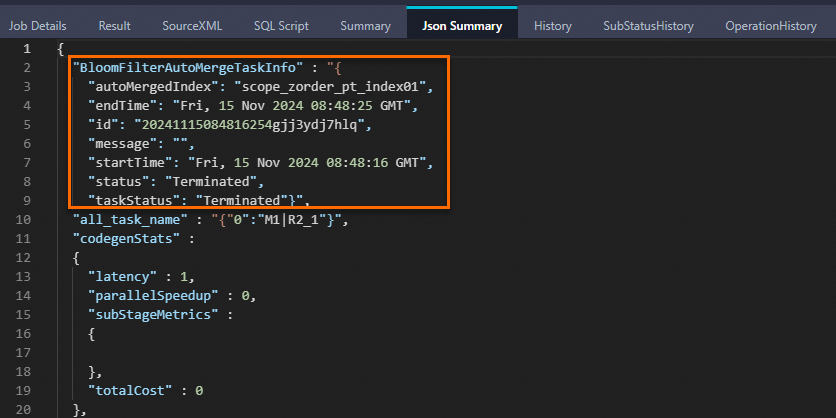
查詢資料。
SET odps.sql.enable.bloom.filter.index=true;
SELECT * FROM scope_zorder_pt WHERE card='073415764266290' AND ds='20241115';
返回結果如下:
+-------------+-----------------+----------------+------------+---------------------+------------+
| phone       | card            | machine        | geohash    | zvalue              | ds         |
+-------------+-----------------+----------------+------------+---------------------+------------+
| 1576426**** | 073415764266290 | 51133960245770 | fWbDDsf    | 3590549286038929408 | 20241115   |
+-------------+-----------------+----------------+------------+---------------------+------------+
Logview中顯示如下資訊,表示Bloomfilter index已經生效,攜帶
bf尾碼的是虛擬表,對應Bloomfilter index檔案。