全部產品
Search
文件中心

Container Service for Kubernetes:部署多機分布式推理服務

更新時間:Aug 29, 2026

本文以Qwen3-32B模型為例,示範如何在ACK中使用vLLM架構及SGLang架構部署多機分布式模型推理服務。

背景知識

  • Qwen3-32B

    Qwen3-32B 是千問系列最新一代的大型語言模型,基於328億參數的密集模型架構,兼具卓越的推理能力與高效的對話效能。其最大特色在於支援思考模式與非思考模式的無縫切換。在複雜邏輯推理、數學計算和代碼產生任務中表現出眾,而在日常對話情境下也可高效響應。模型具備出色的指令遵循、多輪對話、角色扮演和創意寫作能力,並在Agent任務中實現領先的工具調用表現。原生支援32K上下文,結合YaRN技術可擴充至131K。同時,支援100多種語言,具備強大的多語言理解與翻譯能力,適用於全球化應用情境。有關更多詳細資料,請參閱部落格、GitHub和文檔。

  • vLLM

    vLLM是一個高效、輕量的大型語言模型推理引擎,它採用創新的 PagedAttention 技術,高效管理KV緩衝,支援連續批處理、CUDA/HIP 圖加速、chunked prefill和Speculative decoding,顯著提升服務吞吐與響應速度。支援多種量化格式(如 GPTQ、AWQ、INT4/8、FP8)及 FlashAttention 等最佳化核心。vLLM 相容 Hugging Face和ModeScope模型,支援TP、PP、DP和EP並行,提供流式輸出和 OpenAI 相容 API。支援 NVIDIA、AMD、Intel 等多種硬體,覆蓋 Qwen、Deepseek、Llama、E5-Mistral等主流模型,廣泛應用於對話系統、內容產生、AI Agent 等情境,是構建大模型應用的理想選擇。更多關於vLLM架構的資訊,請參見vLLM GitHub。

  • SGLang

    SGLang 是一個高效能的大型語言模型與多模態模型服務推理引擎,通過前後端協同設計,提升模型互動速度與控制能力。其後端支援 RadixAttention(首碼緩衝)、零開銷 CPU 調度、PD分離、Speculative decoding、連續批處理、PagedAttention、TP/DP/PP/EP並行、結構化輸出、chunked prefill及多種量化技術(FP8/INT4/AWQ/GPTQ)和多LoRA批處理,顯著提升推理效率。前端提供靈活編程介面,支援鏈式產生、進階提示、控制流程、多模態輸入、平行處理和外部互動,便於構建複雜應用。支援 Qwen、DeepSeek、Llama等產生模型,E5-Mistral等嵌入模型以及 Skywork 等獎勵模型,易於擴充新模型。更多關於SGLang推理引擎的資訊,請參見SGLang GitHub。

  • 多機分布式部署

    LLM模型參數越來越大,單個GPU卡無法載入全部模型,需要通過各種並行策略,將一個龐大而緩慢的LLM推理任務,拆分成多個子任務,分配給多個計算單元(GPU),然後將結果高效地匯總起來,從而快速地完成LLM推理任務。常見的並行策略有如下四種。

    資料並行(Data Parallelism, DP)

    其核心思想是每個GPU上都有一套完整的模型副本,但處理不同的資料。這是最簡單、最常見的並行方式。
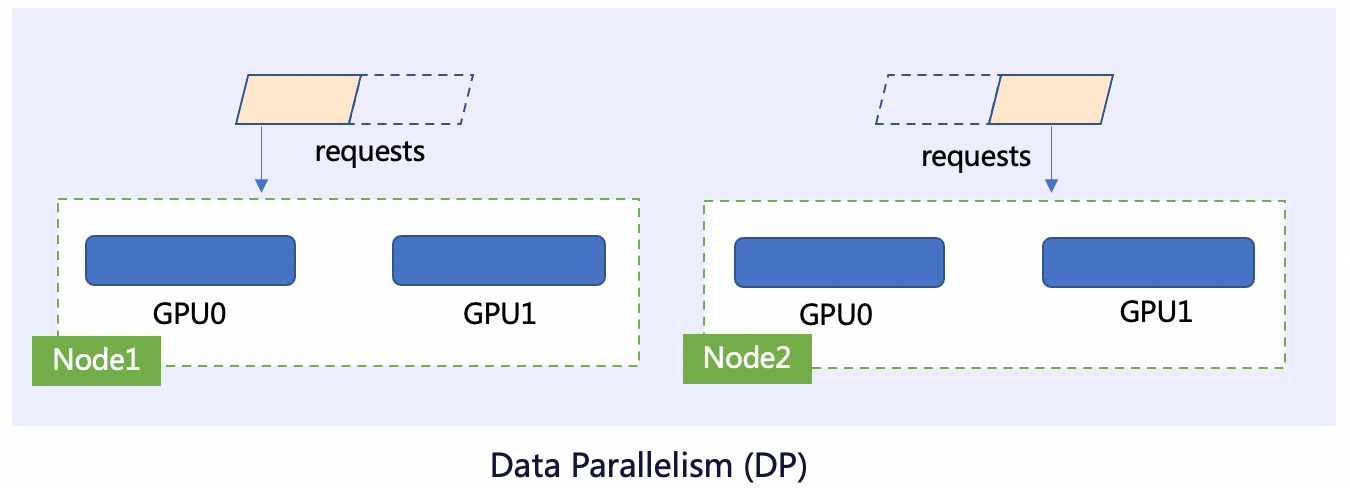
    image.png

    張量並行(Tensor Parallelism, TP)

    其核心思想是把模型權重切分開,讓每個GPU只載入並計算一部分權重。
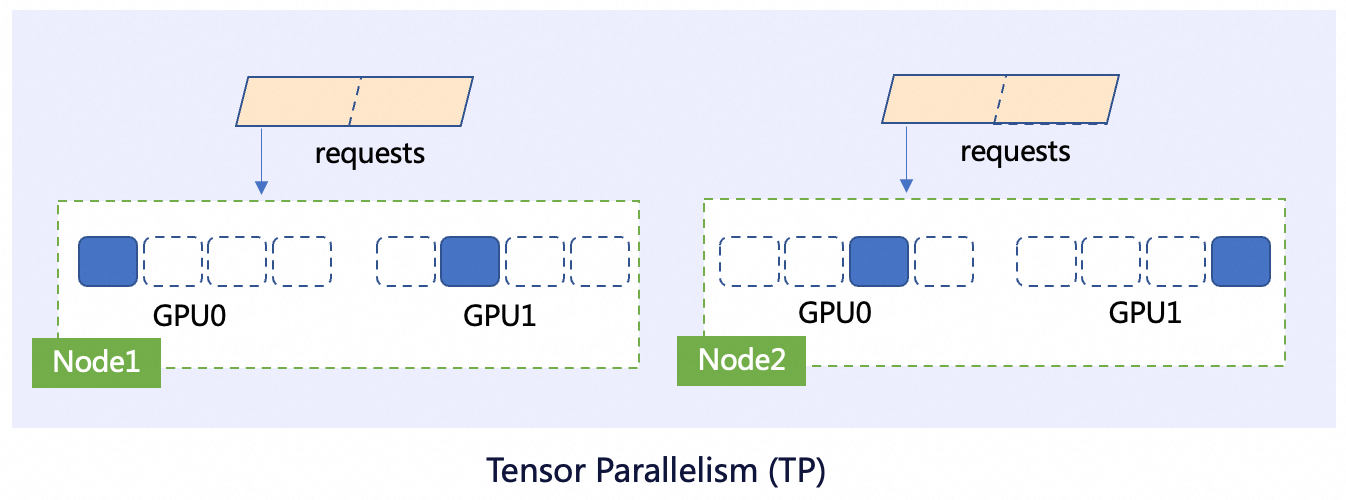
    image.png

    流水線並行(Pipeline Parallelism, PP)

    其核心思想是像工廠流水線一樣,把模型的“層”分配給不同的GPU。每個GPU負責計算一部分的模型層,並將計算的中間結果傳遞給下一個GPU。
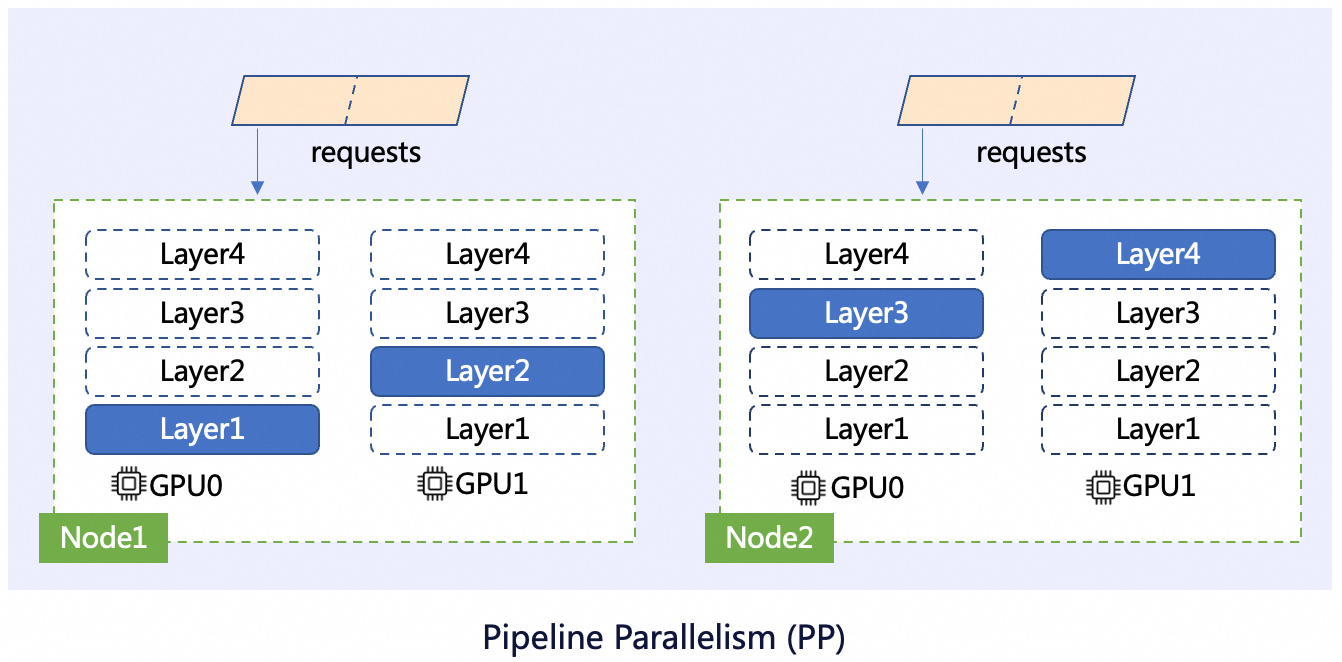
    image.png

    專家並行(Expert Parallelism, EP)

    MoE(Mixture-of-Experts)架構的模型中包含很多專家模型,每次只啟用其中一部分專家來處理。因此可以將這些專家模型存放在不同的GPU上。當推理計算需要用到某個專家時,資料會被路由到對應的GPU上。
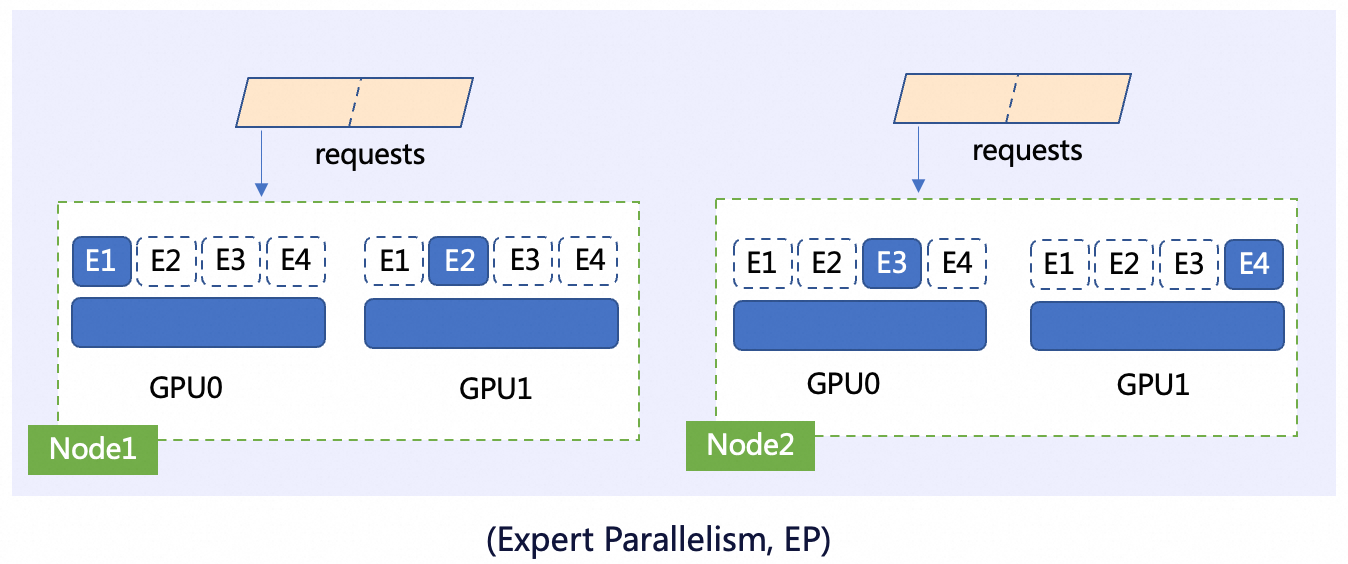
    image.png

前提條件

  • 已建立ACK叢集且叢集版本為1.28及以上,並且已經為叢集添加GPU節點。具體操作,請參見建立ACK託管叢集,及為叢集添加GPU節點。

    本文要求叢集中至少有兩個GPU節點,且單GPU節點顯存需大於32GB,推薦使用ecs.gn8is.4xlarge規格,更多規格資訊可參考GPU計算型執行個體規格類型系列gn8is。
  • 已安裝LeaderWorkerSet組件,組件版本大於等於v0.6.0,組件安裝步驟如下。

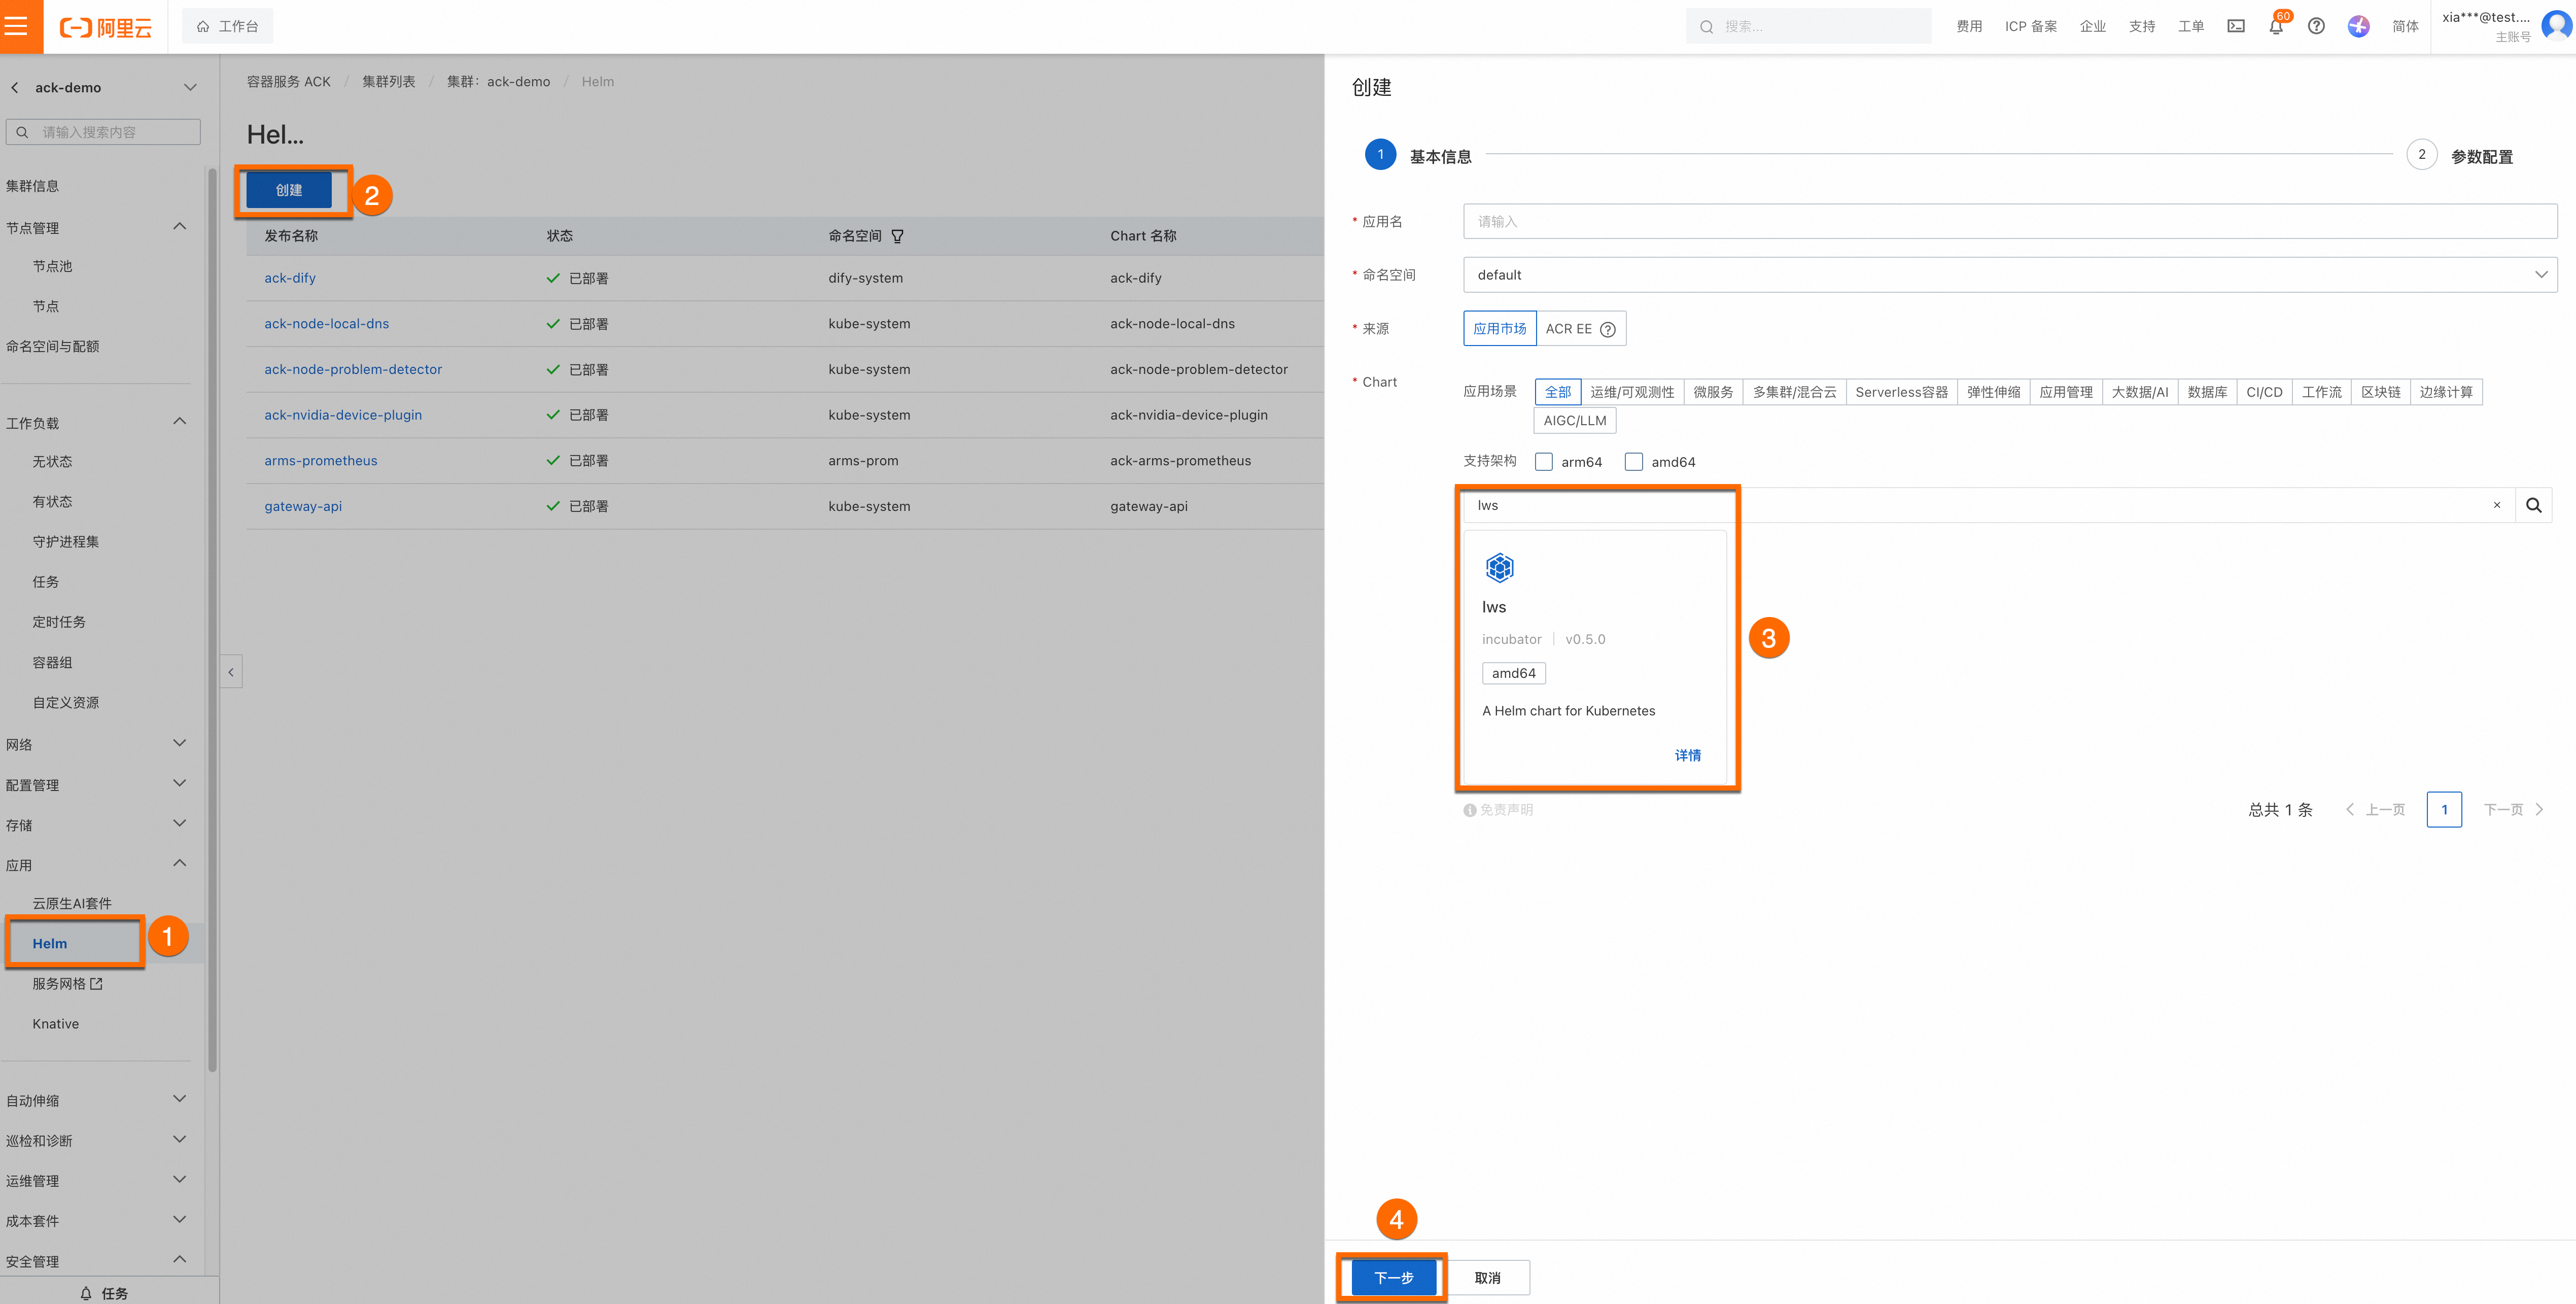
    登入Container Service管理主控台,在左側導覽列選擇叢集列表。單擊目的地組群名稱,進入叢集詳情頁面,使用Helm為目的地組群安裝lws。您無需為組件配置應用程式名稱和命名空間,單擊下一步後會出現一個請確認的彈框,單擊是,即可使用預設的應用程式名稱(lws)和命名空間(lws-system)。然後選擇Chart 版本為最新版本,單擊確定即可完成lws的安裝。image

模型部署

步驟一:準備Qwen3-32B模型檔案

  1. 執行以下命令從ModelScope下載Qwen-32B模型。

    請確認是否已安裝git-lfs外掛程式,如未安裝可執行yum install git-lfs或者apt-get install git-lfs安裝。更多的安裝方式,請參見安裝git-lfs。
    git lfs install
    GIT_LFS_SKIP_SMUDGE=1 git clone https://www.modelscope.cn/Qwen/Qwen3-32B.git
    cd Qwen3-32B/
    git lfs pull
  2. 登入OSS控制台,查看並記錄已建立的Bucket名稱。如何建立Bucket,請參見建立儲存空間。在OSS中建立目錄,將模型上傳至OSS。

    關於ossutil工具的安裝和使用方法,請參見安裝ossutil。
    ossutil mkdir oss://<YOUR-BUCKET-NAME>/Qwen3-32B
    ossutil cp -r ./Qwen3-32B oss://<your-bucket-name>/Qwen3-32B
  3. 建立PV和PVC。為目的地組群配置名為llm-model的儲存卷PV和儲存聲明PVC。具體操作,請參見建立PV和PVC。

    控制台操作樣本

    1. 建立PV。

      • 登入Container Service管理主控台,在左側導覽列選擇叢集列表。

      • 在叢集列表頁面,單擊目的地組群名稱,然後在左側導覽列,選擇儲存 > 儲存卷。

      • 建立 pv-oss-rrsa.yaml。

        apiVersion: v1
        kind: PersistentVolume
        metadata:
          # PV名稱
          name: pv-oss   
          # PV標籤
          labels:    
            alicloud-pvname: pv-oss
        spec:
          capacity:
            # 定義儲存卷容量
            storage: 10Gi  
          # 訪問模式
          accessModes:  
            - ReadOnlyMany
          persistentVolumeReclaimPolicy: Retain
          csi:
            driver: ossplugin.csi.alibabacloud.com
            # 與PV名稱(metadata.name)一致
            volumeHandle: pv-oss  
            volumeAttributes:
              # 替換為實際Bucket名稱
              bucket: "your-bucket-name"  
              # 替換為實際Bucket的地區
              region: cn-hangzhou
              # 掛載Bucket的根目錄或指定子目錄
              path: /  
              # Bucket所在地區的Endpoint
              url: "https://oss-cn-hangzhou-internal.aliyuncs.com"  
              otherOpts: "-o umask=022 -o max_stat_cache_size=100000 -o allow_other"
              authType: "rrsa"
              # 此前建立或修改的RAM角色
              roleName: "demo-role-for-rrsa"
              # OSS請求籤名版本
              sigVersion: "v4"  

        參數

        描述

        storage

        定義OSS儲存卷容量。此值僅用於匹配PVC。

        accessModes

        配置訪問模式,支援ReadOnlyMany和ReadWriteMany。

        選擇ReadOnlyMany時,ossfs將以唯讀模式掛載OSS Bucket。

        persistentVolumeReclaimPolicy

        PV回收策略。當前OSS儲存卷僅支援Retain,即刪除PVC時,PV和OSS Bucket中的資料不會隨之刪除。

        driver

        定義驅動類型。使用阿里雲OSS CSI外掛程式固定為ossplugin.csi.alibabacloud.com。

        volumeHandle

        需與PV名稱(metadata.name)保持一致。

        bucket

        待掛載的OSS Bucket。

        path

        CSI組件版本需為v1.14.8.32-c77e277b-aliyun及以上。

        指定掛載點相對於 Bucket 根目錄的路徑。預設為 /,即掛載整個 Bucket。

        ossfs版本小於1.91時,指定的 path 必須在 OSS Bucket 中預先存在。詳見ossfs 1.91及以上版本新增功能說明

        url

        待掛載OSS的訪問網域名稱(Endpoint)。

        • 掛載節點和Bucket處於相同地區,或已打通VPC網路時,使用內網地址。

        • 掛載節點和Bucket不同地區時,使用外網地址。

        不同訪問連接埠的常見填寫格式如下:

        • 內網格式:https://oss-{{regionName}}-internal.aliyuncs.com。

          內網訪問連接埠格式vpc100-oss-{{regionName}}.aliyuncs.com已廢棄,請及時切換。
        • 外網格式:https://oss-{{regionName}}.aliyuncs.com。

        從安全考慮,建議您通過HTTPS協議訪問OSS,若希望使用HTTP協議,請替換上述格式為http://開頭。

        otherOpts

        為OSS儲存卷輸入定製化參數,格式為-o *** -o ***,例如-o umask=022 -o max_stat_cache_size=100000 -o allow_other。

        展開查看說明

        • umask:更改ossfs讀檔案的許可權。

          例如,umask=022可將ossfs檔案的許可權變更為755,解決通過SDK、OSS控制台等其他方式上傳的檔案(預設許可權為640)在掛載點內許可權不足的問題。推薦在讀寫分離或多使用者訪問時配置。

        • max_stat_cache_size:設定中繼資料快取的條目上限(例如100000),在記憶體中快取檔案元資訊來提升 ls、stat 等操作的效能。

          但該緩衝無法及時感知通過OSS控制台、SDK、ossutil等方式對檔案的修改,可能導致應用讀取資料不一致。在對資料一致性有強要求時可將其設為0(禁用緩衝),或通過stat_cache_expire參數調低緩衝的失效時間,但會犧牲讀取效能。

        • allow_other:允許除掛載使用者外的其他使用者訪問掛載點中的檔案和目錄,適用於需要讓非掛載使用者也能訪問資料的多使用者共用環境。

        更多選擇性參數,請參見掛載選項說明、ossfs 1.0配置最佳實務。

        authType

        配置為rrsa,使用RRSA方式鑒權。

        roleName

        配置為此前建立或修改的RAM角色。

        如需為不同PV配置不同許可權,可建立不同的RAM角色,並在PV中配置不同的roleName。

        sigVersion

        請求OSS服務端的請求籤名版本。

        重要
        • OSS 將逐步下線 V1 簽名,強烈建議您使用更安全的 V4 簽名,以確保應用穩定運行。詳見V1簽名下線時間和影響。

        • 使用OSS簽名版本4時,必須配置region參數。

        region

        使用OSS簽名版本4時需要配置為Bucket所在的OSS地區。如何查詢OSS地區,詳見擷取儲存空間的地區資訊。

        非空時,自動選擇使用OSS簽名版本4。

        若預設的RRSA鑒權不滿足需求(如使用非預設ServiceAccount或第三方OIDC),可通過修改PV配置來指定具體的ARN或ServiceAccount,詳見如何在RRSA鑒權方式中使用指定的ARNs或ServiceAccount?。
      • 在儲存卷頁面,單擊建立,選擇儲存卷類型為OSS,按照頁面配置並提交參數。

        以下為樣本PV的基本配置資訊:

        配置項

        說明

        儲存卷類型

        OSS

        名稱

        llm-model

        訪問認證

        配置用於訪問OSS的AccessKey ID和AccessKey Secret。

        Bucket ID

        選擇上一步所建立的OSS Bucket。

        OSS Path

        選擇模型所在的路徑,如/Qwen3-32B。

    2. 建立PVC。

      • 在叢集列表頁面,單擊目的地組群名稱,然後在左側導覽列,選擇儲存 > 儲存聲明。

      • 建立 pv-oss-rrsa.yaml。

        apiVersion: v1
        kind: PersistentVolume
        metadata:
          # PV名稱
          name: pv-oss   
          # PV標籤
          labels:    
            alicloud-pvname: pv-oss
        spec:
          capacity:
            # 定義儲存卷容量
            storage: 10Gi  
          # 訪問模式
          accessModes:  
            - ReadOnlyMany
          persistentVolumeReclaimPolicy: Retain
          csi:
            driver: ossplugin.csi.alibabacloud.com
            # 與PV名稱(metadata.name)一致
            volumeHandle: pv-oss  
            volumeAttributes:
              # 替換為實際Bucket名稱
              bucket: "your-bucket-name"  
              # 替換為實際Bucket的地區
              region: cn-hangzhou
              # 掛載Bucket的根目錄或指定子目錄
              path: /  
              # Bucket所在地區的Endpoint
              url: "https://oss-cn-hangzhou-internal.aliyuncs.com"  
              otherOpts: "-o umask=022 -o max_stat_cache_size=100000 -o allow_other"
              authType: "rrsa"
              # 此前建立或修改的RAM角色
              roleName: "demo-role-for-rrsa"
              # OSS請求籤名版本
              sigVersion: "v4"  

        參數

        描述

        storage

        定義OSS儲存卷容量。此值僅用於匹配PVC。

        accessModes

        配置訪問模式,支援ReadOnlyMany和ReadWriteMany。

        選擇ReadOnlyMany時,ossfs將以唯讀模式掛載OSS Bucket。

        persistentVolumeReclaimPolicy

        PV回收策略。當前OSS儲存卷僅支援Retain,即刪除PVC時,PV和OSS Bucket中的資料不會隨之刪除。

        driver

        定義驅動類型。使用阿里雲OSS CSI外掛程式固定為ossplugin.csi.alibabacloud.com。

        volumeHandle

        需與PV名稱(metadata.name)保持一致。

        bucket

        待掛載的OSS Bucket。

        path

        CSI組件版本需為v1.14.8.32-c77e277b-aliyun及以上。

        指定掛載點相對於 Bucket 根目錄的路徑。預設為 /,即掛載整個 Bucket。

        ossfs版本小於1.91時,指定的 path 必須在 OSS Bucket 中預先存在。詳見ossfs 1.91及以上版本新增功能說明

        url

        待掛載OSS的訪問網域名稱(Endpoint)。

        • 掛載節點和Bucket處於相同地區,或已打通VPC網路時,使用內網地址。

        • 掛載節點和Bucket不同地區時,使用外網地址。

        不同訪問連接埠的常見填寫格式如下:

        • 內網格式:https://oss-{{regionName}}-internal.aliyuncs.com。

          內網訪問連接埠格式vpc100-oss-{{regionName}}.aliyuncs.com已廢棄,請及時切換。
        • 外網格式:https://oss-{{regionName}}.aliyuncs.com。

        從安全考慮,建議您通過HTTPS協議訪問OSS,若希望使用HTTP協議,請替換上述格式為http://開頭。

        otherOpts

        為OSS儲存卷輸入定製化參數,格式為-o *** -o ***,例如-o umask=022 -o max_stat_cache_size=100000 -o allow_other。

        展開查看說明

        • umask:更改ossfs讀檔案的許可權。

          例如,umask=022可將ossfs檔案的許可權變更為755,解決通過SDK、OSS控制台等其他方式上傳的檔案(預設許可權為640)在掛載點內許可權不足的問題。推薦在讀寫分離或多使用者訪問時配置。

        • max_stat_cache_size:設定中繼資料快取的條目上限(例如100000),在記憶體中快取檔案元資訊來提升 ls、stat 等操作的效能。

          但該緩衝無法及時感知通過OSS控制台、SDK、ossutil等方式對檔案的修改,可能導致應用讀取資料不一致。在對資料一致性有強要求時可將其設為0(禁用緩衝),或通過stat_cache_expire參數調低緩衝的失效時間,但會犧牲讀取效能。

        • allow_other:允許除掛載使用者外的其他使用者訪問掛載點中的檔案和目錄,適用於需要讓非掛載使用者也能訪問資料的多使用者共用環境。

        更多選擇性參數,請參見掛載選項說明、ossfs 1.0配置最佳實務。

        authType

        配置為rrsa,使用RRSA方式鑒權。

        roleName

        配置為此前建立或修改的RAM角色。

        如需為不同PV配置不同許可權,可建立不同的RAM角色,並在PV中配置不同的roleName。

        sigVersion

        請求OSS服務端的請求籤名版本。

        重要
        • OSS 將逐步下線 V1 簽名,強烈建議您使用更安全的 V4 簽名,以確保應用穩定運行。詳見V1簽名下線時間和影響。

        • 使用OSS簽名版本4時,必須配置region參數。

        region

        使用OSS簽名版本4時需要配置為Bucket所在的OSS地區。如何查詢OSS地區,詳見擷取儲存空間的地區資訊。

        非空時,自動選擇使用OSS簽名版本4。

        若預設的RRSA鑒權不滿足需求(如使用非預設ServiceAccount或第三方OIDC),可通過修改PV配置來指定具體的ARN或ServiceAccount,詳見如何在RRSA鑒權方式中使用指定的ARNs或ServiceAccount?。
      • 以下為樣本PVC的基本配置資訊:

        配置項

        說明

        儲存宣告類型

        OSS

        名稱

        llm-model

        分配模式

        選擇已有儲存卷。

        已有儲存卷

        單擊選擇已有儲存卷連結,選擇已建立的儲存卷PV。

    kubectl操作樣本

    1. 建立llm-model.yaml檔案,該YAML檔案包含Secret、靜態卷PV、靜態卷PVC等配置,樣本YAML檔案如下所示。

      apiVersion: v1
      kind: Secret
      metadata:
        name: oss-secret
      stringData:
        akId: <YOUR-OSS-AK> # 配置用於訪問OSS的AccessKey ID
        akSecret: <YOUR-OSS-SK> # 配置用於訪問OSS的AccessKey Secret
      ---
      apiVersion: v1
      kind: PersistentVolume
      metadata:
        name: llm-model
        labels:
          alicloud-pvname: llm-model
      spec:
        capacity:
          storage: 30Gi 
        accessModes:
          - ReadOnlyMany
        persistentVolumeReclaimPolicy: Retain
        csi:
          driver: ossplugin.csi.alibabacloud.com
          volumeHandle: llm-model
          nodePublishSecretRef:
            name: oss-secret
            namespace: default
          volumeAttributes:
            bucket: <YOUR-BUCKET-NAME> # bucket名稱
            url: <YOUR-BUCKET-ENDPOINT> # Endpoint資訊,如oss-cn-hangzhou-internal.aliyuncs.com
            otherOpts: "-o umask=022 -o max_stat_cache_size=0 -o allow_other"
            path: <YOUR-MODEL-PATH> # 本樣本中為/Qwen3-32B/
      ---
      apiVersion: v1
      kind: PersistentVolumeClaim
      metadata:
        name: llm-model
      spec:
        accessModes:
          - ReadOnlyMany
        resources:
          requests:
            storage: 30Gi
        selector:
          matchLabels:
            alicloud-pvname: llm-model
    2. 建立Secret、建立靜態卷PV、建立靜態卷PVC。

      kubectl create -f llm-model.yaml

步驟二:部署推理服務

本文使用LeaderWorkerSet作為工作負載,採用TP=2的並行策略,在兩個GPU節點上部署分布式推理服務。

vLLM架構部署多機推理服務

  1. 建立vllm_multi.yaml檔案。

    展開查看相關範例程式碼。

    apiVersion: leaderworkerset.x-k8s.io/v1
    kind: LeaderWorkerSet
    metadata:
      name: vllm-multi-nodes
    spec:
      replicas: 1
      leaderWorkerTemplate:
        size: 2
        restartPolicy: RecreateGroupOnPodRestart
        leaderTemplate:
          metadata:
            labels:
              role: leader
              # for prometheus to scrape
              alibabacloud.com/inference-workload: vllm-multi-nodes
              alibabacloud.com/inference_backend: vllm
          spec:
            volumes:
              - name: model
                persistentVolumeClaim:
                  claimName: llm-model
              - name: dshm
                emptyDir:
                  medium: Memory
                  sizeLimit: 15Gi
            containers:
              - name: vllm-leader
                image: kube-ai-registry.cn-shanghai.cr.aliyuncs.com/kube-ai/vllm:v0.10.0
                command:
                  - sh
                  - -c
                  - "bash /vllm-workspace/examples/online_serving/multi-node-serving.sh leader --ray_cluster_size=$(LWS_GROUP_SIZE); python3 -m vllm.entrypoints.openai.api_server --port 8000 --model /models/Qwen3-32B --tensor-parallel-size 2"
                resources:
                  limits:
                    nvidia.com/gpu: "1"
                    memory: "24Gi"
                    cpu: "8"
                  requests:
                    nvidia.com/gpu: "1"
                    memory: "24Gi"
                    cpu: "8"
                ports:
                  - containerPort: 8000
                    name: http
                readinessProbe:
                  initialDelaySeconds: 30
                  periodSeconds: 10
                  tcpSocket:
                    port: 8000
                volumeMounts:
                  - mountPath: /models/Qwen3-32B
                    name: model
                  - mountPath: /dev/shm
                    name: dshm
        workerTemplate:
          spec:
            volumes:
              - name: model
                persistentVolumeClaim:
                  claimName: llm-model
              - name: dshm
                emptyDir:
                  medium: Memory
                  sizeLimit: 15Gi
            containers:
              - name: vllm-worker
                image: kube-ai-registry.cn-shanghai.cr.aliyuncs.com/kube-ai/vllm:v0.10.0
                command:
                  - sh
                  - -c
                  - "bash /vllm-workspace/examples/online_serving/multi-node-serving.sh worker --ray_address=$(LWS_LEADER_ADDRESS)"
                resources:
                  limits:
                    nvidia.com/gpu: "1"
                    memory: "24Gi"
                    cpu: "8"
                  requests:
                    nvidia.com/gpu: "1"
                    memory: "24Gi"
                    cpu: "8"
                ports:
                  - containerPort: 8000
                volumeMounts:
                  - mountPath: /models/Qwen3-32B
                    name: model
                  - mountPath: /dev/shm
                    name: dshm
    ---
    apiVersion: v1
    kind: Service
    metadata:
      name: multi-nodes-service
    spec:
      type: ClusterIP
      ports:
      - port: 8000
        protocol: TCP
        targetPort: 8000
      selector:
        alibabacloud.com/inference-workload: vllm-multi-nodes
        role: leader
  2. 使用vLLM架構部署多機LLM推理服務。

    kubectl create -f vllm_multi.yaml

SGLang架構部署多機推理服務

  1. 建立sglang_multi.yaml檔案。

    展開查看相關範例程式碼。

    apiVersion: leaderworkerset.x-k8s.io/v1
    kind: LeaderWorkerSet
    metadata:
      name: sglang-multi-nodes
    spec:
      replicas: 1
      leaderWorkerTemplate:
        size: 2
        restartPolicy: RecreateGroupOnPodRestart
        leaderTemplate:
          metadata:
            labels:
              role: leader
              # for prometheus to scrape
              alibabacloud.com/inference-workload: sglang-multi-nodes
              alibabacloud.com/inference_backend: sglang
          spec:
            containers:
              - name: sglang-leader
                image: anolis-registry.cn-zhangjiakou.cr.aliyuncs.com/anolis-docker-images/docker-temp:0.3.4.post2-sglang0.4.10.post2-pytorch2.7.1.8-cuda12.8.1-py312-alinux3.2104
                command:
                  - sh
                  - -c
                  - "python3 -m sglang.launch_server --model-path /models/Qwen3-32B --tp 2 --dist-init-addr $(LWS_LEADER_ADDRESS):20000 \
                  --nnodes $(LWS_GROUP_SIZE) --node-rank $(LWS_WORKER_INDEX) --trust-remote-code --host 0.0.0.0 --port 8000 --enable-metrics"
                resources:
                  limits:
                    nvidia.com/gpu: "1"
                    memory: "24Gi"
                    cpu: "8"
                  requests:
                    nvidia.com/gpu: "1"
                    memory: "24Gi"
                    cpu: "8"
                ports:
                  - containerPort: 8000
                    name: http
                readinessProbe:
                  tcpSocket:
                    port: 8000
                  initialDelaySeconds: 30
                  periodSeconds: 10
                volumeMounts:
                  - mountPath: /dev/shm
                    name: dshm
                  - mountPath: /models/Qwen3-32B
                    name: model
            volumes:
                - name: model
                  persistentVolumeClaim:
                    claimName: llm-model
                - name: dshm
                  emptyDir:
                    medium: Memory
                    sizeLimit: 15Gi
        workerTemplate:
          spec:
            containers:
              - name: sglang-worker
                image: anolis-registry.cn-zhangjiakou.cr.aliyuncs.com/anolis-docker-images/docker-temp:0.3.4.post2-sglang0.4.10.post2-pytorch2.7.1.8-cuda12.8.1-py312-alinux3.2104
                command:
                  - sh
                  - -c
                  - "python3 -m sglang.launch_server --model-path /models/Qwen3-32B --tp 2 --dist-init-addr $(LWS_LEADER_ADDRESS):20000 \
                  --nnodes $(LWS_GROUP_SIZE) --node-rank $(LWS_WORKER_INDEX) --trust-remote-code"
                resources:
                  limits:
                    nvidia.com/gpu: "1"
                    memory: "24Gi"
                    cpu: "8"
                  requests:
                    nvidia.com/gpu: "1"
                    memory: "24Gi"
                    cpu: "8"
                volumeMounts:
                  - mountPath: /dev/shm
                    name: dshm
                  - mountPath: /models/Qwen3-32B
                    name: model
            volumes:
                - name: model
                  persistentVolumeClaim:
                    claimName: llm-model
                - name: dshm
                  emptyDir:
                    medium: Memory
                    sizeLimit: 15Gi
    ---
    apiVersion: v1
    kind: Service
    metadata:
      name: multi-nodes-service
    spec:
      selector:
        alibabacloud.com/inference-workload: sglang-multi-nodes
        role: leader
      ports:
        - protocol: TCP
          port: 8000
          targetPort: 8000
  2. 使用SGLang架構部署多機LLM推理服務。

    kubectl create -f sglang_multi.yaml

步驟三:驗證推理服務

  1. 執行以下命令,在推理服務與本地環境之間建立連接埠轉寄。

    重要

    kubectl port-forward建立的連接埠轉寄不具備生產層級的可靠性、安全性和擴充性,因此僅適用於開發和調試目的,不適合在生產環境使用。更多關於Kubernetes叢集內生產可用的網路方案的資訊,請參見Ingress管理。

    kubectl port-forward svc/multi-nodes-service 8000:8000

    預期輸出:

    Forwarding from 127.0.0.1:8000 -> 8000
    Forwarding from [::1]:8000 -> 8000
  2. 執行以下命令,向模型推理服務發送了一條樣本的模型推理請求。

    curl http://localhost:8000/v1/chat/completions -H "Content-Type: application/json"  -d '{"model": "/models/Qwen3-32B", "messages": [{"role": "user", "content": "測試一下"}], "max_tokens": 30, "temperature": 0.7, "top_p": 0.9, "seed": 10}'

    預期輸出:

    {"id":"chatcmpl-ee6b347a8bd049f9a502669db0817938","object":"chat.completion","created":1753685847,"model":"/models/Qwen3-32B","choices":[{"index":0,"message":{"role":"assistant","reasoning_content":null,"content":"<think>\n好的,使用者發來“測試一下”,我需要先確認他們的需求。可能是在測試我的功能,或者想看看我的反應。","tool_calls":[]},"logprobs":null,"finish_reason":"length","stop_reason":null}],"usage":{"prompt_tokens":10,"total_tokens":40,"completion_tokens":30,"prompt_tokens_details":null},"prompt_logprobs":null,"kv_transfer_params":null}

    輸出結果表明模型可以根據給定的輸入(在這個例子中是一條測試訊息)產生相應的回複。

相關文檔

  • 為LLM推理服務配置Prometheus Dashboard監控

    在生產環境中,LLM推理服務的可觀測性是系統穩定性的核心保障,開源推理引擎通過整合Prometheus Dashboard實現故障的主動發現與精準定位。

  • 為單機/多機推理配置彈性擴縮容

    針對LLM模型服務的動態負載波動問題,Kubernetes HPA結合ACK的ack-alibaba-cloud-metrics-adapter組件,可根據CPU/記憶體/GPU利用率及自訂指標實現Pod的動態Auto Scaling,保障服務穩定性與資源高效利用。

  • 配置ACK Gateway with Inference Extension網關實現智能路由

    ACK Gateway with Inference Extension 是基於 Kubernetes 社區 Gateway API 及其 Inference Extension 規範構建的增強型組件,支援 Kubernetes 四層和七層路由服務,同時針對產生式 AI 推理情境提供了一系列最佳化能力。該組件能夠簡化 AI 推理服務的管理流程,並提升多推理服務工作負載間的負載平衡效能。其關鍵特性包括:

    • 模型感知的推理負載平衡:提供最佳化的負載平衡策略,確保推理請求高效分發。

    • 基於 OpenAI API 規範的模型路由:根據模型名稱對推理請求進行智能路由,支援對同一基本模型的不同 LoRA 模型進行流量灰階管理。

    • 模型關鍵性優先順序配置:通過為不同模型設定關鍵性等級,實現請求的差異化優先順序處理,確保高優先順序模型的服務品質。

  • 基於Fluid配置分布式緩衝實現模型加速

    LLM 模型通常包含超過10GB的權重檔案,從儲存服務(如 OSS、NAS 等)拉取這些大檔案時,容易因長時間延遲和冷啟動問題影響效能。Fluid 通過在 Kubernetes 叢集節點上構建分布式檔案快取系統,整合多個節點的儲存與頻寬資源;同時,它從應用程式端最佳化模型檔案的讀取機制,從而顯著加速模型載入過程。