Crie um sistema de recuperação de texto para imagem usando o DashVector e o modelo Chinese CLIP do ModelScope. O conjunto de dados multimodal Muge serve como corpus de imagens.
Fluxo de trabalho

O processo tem duas etapas principais:
Incorporação e armazenamento de dados de imagem: converta as imagens do conjunto de dados Muge em vetores com a API de incorporação do Chinese CLIP e grave-os no DashVector.
Recuperação por consulta de texto: transforme uma consulta de texto em vetor com o mesmo modelo Chinese CLIP e recupere imagens semelhantes no DashVector.
Pré-requisitos
1. Preparar uma chave de API
Ative o DashVector. Consulte Ativar o DashVector.
Crie uma chave de API do DashVector. Consulte Gerenciar chaves de API.
2. Preparar o ambiente
Este tutorial usa o modelo Enormous (resolução 224) do CLIP no ModelScope, treinado com cerca de 200 milhões de pares imagem-texto em chinês. Instale as seguintes dependências:
Instale o Python 3.7 ou versão posterior.
# Install the DashVector client
pip3 install dashvector

# Install ModelScope
# ModelScope 0.3.7 or later is required. The default version is usually later than 0.3.7, but check to be sure.
# Update the image or use the following method.
pip3 install --upgrade modelscope -f https://modelscope.oss-cn-beijing.aliyuncs.com/releases/repo.html
# Install decord separately.
# pip3 install decord
# The ModelScope installation may have other dependencies. The dependencies for the current version are listed below.
# pip3 install torch torchvision opencv-python timm librosa fairseq transformers unicodedata2 zhconv rapidfuzz
3. Preparar os dados
Este tutorial utiliza o conjunto de validação do conjunto de dados multimodal Muge. Carregue-o pela API de conjunto de dados do ModelScope.
from modelscope.msdatasets import MsDataset

dataset = MsDataset.load("muge", split="validation")
Etapas
Substitua your-xxx-api-key e your-xxx-cluster-endpoint pela sua chave de API e pelo endpoint do cluster reais.
1. Incorporar e armazenar dados de imagem
O conjunto de validação do conjunto de dados multimodal Muge contém 30.588 imagens. Extraia os vetores de incorporação com o modelo CLIP e armazene-os no DashVector junto com os dados de imagem codificados em base64 para exibição posterior.
import torch
from modelscope.utils.constant import Tasks
from modelscope.pipelines import pipeline
from modelscope.msdatasets import MsDataset
from dashvector import Client, Doc, DashVectorException, DashVectorCode
from PIL import Image
import base64
import io

def image2str(image):
    image_byte_arr = io.BytesIO()
    image.save(image_byte_arr, format='PNG')
    image_bytes = image_byte_arr.getvalue()
    return base64.b64encode(image_bytes).decode()

if __name__ == '__main__':
    # Initialize the DashVector client
    client = Client(
      api_key='{your-dashvector-api-key}',
      endpoint='{your-dashvector-cluster-endpoint}'
    )

    # Create a collection: Specify the collection name and vector dimensions. The CLIP Enormous model produces vectors with 1024 dimensions.
    rsp = client.create('muge_embedding', 1024)
    if not rsp:
        raise DashVectorException(rsp.code, reason=rsp.message)

    # Generate image embeddings in batches and store the vectors.
    collection = client.get('muge_embedding')
    pipe = pipeline(task=Tasks.multi_modal_embedding,
                    model='damo/multi-modal_clip-vit-huge-patch14_zh',
                    model_revision='v1.0.0')
    ds = MsDataset.load("muge", split="validation")

    BATCH_COUNT = 10
    TOTAL_DATA_NUM = len(ds)
    print(f"Start indexing Muge validation data. Total data size: {TOTAL_DATA_NUM}, Batch size: {BATCH_COUNT}")
    idx = 0
    while idx < TOTAL_DATA_NUM:
        batch_range = range(idx, idx + BATCH_COUNT) if idx + BATCH_COUNT <= TOTAL_DATA_NUM else range(idx, TOTAL_DATA_NUM)
        images = [ds[i]['image'] for i in batch_range]
        # Generate image embedding vectors with the Chinese CLIP model.
        image_embeddings = pipe.forward({'img': images})['img_embedding']
        image_vectors = image_embeddings.detach().cpu().numpy()
        collection.insert(
            [
                Doc(
                    id=str(img_id),
                    vector=img_vec,
                    fields={'png_img': image2str(img)}
                )
                for img_id, img_vec, img in zip(batch_range, image_vectors, images)
            ]
        )
        idx += BATCH_COUNT
    print("Finished indexing Muge validation data.")
Por padrão, o modelo roda na CPU. Para melhor desempenho, execute em uma GPU.
2. Recuperar dados com uma consulta de texto
Após armazenar os dados de imagem, converta uma consulta de texto em vetor com o mesmo modelo CLIP e recupere imagens semelhantes pela API do DashVector.
import torch
from modelscope.utils.constant import Tasks
from modelscope.pipelines import pipeline
from modelscope.msdatasets import MsDataset
from dashvector import Client, Doc, DashVectorException
from PIL import Image
import base64
import io

def str2image(image_str):
    image_bytes = base64.b64decode(image_str)
    return Image.open(io.BytesIO(image_bytes))

def multimodal_search(input_text):
    # Initialize the DashVector client
    client = Client(
      api_key='{your-dashvector-api-key}',
      endpoint='{your-dashvector-cluster-endpoint}'
    )

    # Get the collection that was previously stored.
    collection = client.get('muge_embedding')

    # Get the embedding vector for the text query.
    pipe = pipeline(task=Tasks.multi_modal_embedding,
                    model='damo/multi-modal_clip-vit-huge-patch14_zh', model_revision='v1.0.0')
    text_embedding = pipe.forward({'text': input_text})['text_embedding']  # 2D Tensor, [number of texts, feature dimensions]
    text_vector = text_embedding.detach().cpu().numpy()[0]

    # Retrieve vectors with DashVector.
    rsp = collection.query(text_vector, topk=3)
    image_list = list()
    for doc in rsp:
        image_str = doc.fields['png_img']
        image_list.append(str2image(image_str))
    return image_list

if __name__ == '__main__':
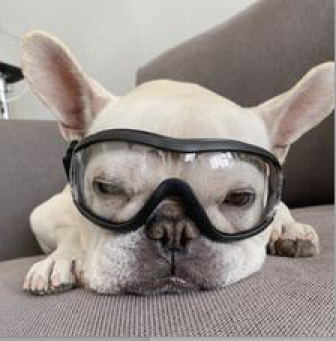
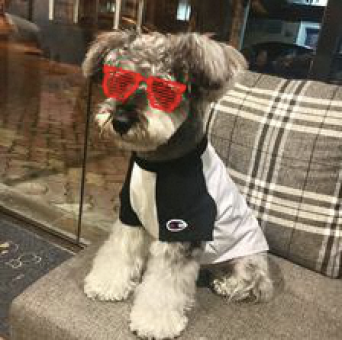
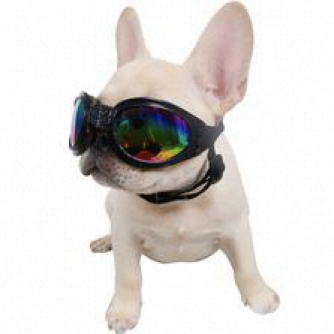
    text_query = "a dog wearing glasses"

    images = multimodal_search(text_query)
    for img in images:
        # Note: The show() function may require you to install necessary image browser components to work on a Linux server.
        # Run this code on a server that supports Jupyter Notebook.
        img.show()
Execute o código. A saída será semelhante à seguinte: