Este tópico descreve como usar o recurso de agregação do Table Store para análise de dados. Com ele, é possível: calcular métricas como valor mínimo, máximo, soma, média, contagem, contagem distinta e percentis; agrupar dados por valor de campo, intervalo, localização ou filtros; gerar histogramas e histogramas de data; recuperar linhas de cada grupo; e realizar consultas aninhadas. Também é possível combinar múltiplas funções de agregação para construir consultas complexas.
Procedimento
A figura a seguir ilustra o procedimento completo de agregação.
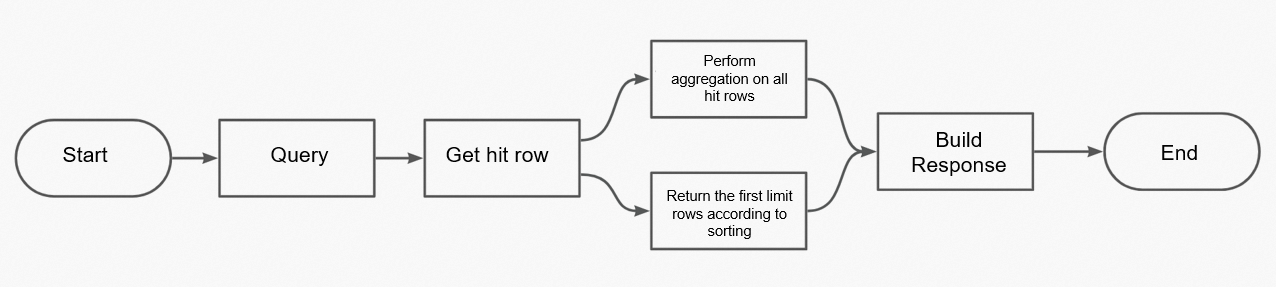
Após a conclusão de uma consulta, o servidor agrega todos os documentos correspondentes. Por isso, uma requisição que inclui agregação é mais complexa de processar do que uma sem agregação.
Recursos
A agregação oferece funções equivalentes a diversas funções SQL, incluindo MIN(), MAX(), SUM(), AVG(), COUNT(), COUNT(DISTINCT), ANY_VALUE() e GROUP BY. Também são suportados outros recursos, como estatísticas de percentil, agrupamento por valor de campo, agrupamento por múltiplos campos, agrupamento por intervalo, agrupamento por localização geográfica, agrupamento por filtro, agregação por histograma, agregação por histograma de data e sub-agregação. A tabela a seguir detalha esses recursos.
|
Recurso |
Descrição |
|
Valor mínimo |
Retorna o valor mínimo de um campo, de forma similar à função MIN do SQL. |
|
Valor máximo |
Retorna o valor máximo de um campo, de forma similar à função |
|
Soma |
Retorna a soma dos valores de um campo numérico, de forma similar à função sum do SQL. |
|
Valor médio |
Calcula a média de um campo numérico, de forma similar à função |
|
Contagem |
Retorna o número de valores de um campo especificado ou o total de linhas em um Search Index, de forma similar à função COUNT do SQL. |
|
Contagem distinta |
Retorna o número de valores distintos de um campo especificado, de forma similar à função COUNT(DISTINCT) do SQL. |
|
Estatísticas de percentil |
Analisa a distribuição percentual de um conjunto de dados. Por exemplo, durante operações rotineiras de O&M, é possível acompanhar a distribuição das latências de requisição verificando percentis como P25, P50, P90 e P99. |
|
Agrupamento por valor de campo |
Agrupa os resultados da consulta com base no valor de um campo especificado. Linhas com o mesmo valor formam um grupo. A operação retorna o valor de cada grupo e sua contagem de linhas. |
|
Sub-agregação |
As agregações de agrupamento suportam aninhamento, permitindo adicionar sub-agregações dentro de um grupo. |
|
Agrupamento por múltiplos campos |
Agrupa os resultados da consulta com base em múltiplos campos. Este recurso suporta paginação por meio de um token de paginação. |
|
Agrupamento por intervalo |
Agrupa os resultados da consulta em intervalos personalizados com base no valor de um campo, retornando a contagem de cada intervalo. |
|
Agrupamento por localização geográfica |
Agrupa os resultados da consulta pela distância a partir de uma origem. Itens dentro de um intervalo de distância especificado são colocados no mesmo grupo, e a operação retorna a contagem de cada intervalo. |
|
Agrupamento por filtro |
Agrupa os resultados da consulta com base em filtros especificados. Retorna a contagem de documentos que correspondem a cada filtro, na mesma ordem em que os filtros foram adicionados. |
|
Agregação por histograma |
Agrupa os resultados da consulta por um intervalo de dados especificado. Linhas cujos valores de campo estejam dentro do mesmo intervalo são colocadas no mesmo grupo. A operação retorna o valor inicial de cada grupo e sua contagem de linhas correspondente. |
|
Agregação por histograma de data |
Para um campo de data, agrupa as linhas em buckets de um intervalo de tempo especificado e retorna a contagem de linhas de cada bucket. |
|
Obter linhas do grupo de agregação |
Após agrupar os resultados da consulta, uma agregação top-rows recupera uma seleção de linhas de cada grupo. Este recurso é similar à função |
|
Múltiplas agregações |
É possível combinar múltiplas agregações em uma única consulta. Nota
Consultas complexas com múltiplas agregações podem afetar o tempo de resposta. |
APIs relacionadas
A operação de API para agregação é Search.
Pré-requisitos
É possível executar agregações pelo console do Tablestore, CLI ou um SDK.
O console do Tablestore e a CLI suportam apenas um subconjunto dos recursos de agregação.
-
Use uma conta Alibaba Cloud ou um usuário RAM com as permissões necessárias para operações no Table Store. Para conceder permissões a um usuário RAM, consulte Grant permissions to a RAM user by using a RAM policy.
Ao usar um SDK ou ferramenta de linha de comando, create an AccessKey para sua conta Alibaba Cloud ou usuário RAM, caso ainda não tenha.
Crie uma tabela de dados antes de prosseguir.
Um Search Index deve ter sido criado para a tabela de dados.
Ao usar um SDK, inicialize o Tablestore Client.
Ao usar a ferramenta de linha de comando, baixe-a e inicie-a, configure a conexão com sua instância e selecione a tabela de destino. Para mais informações, consulte Download the command-line tool, Start the tool and configure connection information e Data table operations.
Console
-
Acesse a aba Index Management.
Faça login no Table Store console.
Na barra de navegação superior, selecione um grupo de recursos e uma região.
Na página Overview, clique no nome da instância ou clique em Instance Management na coluna Actions.
Na aba Instance Details, na aba Data Table List, clique no nome da tabela de dados ou clique em Index Management na coluna Actions.
Na aba Index Management, localize o Search Index de destino e clique em Search na coluna Actions.
-
Na caixa de diálogo Search, especifique as condições de consulta.
-
Por padrão, todas as colunas são retornadas. Para retornar colunas específicas, desative Retrieve All Columns e insira os nomes das colunas, separados por vírgulas.
NotaPor padrão, o Table Store retorna as colunas de chave primária da tabela de dados.
-
Selecione um operador lógico: And, Or ou Not.
Ao selecionar And, a consulta retorna dados que atendem a todas as condições especificadas. Ao selecionar Or, a consulta retorna dados que atendem a pelo menos uma das condições. Ao selecionar Not, a consulta retorna dados que não atendem às condições especificadas.
-
Selecione um campo de índice, clique em Add e defina o tipo e o valor da consulta para o campo.
Repita esta etapa para adicionar condições de consulta para múltiplos campos de índice.
Por padrão, a ordenação está desativada. Para ordenar os resultados por um campo específico, ative Enable Sorting, adicione o campo de ordenação e configure a ordem.
-
Por padrão, o recurso de estatísticas está desativado. Para coletar estatísticas de campos específicos, ative o botão Collect Statistics, adicione os campos desejados e configure o tipo de estatística, o Item e o valor Default conforme necessário.
É possível adicionar múltiplos campos para estatísticas de uma vez. Os valores válidos para Statistics Type são Minimum, Maximum, Sum, Average, Count e Distinct count. O parâmetro Default especifica o valor a usar quando um campo não existe em uma linha.
-
-
Clique em OK.
A aba Indexes exibe os dados que correspondem à sua consulta e os resultados estatísticos.
CLI
Ao consultar dados com o comando search na CLI do Tablestore, também é possível realizar agregações. Os tipos de agregação suportados incluem mínimo (min), máximo (max), soma (sum), média (avg) e contagem (count). Para mais informações, consulte search index.
-
Execute o seguinte comando
searchpara consultar e analisar dados na tabela usando o search indexsearch_indexe retornar todas as colunas indexadas.search -n search_index --return_all_indexed -
Insira as condições de consulta conforme solicitado.
O exemplo a seguir mostra uma consulta que recupera linhas onde o valor da coluna
gidé menor que 10 ou igual a 77. A consulta também calcula o valor médio da colunagid.{ "Offset": -1, "Limit": 10, "Collapse": null, "Sort": null, "GetTotalCount": true, "Token": null, "Query": { "Name": "BoolQuery", "Query": { "MinimumShouldMatch": 1, "MustQueries": null, "MustNotQueries": null, "FilterQueries": null, "ShouldQueries": [{ "Name": "RangeQuery", "Query": { "FieldName": "gid", "From": null, "To": 10, "IncludeLower": false, "IncludeUpper": false } }, { "Name": "TermQuery", "Query": { "FieldName": "gid", "Term": 77 } }] } }, "Aggregations": [{ "Name": "avg", "Aggregation": { "AggName": "agg1", "Field": "gid", "MissingValue": null } }] }
Tablestore SDKs
É possível realizar agregações usando Tablestore SDK for Java, Tablestore SDK for Go, Tablestore SDK for Python, Tablestore SDK for Node.js, Tablestore SDK for .NET e Tablestore SDK for PHP. O exemplo neste tópico usa o Tablestore SDK for Java.
O recurso de agregação suporta os tipos de campo definidos para um search index. Para mais informações sobre esses tipos e como são mapeados a partir dos tipos de campo da tabela de dados, consulte Data types.
Minimum value
Retorna o valor mínimo de um campo, de forma similar à função MIN do SQL.
-
Parâmetros
Parâmetro
Descrição
aggregationName
O nome exclusivo da operação de agregação. Use este nome para consultar os resultados de uma operação de agregação específica.
fieldName
O nome do campo usado na operação de agregação. Apenas os tipos Long, Double e Date são suportados.
missing
O valor padrão do campo sobre o qual a operação de agregação é realizada, aplicado às linhas em que o valor do campo está vazio.
-
Se nenhum valor for especificado para o parâmetro missing, a linha será ignorada.
-
Se um valor for especificado para o parâmetro missing, esse valor será usado como o valor do campo na linha.
-
-
Exemplos
/**
 * The price of each product is listed in the product table. Query the minimum price of the products that are produced in Zhejiang.
 * SQL statement: SELECT min(column_price) FROM product where place_of_production="Zhejiang".
 */
public void min(SyncClient client) {
    //Use builder to create a query statement.
    {
        SearchRequest searchRequest = SearchRequest.newBuilder()
                .tableName("<TABLE_NAME>")
                .indexName("<SEARCH_INDEX_NAME>")
                .searchQuery(
                        SearchQuery.newBuilder()
                                .query(QueryBuilders.term("place_of_production", "Zhejiang"))
                                .limit(0) //If you want to obtain only the aggregation results instead of specific data, set limit to 0 to improve query performance.
                                .addAggregation(AggregationBuilders.min("min_agg_1", "column_price").missing(100))
                                .build())
                .build();
        //Execute the query statement.
        SearchResponse resp = client.search(searchRequest);
        //Obtain the aggregation results.
        System.out.println(resp.getAggregationResults().getAsMinAggregationResult("min_agg_1").getValue());
    }

    //Create a query statement without using builder.
    {
        SearchRequest searchRequest = new SearchRequest();
        searchRequest.setTableName("<TABLE_NAME>");
        searchRequest.setIndexName("<SEARCH_INDEX_NAME>");

        SearchQuery searchQuery = new SearchQuery();
        TermQuery query = new TermQuery();
        query.setTerm(ColumnValue.fromString("Zhejiang"));
        query.setFieldName("place_of_production");
        //In the following comment, builder is used to create a query statement. The method that uses builder to create a query statement has the same effect as the method that uses TermQuery to create a query statement.
        // Query query2 = QueryBuilders.term("place_of_production", "Zhejiang").build();

        searchQuery.setQuery(query);
        searchQuery.setLimit(0);

        MinAggregation aggregation = new MinAggregation();
        aggregation.setAggName("min_agg_1");
        aggregation.setFieldName("column_price");
        aggregation.setMissing(ColumnValue.fromLong(100));
        //In the following comment, builder is used to create a query statement. The method that uses builder to create a query statement has the same effect as the method that uses aggregation to create a query statement.
        // MinAggregation aggregation2 = AggregationBuilders.min("min_agg_1", "column_price").missing(100).build();
        List<Aggregation> aggregationList = new ArrayList<Aggregation>();
        aggregationList.add(aggregation);
        searchQuery.setAggregationList(aggregationList);

        //Execute the query statement.
        SearchResponse resp = client.search(searchRequest);
        //Obtain the aggregation results.
        System.out.println(resp.getAggregationResults().getAsMinAggregationResult("min_agg_1").getValue());
    }
}
Max
Retorna o valor máximo de um campo, de forma similar à função max do SQL.
-
Parâmetros
Parâmetro
Descrição
aggregationName
O nome exclusivo da operação de agregação. Use este nome para consultar os resultados de uma operação de agregação específica.
fieldName
O nome do campo usado na operação de agregação. Apenas os tipos Long, Double e Date são suportados.
missing
O valor padrão do campo sobre o qual a operação de agregação é realizada, aplicado às linhas em que o valor do campo está vazio.
-
Se nenhum valor for especificado para o parâmetro missing, a linha será ignorada.
-
Se um valor for especificado para o parâmetro missing, esse valor será usado como o valor do campo na linha.
-
-
Exemplos
/**
 * The price of each product is listed in the product table. Query the maximum price of the products that are produced in Zhejiang.
 * SQL statement: SELECT max(column_price) FROM product where place_of_production="Zhejiang".
 */
public void max(SyncClient client) {
    //Use builder to create a query statement.
    {
        SearchRequest searchRequest = SearchRequest.newBuilder()
                .tableName("<TABLE_NAME>")
                .indexName("<SEARCH_INDEX_NAME>")
                .searchQuery(
                        SearchQuery.newBuilder()
                                .query(QueryBuilders.term("place_of_production", "Zhejiang"))
                                .limit(0) //If you want to obtain only the aggregation results instead of specific data, set limit to 0 to improve query performance.
                                .addAggregation(AggregationBuilders.max("max_agg_1", "column_price").missing(0))
                                .build())
                .build();
        //Execute the query statement.
        SearchResponse resp = client.search(searchRequest);
        //Obtain the aggregation results.
        System.out.println(resp.getAggregationResults().getAsMaxAggregationResult("max_agg_1").getValue());
    }

    //Create a query statement without using builder.
    {
        SearchRequest searchRequest = new SearchRequest();
        searchRequest.setTableName("<TABLE_NAME>");
        searchRequest.setIndexName("<SEARCH_INDEX_NAME>");

        SearchQuery searchQuery = new SearchQuery();
        TermQuery query = new TermQuery();
        query.setTerm(ColumnValue.fromString("Zhejiang"));
        query.setFieldName("place_of_production");
        //In the following comment, builder is used to create a query statement. The method that uses builder to create a query statement has the same effect as the method that uses TermQuery to create a query statement.
        // Query query2 = QueryBuilders.term("place_of_production", "Zhejiang").build();

        searchQuery.setQuery(query);
        searchQuery.setLimit(0);

        MaxAggregation aggregation = new MaxAggregation();
        aggregation.setAggName("max_agg_1");
        aggregation.setFieldName("column_price");
        aggregation.setMissing(ColumnValue.fromLong(100));
        //In the following comment, builder is used to create a query statement. The method that uses builder to create a query statement has the same effect as the method that uses aggregation to create a query statement.
        // MaxAggregation aggregation2 = AggregationBuilders.max("max_agg_1", "column_price").missing(100).build();
        List<Aggregation> aggregationList = new ArrayList<Aggregation>();
        aggregationList.add(aggregation);
        searchQuery.setAggregationList(aggregationList);

        //Execute the query statement.
        SearchResponse resp = client.search(searchRequest);
        //Obtain the aggregation results.
        System.out.println(resp.getAggregationResults().getAsMaxAggregationResult("max_agg_1").getValue());
    }
}
Sum
Retorna a soma dos valores de um campo numérico, de forma similar à função sum do SQL.
-
Parâmetros
Parâmetro
Descrição
aggregationName
O nome exclusivo da operação de agregação. Use este nome para consultar os resultados de uma operação de agregação específica.
fieldName
O nome do campo usado na operação de agregação. Apenas os tipos Long e Double são suportados.
missing
O valor padrão do campo sobre o qual a operação de agregação é realizada, aplicado às linhas em que o valor do campo está vazio.
-
Se nenhum valor for especificado para o parâmetro missing, a linha será ignorada.
-
Se um valor for especificado para o parâmetro missing, esse valor será usado como o valor do campo na linha.
-
-
Exemplos
/**
 * The price of each product is listed in the product table. Query the maximum price of the products that are produced in Zhejiang.
 * SQL statement: SELECT sum(column_price) FROM product where place_of_production="Zhejiang".
 */
public void sum(SyncClient client) {
    //Use builder to create a query statement.
    {
        SearchRequest searchRequest = SearchRequest.newBuilder()
                .tableName("<TABLE_NAME>")
                .indexName("<SEARCH_INDEX_NAME>")
                .searchQuery(
                        SearchQuery.newBuilder()
                                .query(QueryBuilders.term("place_of_production", "Zhejiang"))
                                .limit(0) //If you want to obtain only the aggregation results instead of specific data, set limit to 0 to improve query performance.
                                .addAggregation(AggregationBuilders.sum("sum_agg_1", "column_number").missing(10))
                                .build())
                .build();
        //Execute the query statement.
        SearchResponse resp = client.search(searchRequest);
        //Obtain the aggregation results.
        System.out.println(resp.getAggregationResults().getAsSumAggregationResult("sum_agg_1").getValue());
    }

    // Create a query statement without using builder.
    {
        SearchRequest searchRequest = new SearchRequest();
        searchRequest.setTableName("<TABLE_NAME>");
        searchRequest.setIndexName("<SEARCH_INDEX_NAME>");

        SearchQuery searchQuery = new SearchQuery();
        TermQuery query = new TermQuery();
        query.setTerm(ColumnValue.fromString("Zhejiang"));
        query.setFieldName("place_of_production");
        //In the following comment, builder is used to create a query statement. The method that uses builder to create a query statement has the same effect as the method that uses TermQuery to create a query statement.
        // Query query2 = QueryBuilders.term("place_of_production", "Zhejiang").build();

        searchQuery.setQuery(query);
        searchQuery.setLimit(0);

        SumAggregation aggregation = new SumAggregation();
        aggregation.setAggName("sum_agg_1");
        aggregation.setFieldName("column_number");
        aggregation.setMissing(ColumnValue.fromLong(100));
        //In the following comment, builder is used to create a query statement. The method that uses builder to create a query statement has the same effect as the method that uses aggregation to create a query statement.
        // SumAggregation aggregation2 = AggregationBuilders.sum("sum_agg_1", "column_number").missing(10).build();
        List<Aggregation> aggregationList = new ArrayList<Aggregation>();
        aggregationList.add(aggregation);
        searchQuery.setAggregationList(aggregationList);

        //Execute the query statement.
        SearchResponse resp = client.search(searchRequest);
        //Obtain the aggregation results.
        System.out.println(resp.getAggregationResults().getAsSumAggregationResult("sum_agg_1").getValue());
    }
}
Average
Calcula a média de um campo numérico, de forma similar à função avg do SQL.
-
Parâmetros
Parâmetro
Descrição
aggregationName
O nome exclusivo da operação de agregação. Use este nome para consultar os resultados de uma operação de agregação específica.
fieldName
O nome do campo usado na operação de agregação. Apenas os tipos Long, Double e Date são suportados.
missing
O valor padrão do campo sobre o qual a operação de agregação é realizada, aplicado às linhas em que o valor do campo está vazio.
-
Se nenhum valor for especificado para o parâmetro missing, a linha será ignorada.
-
Se um valor for especificado para o parâmetro missing, esse valor será usado como o valor do campo na linha.
-
-
Exemplos
/**
 * The sales of each product are listed in the product table. Query the average price of the products that are produced in Zhejiang.
 * SQL statement: SELECT avg(column_price) FROM product where place_of_production="Zhejiang".
 */
public void avg(SyncClient client) {
    //Use builder to create a query statement.
    {
        SearchRequest searchRequest = SearchRequest.newBuilder()
                .tableName("<TABLE_NAME>")
                .indexName("<SEARCH_INDEX_NAME>")
                .searchQuery(
                        SearchQuery.newBuilder()
                                .query(QueryBuilders.term("place_of_production", "Zhejiang"))
                                .limit(0) //If you want to obtain only the aggregation results instead of specific data, set limit to 0 to improve query performance.
                                .addAggregation(AggregationBuilders.avg("avg_agg_1", "column_price"))
                                .build())
                .build();
        //Execute the query statement.
        SearchResponse resp = client.search(searchRequest);
        //Obtain the aggregation results.
        System.out.println(resp.getAggregationResults().getAsAvgAggregationResult("avg_agg_1").getValue());
    }

    //Create a query statement without using builder.
    {
        SearchRequest searchRequest = new SearchRequest();
        searchRequest.setTableName("<TABLE_NAME>");
        searchRequest.setIndexName("<SEARCH_INDEX_NAME>");

        SearchQuery searchQuery = new SearchQuery();
        TermQuery query = new TermQuery();
        query.setTerm(ColumnValue.fromString("Zhejiang"));
        query.setFieldName("place_of_production");
        //In the following comment, builder is used to create a query statement. The method that uses builder to create a query statement has the same effect as the method that uses TermQuery to create a query statement.
        // Query query2 = QueryBuilders.term("place_of_production", "Zhejiang").build();

        searchQuery.setQuery(query);
        searchQuery.setLimit(0);

        AvgAggregation aggregation = new AvgAggregation();
        aggregation.setAggName("avg_agg_1");
        aggregation.setFieldName("column_price");
        //In the following comment, builder is used to create a query statement. The method that uses builder to create a query statement has the same effect as the method that uses aggregation to create a query statement.
        // AvgAggregation aggregation2 = AggregationBuilders.avg("avg_agg_1", "column_price").build();
        List<Aggregation> aggregationList = new ArrayList<Aggregation>();
        aggregationList.add(aggregation);
        searchQuery.setAggregationList(aggregationList);

        //Execute the query statement.
        SearchResponse resp = client.search(searchRequest);
        //Obtain the aggregation results.
        System.out.println(resp.getAggregationResults().getAsAvgAggregationResult("avg_agg_1").getValue());
    }
}
Count
Conta o número de valores em um campo especificado ou o total de linhas em um search index, de forma similar à função count do SQL.
Use os seguintes métodos para consultar o total de linhas em um search index ou o total de linhas que atendem às condições de consulta:
Use o recurso count da agregação. Defina o parâmetro count como * na requisição.
Use o recurso de consulta para obter o número de linhas que atendem às condições. Defina o parâmetro setGetTotalCount como true na consulta. Use MatchAllQuery para obter o total de linhas em um search index.
Use o nome de uma coluna como valor da expressão count para consultar o número de linhas que contêm a coluna em um search index. Esse método é adequado para cenários com colunas esparsas.
-
Parâmetros
Parâmetro
Descrição
aggregationName
O nome exclusivo da operação de agregação. Use este nome para consultar os resultados de uma operação de agregação específica.
fieldName
O nome do campo usado na operação de agregação. Os seguintes tipos são suportados: Long, Double, Boolean, Keyword, Geo_point e Date.
-
Exemplos
/**
 * Penalty records of merchants are recorded in the merchant table. You can query the number of merchants who are located in Zhejiang and for whom penalty records exist. If no penalty record exists for a merchant, the field that corresponds to penalty records also does not exist for the merchant.
 * SQL statement: SELECT count(column_history) FROM product where place_of_production="Zhejiang".
 */
public void count(SyncClient client) {
    //Use builder to create a query statement.
    {
        SearchRequest searchRequest = SearchRequest.newBuilder()
                .tableName("<TABLE_NAME>")
                .indexName("<SEARCH_INDEX_NAME>")
                .searchQuery(
                        SearchQuery.newBuilder()
                                .query(QueryBuilders.term("place_of_production", "Zhejiang"))
                                .limit(0) //If you want to obtain only the aggregation results instead of specific data, set limit to 0 to improve query performance.
                                .addAggregation(AggregationBuilders.count("count_agg_1", "column_history"))
                                .build())
                .build();
        //Execute the query statement.
        SearchResponse resp = client.search(searchRequest);
        //Obtain the aggregation results.
        System.out.println(resp.getAggregationResults().getAsCountAggregationResult("count_agg_1").getValue());
    }

    //Create a query statement without using builder.
    {
        SearchRequest searchRequest = new SearchRequest();
        searchRequest.setTableName("<TABLE_NAME>");
        searchRequest.setIndexName("<SEARCH_INDEX_NAME>");

        SearchQuery searchQuery = new SearchQuery();
        TermQuery query = new TermQuery();
        query.setTerm(ColumnValue.fromString("Zhejiang"));
        query.setFieldName("place_of_production");
        //In the following comment, builder is used to create a query statement. The method that uses builder to create a query statement has the same effect as the method that uses TermQuery to create a query statement.
        // Query query2 = QueryBuilders.term("place_of_production", "Zhejiang").build();

        searchQuery.setQuery(query);
        searchQuery.setLimit(0);

        CountAggregation aggregation = new CountAggregation();
        aggregation.setAggName("count_agg_1");
        aggregation.setFieldName("column_history");
        //In the following comment, builder is used to create a query statement. The method that uses builder to create a query statement has the same effect as the method that uses aggregation to create a query statement.
        // CountAggregation aggregation2 = AggregationBuilders.count("count_agg_1", "column_history").build();
        List<Aggregation> aggregationList = new ArrayList<Aggregation>();
        aggregationList.add(aggregation);
        searchQuery.setAggregationList(aggregationList);

        //Execute the query statement.
        SearchResponse resp = client.search(searchRequest);
        //Obtain the aggregation results.
        System.out.println(resp.getAggregationResults().getAsCountAggregationResult("count_agg_1").getValue());
    }
}
Distinct count
Retorna o número de valores distintos de um campo especificado, de forma similar à função count(distinct) do SQL.
O número de valores distintos é um valor aproximado.
Se o total de linhas antes do uso do recurso de contagem distinta for menor que 10.000, o resultado calculado será próximo do valor exato.
Se o total de linhas for maior ou igual a 100 milhões, a margem de erro é de aproximadamente 2%.
-
Parâmetros
Parâmetro
Descrição
aggregationName
O nome exclusivo da operação de agregação. Use este nome para consultar os resultados de uma operação de agregação específica.
fieldName
O nome do campo usado na operação de agregação. Os seguintes tipos são suportados: Long, Double, Boolean, Keyword, Geo_point e Date.
missing
O valor padrão do campo sobre o qual a operação de agregação é realizada, aplicado às linhas em que o valor do campo está vazio.
-
Se nenhum valor for especificado para o parâmetro missing, a linha será ignorada.
-
Se um valor for especificado para o parâmetro missing, esse valor será usado como o valor do campo na linha.
-
-
Exemplos
/**
 * Query the number of distinct provinces from which the products are produced.
 * SQL statement: SELECT count(distinct column_place) FROM product.
 */
public void distinctCount(SyncClient client) {
    //Use builder to create a query statement.
    {
        SearchRequest searchRequest = SearchRequest.newBuilder()
                .tableName("<TABLE_NAME>")
                .indexName("<SEARCH_INDEX_NAME>")
                .searchQuery(
                        SearchQuery.newBuilder()
                                .query(QueryBuilders.matchAll())
                                .limit(0) //If you want to obtain only the aggregation results instead of specific data, set limit to 0 to improve query performance.
                                .addAggregation(AggregationBuilders.distinctCount("dis_count_agg_1", "column_place"))
                                .build())
                .build();
        //Execute the query statement.
        SearchResponse resp = client.search(searchRequest);
        //Obtain the aggregation results.
        System.out.println(resp.getAggregationResults().getAsDistinctCountAggregationResult("dis_count_agg_1").getValue());
    }

    //Create a query statement without using builder.
    {
        SearchRequest searchRequest = new SearchRequest();
        searchRequest.setTableName("<TABLE_NAME>");
        searchRequest.setIndexName("<SEARCH_INDEX_NAME>");

        SearchQuery searchQuery = new SearchQuery();
        MatchAllQuery query = new MatchAllQuery();
        //In the following comment, builder is used to create a query statement. The method that uses builder to create a query statement has the same effect as the method that uses TermQuery to create a query statement.
        // Query query2 = QueryBuilders.matchAll().build();

        searchQuery.setQuery(query);
        searchQuery.setLimit(0);

        DistinctCountAggregation aggregation = new DistinctCountAggregation();
        aggregation.setAggName("dis_count_agg_1");
        aggregation.setFieldName("column_place");
        //In the following comment, builder is used to create a query statement. The method that uses builder to create a query statement has the same effect as the method that uses aggregation to create a query statement.
        // DistinctCountAggregation aggregation2 = AggregationBuilders.distinctCount("dis_count_agg_1", "column_place").build();
        List<Aggregation> aggregationList = new ArrayList<Aggregation>();
        aggregationList.add(aggregation);
        searchQuery.setAggregationList(aggregationList);

        //Execute the query statement.
        SearchResponse resp = client.search(searchRequest);
        //Obtain the aggregation results.
        System.out.println(resp.getAggregationResults().getAsDistinctCountAggregationResult("dis_count_agg_1").getValue());
    }
}
Percentile statistics
Analisa a distribuição percentual de um conjunto de dados. Por exemplo, durante operações rotineiras de O&M, é possível acompanhar a distribuição das latências de requisição verificando percentis como P25, P50, P90 e P99.
Para melhorar a precisão dos resultados, recomenda-se especificar valores de percentil extremos, como p1 e p99. O uso de valores extremos em vez de outros, como p50, produz resultados mais precisos.
-
Parâmetros
Parâmetro
Descrição
aggregationName
O nome exclusivo da operação de agregação. Use este nome para consultar os resultados de uma operação de agregação específica.
fieldName
O nome do campo usado na operação de agregação. Apenas os tipos Long, Double e Date são suportados.
percentiles
Os percentis, como p50, p90 e p99. É possível especificar um ou mais percentis.
missing
O valor padrão do campo sobre o qual a operação de agregação é realizada, aplicado às linhas em que o valor do campo está vazio.
-
Se nenhum valor for especificado para o parâmetro missing, a linha será ignorada.
-
Se um valor for especificado para o parâmetro missing, esse valor será usado como o valor do campo na linha.
-
-
Exemplos
/**
 * Analyze the distribution of the response time of each request that is sent to the system by using percentiles.
 */
public void percentilesAgg(SyncClient client) {
    //Use builder to create a query statement.
    {
        SearchRequest searchRequest = SearchRequest.newBuilder()
                .tableName("<TABLE_NAME>")
                .indexName("indexName")
                .searchQuery(
                        SearchQuery.newBuilder()
                                .query(QueryBuilders.matchAll())
                                .limit(0) //If you want to obtain only the aggregation results instead of specific data, set limit to 0 to improve query performance.
                                .addAggregation(AggregationBuilders.percentiles("percentilesAgg", "latency")
                                        .percentiles(Arrays.asList(25.0d, 50.0d, 99.0d))
                                        .missing(1.0))
                                .build())
                .build();
        //Execute the query statement.
        SearchResponse resp = client.search(searchRequest);
        //Obtain the results.
        PercentilesAggregationResult percentilesAggregationResult = resp.getAggregationResults().getAsPercentilesAggregationResult("percentilesAgg");
        for (PercentilesAggregationItem item : percentilesAggregationResult.getPercentilesAggregationItems()) {
            System.out.println("key:" + item.getKey() + " value:" + item.getValue().asDouble());
        }
    }

    //Create a query statement without using builder.
    {
        SearchRequest searchRequest = new SearchRequest();
        searchRequest.setTableName("<TABLE_NAME>");
        searchRequest.setIndexName("<SEARCH_INDEX_NAME>");

        SearchQuery searchQuery = new SearchQuery();
        MatchAllQuery query = new MatchAllQuery();
        //In the following comment, builder is used to create a query statement. The method that uses builder to create a query statement has the same effect as the method that uses TermQuery to create a query statement.
        // Query query2 = QueryBuilders.matchAll().build();

        searchQuery.setQuery(query);
        searchQuery.setLimit(0);

        PercentilesAggregation aggregation = new PercentilesAggregation();
        aggregation.setAggName("percentilesAgg");
        aggregation.setFieldName("latency");
        aggregation.setPercentiles(Arrays.asList(25.0d, 50.0d, 99.0d));
        //In the following comment, builder is used to create a query statement. The method that uses builder to create a query statement has the same effect as the method that uses aggregation to create a query statement.
        // AggregationBuilders.percentiles("percentilesAgg", "latency").percentiles(Arrays.asList(25.0d, 50.0d, 99.0d)).missing(1.0).build();
        List<Aggregation> aggregationList = new ArrayList<Aggregation>();
        aggregationList.add(aggregation);
        searchQuery.setAggregationList(aggregationList);

        //Execute the query statement.
        SearchResponse resp = client.search(searchRequest);
        //Obtain the results.
        PercentilesAggregationResult percentilesAggregationResult = resp.getAggregationResults().getAsPercentilesAggregationResult("percentilesAgg");
        for (PercentilesAggregationItem item : percentilesAggregationResult.getPercentilesAggregationItems()) {
            System.out.println("key:" + item.getKey() + " value:" + item.getValue().asDouble());
        }
    }
}
Group by field value
Agrupa os resultados da consulta com base no valor de um campo especificado. Linhas com o mesmo valor de campo formam um grupo. A operação retorna o valor de cada grupo e sua contagem de linhas.
O agrupamento por valor de campo utiliza computação paralela. Por ser um método estatístico inexato, os resultados podem conter pequenos erros.
Para agrupamento por múltiplos campos, use nested grouping ou multi-field grouping. Para uma comparação entre os dois métodos, consulte Appendix: Comparison of different implementations for multi-field grouping.
-
Parâmetros
Parâmetro
Descrição
groupByName
O nome exclusivo da operação de agregação. Use este nome para consultar os resultados de uma operação de agregação específica.
fieldName
O nome do campo usado na operação de agregação. Apenas os tipos Long, Double, Boolean, Keyword e Date são suportados.
groupBySorter
As regras de ordenação dos grupos. Por padrão, os grupos são ordenados pelo número de itens em ordem decrescente. Ao configurar múltiplas regras, os grupos são ordenados na sequência em que as regras foram definidas. As seguintes regras de ordenação são suportadas:
-
groupKeySortInAsc: ordena por valor em ordem alfabética.
-
groupKeySortInDesc: ordena por valor em ordem alfabética inversa.
-
rowCountSortInAsc: ordena pela contagem de linhas em ordem crescente.
-
rowCountSortInDesc (padrão): ordena pela contagem de linhas em ordem decrescente.
-
subAggSortInAsc: ordena pelos valores obtidos dos resultados de sub-agregação em ordem crescente.
-
subAggSortInDesc: ordena pelos valores obtidos dos resultados de sub-agregação em ordem decrescente.
size
O número de grupos a retornar. Valor padrão: 10. Valor máximo: 2000.
subAggregations
As operações de sub-agregação que podem ser realizadas nos dados de cada grupo, como calcular o valor máximo, a soma ou a média.
subGroupBys
As operações de sub-agrupamento que podem ser realizadas nos dados de cada grupo pai para agrupamentos adicionais.
-
-
Exemplos
Group by single field
/**
 * Query the number of products, and the maximum and minimum product prices in each category.
 * Example of returned results: Fruits: 5. The maximum price is USD 2, and the minimum price is USD 0.5. Toiletries: 10. The maximum price is USD 13, and the minimum price is USD 0.1. Electronic devices: 3. The maximum price is USD 1,160, and the minimum price is USD 310. Other products: 15. The maximum price is USD 130, and the minimum price is USD 11.
 */
public void groupByField(SyncClient client) {
    //Use builder to create a query statement.
    {
        SearchRequest searchRequest = SearchRequest.newBuilder()
                .tableName("<TABLE_NAME>")
                .indexName("<SEARCH_INDEX_NAME>")
                .searchQuery(
                        SearchQuery.newBuilder()
                                .query(QueryBuilders.matchAll())
                                .limit(0)  //If you want to obtain only the aggregation results instead of specific data, set limit to 0 to improve query performance.
                                .addGroupBy(GroupByBuilders
                                        .groupByField("name1", "column_type")
                                        .addSubAggregation(AggregationBuilders.min("subName1", "column_price"))
                                        .addSubAggregation(AggregationBuilders.max("subName2", "column_price"))
                                )
                                .build())
                .build();
        //Execute the query statement.
        SearchResponse resp = client.search(searchRequest);
        //Obtain the aggregation results.
        for (GroupByFieldResultItem item : resp.getGroupByResults().getAsGroupByFieldResult("name1").getGroupByFieldResultItems()) {
            //Display values.
            System.out.println(item.getKey());
            //Display the number of rows.
            System.out.println(item.getRowCount());
            //Display the minimum prices.
            System.out.println(item.getSubAggregationResults().getAsMinAggregationResult("subName1").getValue());
            //Display the maximum prices.
            System.out.println(item.getSubAggregationResults().getAsMaxAggregationResult("subName2").getValue());
        }
    }

    //Create a query statement without using builder.
    {
        SearchRequest searchRequest = new SearchRequest();
        searchRequest.setTableName("<TABLE_NAME>");
        searchRequest.setIndexName("<SEARCH_INDEX_NAME>");

        SearchQuery searchQuery = new SearchQuery();
        MatchAllQuery query = new MatchAllQuery();
        //In the following comment, builder is used to create a query statement. The method that uses builder to create a query statement has the same effect as the method that uses TermQuery to create a query statement.
        // Query query2 = QueryBuilders.matchAll().build();

        searchQuery.setQuery(query);
        searchQuery.setLimit(0);

        GroupByField groupByField = new GroupByField();
        groupByField.setGroupByName("name1");
        groupByField.setFieldName("column_type");
        //Configure sub-aggregation operations.
        MinAggregation minAggregation = AggregationBuilders.min("subName1", "column_price").build();
        MaxAggregation maxAggregation = AggregationBuilders.max("subName2", "column_price").build();
        groupByField.setSubAggregations(Arrays.asList(minAggregation, maxAggregation));

        //In the following comment, builder is used to create a query statement. The method that uses builder to create a query statement has the same effect as the method that uses aggregation to create a query statement.
        // GroupByBuilders.groupByField("name1", "column_type")
        //        .addSubAggregation(AggregationBuilders.min("subName1", "column_price"))
        //        .addSubAggregation(AggregationBuilders.max("subName2", "column_price").build());
        List<GroupBy> groupByList = new ArrayList<GroupBy>();
        groupByList.add(groupByField);
        searchQuery.setGroupByList(groupByList);
        searchRequest.setSearchQuery(searchQuery);

        //Execute the query statement.
        SearchResponse resp = client.search(searchRequest);
        //Obtain the aggregation results.
        for (GroupByFieldResultItem item : resp.getGroupByResults().getAsGroupByFieldResult("name1").getGroupByFieldResultItems()) {
            //Display values.
            System.out.println(item.getKey());
            //Display the number of rows.
            System.out.println(item.getRowCount());
            //Display the minimum prices.
            System.out.println(item.getSubAggregationResults().getAsMinAggregationResult("subName1").getValue());
            //Display the maximum prices.
            System.out.println(item.getSubAggregationResults().getAsMaxAggregationResult("subName2").getValue());
        }
    }
}
Group by multiple fields in nested mode
/**
 * Example of grouping query results by multiple fields in nested mode.
 * In a search index, use two groupBy fields in nested mode to achieve the same effect as using multiple groupBy fields in an SQL statement.
 * SQL statement: select a,d, sum(b),sum(c) from user group by a,d.
 */
public void GroupByMultiField(SyncClient client) {
    SearchRequest searchRequest = SearchRequest.newBuilder()
        .tableName("<TABLE_NAME>")
        .indexName("<SEARCH_INDEX_NAME>")
        .returnAllColumns(true)   //Set returnAllColumns to false and specify a value for addColumesToGet to obtain better query performance.
        //.addColumnsToGet("col_1","col_2")
        .searchQuery(SearchQuery.newBuilder()
            .query(QueryBuilders.matchAll())   //Specify query conditions. Query conditions can be used in the same manner as the WHERE clause in SQL. Use QueryBuilders.bool() to perform nested queries.
            .addGroupBy(
                GroupByBuilders
                    .groupByField("unique name_1", "field_a")
                    .size(20)
                    .addSubGroupBy(
                        GroupByBuilders
                            .groupByField("unique name_2", "field_d")
                            .size(20)
                            .addSubAggregation(AggregationBuilders.sum("unique name_3", "field_b"))
                            .addSubAggregation(AggregationBuilders.sum("unique name_4", "field_c"))
                    )
            )
            .build())
        .build();
    SearchResponse response = client.search(searchRequest);
    //Query rows that meet the specified conditions.
    List<Row> rows = response.getRows();
    //Obtain the aggregation results.
    GroupByFieldResult groupByFieldResult1 = response.getGroupByResults().getAsGroupByFieldResult("unique name_1");
    for (GroupByFieldResultItem resultItem : groupByFieldResult1.getGroupByFieldResultItems()) {
        System.out.println("field_a key:" + resultItem.getKey() + " Count:" + resultItem.getRowCount());
        //Obtain the sub-aggregation results.
        GroupByFieldResult subGroupByResult = resultItem.getSubGroupByResults().getAsGroupByFieldResult("unique name_2");
        for (GroupByFieldResultItem item : subGroupByResult.getGroupByFieldResultItems()) {
            System.out.println("field_a " + resultItem.getKey() + " field_d key:" + item.getKey() + " Count: " + item.getRowCount());
            double sumOf_field_b = item.getSubAggregationResults().getAsSumAggregationResult("unique name_3").getValue();
            double sumOf_field_c = item.getSubAggregationResults().getAsSumAggregationResult("unique name_4").getValue();
            System.out.println("sumOf_field_b:" + sumOf_field_b);
            System.out.println("sumOf_field_c:" + sumOf_field_c);
        }
    }
}
Sort groups for aggregation
/**
 * Example of configuring sorting rules for aggregation.
 * Method: Configure sorting rules by specifying GroupBySorter. If you configure multiple sorting rules, the groups are sorted based on the order in which the rules are configured. GroupBySorter supports sorting in ascending or descending order.
 * By default, the groups are sorted by row count in descending order (GroupBySorter.rowCountSortInDesc()).
 */
public void groupByFieldWithSort(SyncClient client) {
    //Create a query statement.
    SearchRequest searchRequest = SearchRequest.newBuilder()
        .tableName("<TABLE_NAME>")
        .indexName("<SEARCH_INDEX_NAME>")
        .searchQuery(
            SearchQuery.newBuilder()
                .query(QueryBuilders.matchAll())
                .limit(0)
                .addGroupBy(GroupByBuilders
                    .groupByField("name1", "column_type")
                    //.addGroupBySorter(GroupBySorter.subAggSortInAsc("subName1")) //Sort the groups in ascending order based on the values that are obtained from sub-aggregation results.
                    .addGroupBySorter(GroupBySorter.groupKeySortInAsc())           //Sort the groups in ascending order based on the values that are obtained from aggregation results.
                    //.addGroupBySorter(GroupBySorter.rowCountSortInDesc())        //Sort the groups in descending order based on the number of rows that are obtained from the aggregation results in each group.
                    .size(20)
                    .addSubAggregation(AggregationBuilders.min("subName1", "column_price"))
                    .addSubAggregation(AggregationBuilders.max("subName2", "column_price"))
                )
                .build())
        .build();
    //Execute the query statement.
    SearchResponse resp = client.search(searchRequest);
}
Nested grouping
As agregações de agrupamento suportam aninhamento, permitindo adicionar sub-agregações dentro de um grupo.
Para equilibrar desempenho e complexidade, a profundidade máxima de aninhamento é limitada. Para mais informações, consulte Search Index limits.
-
Cenários comuns
-
Agrupamento em múltiplos níveis (GroupBy + SubGroupBy)
Após agrupar os dados no primeiro nível, aplique um segundo nível de agrupamento. Por exemplo, agrupe primeiro por província e depois por cidade para obter os dados de cada cidade em cada província.
-
Agrupamento seguido de agregação (GroupBy + SubAggregation)
Após agrupar os dados no primeiro nível, realize operações de agregação (como calcular o valor máximo ou a média) nos dados de cada grupo. Por exemplo, após agrupar por província, obtenha o valor máximo de uma métrica específica para cada grupo provincial.
-
-
Exemplos
O exemplo a seguir mostra como realizar agrupamento aninhado por província e cidade, calculando o total de pedidos de cada província e o total de pedidos e o valor máximo de pedido de cada cidade.
public static void subGroupBy(SyncClient client) {
    //Create a query statement.
    SearchRequest searchRequest = SearchRequest.newBuilder()
            .tableName("<TABLE_NAME>")
            .indexName("<SEARCH_INDEX_NAME>")
            .returnAllColumns(true)
            .searchQuery(SearchQuery.newBuilder()
                    .query(QueryBuilders.matchAll()).limit(20)
                    //First-level grouping: Group by province and count the number of order IDs (total orders) for each province.
                    //Second-level grouping: Group by city and count the number of order IDs (total orders) for each city, and calculate the maximum order amount for each city.
                    .addGroupBy(GroupByBuilders.groupByField("provinceName", "province")
                            .addSubAggregation(AggregationBuilders.count("provinceOrderCounts", "order_id"))
                            .addGroupBySorter(GroupBySorter.rowCountSortInDesc())
                            .addSubGroupBy(GroupByBuilders.groupByField("cityName", "city")
                                    .addSubAggregation(AggregationBuilders.count("cityOrderCounts", "order_id"))
                                    .addSubAggregation(AggregationBuilders.max("cityMaxAmount", "order_amount"))
                                    .addGroupBySorter(GroupBySorter.subAggSortInDesc("cityMaxAmount"))))
                    .build())
            .build();

    //Execute the query statement.
    SearchResponse resp = client.search(searchRequest);

    //Obtain the first-level grouping results (total orders for each province)
    GroupByFieldResult results = resp.getGroupByResults().getAsGroupByFieldResult("provinceName");
    for (GroupByFieldResultItem item : results.getGroupByFieldResultItems()) {
        System.out.println("Province:" + item.getKey()
                + "\tTotal Orders:" + item.getSubAggregationResults().getAsCountAggregationResult("provinceOrderCounts").getValue());

        //Obtain the second-level grouping results (total orders and maximum order amount for each city)
        GroupByFieldResult subResults = item.getSubGroupByResults().getAsGroupByFieldResult("cityName");
        for (GroupByFieldResultItem subItem : subResults.getGroupByFieldResultItems()) {
            System.out.println("\t(City)" + subItem.getKey()
                    + "\tTotal Orders:" + subItem.getSubAggregationResults().getAsCountAggregationResult("cityOrderCounts").getValue()
                    + "\tMaximum Order Amount:" + subItem.getSubAggregationResults().getAsMaxAggregationResult("cityMaxAmount").getValue());
        }
    }
}
Composite grouping
Agrupa os resultados da consulta com base em múltiplos campos. Este recurso suporta paginação por meio de um token de paginação.
Este recurso está disponível apenas no Java SDK e no Go SDK.
-
Parâmetros
Parâmetro
Descrição
groupByName
O nome exclusivo da operação de agregação. Use este nome para consultar os resultados de uma operação de agregação específica.
sources
Os campos pelos quais se deseja agrupar os resultados. Agrupe por até 32 campos e realize operações de agregação nos grupos resultantes. Os seguintes tipos de agrupamento são suportados:
-
GroupByField: agrupa por valor de campo. Configure os parâmetros groupByName, fieldName e groupBySorter.
-
GroupByHistogram: consulta por histograma. Configure os parâmetros groupByName, fieldName, interval e groupBySorter.
-
GroupByDateHistogram: consulta por histograma de data. Configure os parâmetros groupByName, fieldName, interval, timeZone e groupBySorter.
Importante-
Para itens de grupo em sources, apenas a ordenação pelo valor do grupo (groupKeySort) em ordem de dicionário é suportada. Por padrão, os grupos são ordenados em ordem decrescente.
-
Se o valor de um campo não existir para uma coluna específica, o valor nos resultados retornados será NULL.
nextToken
O token de paginação usado para recuperar a próxima página de dados. Por padrão, este parâmetro está vazio.
Na primeira requisição, defina nextToken como vazio. Se nem todos os dados que atendem às condições de consulta forem retornados em uma única requisição, o parâmetro nextToken na resposta não estará vazio. Use esse nextToken para consultas de paginação.
NotaSe precisar persistir o nextToken ou transmiti-lo a uma página de frontend, recomenda-se usar codificação Base64 para convertê-lo em string antes de salvar ou transmitir. O nextToken em si não é uma string. Usar new String(nextToken) diretamente resultará em perda de informações do token.
size
O número de grupos por página. Valor padrão: 10. Valor máximo: 2000.
Importante-
Para limitar o número de grupos a retornar, na maioria dos casos, recomenda-se configurar o parâmetro size.
-
Os parâmetros size e suggestedSize não podem ser configurados simultaneamente.
suggestedSize
O número de grupos a retornar. Especifique um valor maior que o número máximo de grupos permitido pelo servidor ou -1. O servidor retorna os grupos de acordo com sua capacidade.
Se o valor definido for maior que o máximo permitido pelo servidor, o sistema ajustará o valor para esse máximo. O número real de grupos retornados é igual a min(suggestedSize, número máximo permitido pelo servidor, total de grupos).
ImportanteEste parâmetro é adequado para cenários em que o Tablestore é integrado a um mecanismo de computação de alto throughput, como Apache Spark ou PrestoSQL.
subAggregations
As operações de sub-agregação que podem ser realizadas nos dados de cada grupo, como calcular o valor máximo, a soma ou a média.
subGroupBys
As operações de sub-agrupamento que podem ser realizadas nos dados de cada grupo pai para agrupamentos adicionais.
ImportanteO parâmetro GroupByComposite não é suportado em subGroupBy.
-
-
Exemplos
/**
 * Group and aggregate query results: Group the query results and perform the aggregation operation on the resulting groups based on the parameters such as groupbyField, groupByHistogram, and groupByDataHistogram that are passed to the SourceGroupBy parameter.
 * Return the aggregated results of multiple fields in a flat structure.
 */
public static void groupByComposite(SyncClient client) {
    GroupByComposite.Builder compositeBuilder = GroupByBuilders
            .groupByComposite("groupByComposite")
            .size(2000)
            .addSources(GroupByBuilders.groupByField("groupByField", "Col_Keyword")
                    .addGroupBySorter(GroupBySorter.groupKeySortInAsc()).build())
            .addSources(GroupByBuilders.groupByHistogram("groupByHistogram", "Col_Long")
                    .addGroupBySorter(GroupBySorter.groupKeySortInAsc())
                    .interval(5)
                    .build())
            .addSources(GroupByBuilders.groupByDateHistogram("groupByDateHistogram", "Col_Date")
                    .addGroupBySorter(GroupBySorter.groupKeySortInAsc())
                    .interval(5, DateTimeUnit.DAY)
                    .timeZone("+05:30").build());

    SearchRequest searchRequest = SearchRequest.newBuilder()
            .indexName("<SEARCH_INDEX_NAME>")
            .tableName("<TABLE_NAME>")
            .returnAllColumnsFromIndex(true)
            .searchQuery(SearchQuery.newBuilder()
                    .addGroupBy(compositeBuilder.build())
                    .build())
            .build();

    SearchResponse resp = client.search(searchRequest);

    while (true) {
        if (resp.getGroupByResults() == null || resp.getGroupByResults().getResultAsMap().size() == 0) {
            System.out.println("groupByComposite Result is null or empty");
            return;
        }

        GroupByCompositeResult result = resp.getGroupByResults().getAsGroupByCompositeResult("groupByComposite");

        if(!result.getSourceNames().isEmpty()) {
            for (String sourceGroupByNames: result.getSourceNames()) {
                System.out.printf("%s\t", sourceGroupByNames);
            }
            System.out.print("rowCount\t\n");
        }

        for (GroupByCompositeResultItem item : result.getGroupByCompositeResultItems()) {
            for (String value : item.getKeys()) {
                String val = value == null ? "NULL" : value;
                System.out.printf("%s\t", val);

            }
            System.out.printf("%d\t\n", item.getRowCount());
        }

        // Use the token to page through groups.
        if (result.getNextToken() != null) {
            searchRequest.setSearchQuery(
                    SearchQuery.newBuilder()
                            .addGroupBy(compositeBuilder.nextToken(result.getNextToken()).build())
                            .build()
            );
            resp = client.search(searchRequest);
        } else {
            break;
        }
    }
}
Group by range
Agrupa os resultados da consulta em intervalos personalizados com base no valor de um campo, retornando a contagem de cada intervalo.
-
Parâmetros
Parâmetro
Descrição
groupByName
O nome exclusivo da operação de agregação. Use este nome para consultar os resultados de uma operação de agregação específica.
fieldName
O nome do campo usado na operação de agregação. Apenas os tipos Long e Double são suportados.
range[double_from, double_to)
Os intervalos de valores para agrupamento.
Defina double_from como Double.MIN_VALUE para especificar o valor mínimo e double_to como Double.MAX_VALUE para especificar o valor máximo.
subAggregation and subGroupBy
A operação de sub-agregação. Realize a sub-agregação com base nos resultados do agrupamento.
Por exemplo, após agrupar os resultados por volume de vendas e por província, obtenha a província com maior proporção de vendas em um intervalo especificado. Especifique GroupByField em GroupByRange para executar essa consulta.
-
Exemplos
/**
 * Group sales volumes based on ranges [0, 1000), [1000, 5000), and [5000, Double.MAX_VALUE) to obtain the sales volume in each range.
 */
public void groupByRange(SyncClient client) {
    //Create a query statement.
    SearchRequest searchRequest = SearchRequest.newBuilder()
        .tableName("<TABLE_NAME>")
        .indexName("<SEARCH_INDEX_NAME>")
        .searchQuery(
            SearchQuery.newBuilder()
                .query(QueryBuilders.matchAll())
                .limit(0)
                .addGroupBy(GroupByBuilders
                    .groupByRange("name1", "column_number")
                    .addRange(0, 1000)
                    .addRange(1000, 5000)
                    .addRange(5000, Double.MAX_VALUE)
                )
                .build())
        .build();
    //Execute the query statement.
    SearchResponse resp = client.search(searchRequest);
    //Obtain the aggregation results.
    for (GroupByRangeResultItem item : resp.getGroupByResults().getAsGroupByRangeResult("name1").getGroupByRangeResultItems()) {

        //Display the number of rows.
        System.out.println(item.getRowCount());
    }
}
Geographic grouping
Agrupa os resultados da consulta pela distância a partir de uma origem. Itens dentro de um intervalo de distância especificado são colocados no mesmo grupo, e a operação retorna a contagem de cada intervalo.
-
Parâmetros
Parâmetro
Descrição
groupByName
O nome exclusivo da operação de agregação. Use este nome para consultar os resultados de uma operação de agregação específica.
fieldName
O nome do campo usado na operação de agregação. Apenas o tipo Geo_point é suportado.
origin(double lat, double lon)
A longitude e latitude do ponto central.
double lat especifica a latitude do ponto central. double lon especifica a longitude do ponto central.
range[double_from, double_to)
Os intervalos de distância usados para agrupamento. Unidade: metros.
Defina double_from como Double.MIN_VALUE para especificar o valor mínimo e double_to como Double.MAX_VALUE para especificar o valor máximo.
subAggregation and subGroupBy
A operação de sub-agregação. Realize a sub-agregação com base nos resultados do agrupamento.
-
Exemplos
/**
 * Group users based on geographical locations to a Wanda Plaza to obtain the number of users in each distance range. The distance ranges are [0, 1000), [1000, 5000), and [5000, Double.MAX_VALUE). Unit: meters.
 */
public void groupByGeoDistance(SyncClient client) {
    //Create a query statement.
    SearchRequest searchRequest = SearchRequest.newBuilder()
        .tableName("<TABLE_NAME>")
        .indexName("<SEARCH_INDEX_NAME>")
        .searchQuery(
            SearchQuery.newBuilder()
                .query(QueryBuilders.matchAll())
                .limit(0)
                .addGroupBy(GroupByBuilders
                    .groupByGeoDistance("name1", "column_geo_point")
                    .origin(3.1, 6.5)
                    .addRange(0, 1000)
                    .addRange(1000, 5000)
                    .addRange(5000, Double.MAX_VALUE)
                )
                .build())
        .build();
    //Execute the query statement.
    SearchResponse resp = client.search(searchRequest);
    //Obtain the aggregation results.
    for (GroupByGeoDistanceResultItem item : resp.getGroupByResults().getAsGroupByGeoDistanceResult("name1").getGroupByGeoDistanceResultItems()) {
       //Display the number of rows.
        System.out.println(item.getRowCount());
    }
}
Group by filter
Agrupa os resultados da consulta com base em filtros especificados. Retorna a contagem de documentos que correspondem a cada filtro, na mesma ordem em que os filtros foram adicionados.
-
Parâmetros
Parâmetro
Descrição
groupByName
O nome exclusivo da operação de agregação. Use este nome para consultar os resultados de uma operação de agregação específica.
filter
Os filtros que podem ser usados na consulta. Os resultados são retornados na ordem em que os filtros são especificados.
subAggregation and subGroupBy
A operação de sub-agregação. Realize a sub-agregação com base nos resultados do agrupamento.
-
Exemplos
/**
 * Specify the following filters to obtain the number of items that match each filter: The sales volume exceeds 100, the place of origin is Zhejiang, and the description contains Hangzhou.
 */
public void groupByFilter(SyncClient client) {
    //Create a query statement.
    SearchRequest searchRequest = SearchRequest.newBuilder()
        .tableName("<TABLE_NAME>")
        .indexName("<SEARCH_INDEX_NAME>")
        .searchQuery(
            SearchQuery.newBuilder()
                .query(QueryBuilders.matchAll())
                .limit(0)
                .addGroupBy(GroupByBuilders
                    .groupByFilter("name1")
                    .addFilter(QueryBuilders.range("number").greaterThanOrEqual(100))
                    .addFilter(QueryBuilders.term("place","Zhejiang"))
                    .addFilter(QueryBuilders.match("text","Hangzhou"))
                )
                .build())
        .build();
    //Execute the query statement.
    SearchResponse resp = client.search(searchRequest);
    //Obtain the aggregation results based on the order of filters.
    for (GroupByFilterResultItem item : resp.getGroupByResults().getAsGroupByFilterResult("name1").getGroupByFilterResultItems()) {
        //Display the number of rows.
        System.out.println(item.getRowCount());
    }
}
Group by histogram
Agrupa os resultados da consulta por um intervalo de dados especificado. Linhas cujos valores de campo estejam dentro do mesmo intervalo são colocadas no mesmo grupo. A operação retorna o valor inicial de cada grupo e sua contagem de linhas correspondente.
-
Parâmetros
Parâmetro
Descrição
groupByName
O nome exclusivo da operação de agregação. Use este nome para consultar os resultados de uma operação de agregação específica.
fieldName
O nome do campo usado na operação de agregação. Apenas os tipos Long e Double são suportados.
interval
O intervalo de dados usado para obter os resultados de agregação.
fieldRange[min,max]
O intervalo usado em conjunto com o parâmetro interval para limitar o número de grupos. O número de grupos determinado pela fórmula
(fieldRange.max-fieldRange.min)/intervalnão pode exceder 2.000.minDocCount
O número mínimo de linhas. Se o número de linhas em um grupo for inferior a esse mínimo, os resultados de agregação do grupo não serão retornados.
missing
O valor padrão do campo sobre o qual a operação de agregação é realizada, aplicado às linhas em que o valor do campo está vazio.
-
Se nenhum valor for especificado para o parâmetro missing, a linha será ignorada.
-
Se um valor for especificado para o parâmetro missing, esse valor será usado como o valor do campo na linha.
-
-
Exemplos
/**
 * Collect statistics on the distribution of users by age group.
 */
public static void groupByHistogram(SyncClient client) {
    //Create a query statement.
    SearchRequest searchRequest = SearchRequest.newBuilder()
        .tableName("<TABLE_NAME>")
        .indexName("<SEARCH_INDEX_NAME>")
        .searchQuery(
            SearchQuery.newBuilder()
                .addGroupBy(GroupByBuilders
                    .groupByHistogram("groupByHistogram", "age")
                    .interval(10)
                    .minDocCount(0L)
                    .addFieldRange(0, 99))
                .build())
        .build();
    //Execute the query statement.
    SearchResponse resp = ots.search(searchRequest);
    //Obtain the results that are returned when the aggregation operation is performed.
    GroupByHistogramResult results = resp.getGroupByResults().getAsGroupByHistogramResult("groupByHistogram");
    for (GroupByHistogramItem item : results.getGroupByHistogramItems()) {
        System.out.println("key:" + item.getKey().asLong() + " value:" + item.getValue());
    }
}
Date histogram
Agrupa os resultados da consulta de um campo de data em buckets com um intervalo de tempo especificado. Cada bucket contém as linhas do mesmo intervalo e retorna seu horário de início e a contagem de linhas.
Este recurso requer o Tablestore Java SDK 5.16.1 ou posterior. Para o histórico completo de versões, consulte Java SDK version history.
-
Parâmetros
Parâmetro
Descrição
groupByName
O nome exclusivo da operação de agregação. Use este nome para consultar os resultados de uma operação de agregação específica.
fieldName
O nome do campo usado na operação de agregação. Apenas o tipo Date é suportado.
ImportanteO tipo Date em search indexes é suportado pelo Tablestore SDK for Java V5.13.9 e posteriores.
interval
Intervalo estatístico.
fieldRange[min,max]
O intervalo usado em conjunto com o parâmetro interval para limitar o número de grupos. O número de grupos determinado pela fórmula
(fieldRange.max-fieldRange.min)/intervalnão pode exceder 2.000.minDocCount
O número mínimo de linhas. Se o número de linhas em um grupo for inferior a esse mínimo, os resultados de agregação do grupo não serão retornados.
missing
O valor padrão do campo sobre o qual a operação de agregação é realizada, aplicado às linhas em que o valor do campo está vazio.
-
Se nenhum valor for especificado para o parâmetro missing, a linha será ignorada.
-
Se um valor for especificado para o parâmetro missing, esse valor será usado como o valor do campo na linha.
timeZone
O fuso horário no formato
+hh:mmou-hh:mm, como+08:00ou-09:00. Este parâmetro é obrigatório apenas quando o campo é do tipo Date.Se este parâmetro não for especificado para um campo do tipo Date, pode ocorrer um deslocamento de N horas nos resultados de agregação. Especifique o parâmetro timeZone para evitar esse problema.
-
-
Exemplos
/**
 * Collect statistics on the daily distribution of data in the col_date field from 10:00:00 on May 1, 2017 to 13:00:00 May 21, 2017.
 */
public static void groupByDateHistogram(SyncClient client) {
    //Create a query statement.
    SearchRequest searchRequest = SearchRequest.newBuilder()
    .returnAllColumns(false)
    .indexName("<SEARCH_INDEX_NAME>")
    .tableName("<TABLE_NAME>")
    .searchQuery(
        SearchQuery.newBuilder()
        .query(QueryBuilders.matchAll())
        .limit(0)
        .getTotalCount(false)
        .addGroupBy(GroupByBuilders
                    .groupByDateHistogram("groupByDateHistogram", "col_date")
                    .interval(1, DateTimeUnit.DAY)
                    .minDocCount(1)
                    .missing("2017-05-01 13:01:00")
                    .fieldRange("2017-05-01 10:00", "2017-05-21 13:00:00"))
        .build())
    .build();
    //Execute the query statement.
    SearchResponse resp = ots.search(searchRequest);
    //Obtain the results that are returned when the aggregation operation is performed.
    List<GroupByDateHistogramItem> items = resp.getGroupByResults().getAsGroupByDateHistogramResult("groupByDateHistogram").getGroupByDateHistogramItems();
    for (GroupByDateHistogramItem item : items) {
        System.out.printf("millisecondTimestamp:%d, count:%d \n", item.getTimestamp(), item.getRowCount());
    }
}
Top-rows aggregation
Após agrupar os resultados da consulta, uma agregação top-rows recupera uma seleção de linhas de cada grupo. Este recurso é similar à função ANY_VALUE(field) do MySQL.
Ao usar a agregação top-rows, se o Search Index contiver campos do tipo nested, Geopoint ou array, a agregação retornará apenas a chave primária de cada linha. Para recuperar outros campos, consulte a tabela de dados separadamente.
-
Parâmetros
Parâmetro
Descrição
aggregationName
O nome exclusivo da operação de agregação. Use este nome para consultar os resultados de uma operação de agregação específica.
limit
O número máximo de linhas retornadas por grupo. Por padrão, apenas uma linha de dados é retornada.
sort
O método de ordenação usado para classificar os dados nos grupos.
columnsToGet
Os campos que devem ser retornados. Apenas campos em search indexes são suportados. Campos do tipo Array, Date, Geopoint e Nested não são suportados.
O valor deste parâmetro é o mesmo do parâmetro columnsToGet em SearchRequest. Basta especificar um valor para o parâmetro columnsToGet em SearchRequest.
-
Exemplos
/**
 * An activity application form of a school contains fields in which information such as the names of students, classes, head teachers, and class presidents can be specified. Group students by class to view the application statistics and the property information of each class.
 * SQL statement: select className, teacher, monitor, COUNT(*) as number from table GROUP BY className.
 */
public void testTopRows(SyncClient client) {
    SearchRequest searchRequest = SearchRequest.newBuilder()
            .indexName("<SEARCH_INDEX_NAME>")
            .tableName("<TABLE_NAME>")
            .searchQuery(
                    SearchQuery.newBuilder()
                            .query(QueryBuilders.matchAll())
                            .limit(0)
                            .addGroupBy(GroupByBuilders.groupByField("groupName", "className")
                                    .size(5)  //Specify the number of groups that you want to return. For information about the maximum value that you can specify for the number of groups to return, see the description of the number of groups returned by GroupByField in the "Search index limits" topic.
                                    .addSubAggregation(AggregationBuilders.topRows("topRowsName")
                                            .limit(1)
                                            .sort(new Sort(Arrays.asList(new FieldSort("teacher", SortOrder.DESC)))) //Sort rows by teacher in descending order.
                                    )
                            )
                            .build())
            .addColumnsToGet(Arrays.asList("teacher", "monitor"))
            .build();
    SearchResponse resp = client.search(searchRequest);
    List<GroupByFieldResultItem> items = resp.getGroupByResults().getAsGroupByFieldResult("groupName").getGroupByFieldResultItems();
    for (GroupByFieldResultItem item : items) {
        String className = item.getKey();
        long number = item.getRowCount();
        List<Row> topRows = item.getSubAggregationResults().getAsTopRowsAggregationResult("topRowsName").getRows();
        Row row = topRows.get(0);
        String teacher = row.getLatestColumn("teacher").getValue().asString();
        String monitor = row.getLatestColumn("monitor").getValue().asString();
    }
}
Multiple aggregations
É possível combinar múltiplas agregações em uma única consulta.
Consultas complexas com múltiplas agregações podem aumentar o tempo de resposta.
Combine multiple aggregations
public void multipleAggregation(SyncClient client) {
    //Create a query statement.
    SearchRequest searchRequest = SearchRequest.newBuilder()
        .tableName("<TABLE_NAME>")
        .indexName("<SEARCH_INDEX_NAME>")
        .searchQuery(
            SearchQuery.newBuilder()
                .query(QueryBuilders.matchAll())
                .limit(0)
                .addAggregation(AggregationBuilders.min("name1", "long"))
                .addAggregation(AggregationBuilders.sum("name2", "long"))
                .addAggregation(AggregationBuilders.distinctCount("name3", "long"))
                .build())
        .build();
    //Execute the query statement.
    SearchResponse resp = client.search(searchRequest);
    //Obtain the minimum value from the results of the aggregation operation.
    System.out.println(resp.getAggregationResults().getAsMinAggregationResult("name1").getValue());
    //Obtain the sum from the results of the aggregation operation.
    System.out.println(resp.getAggregationResults().getAsSumAggregationResult("name2").getValue());
    //Obtain the number of distinct values from the results of the aggregation operation.
    System.out.println(resp.getAggregationResults().getAsDistinctCountAggregationResult("name3").getValue());
}
Combine Aggregation and GroupBy
public void multipleGroupBy(SyncClient client) {
    //Create a query statement.
    SearchRequest searchRequest = SearchRequest.newBuilder()
        .tableName("<TABLE_NAME>")
        .indexName("<SEARCH_INDEX_NAME>")
        .searchQuery(
            SearchQuery.newBuilder()
                .query(QueryBuilders.matchAll())
                .limit(0)
                .addAggregation(AggregationBuilders.min("name1", "long"))
                .addAggregation(AggregationBuilders.sum("name2", "long"))
                .addAggregation(AggregationBuilders.distinctCount("name3", "long"))
                .addGroupBy(GroupByBuilders.groupByField("name4", "type"))
                .addGroupBy(GroupByBuilders.groupByRange("name5", "long").addRange(1, 15))
                .build())
        .build();
    //Execute the query statement.
    SearchResponse resp = client.search(searchRequest);
    //Obtain the minimum value from the results of the aggregation operation.
    System.out.println(resp.getAggregationResults().getAsMinAggregationResult("name1").getValue());
    //Obtain the sum from the results of the aggregation operation.
    System.out.println(resp.getAggregationResults().getAsSumAggregationResult("name2").getValue());
    //Obtain the number of distinct values from the results of the aggregation operation.
    System.out.println(resp.getAggregationResults().getAsDistinctCountAggregationResult("name3").getValue());
    //Obtain the values of GroupByField from the results of the aggregation operation.
    for (GroupByFieldResultItem item : resp.getGroupByResults().getAsGroupByFieldResult("name4").getGroupByFieldResultItems()) {
        //Display the keys.
        System.out.println(item.getKey());
        //Display the number of rows.
        System.out.println(item.getRowCount());
    }
    //Obtain the values of GroupByRange from the results of the aggregation operation.
    for (GroupByRangeResultItem item : resp.getGroupByResults().getAsGroupByRangeResult("name5").getGroupByRangeResultItems()) {
        //Display the number of rows.
        System.out.println(item.getRowCount());
    }
}
Apêndice: Comparação entre os métodos de agrupamento por múltiplos campos
Para agrupar os resultados da consulta por múltiplos campos, use o parâmetro groupBy no modo aninhado ou o parâmetro GroupByComposite. A tabela a seguir descreve as diferenças entre os dois métodos.
|
Recurso |
groupBy (aninhado) |
Agrupamento por múltiplos campos |
|
size |
2000 |
2000 |
|
Limite de campos |
Suporta até 3 níveis. |
Suporta até 32 níveis. |
|
Paginação |
Não suportada |
Suportada pelo parâmetro nextToken |
|
Regras de ordenação dos grupos |
|
Em ordem alfabética ou alfabética inversa |
|
Suporte a agregação |
Sim |
Sim |
|
Compatibilidade |
Para campos do tipo Date, os resultados da consulta são retornados no formato especificado. |
Para campos do tipo DATE, os resultados da consulta são retornados como strings de timestamp. |