O modelo Wide Column é compatível com Bigtable/HBase e atende a cenários de metadados, big data e outras aplicações. Cada tabela oferece armazenamento em escala de petabytes, dezenas de milhões de QPS, linhas largas sem esquema, dados com múltiplas versões e gerenciamento de ciclo de vida baseado em TTL.
Visão geral do modelo
O modelo Wide Column do Tablestore é compatível com Bigtable/HBase e armazena dados em tabelas usando uma estrutura tridimensional (linha, coluna e tempo). As tabelas não possuem esquema: cada linha pode ter colunas diferentes, e é possível adicionar ou remover colunas de atributo sem definir um esquema.
Componentes do modelo
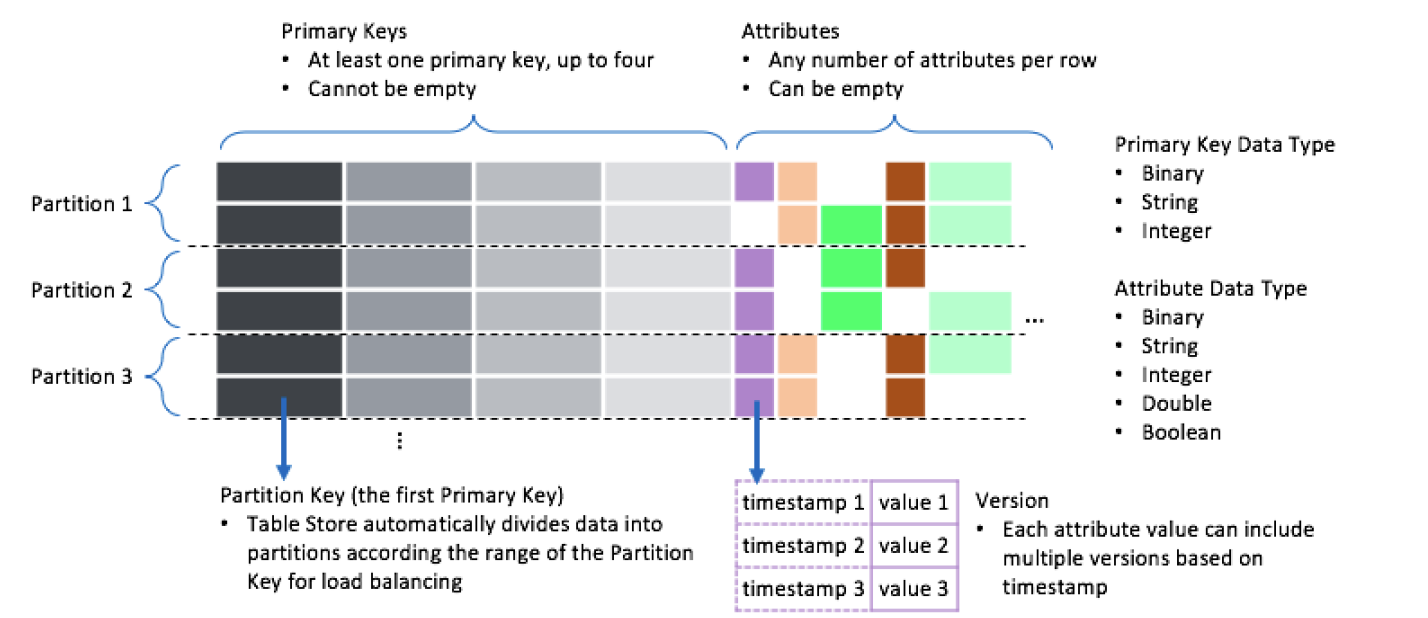
O modelo Wide Column consiste nos seguintes componentes.
|
Componente |
Descrição |
|
Primary Key |
Identifica exclusivamente cada linha em uma tabela. Uma chave primária consiste em uma a quatro colunas de chave primária. |
|
Partition Key |
Primeira coluna da chave primária. O Tablestore distribui os dados entre partições com base nos valores da chave de partição para balanceamento de carga. |
|
Attribute Column |
Colunas que não são de chave primária em uma linha. Cada coluna de atributo pode armazenar múltiplos valores versionados. Não há limite para o número de colunas de atributo por linha. |
|
Version |
Cada valor possui um carimbo de data/hora de versão que define o ciclo de vida dos dados. Número da versão. |
|
Data Type |
O Tablestore suporta os tipos de dados String, Binary, Double, Integer e Boolean. Tipos de dados. |
|
Time To Live (TTL) |
Define um ciclo de vida de dados por tabela. Por exemplo, com um TTL de um mês, o Tablestore remove automaticamente dados com mais de um mês. Time to live. |
|
Max Versions |
Defina o número máximo de versões por coluna de atributo. Quando as versões excedem esse limite, o Tablestore exclui as versões mais antigas de forma assíncrona. Máximo de versões. |
Componentes principais
Tabelas de dados, linhas, chaves primárias e atributos são os componentes principais do modelo Wide Column do Tablestore. Uma tabela é um conjunto de linhas, e cada linha consiste em uma chave primária e atributos. A primeira coluna da chave primária é a chave de partição.
A tabela a seguir descreve esses componentes.
Os tipos de dados de chave primária e coluna de atributo estão listados em Convenções de nomenclatura e tipos de dados.
|
Componente |
Descrição |
|
Primary key |
Identifica exclusivamente cada linha. Uma chave primária consiste em uma a quatro colunas. Ao criar uma tabela, especifique a composição da chave primária, o nome e o tipo de dados de cada coluna, além da ordem das colunas. O Tablestore indexa os dados com base na chave primária da tabela de dados. Por padrão, as linhas em uma tabela de dados são classificadas em ordem crescente pela chave primária. |
|
Partition key |
Primeira coluna da chave primária. O Tablestore distribui as linhas entre partições e máquinas com base nos valores da chave de partição para balanceamento de carga. Linhas com o mesmo valor de chave de partição pertencem à mesma partição. Uma partição pode conter vários valores de chave de partição. O Tablestore divide e mescla partições automaticamente conforme necessário. Nota
Um valor de chave de partição é a menor unidade de particionamento e não pode ser subdividido. Para evitar partições excessivamente grandes, mantenha o tamanho total de todas as linhas para um único valor de chave de partição abaixo de 10 GB. Para obter diretrizes sobre seleção de chave de partição, consulte Operações de tabela. |
|
Attribute |
Consiste em múltiplas colunas de atributo sem limite por linha. As colunas podem diferir entre linhas, os valores podem estar vazios e a mesma coluna pode armazenar valores de diferentes tipos de dados. As colunas de atributo suportam múltiplas versões para consulta e um tempo de vida (TTL) configurável. Versões de dados e TTL. |
Diferenças em relação ao modelo relacional
A tabela a seguir compara o modelo Wide Column com o modelo relacional.
|
Modelo |
Recursos |
|
Modelo Wide Column |
Tridimensional (linha, coluna, tempo), sem esquema, linhas largas, dados com múltiplas versões e gerenciamento de ciclo de vida. |
|
Modelo relacional |
Bidimensional (linha, coluna), esquema fixo. |
Limites
Os limites gerais estão listados em Limites.
Se você usar um índice secundário ou índice de busca, verifique os limites aplicáveis: Limites de índice secundário, Limites de índice de busca.
Caso utilize consultas SQL, consulte os limites aplicáveis: Limites de consulta SQL.
Recursos
|
Recursos |
Descrição |
Referências |
|
Operações de tabela |
Liste, crie, atualize e exclua tabelas de dados em uma instância. |
|
|
Operações básicas de dados |
O Tablestore fornece operações de linha única (PutRow, GetRow, UpdateRow, DeleteRow) e operações de múltiplas linhas (BatchWriteRow, BatchGetRow, GetRange) para leitura e gravação de dados da tabela. |
|
|
Versões de dados e TTL |
Gerencie a retenção de dados com controle de versão e TTL para reduzir espaço de armazenamento e custos. |
|
|
Coluna de chave primária com incremento automático |
Quando uma coluna de chave primária que não é de partição está definida como incremento automático, não é necessário especificar seu valor ao gravar dados. O Tablestore gera um valor exclusivo e estritamente crescente por chave de partição para a coluna. |
|
|
Atualização condicional |
Atualiza os dados somente quando condições específicas são atendidas. Caso contrário, a atualização falha. |
|
|
Transação local |
Cria uma transação local dentro de um único valor de chave de partição. Execute operações de leitura e gravação e, em seguida, confirme ou descarte a transação. |
|
|
Contador atômico |
Utiliza uma coluna como contador atômico para estatísticas em tempo real, como contagem de visualizações de página (PV). |
|
|
Filtro |
Filtra os resultados de leitura no lado do servidor e retorna apenas as linhas correspondentes, reduzindo a transferência de rede e o tempo de resposta. |
|
|
Índice secundário |
Cria tabelas de índice para ativar consultas em colunas que não são de chave primária. Inclui índices secundários globais e locais.
|
|
|
Índice de busca |
Baseado em índices invertidos e armazenamento colunar para consultas complexas de big data. Suporta consultas fora da chave primária, busca de texto completo, consultas por prefixo/fuzzy, condições combinadas, consultas aninhadas, consultas geográficas, agregações (max, min, count, sum, avg, distinct_count, group_by) e varredura paralela. |
|
|
Consulta SQL |
Fornece uma interface SQL unificada entre mecanismos de dados para consultas complexas e análise de dados no Tablestore, com otimização de consulta baseada em índice. |
|
|
Tunnel Service |
O Tablestore fornece três canais de dados distribuídos em tempo real (incremental, completo e incremental mais completo) para consumir e processar dados históricos e novos em uma tabela. |
Faturamento
Cobrança por throughput de leitura/gravação, armazenamento de dados e tráfego de saída para a Internet. Visão geral do faturamento.
Perguntas frequentes
Referências
Crie uma instância com redundância de zona para recuperação de desastres no nível de zona. Armazenamento com redundância de zona.
Proteja dados e acesso à rede com criptografia de tabela e acesso via VPC. Criptografia de dados. Gerenciamento de segurança de rede.
Faça backup periódico dos dados para evitar exclusão acidental. Backup de dados.
Consuma e processe dados históricos e novos da tabela com o Tunnel Service.
Configure notificações de alerta baseadas em métricas com o Cloud Monitor. Monitoramento e alertas.
Visualize dados com DataV ou Grafana. Visualização de dados.