Use o CloudLens for SLS para monitorar o uso da cota de recursos do Project, detectar excessos por meio de logs de erro globais e métricas e solicitar aumentos de cota.
Contexto
O Alibaba Cloud Lens oferece observabilidade para product cloud baseada no Simple Log Service (SLS), permitindo a coleta com um clique em de logs de instância (logs importantes, logs detalhados e logs operacionais de jobs) e logs globais (logs de auditoria, logs de faturamento, logs de erro e métricas).
|
Tipo de log |
Subtipo |
Descrição |
|
Logs de instância |
Logs detalhados |
Monitoramento de tráfego de acesso Monitoramento de exceções de acesso |
|
Logs importantes |
Monitoramento de grupos de consumidores Monitoramento de coleta do Logtail |
|
|
Logs operacionais de jobs |
Monitoramento de transformação de dados (nova) Monitoramento de jobs SQL agendados |
|
|
Logs globais |
Logs de auditoria |
Monitoramento de operações de recursos |
|
Logs de erro |
Monitoramento de excesso de cota Monitoramento de exceções de acesso Monitoramento de exceções de operação |
|
|
Métricas |
Monitoramento de tráfego de acesso Monitoramento de exceções de acesso Monitoramento de uso de cota de recursos |
|
|
Logs de faturamento |
Rastreamento de uso de recursos |
Para obter detalhes sobre os tipos de log, consulte a tabela de índice de logs.
Pré-requisitos
Crie um usuário RAM e conceda a ele as permissões necessárias. Para mais informações, consulte Create a RAM user e Authorize a RAM user to operate CloudLens for SLS.
Ative o recurso de coleta de logs para logs globais, incluindo logs de erro e métricas. Para mais informações, consulte Enable the log collection feature.
Para monitorar o uso da cota de recursos em tempo real, ative a coleta dos seguintes logs globais: logs de erro e métricas. Armazene esses logs no mesmo projeto.
Armazene os logs de monitoramento em um projeto dedicado para evitar que consumam a cota de recursos de um projeto de negócios. Por exemplo, use o projeto
log-service-{user ID}-cn-hangzhouna região China (Hangzhou).
Painel de monitoramento de cotas
O painel de monitoramento de cotas no CloudLens for SLS exibe alertas de cota de recursos, uso em tempo real dos principais recursos do Project e excessos de cota.
Faça login no console do Simple Log Service.
Em , clique em CloudLens for SLS.
No painel de navegação à esquerda, escolha para visualizar as informações de cota.
Alertas de cota de recursos
Exibe alertas de cota de recursos quando o uso ultrapassa 80% e mostra a distribuição de recursos acima do limite.
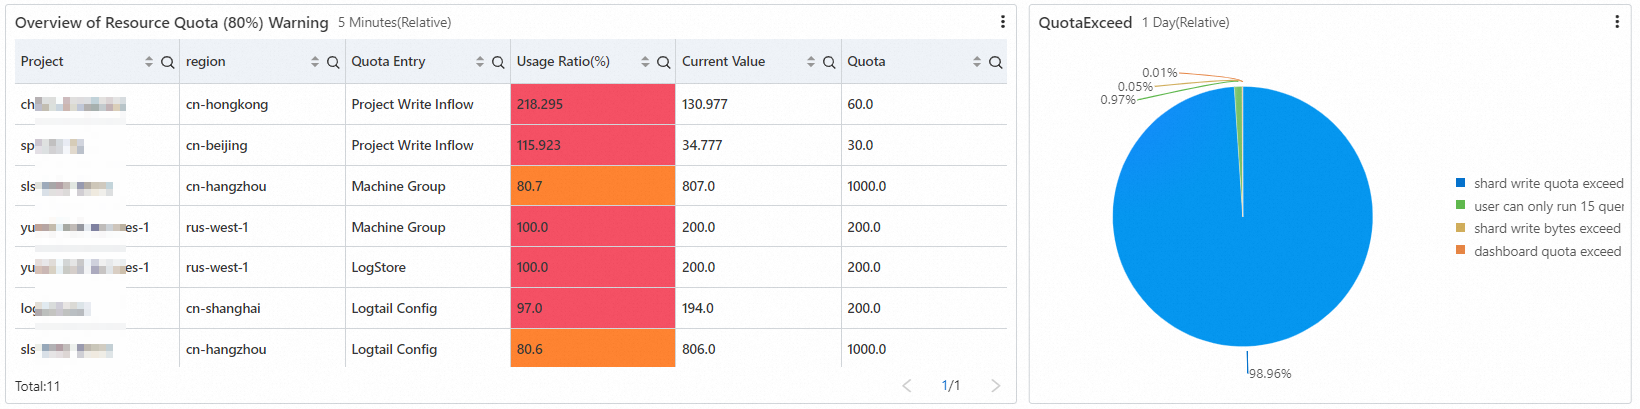
Uso de cota em tempo real
Apresenta o uso em tempo real dos recursos básicos do projeto e das cotas de leitura/gravação de dados.
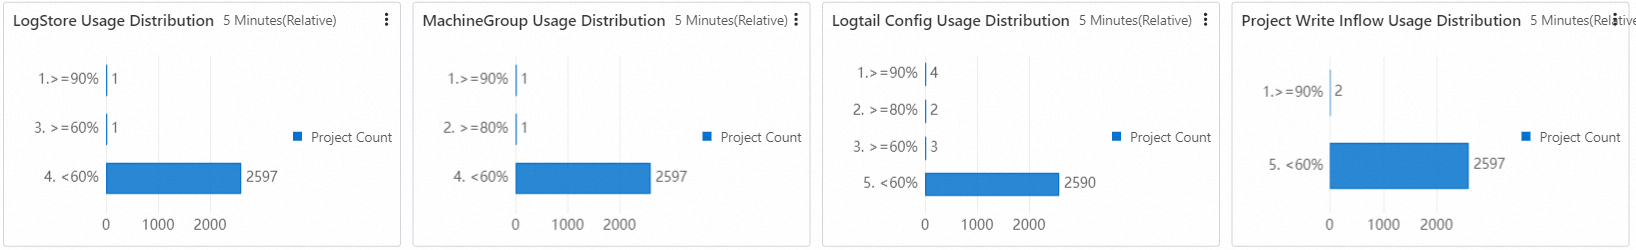
Lista o uso da cota de recursos por Project, incluindo Region, Logstore Usage (%), Machine Group Usage (%) e Logtail configuration Usage (%), juntamente com seus limites. As células ficam vermelhas quando o uso atinge ou se aproxima de 100% e laranjas por volta de 80%. Clique em Adjust Resource Quotas no canto superior direito para modifique as cotas.
A tabela de cota de leitura/gravação de dados apresenta as colunas Project, region, Project write throughput (%), Project write operations (%), Project read operations (%), Project write throughput (GB/min) (watermark/limit), Project write operations (watermark/limit) e Project read operations (watermark/limit). Clique em Adjust Resource Quota no canto superior direito para alterar os limites de cota.
Excesso de cota do Project
Mostra os excessos nas cotas de recursos do Project.
Relaciona o Project, a error message e a count para cada tipo de violação de cota. Os tipos comuns incluem report quota exceeded e Logstore count exceeded. Clique em Adjust Resource Quota no canto superior direito para ajustar a cota de recurso correspondente.
Monitoramento de recursos
O CloudLens for SLS suporta monitoramento de cota de recursos, monitoramento de cota de leitura/gravação de dados e monitoramento avançado para Logstores, grupos de máquinas e operações de gravação do Project.
Faça login no console do Simple Log Service.
Na seção Log Application, clique em CloudLens for SLS.
Na página CloudLens for SLS, no painel de navegação à esquerda, clique em Anomaly Detection para configure regras de alerta para monitoramento de recursos.
Monitoramento de cotas
A tabela a seguir lista as categorias de métricas de cota.
|
Categoria |
Métrica |
Descrição |
|
monitoramento de uso em tempo real |
|
|
|
||
|
monitoramento de excesso de cota |
|
Monitoramento de cota de recursos
Clique em Create Alert para configure uma regra de alerta.
Selecione o Project que armazena logs de erro globais e métricas para a regra de alerta.
-
Configure a condição de disparo e a política de alerta conforme suas necessidades.
Defina os parâmetros conforme a tabela abaixo. Mantenha os valores padrão para os demais parâmetros. Para mais informações, consulte Create a log-based alert rule.
Parâmetro
Valor
Rule Name
uso de cota de recursos básicos
Check Frequency
Intervalo fixo, 15 minutos
Query statistics
-
Type: Metricstore
-
Authorization: Default
-
Metricstore: internal-monitor-metric
-
Time Range: 15 Minutes (Relative)
-
Query:
ImportantePor padrão, uma consulta SQL retorna 100 linhas. Se você adicionar
limit 1000ao final da consulta, até 1.000 linhas serão retornadas.* | select Project, region, logstore_ratio, machine_group_ratio, logtail_config_ratio from (SELECT A.id as Project , A.region as region, round(COALESCE(SUM(B.count_logstore), 0)/cast(json_extract(A.quota, '$.logstore') as double) * 100, 3) as logstore_ratio, cast(json_extract(A.quota, '$.logstore') as double) as quota_logstore, round(COALESCE(SUM(C.count_machine_group), 0)/cast(json_extract(A.quota, '$.machine_group') as double) * 100, 3) as machine_group_ratio, cast(json_extract(A.quota, '$.machine_group') as double) as quota_machine_group, round(COALESCE(SUM(D.count_logtail_config), 0)/cast(json_extract(A.quota, '$.config') as double) * 100, 3) as logtail_config_ratio, cast(json_extract(A.quota, '$.config') as double) as quota_logtail_config FROM "resource.sls.cmdb.project" as A LEFT JOIN ( SELECT project, COUNT(*) AS count_logstore FROM "resource.sls.cmdb.logstore" as B GROUP BY project ) AS B ON A.id = B.project LEFT JOIN ( SELECT project, COUNT(*) AS count_machine_group FROM "resource.sls.cmdb.machine_group" as C GROUP BY project ) AS C ON A.id = C.project LEFT JOIN ( SELECT project, COUNT(*) AS count_logtail_config FROM "resource.sls.cmdb.logtail_config" as D GROUP BY project ) AS D ON A.id = D.project group by A.id, A.quota, A.region) where quota_logstore is not null and quota_machine_group is not null and quota_logtail_config is not null and (logstore_ratio > 80 or machine_group_ratio > 80 or logtail_config_ratio > 80) limit 10000
Group evaluation
Auto Label
Trigger Condition
-
Um alerta Critical é disparado se o uso de cota para Logstores, grupos de máquinas ou configurações do Logtail em um Project exceder 90%.
-
Um alerta Medium é disparado se o uso de cota para Logstores, grupos de máquinas ou configurações do Logtail em um Project exceder 80%.
-
Quando os dados corresponderem a
logstore_ratio > 90 || machine_group_ratio > 90 || logtail_config_ratio > 90, Severity: Critical. -
Quando os dados corresponderem a
logstore_ratio > 80 || machine_group_ratio > 80 || logtail_config_ratio > 80, Severity: Medium.
NotaDestination
Simple Log Service Notification
Alert Policy
Standard Mode
Action Policy
Selecione uma política de ação existente que atenda às suas necessidades ou clique em Add para crie uma nova. Para mais informações, consulte Action policies.
Na seção Add Annotation, defina
titlecomo${alert_name} alert triggerededesccomo${alert_name} alert triggered. Mantenha Auto Add Annotation desativado. -
Após configure os parâmetros, clique em OK.
Uso de cota de leitura/gravação de dados
Clique em Create Alert para configure uma regra de alerta.
Selecione o Project que armazena logs de erro globais e métricas para a regra de alerta.
-
Configure a condição de disparo e a política de alerta.
Defina os parâmetros conforme a tabela abaixo. Mantenha os valores padrão para os demais parâmetros. Para mais informações, consulte Create Log Alert Monitoring Rules.
Parâmetro
Valor
Rule Name
Uso de cota de leitura/gravação de dados
Check Frequency
Intervalo fixo, 15 minutos
Query statistics
-
Type: Metricstore
-
Authorization: Default
-
Metricstore: internal-monitor-metric
-
Time Range: 5 minutes (relative)
-
Query:
ImportantePor padrão, as consultas retornam 100 linhas. Para retornar até 1.000 linhas, adicione
limit 1000ao final da sua consulta.(*)| select Project, region, inflow_ratio, write_cnt_ratio from (SELECT cmdb.id as Project, cmdb.region as region, round(COALESCE(M.name1,0)/round(cast(json_extract(cmdb.quota, '$.inflow_per_min') as double)/1000000000, 3) * 100, 3) as inflow_ratio, round(COALESCE(M.name2,0)/cast(json_extract(cmdb.quota, '$.write_cnt_per_min') as double) * 100, 3) as write_cnt_ratio from "resource.sls.cmdb.project" as cmdb LEFT JOIN ( select project, round(MAX(name1)/1000000000, 3) as name1, MAX(name2) as name2 from (SELECT __time_nano__ as time, element_at( split_to_map(__labels__, '|', '#$#') , 'project') as project, sum(CASE WHEN __name__ = 'logstore_origin_inflow_bytes' THEN __value__ ELSE NULL END) AS name1, sum(CASE WHEN __name__ = 'logstore_write_count' THEN __value__ ELSE NULL END) AS name2 FROM "internal-monitor-metric.prom" where __name__ in ('logstore_origin_inflow_bytes','logstore_write_count' ) and regexp_like(element_at( split_to_map(__labels__, '|', '#$#') , 'project') , '.*') group by project,time )group by project) AS M ON cmdb.id = M.project) where inflow_ratio > 80 or write_cnt_ratio > 80 limit 10000
Group evaluation
Auto label
Trigger Condition
-
Um alerta com severidade Critical é disparado se o uso de tráfego de gravação ou contagem de gravação de um Project exceder 90% da cota.
-
Um alerta com severidade Medium é disparado se o uso de tráfego de gravação ou contagem de gravação de um Project exceder 80% da cota.
-
Define a severidade como Critical quando os dados correspondem a
where inflow_ratio > 90 || write_cnt_ratio > 90. -
Define a severidade como Medium quando os dados correspondem a
where inflow_ratio > 80 || write_cnt_ratio > 80.
NotaDestination
Simple Log Service Notification
Alert Policy
Standard mode
Action Policy
Selecione uma política de ação existente ou clique em Add para crie uma nova. Para mais informações, consulte Action policies.
Na seção Add annotation, defina title como
${alert_name} alert triggerede desc como${alert_name} alert triggered. -
Após configure os parâmetros, clique em OK.
Monitoramento de violação de cota de recursos
Clique em Create Alert para configure uma regra de alerta.
Selecione o Project que armazena logs de erro globais e métricas para a regra de alerta.
-
Configure a condição de disparo e a política de alerta com base nos requisitos do seu negócio.
Defina os parâmetros conforme a tabela abaixo. É possível manter os valores padrão para outros parâmetros. Para mais informações, consulte Create log alert rules.
Parâmetro
Valor
Rule Name
Monitoramento de violação de cota de recursos
Check Frequency
Intervalo fixo, 15 minutos
Query and statistics
-
Type: Logstore
-
Authorization: Default
-
Logstore: internal-error_log
-
Time Range: 15 minutes (Relative)
-
Query Statement:
ImportantePor padrão, as consultas retornam no máximo 100 resultados. Adicionar
limit 1000à instrução de consulta aumenta esse máximo para 1.000.((* and (ErrorCode: ExceedQuota or ErrorCode: QuotaExceed or ErrorCode: ProjectQuotaExceed or ErrorCode:WriteQuotaExceed or ErrorCode: ShardWriteQuotaExceed or ErrorCode: ShardReadQuotaExceed)))| SELECT Project, CASE WHEN ErrorMsg like '%Project write quota exceed: inflow%' then 'The Project write traffic quota is exceeded.' WHEN ErrorMsg like '%Project write quota exceed: qps%' then 'The Project write operation quota is exceeded.' WHEN ErrorMsg like '%dashboard quota exceed%' then 'The dashboard quota is exceeded.' WHEN ErrorMsg like '%config count%' then 'The Logtail configuration quota is exceeded.' WHEN ErrorMsg like '%machine group count%' then 'The machine group quota is exceeded.' WHEN ErrorMsg like '%Alert count %' then 'The alert rule quota is exceeded.' WHEN ErrorMsg like '%logstore count %' then 'The Logstore quota is exceeded.' WHEN ErrorMsg like '%shard count%' then 'The shard quota is exceeded.' WHEN ErrorMsg like '%shard write bytes%' then 'The shard write traffic quota is exceeded.' WHEN ErrorMsg like '%shard write quota%' then 'The shard write operation quota is exceeded.' WHEN ErrorMsg like '%user can only run%' then 'The concurrent SQL analysis operation quota is exceeded.' ELSE ErrorMsg END AS ErrorMsg, COUNT(1) AS count GROUP BY Project, ErrorMsg Limit 1000
Group evaluation
No grouping
Trigger Condition
-
Exceder uma cota mais de 10 vezes dispara um alerta Critical.
-
Exceder uma cota mais de uma vez dispara um alerta Medium.
-
Para dados correspondentes a
count > 10, a severidade é Critical. -
Para dados correspondentes a
count > 1, a severidade é Medium.
NotaDestination
SLS Notification
Alert Policy
Standard Mode
Action Policy
Selecione uma política de ação conforme necessário ou clique em Add para crie uma. Para mais informações, consulte Action policies.
-
Após configure os parâmetros, clique em OK.
Monitoramento avançado
O monitoramento avançado abrange as seguintes métricas:
|
Categoria |
Cenário |
Métrica |
Descrição |
|
Cota de recursos básicos |
Uso em tempo real |
|
|
|
Cota excedida |
|
||
|
Uso em tempo real |
|
||
|
Cota excedida |
|
||
|
Uso em tempo real |
|
||
|
Cota excedida |
|
||
|
Cota de leitura/gravação de dados |
Uso em tempo real |
|
|
|
Cota excedida |
|
||
|
Uso em tempo real |
|
||
|
Cota excedida |
|
Monitoramento de Logstore
Monitoramento de uso em tempo real
Clique em Create Alert para configure uma regra de alerta.
Selecione o Project para a regra de alerta. Este Project deve armazenar seus logs de erro globais e métricas.
-
Configure a condição de disparo e a política de alerta com base nos requisitos do seu negócio.
Defina os parâmetros conforme descrito na tabela a seguir. Mantenha os valores padrão para os demais parâmetros. Para mais informações, consulte Create Log Alert Monitoring Rules.
Parâmetro
Valor
Rule Name
Monitoramento de uso de Logstore
Check Frequency
Intervalo fixo, 15 minutos
Query statistics
-
Type: Metricstore
-
Authorization: Default
-
Metricstore: internal-monitor-metric
-
Time range: 15 minutes (Relative)
-
Query:
ImportantePor padrão, uma consulta retorna no máximo 100 resultados. Se você adicionar limit 1000 ao final da consulta, ela poderá retornar até 1.000 resultados.
* |  select Project, region, round(count_logstore/quota_logstore * 100, 3)  as logstore_ratio from
(SELECT A.id as Project , A.region as region, COALESCE(SUM(B.count_logstore), 0)  AS count_logstore , cast(json_extract(A.quota, '$.logstore') as double)  as quota_logstore
FROM  "resource.sls.cmdb.project" as A
LEFT JOIN (
  SELECT project, COUNT(*) AS count_logstore
  FROM "resource.sls.cmdb.logstore" as B
  GROUP BY project
) AS B ON A.id = B.project
group by A.id, A.quota, A.region) where  quota_logstore is not null   order by logstore_ratio desc limit 1000
Group evaluation
Auto Label
Trigger Condition
-
O sistema dispara um alerta Critical se o número de Logstores em um Project exceder 90% de sua cota.
-
O sistema dispara um alerta Medium se o número de Logstores em um Project exceder 80% de sua cota.
-
Se os dados corresponderem à expressão
logstore_ratio > 90, a Severity do alerta será Critical. -
Se os dados corresponderem à expressão
logstore_ratio > 80, a Severity do alerta será Medium.
NotaDestination
Simple Log Service Notification
Alert Policy
Standard Mode
Action Policy
Selecione uma política de ação existente ou clique em Add para crie uma nova. Para mais informações, consulte action policy.
-
Após configure os parâmetros, clique em OK.
Monitoramento de violação de cota
Clique em Create Alert para configure uma regra de alerta.
Selecione o Project para a regra de alerta. Este Project deve armazenar seus logs de erro globais e métricas.
-
Configure a condição de disparo e a política de alerta com base nos requisitos do seu negócio.
Defina os parâmetros conforme descrito na tabela a seguir. Mantenha os valores padrão para os demais parâmetros. Para mais informações, consulte Create Log Alert Monitoring Rules.
Parâmetro
Valor
Rule Name
Cota de Logstore excedida
Check Frequency
Intervalo fixo, 15 minutos
Query statistics
-
Type: Logstore
-
Authorization: Default
-
Logstore: internal-error_log
-
Time range: 15 minutes (Relative)
-
Query:
ImportantePor padrão, uma consulta retorna no máximo 100 resultados. Se você adicionar limit 1000 ao final da consulta, ela poderá retornar até 1.000 resultados.
* and (ErrorCode: ExceedQuota or ErrorCode: QuotaExceed or ErrorCode: ProjectQuotaExceed or ErrorCode:WriteQuotaExceed)| SELECT Project,
COUNT(1) AS count where ErrorMsg like '%logstore count %' GROUP BY Project ORDER BY count DESC LIMIT 1000
Group evaluation
No Grouping
Trigger Condition
-
O sistema dispara um alerta Critical se um Project exceder sua cota de Logstore mais de 10 vezes.
-
O sistema dispara um alerta Medium se um Project exceder sua cota de Logstore mais de uma vez.
-
Se os dados corresponderem à expressão
count > 10, a Severity do alerta será Critical. -
Se os dados corresponderem à expressão
count > 1, a Severity do alerta será Medium.
NotaDestination
Simple Log Service Notification
Alert Policy
Standard Mode
Action Policy
Selecione uma política de ação existente ou clique em Add para crie uma nova. Para mais informações, consulte action policy.
-
Após configure os parâmetros, clique em OK.
Monitoramento de grupos de máquinas
Monitoramento de uso em tempo real
Clique em Create Alert para configure uma regra de alerta.
Selecione o Project para a regra de alerta. Este Project deve armazenar seus logs de erro globais e métricas de monitoramento.
-
Configure a condição de disparo e a política de alerta conforme necessário.
Defina os parâmetros conforme descrito na tabela abaixo. Mantenha as configurações padrão para outros parâmetros. Para mais informações, consulte Create alert rules for logs.
Parâmetro
Valor
Rule Name
Uso de grupo de máquinas
Check Frequency
Intervalo fixo, 15 minutos
Query statistics
-
Type: Metricstore
-
Authorization: Default
-
Metricstore: internal-monitor-metric
-
Time Range: 15 Minutes (Relative)
-
Query:
ImportantePor padrão, uma instrução SQL pode retornar até 100 linhas. Se você adicionar
limit 1000ao final da instrução, ela poderá retornar até 1.000 linhas.* | select Project, region, round(count_machine_group/quota_machine_group * 100, 3) as machine_group_ratio from (SELECT A.id as Project , A.region as region, COALESCE(SUM(B.count_machine_group), 0) AS count_machine_group , cast(json_extract(A.quota, '$.machine_group') as double) as quota_machine_group FROM "resource.sls.cmdb.project" as A LEFT JOIN ( SELECT project, COUNT(*) AS count_machine_group FROM "resource.sls.cmdb.machine_group" as B GROUP BY project ) AS B ON A.id = B.project group by A.id, A.quota, A.region) where quota_machine_group is not null order by machine_group_ratio desc limit 1000
Group evaluation
Auto Label
Trigger Condition
-
Um alerta Critical é disparado se a contagem de grupos de máquinas em um Project exceder 90% de sua cota.
-
Um alerta Medium é disparado se a contagem de grupos de máquinas em um Project exceder 80% de sua cota.
-
Quando os dados corresponderem a
machine_group_ratio > 90, Severity: Critical. -
Quando os dados corresponderem a
machine_group_ratio > 80, Severity: Medium.
NotaDestination
SLS Notification
Alert Policy
Standard Mode
Action Policy
Selecione uma política de ação existente ou clique em Add para crie uma. Para mais informações, consulte Action policies.
-
Após configure os parâmetros, clique em OK.
Monitoramento de violação de cota
Clique em Create Alert para configure uma regra de alerta.
Selecione o Project para a regra de alerta. Este Project deve armazenar seus logs de erro globais e métricas de monitoramento.
-
Configure a condição de disparo e a política de alerta conforme necessário.
Defina os parâmetros conforme descrito na tabela abaixo. Mantenha as configurações padrão para outros parâmetros. Para mais informações, consulte Create alert rules for logs.
Parâmetro
Valor
Rule Name
Cota de grupo de máquinas excedida
Check Frequency
Intervalo fixo, 15 minutos
Query statistics
-
Type: Logstore
-
Authorization: Default
-
Logstore: internal-error_log
-
Time Range: 15 Minutes (Relative)
-
Query:
ImportantePor padrão, uma instrução SQL pode retornar até 100 linhas. Se você adicionar
limit 1000ao final da instrução, ela poderá retornar até 1.000 linhas.* and (ErrorCode: ExceedQuota or ErrorCode: QuotaExceed or ErrorCode: ProjectQuotaExceed or ErrorCode:WriteQuotaExceed)| SELECT Project, COUNT(1) AS count where ErrorMsg like '%machine group count%' GROUP BY Project ORDER BY count DESC LIMIT 1000
Group evaluation
No grouping
Trigger Condition
-
Um alerta Critical é disparado se mais de 10 erros de cota de grupo de máquinas forem registrados para um Project.
-
Um alerta Medium é disparado se mais de um erro de cota de grupo de máquinas for registrado para um Project.
-
Quando os dados corresponderem a
count > 10, Severity: Critical. -
Quando os dados corresponderem a
count > 1, Severity: Medium.
NotaDestination
SLS Notification
Alert Policy
Standard Mode
Action Policy
Selecione uma política de ação existente ou clique em Add para crie uma. Para mais informações, consulte Action policies.
-
Após configure os parâmetros, clique em OK.
Coleta do Logtail
Monitoramento de nível de uso
Clique em Create Alert para configure uma regra de alerta.
Selecione o Project para a regra de alerta. Este Project deve armazenar seus logs de erro globais e métricas de monitoramento.
-
Configure a condição de disparo e a política de alerta com base nos requisitos do seu negócio.
Defina os parâmetros conforme descrito na tabela a seguir. Mantenha os valores padrão para os demais parâmetros. Para mais informações, consulte Create a log alert monitoring rule.
Parâmetro
Valor
Rule Name
Uso de cota de configuração de coleta do Logtail
Check Frequency
intervalo fixo, 15 minutos
Query statistics
-
Type: Metricstore
-
Authorization: Default
-
Metricstore: internal-monitor-metric
-
time range: 15 minutes (relative)
-
query statement:
ImportantePor padrão, uma consulta retorna até 100 linhas. Se você adicionar
limit 1000ao final da instrução de consulta, ela poderá retornar até 1.000 linhas.* | select Project, region, round(count_logtail_config/quota_logtail_config * 100, 3) as logtail_config_ratio from (SELECT A.id as Project , A.region as region, COALESCE(SUM(B.count_logtail_config), 0) AS count_logtail_config , cast(json_extract(A.quota, '$.config') as double) as quota_logtail_config FROM "resource.sls.cmdb.project" as A LEFT JOIN ( SELECT project, COUNT(*) AS count_logtail_config FROM "resource.sls.cmdb.logtail_config" as B GROUP BY project ) AS B ON A.id = B.project group by A.id, A.quota, A.region) where quota_logtail_config is not null order by logtail_config_ratio desc limit 1000
Group evaluation
Auto Label
Trigger Condition
-
Se o número de configurações de coleta do Logtail em um Project exceder 90% da cota, um alerta Critical será disparado.
-
Se o número de configurações de coleta do Logtail em um Project exceder 80% da cota, um alerta Medium será disparado.
-
Quando os dados corresponderem à expressão
logtail_config_ratio > 90, severity: Critical. -
Quando os dados corresponderem à expressão
logtail_config_ratio > 80, severity: Medium.
NotaDestination
Simple Log Service Notification
Alert Policy
standard mode
Action Policy
Selecione uma política de ação existente ou clique em Add para crie uma. Para mais informações, consulte Action policies.
-
Após configure os parâmetros, clique em OK.
Monitoramento de violação de cota
Clique em Create Alert para configure uma regra de alerta.
Selecione o Project para a regra de alerta. Este Project deve armazenar seus logs de erro globais e métricas de monitoramento.
-
Configure a condição de disparo e a política de alerta com base nos requisitos do seu negócio.
Defina os parâmetros conforme descrito na tabela a seguir. Mantenha os valores padrão para os demais parâmetros. Para mais informações, consulte Create a log alert monitoring rule.
Parâmetro
Valor
Rule Name
Cota de configuração de coleta do Logtail excedida
Check Frequency
intervalo fixo, 15 minutos
Query statistics
-
Type: Logstore
-
Authorization: Default
-
Logstore: internal-error_log
-
time range: 15 minutes (relative)
-
query statement:
ImportantePor padrão, uma consulta retorna até 100 linhas. Se você adicionar
limit 1000ao final da instrução de consulta, ela poderá retornar até 1.000 linhas.* and (ErrorCode: ExceedQuota or ErrorCode: QuotaExceed or ErrorCode: ProjectQuotaExceed or ErrorCode:WriteQuotaExceed)| SELECT Project, COUNT(1) AS count where ErrorMsg like '%config count%' GROUP BY Project ORDER BY count DESC LIMIT 1000
Group evaluation
No Grouping
Trigger Condition
-
Exceder a cota de configuração do Logtail para um Project mais de 10 vezes dispara um alerta Critical.
-
Exceder a cota de configuração do Logtail para um Project mais de uma vez dispara um alerta Medium.
-
Quando os dados corresponderem à expressão
count > 10, severity: Critical. -
Quando os dados corresponderem à expressão
count > 1, severity: Medium.
NotaDestination
Simple Log Service Notification
Alert Policy
standard mode
Action Policy
Selecione uma política de ação existente ou clique em Add para crie uma. Para mais informações, consulte Action policies.
-
Após configure os parâmetros, clique em OK.
Monitoramento de tráfego de gravação do Project
Monitoramento de uso em tempo real
Clique em Create Alert para configure uma regra de alerta.
Selecione o Project para a regra de alerta. Este Project deve armazenar seus logs de erro globais e métricas.
-
Configure a condição de disparo do alerta e a política de alerta com base no seu cenário de negócios.
Defina os parâmetros conforme descrito na tabela a seguir e mantenha os valores padrão para os demais parâmetros. Para mais informações, consulte Create log alert monitoring rules.
Parâmetro
Valor
Rule Name
uso de cota de tráfego de gravação do Project
Check Frequency
Intervalo fixo, 15 minutos
Query statistics
-
Type: Metricstore
-
Authorization: Default
-
Metricstore: internal-monitor-metric
-
Time range: 15 minutes (relative)
-
Query statement:
ImportantePor padrão, uma instrução de consulta retorna até 100 linhas. Adicionar 'limit 1000' ao final da instrução permite que ela retorne até 1.000 linhas.
(*)| SELECT Project, region , round(count_inflow/cast(quota_inflow as double) * 100, 3) as inflow_ratio
FROM
(SELECT cmdb.id as Project, cmdb.region as region, COALESCE(M.name1,0) as count_inflow, round(cast(json_extract(cmdb.quota, '$.inflow_per_min') as double)/1000000000, 3) as quota_inflow  from "resource.sls.cmdb.project" as cmdb
LEFT JOIN (
    select project,  round(MAX(name1)/1000000000, 3) as name1 from (SELECT __time_nano__ as time, element_at( split_to_map(__labels__, '|', '#$#') , 'project') as project,   sum(CASE WHEN __name__ = 'logstore_origin_inflow_bytes' THEN __value__ ELSE NULL END) AS name1
    FROM "internal-monitor-metric.prom" where __name__ ='logstore_origin_inflow_bytes' and regexp_like(element_at( split_to_map(__labels__, '|', '#$#') , 'project') , '.*') group by project,time )group by project) AS M ON cmdb.id = M.project )order by inflow_ratio desc  limit 1000
Group evaluation
Auto Label
Trigger Condition
-
Exceder 90% da cota de tráfego de gravação de um Project dispara um alerta Critical.
-
Exceder 80% da cota de tráfego de gravação de um Project dispara um alerta Medium.
-
Dados correspondentes à expressão
inflow_ratio > 90disparam um alerta Critical. -
Dados correspondentes à expressão
inflow_ratio > 80disparam um alerta Medium.
NotaDestination
Simple Log Service Notification
Alert Policy
Standard mode
Action Policy
Selecione uma política de ação com base nos requisitos do seu negócio ou clique em Add para crie uma. Para mais informações, consulte Action policy.
-
Após configure os parâmetros, clique em OK.
Monitoramento de violação de cota
Clique em Create Alert para configure uma regra de alerta.
Selecione o Project para a regra de alerta. Este Project deve armazenar seus logs de erro globais e métricas.
-
Configure a condição de disparo do alerta e a política de alerta com base no seu cenário de negócios.
Defina os parâmetros conforme descrito na tabela a seguir e mantenha os valores padrão para os demais parâmetros. Para mais informações, consulte Create log alert monitoring rules.
Parâmetro
Valor
Rule Name
cota de tráfego de gravação do Project excedida
Check Frequency
Intervalo fixo, 15 minutos
Query statistics
-
Type: Logstore
-
Authorization: Default
-
Logstore: internal-error_log
-
Time range: 15 minutes (relative)
-
Query statement:
ImportantePor padrão, uma instrução de consulta retorna até 100 linhas. Adicionar 'limit 1000' ao final da instrução permite que ela retorne até 1.000 linhas.
* and (ErrorCode: ExceedQuota or ErrorCode: QuotaExceed or ErrorCode: ProjectQuotaExceed or ErrorCode:WriteQuotaExceed)| SELECT Project,
COUNT(1) AS count where ErrorMsg like '%Project write quota exceed: inflow%' GROUP BY Project ORDER BY count DESC LIMIT 1000
Group evaluation
No grouping
Trigger Condition
-
Exceder a cota de tráfego de gravação do Project mais de 10 vezes dispara um alerta Critical.
-
Exceder a cota de tráfego de gravação do Project mais de uma vez dispara um alerta Medium.
-
Dados correspondentes à expressão
count > 10disparam um alerta Critical. -
Dados correspondentes à expressão
count > 1disparam um alerta Medium.
NotaDestination
Simple Log Service Notification
Alert Policy
Standard mode
Action Policy
Selecione uma política de ação com base nos requisitos do seu negócio ou clique em Add para crie uma. Para mais informações, consulte Action policy.
-
Após configure os parâmetros, clique em OK.
Monitoramento de gravação do Project
Monitoramento de uso em tempo real
Clique em Create Alert para configure uma regra de alerta.
Selecione o Project que armazena seus logs de erro globais e métricas de monitoramento.
-
Configure a condição de disparo e a política de alerta com base nos requisitos do seu negócio.
Defina os parâmetros conforme mostrado na tabela a seguir. Mantenha os valores padrão para os demais parâmetros. Para mais informações, consulte Create a log alert rule.
Parâmetro
Valor
Rule Name
Uso de cota de operações de gravação do Project
Check Frequency
Intervalo fixo, 15 minutos
Query statistics
-
Type: MetricStore
-
Authorization: Default
-
MetricStore: internal-monitor-metric
-
Time Range: 15 minutes (relative)
-
Query Statement:
ImportantePor padrão, uma consulta retorna até 100 resultados. Se você adicionar
limit 1000ao final da consulta, ela poderá retornar até 1.000 resultados.(*)| SELECT Project, region, round(count_write_cnt/cast(quota_write_cnt as double) * 100, 3) as write_cnt_ratio FROM (SELECT cmdb.id as Project, cmdb.region as region, COALESCE(M.name1,0) as count_write_cnt, cast(json_extract(cmdb.quota, '$.write_cnt_per_min') as bigint) as quota_write_cnt from "resource.sls.cmdb.project" as cmdb LEFT JOIN ( select project, MAX(name1) as name1 from (SELECT __time_nano__ as time, element_at( split_to_map(__labels__, '|', '#$#') , 'project') as project, sum(CASE WHEN __name__ = 'logstore_write_count' THEN __value__ ELSE NULL END) AS name1 FROM "internal-monitor-metric.prom" where __name__ = 'logstore_write_count' and regexp_like(element_at( split_to_map(__labels__, '|', '#$#') , 'project') , '.*') group by project,time )group by project) AS M ON cmdb.id = M.project ) order by write_cnt_ratio desc limit 1000
Group evaluation
Auto Label
Trigger Condition
-
O SLS dispara um alerta Critical se as operações de gravação de um Project excederem 90% de sua cota.
-
O SLS dispara um alerta Medium se as operações de gravação de um Project excederem 80% de sua cota.
-
Quando os dados corresponderem a
write_cnt_ratio > 90, Severity: Critical. -
Quando os dados corresponderem a
write_cnt_ratio > 80, Severity: Medium.
NotaDestination
Notificação do SLS
Alert Policy
Standard Mode
Action Policy
Selecione uma política de ação conforme necessário ou clique em Add para crie uma nova. Para mais informações, consulte action policies.
Na seção Add Tag, defina title como
${alert_name} alert triggerede desc como${alert_name} alert triggered. -
Após configure os parâmetros, clique em OK.
Monitoramento de excesso de cota
Clique em Create Alert para configure uma regra de alerta.
Selecione o Project que armazena seus logs de erro globais e métricas de monitoramento.
-
Configure a condição de disparo e a política de alerta com base nos requisitos do seu negócio.
Defina os parâmetros conforme mostrado na tabela a seguir. Mantenha os valores padrão para os demais parâmetros. Para mais informações, consulte Create a log alert rule.
Parâmetro
Valor
Rule Name
Cota de operações de gravação do Project excedida
Check Frequency
Intervalo fixo, 15 minutos
Query statistics
-
Type: Logstore
-
Authorization: Default
-
Logstore: internal-error_log
-
Time Range: 15 minutes (relative)
-
Query Statement:
ImportantePor padrão, uma consulta retorna até 100 resultados. Se você adicionar
limit 1000ao final da consulta, ela poderá retornar até 1.000 resultados.* and (ErrorCode: ExceedQuota or ErrorCode: QuotaExceed or ErrorCode: ProjectQuotaExceed or ErrorCode:WriteQuotaExceed)| SELECT Project, COUNT(1) AS count where ErrorMsg like '%Project write quota exceed: qps%' GROUP BY Project ORDER BY count DESC LIMIT 1000
Group evaluation
No Grouping
Trigger Condition
-
O SLS dispara um alerta Critical se a cota de operações de gravação de um Project for excedida mais de 10 vezes.
-
O SLS dispara um alerta Medium se a cota de operações de gravação de um Project for excedida mais de uma vez.
-
Quando os dados corresponderem a
count > 10, Severity: Critical. -
Quando os dados corresponderem a
count > 1, Severity: Medium.
NotaDestination
Notificação do SLS
Alert Policy
Standard Mode
Action Policy
Selecione uma política de ação conforme necessário ou clique em Add para crie uma nova. Para mais informações, consulte action policies.
-
Após configure os parâmetros, clique em OK.
Ajuste de cota de recursos
Faça login no console do Simple Log Service.
-
Na seção Projects, clique naquele que deseja acessar.
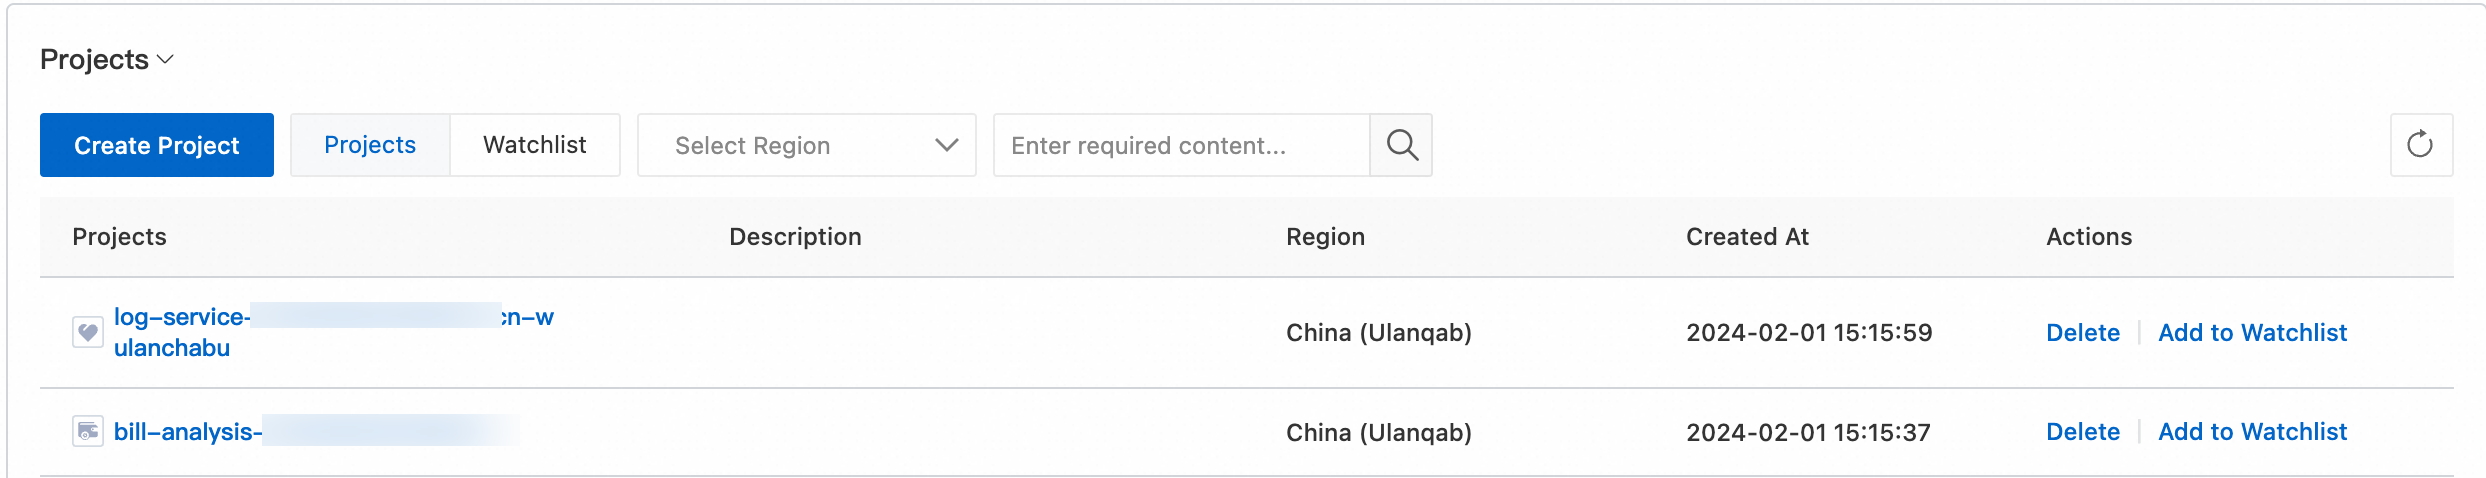
Clique no ícone
 .
Clique em Manage ao lado de Resource Quotas.
No painel Resource Quotas, ajuste as cotas para os recursos desejados e clique em Save.