O Simple Log Service (SLS) permite importar arquivos de log do Amazon S3 para consulta, análise e processamento. Há suporte para objetos individuais do S3 de até 5 GB (para objetos compactados, considera-se o tamanho após compressão).
Pré-requisitos
Faça upload dos arquivos de log para o Amazon S3.
Crie um projeto e um Logstore. {{XREF_0}}, {{XREF_1}}.
-
Configure permissões personalizadas:
-
Crie uma política personalizada que conceda permissões para gerenciar recursos do S3, conforme o exemplo a seguir (AWS: Conjuntos de permissões personalizadas).
NotaPermissões personalizadas do S3 são obrigatórias para importar arquivos no SLS.
{ "Version": "1", "Statement": [ { "Effect": "Allow", "Action": [ "s3:GetObject", "s3:ListBucket" ], "Resource": [ "arn:aws:s3:::your_bucket_name", "arn:aws:s3:::your_bucket_name/*" ] } ] } -
Crie uma política personalizada que conceda permissões para gerenciar recursos do SQS (AWS: Conjuntos de permissões personalizadas).
NotaIsso é necessário apenas se você ativar a integração com SQS. Uma fila SQS deve ser dedicada a uma única tarefa de importação. Não utilize a fila para outras tarefas de importação ou para qualquer outra finalidade. Se os dados na fila não corresponderem às condições de filtro da tarefa de importação, o sistema limpará os dados por padrão.
{
  "Effect": "Allow",
  "Action": [
    "sqs:ReceiveMessage",
    "sqs:DeleteMessage",
    "sqs:GetQueueAttributes",
    "kms:Decrypt"
  ],
  "Resource": "*"
}
-
Criar uma configuração de importação de dados
Faça login no console do Simple Log Service.
Acesse Import Data > Data Import e selecione S3 - Data Import.
Selecione o projeto e o Logstore de destino e clique em Next.
-
Configure as definições de importação.
-
Na etapa Import Configuration, defina os seguintes parâmetros.
Parâmetro
Descrição
Task Name
Nome exclusivo para o trabalho de Data Import.
S3 Region
Região onde o bucket de origem está localizado.
AWS AccessKey ID
AccessKey ID da AWS usado para acessar sua conta AWS.
ImportanteCertifique-se de que seu AccessKey ID tenha as permissões necessárias para acessar os recursos relevantes da AWS.
AWS Secret AccessKey
Secret AccessKey da AWS correspondente ao seu AccessKey ID.
SQS Queue URL
URL da fila SQS (AWS: Identificadores de fila e mensagem).
ImportanteEste parâmetro é obrigatório apenas se você ativar a integração com SQS.
File Path Prefix Filter
Filtra objetos do S3 pelo prefixo da chave. Por exemplo, defina o prefixo como
csv/para importar apenas objetos desse diretório.Se este parâmetro for deixado vazio, todo o bucket S3 será verificado.
NotaConfigure um prefixo para buckets grandes. A varredura completa de um bucket torna a importação mais lenta.
File Path Regex Filter
Filtra objetos do S3 por uma expressão regular que corresponde ao caminho completo do objeto. Apenas objetos correspondentes são importados. Vazio por padrão (sem filtragem).
Por exemplo, se um objeto S3 estiver em
testdata/csv/bill.csv, você pode definir a expressão regular como(testdata/csv/)(.*).{{XREF_2}}.
File Modification Time Filter
Filtra objetos do S3 pela última hora de modificação.
All: Selecione esta opção para importar todos os objetos que atendem às condições especificadas.
From Specific Time: Escolha esta opção para importar objetos modificados após um momento específico.
Specific Time Range: Utilize esta opção para importar objetos modificados dentro de um intervalo de tempo específico.
Data Format
Formato para análise dos arquivos de log:
CSV: Texto delimitado. É possível usar a primeira linha do arquivo como nomes de campo ou especificar manualmente os nomes. Cada linha subsequente é analisada como valores de uma entrada de log.
Single-line JSON: Lê o objeto S3 linha por linha e analisa cada linha como um objeto JSON. As chaves do objeto JSON tornam-se os nomes dos campos no log.
Single-line Text Log: Analisa cada linha no objeto S3 como uma entrada de log separada.
Multi-line Text Logs: Analisa várias linhas como uma única entrada de log. Você deve especificar uma expressão regular para corresponder ao início ou fim de uma entrada de log.
Compression Format
Formato de compactação dos objetos S3 de origem. O SLS descompacta os objetos com base no formato selecionado antes de ler os dados.
Encoding Format
Formato de codificação dos objetos S3 de origem. Apenas UTF-8 e GBK são suportados.
New File Check Cycle
Se novos objetos forem adicionados continuamente ao caminho S3 de origem, defina o New File Check Cycle conforme necessário. O trabalho de importação descobre e lê periodicamente novos objetos. Cada objeto S3 é importado no máximo uma vez.
Caso nenhum novo objeto seja adicionado, selecione Never Check. O trabalho será interrompido após importar todos os objetos correspondentes.
Log Time Configuration
Time Field
Se Data Format ou Single-line JSON for selecionado como Single-line JSON, você pode especificar um campo que contém o carimbo de data/hora. O SLS usa esse campo como timestamp do log.
Time Field Extraction Regular Expression
É possível usar uma expressão regular para extrair o timestamp do conteúdo do log.
Por exemplo, se uma entrada de log de amostra for 127.0.0.1 - - [10/Sep/2018:12:36:49 0800] "GET /index.html HTTP/1.1", você pode definir a Time Field Extraction Regular Expression como
[0-9]{0,2}\/[0-9a-zA-Z]+\/[0-9:,]+.NotaPara outros formatos de dados, também é possível usar uma expressão regular para extrair apenas parte de um campo de tempo.
Time Field Format
Formato usado para analisar o valor do campo de tempo.
Suporta sintaxe Java SimpleDateFormat, como
yyyy-MM-dd HH:mm:ss. {{XREF_3}}.Formatos Epoch são suportados, incluindo epoch, epochMillis, epochMicro e epochNano.
Time Zone
Selecione o fuso horário para o campo de tempo. Fusos horários não são necessários para formatos epoch.
Para considerar o horário de verão, selecione um formato UTC. Caso contrário, escolha um formato GMT.
NotaO fuso horário padrão é UTC+8.
Se você selecionar Data Format como Data Format, deverá configurar os parâmetros adicionais descritos na tabela a seguir.
-
Parâmetros específicos de CSV
Parâmetro
Descrição
Delimiter
Delimitador usado para separar campos. O valor padrão é vírgula (,).
Quote
Caractere de aspas usado para strings CSV.
Quote
Caractere de escape usado para escapar caracteres especiais. O valor padrão é barra invertida (\).
Maximum Lines
Se você ativar First Line as Field Name, a primeira linha do arquivo CSV será usada como nomes dos campos.
Custom Fields
Caso desative First Line as Field Name, será necessário especificar nomes de campo personalizados para os logs. Separe vários nomes de campo com vírgulas (,).
Lines to Skip
Número de linhas de log a serem ignoradas no início do arquivo. Por exemplo, se definido como 1, a coleta de dados começa na segunda linha do arquivo CSV.
-
Parâmetros específicos de log de texto multilinha
Parâmetro
Descrição
Position to Match Regular Expression
Posição para correspondência da expressão regular. As opções disponíveis são:
Regular Expression to Match First Line: Usa uma expressão regular para corresponder à primeira linha de uma entrada de log. Linhas sem correspondência são consideradas parte da entrada de log atual até atingir o número máximo de linhas.
Regular Expression to Match Last Line: Usa uma expressão regular para corresponder à última linha de uma entrada de log. Linhas sem correspondência são consideradas parte da próxima entrada de log até atingir o número máximo de linhas.
Regular Expression
Expressão regular que define o início ou fim de uma entrada de log.
{{XREF_4}}.
Maximum Lines
Número máximo de linhas para uma única entrada de log.
Clique em Preview para verificar o resultado da importação.
Após confirmar as configurações, clique em Next.
-
-
Visualize os dados, crie um índice e clique em Next.
O SLS ativa o índice de texto completo por padrão. Você também pode criar índices de campo manualmente ou clicar em Automatic Index Generation para gerá-los automaticamente. {{XREF_5}}.
ImportantePara consultar e analisar logs, é necessário ativar um índice de texto completo ou um índice de campo. Se ambos estiverem ativados, o índice de campo terá precedência.
Visualizar a configuração de importação
Consulte detalhes de configuração e relatórios estatísticos no console.
Na lista de projetos, clique no projeto de destino.
Na seção , localize o Logstore de destino, escolha e clique no nome da configuração.
Visualize as informações básicas e relatórios estatísticos da configuração de importação.
-
Também é possível modificar, iniciar, parar ou excluir a configuração de importação.
AvisoEsta operação não pode ser desfeita. Proceda com cautela.
Faturamento
O SLS não cobra pelo recurso Data Import. No entanto, taxas de transferência de dados e solicitações de API do seu provedor de nuvem podem ser aplicáveis. O modelo a seguir descreve custos potenciais. Consulte a fatura do seu provedor para verificar as cobranças reais.
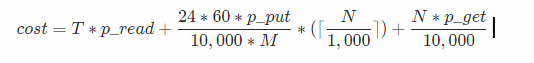
|
Campo |
Descrição |
|
T |
Volume total diário de importação de dados, em GB. |
|
p_read |
Custo por GB de tráfego de saída para a internet. |
|
p_put |
Custo por 10.000 solicitações PUT. |
|
p_get |
Custo por 10.000 solicitações GET. |
|
M |
Intervalo de verificação de novos arquivos, em minutos. Você pode definir o New File Check Cycle ao criar a configuração de importação de dados. |
|
N |
Número de objetos listáveis no bucket que correspondem ao prefixo especificado. |
Perguntas frequentes
Problema | Possível causa | Solução |
A pré-visualização não mostra dados. | Não há objetos no bucket S3, os objetos não contêm dados ou nenhum objeto corresponde às condições de filtro. |
|
Os dados importados contêm texto ilegível. | As configurações de Data Format, Compression Format ou Encoding Format não correspondem ao arquivo de origem. | Confirme o formato real dos objetos S3 e ajuste as configurações de Data Format, Compression Format ou Encoding Format adequadamente. Para corrigir dados ilegíveis existentes, é necessário criar um novo Logstore e uma nova configuração de importação. |
Os timestamps de log no SLS não correspondem aos timestamps nos dados de origem. | O campo de tempo do log não foi especificado, ou o formato de tempo/fuso horário foi configurado incorretamente na configuração de importação. | Especifique o campo de tempo do log e defina o formato de tempo e fuso horário corretos. {{XREF_6}}. |
Não é possível consultar ou analisar dados após a importação. |
|
|
O número de entradas de log importadas é menor que o esperado. | Entradas de log únicas maiores que 3 MB são descartadas durante a importação ({{XREF_10}}). | Ao gravar dados em arquivos S3, garanta que uma única linha de dados não exceda 3 MB. |
Alguns arquivos não foram importados. | As condições de filtro estão definidas incorretamente ou alguns arquivos excedem o limite de tamanho de 5 GB ({{XREF_11}}). |
|
Logs de texto multilinha são analisados incorretamente. | A expressão regular para corresponder à primeira ou última linha está incorreta. | Verifique se a expressão regular para corresponder à primeira ou última linha está correta. |
Alta latência na importação de novos arquivos. | Muitos objetos existentes correspondem ao filtro de prefixo de caminho de arquivo. | Se o número de objetos correspondentes ao filtro de prefixo for muito grande (por exemplo, mais de um milhão), defina um prefixo mais específico e crie múltiplos trabalhos de importação. Caso contrário, a descoberta de novos arquivos ficará significativamente mais lenta. |
Tratamento de erros
|
Erro |
Descrição |
|
Falha na leitura do arquivo |
Se a leitura falhar devido a problemas de rede, corrupção ou outros erros, o trabalho de importação tentará até três vezes antes de pular o arquivo. O intervalo de nova tentativa é igual ao New File Check Cycle. Se o New File Check Cycle estiver definido como Never Check, o intervalo será de 5 minutos. |
|
Erro de análise de formato de compactação |
Se ocorrer um erro de formato de compactação inválido durante a descompactação, o trabalho de importação pulará o arquivo. |
|
Erro de análise de formato de dados |
Quando a análise de dados falha, a tarefa de importação armazena o conteúdo de texto original no campo content do log. |
|
Bucket S3 inexistente |
O trabalho de importação tenta periodicamente. Após a recriação do bucket, a importação é retomada automaticamente. |
|
Erro de permissão |
Se ocorrer um erro de permissão ao ler do S3 ou gravar em um Logstore, o trabalho de importação tentará periodicamente e será retomado após a correção das permissões. Nenhum arquivo é pulado durante um erro de permissão. Após a resolução do problema, o trabalho importa todos os objetos não processados. |