Quando consultas usam filtros IN ou = em colunas de alta cardinalidade, o ApsaraDB for SelectDB ignora blocos de dados inteiros que não contêm o valor pesquisado. Os índices de filtro Bloom viabilizam essa otimização ao fornecer verificações probabilísticas de pertinência por bloco, reduzindo drasticamente a E/S em consultas seletivas de busca pontual.
Funcionamento
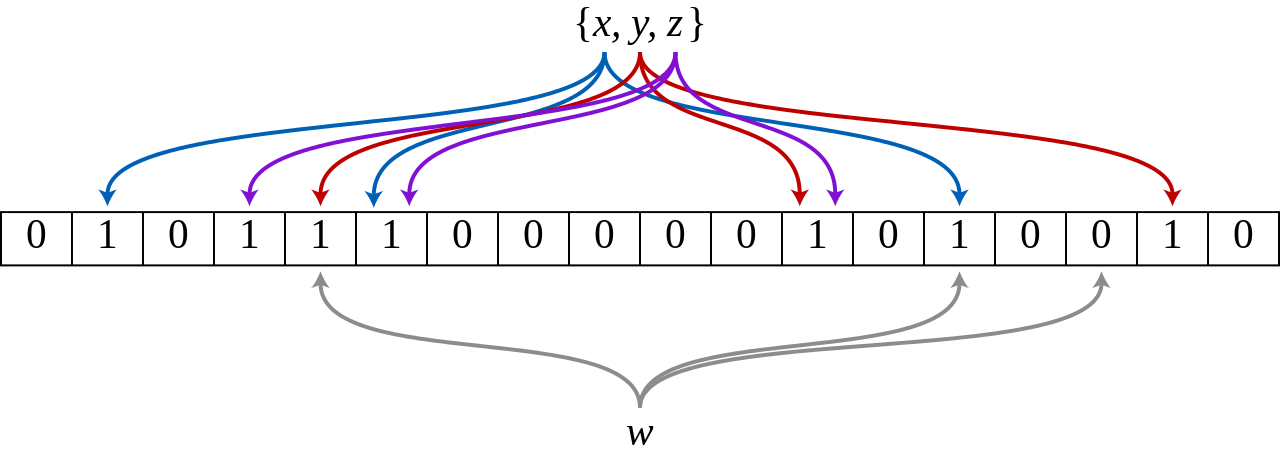
O filtro Bloom é uma estrutura de dados probabilística criada por Burton Howard Bloom em 1970. Ela consiste em um array de bits e uma série de funções de hash. Inicialmente, todos os bits têm valor 0. Ao adicionar um valor ao índice, cada função de hash o mapeia para uma posição de bit, que passa a ter o valor 1.
Durante a consulta, as mesmas funções de hash são aplicadas ao valor pesquisado:
Se alguma posição de bit resultante for 0, o valor está definitivamente ausente do bloco. O sistema ignora o bloco.
Caso todas as posições de bit resultantes sejam 1, o valor pode estar presente no bloco (são possíveis falsos positivos). O sistema lê o bloco.
No SelectDB, os índices de filtro Bloom são construídos por bloco. Para cada bloco, os valores da coluna indexada formam o conjunto do filtro Bloom.
O diagrama a seguir ilustra um filtro Bloom com m = 18 bits e k = 3 funções de hash. Os elementos x, y e z são mapeados no array de bits. Ao consultar o elemento w, uma de suas posições de hash aponta para um bit 0, confirmando que w está ausente neste bloco.
Limitações
Os índices de filtro Bloom apresentam as seguintes limitações:
Operadores não suportados: O índice acelera apenas as condições de filtroINe=. Outros operadores não recebem aceleração.
Tipos de dados não suportados: Não crie índices em colunas dos tiposTINYINT,FLOATouDOUBLE.
Colunas de baixa cardinalidade: Evite indexar colunas com poucos valores distintos. Por exemplo, uma coluna de gênero com apenas dois valores aparecerá em quase todos os blocos; assim, o índice não filtra nada e gera sobrecarga desnecessária. Para verificar se uma consulta usa um índice de filtro Bloom, abra o perfil da consulta e verifique as métricas relacionadas ao filtro Bloom.
Crie um índice
Especifique os índices de filtro Bloom por meio de bloom_filter_columns nas PROPERTIES da tabela.
Crie um índice durante a criação da tabela
Adicione "bloom_filter_columns"="<col1>,<col2>" à cláusula PROPERTIES da instrução CREATE TABLE, separando os nomes das colunas por vírgulas.
O exemplo a seguir cria índices de filtro Bloom nas colunas saler_id e category_id da tabela sale_detail_bloom:
CREATE TABLE IF NOT EXISTS sale_detail_bloom(
    sale_date date NOT NULL COMMENT "The date on which the product was sold",
    customer_id int NOT NULL COMMENT "The ID of the customer",
    saler_id int NOT NULL COMMENT "The ID of the seller",
    sku_id int NOT NULL COMMENT "The ID of the product",
    category_id int NOT NULL COMMENT "The ID of the category to which the product belongs",
    sale_count int NOT NULL COMMENT "The number of products that were sold",
    sale_price DECIMAL(12,2) NOT NULL COMMENT "The unit price of the product",
    sale_amt DECIMAL(20,2) COMMENT "The total sales amount"
)
Duplicate KEY(sale_date, customer_id, saler_id, sku_id, category_id)
distributed BY hash(customer_id) buckets 3
PROPERTIES("bloom_filter_columns"="saler_id, category_id");
Adicionar um índice a uma tabela existente
Execute ALTER TABLE ... SET para atualizar bloom_filter_columns em uma tabela existente. Substitua k1,k3 pelas colunas a indexar:
ALTER TABLE <db.table_name> SET ("bloom_filter_columns" = "k1,k3");As alterações de índice são aplicadas de forma assíncrona. Para monitorar o progresso, execute:
SHOW ALTER TABLE COLUMN;Visualize um índice
Execute SHOW CREATE TABLE para visualizar as colunas de filtro Bloom definidas para uma tabela:
SHOW CREATE TABLE <table_name>;Exemplo: visualize a configuração de índice para sale_detail_bloom:
SHOW CREATE TABLE sale_detail_bloom;A saída exibe a propriedade bloom_filter_columns no bloco PROPERTIES:
+-------------------+---------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+
| Table             | Create Table                                                                                                                                                                                                                                                                                                                                                                                                                                                                                                                                                                                                                                                                                                                                                                                |
+-------------------+---------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+
| sale_detail_bloom | CREATE TABLE `sale_detail_bloom` (
  `sale_date` datev2 NOT NULL COMMENT 'The date on which the product was sold',
  `customer_id` int(11) NOT NULL COMMENT 'The ID of the customer',
  `saler_id` int(11) NOT NULL COMMENT 'The ID of the seller',
  `sku_id` int(11) NOT NULL COMMENT 'The ID of the product',
  `category_id` int(11) NOT NULL COMMENT 'The ID of the category to which the product belongs',
  `sale_count` int(11) NOT NULL COMMENT 'The number of products that were sold',
  `sale_price` decimalv3(12, 2) NOT NULL COMMENT 'The unit price of the product',
  `sale_amt` decimalv3(20, 2) NULL COMMENT 'The total sales amount'
) ENGINE=OLAP
DUPLICATE KEY(`sale_date`, `customer_id`, `saler_id`, `sku_id`, `category_id`)
COMMENT 'OLAP'
DISTRIBUTED BY HASH(`customer_id`) BUCKETS 3
PROPERTIES (
"bloom_filter_columns" = "category_id, saler_id",
"light_schema_change" = "true"
);                               |
+-------------------+---------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+
1 row in set (0.03 sec)
Exclua um índice
Para remover índices de filtro Bloom de uma tabela, defina bloom_filter_columns como uma string vazia:
ALTER TABLE <db.table_name> SET ("bloom_filter_columns" = "");A criação, modificação e exclusão de índices são aplicadas de forma assíncrona. Para monitorar o progresso, execute:
SHOW ALTER TABLE COLUMN;Melhores práticas
Um índice de filtro Bloom atinge eficácia máxima quando três condições são atendidas simultaneamente:
A coluna não é a chave de ordenação principal (a filtragem baseada em prefixo já cobre esse caso).
As consultas na coluna usam frequentemente condições de filtro
INou=.A coluna possui alta cardinalidade, ou seja, muitos valores distintos em relação ao número de linhas por bloco, como IDs de usuário ou números de pedido.
When not to use a Bloom filter index: Se uma coluna tiver baixa cardinalidade — por exemplo, uma coluna de status com valores como active e inactive — é provável que todos os blocos contenham ambos os valores. O índice não filtra nada, mas ainda incorre em custo computacional a cada consulta. Nesse cenário, o índice de filtro Bloom prejudica o desempenho em vez de ajudar.