Quando uma instância Tair (Redis OSS-compatible) fica sem memória, podem ocorrer problemas como evicção frequente de chaves, aumento no tempo de resposta e QPS instável, o que afeta as operações comerciais. Se a memória da instância estiver cheia ou se você receber alertas de memória, use este tópico para determinar se o uso de memória está consistentemente alto, se houve um aumento repentino ou se há desbalanceamento. Em seguida, resolva o problema dividindo chaves grandes, definindo uma política de expiração ou atualizando as especificações da instância.
Cenários de alto uso de memória
O uso elevado de memória geralmente se enquadra em um dos três cenários a seguir:
O uso de memória permanece em um nível alto por um período prolongado. Geralmente, tome medidas quando o uso de memória exceder 95%.
O uso de memória é consistentemente baixo, mas apresenta um pico repentino, chegando às vezes a 100%.
O uso geral de memória da instância é baixo, porém o uso de memória de um nó de dados específico está próximo de 100%.
Para reduzir o uso de memória, aplique a solução correspondente ao seu cenário.
Soluções para uso de memória consistentemente alto
Verifique se as chaves existentes atendem aos requisitos do negócio e limpe prontamente quaisquer chaves desnecessárias.
-
Use o recurso de análise de cache para examinar a distribuição de chaves grandes e as políticas de expiração TTL. Para mais informações, consulte Offline key analysis.
-
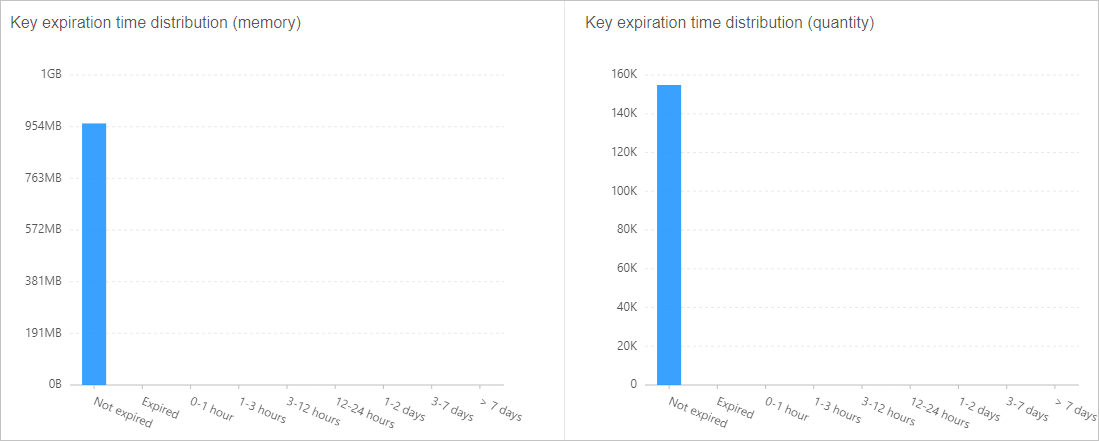
Analise se a chave possui uma política de TTL adequada.
NotaNo exemplo a seguir, nenhuma chave tem tempo de expiração definido. Recomendamos avaliar as necessidades do seu negócio e definir tempos de expiração apropriados no lado do cliente.
Figura 1. Exemplo de distribuição de tempo de expiração de chaves
-
Avalie a chave grande e divida-a no lado da aplicação.
Na página de análise de cache, clique na aba Large Key Analysis para visualizar os detalhes. A tabela exibe informações como nome da chave, tipo da chave e tamanho dos dados. Clique em Export para baixar os resultados da análise para sua máquina local.
-
-
Defina uma política de evicção adequada com base nos requisitos do seu negócio configurando o parâmetro maxmemory-policy. Para instruções específicas, consulte Set parameters.
NotaA política de evicção padrão para uma instância é volatile-lru. Para mais informações, consulte Eviction policies.
-
Configure uma frequência de execução razoável para exclusão ativa de chaves expiradas conforme as necessidades do seu negócio ajustando o valor do parâmetro hz. Para instruções específicas, consulte Adjust the execution frequency of scheduled tasks.
NotaRecomendamos definir o parâmetro hz com um valor inferior a 100. Um valor maior pode impactar significativamente o uso da CPU. Você também pode ativar o ajuste automático se sua instância for compatível com Redis 5.0 ou posterior. Para mais informações, consulte Enable dynamic frequency control for background tasks.
-
Se o uso de memória permanecer alto após as otimizações anteriores, considere atualizar para uma especificação com mais memória para lidar com mais dados e melhorar o desempenho. Para mais informações, consulte Change instance configuration.
NotaAntes de atualizar sua instância, adquira uma instância de pagamento conforme o uso para testar se a especificação alvo atende aos requisitos da sua carga de trabalho. Libere a instância após a conclusão do teste. Para informações sobre como liberar uma instância, consulte Release pay-as-you-go instances.
Soluções para aumentos repentinos de memória
Causas
Um aumento repentino no uso de memória pode ter as seguintes causas:
Um pico repentino de memória tem uma entre quatro causas possíveis. Use o indicador principal em cada linha para identificar qual se aplica ao seu caso.
|
Causa |
Indicador principal |
|
Grande volume de novos dados gravados |
Tráfego de entrada e QPS de gravação apresentam picos simultaneamente ao uso de memória |
|
Aumento súbito de novas conexões |
Contagem de conexões apresenta picos simultaneamente ao uso de memória |
|
Pico de tráfego causando acúmulo no buffer |
Uso de largura de banda atinge 100%; memória |
|
Cliente lento causando acúmulo no buffer de saída |
|
Grande volume de novos dados gravados
Uma entrada rápida de novos dados aumenta diretamente o consumo de memória.
Diagnosticar
Na página Performance Monitor, verifique o tráfego de entrada e as consultas de gravação por segundo (QPS). Se ambas as métricas seguirem a mesma tendência do uso de memória, o pico deve-se a um grande volume de novos dados.
Resolver
Defina valores apropriados de tempo de vida (TTL) nas chaves para expirar automaticamente dados desnecessários. Alternativamente, exclua manualmente as chaves desnecessárias.
Aumente a capacidade de memória da instância. Para detalhes, consulte Change the configurations of an instance.
Se sua instância for do tipo padrão e o uso de memória permanecer alto após o aumento da capacidade, atualize para uma instância cluster. Instâncias cluster distribuem dados entre múltiplos shards, reduzindo a pressão de memória em cada shard. Para detalhes, consulte Change the configurations of an instance.
Aumento súbito de novas conexões
Cada conexão de cliente reserva memória para seus buffers de entrada e saída. Um aumento repentino nas conexões causa uma elevação correspondente no uso total de memória.
Diagnosticar
Na página Performance Monitor, verifique o número de conexões. Se a contagem de conexões subir abruptamente junto com o uso de memória, um aumento súbito de conexões é a causa.
Resolver
Verifique se há vazamentos de conexão na sua aplicação.
Configure um tempo limite de conexão para fechar automaticamente conexões ociosas. Para detalhes, consulte Specify a timeout period for client connections.
Pico de tráfego causando acúmulo no buffer
Quando acessos em rajada geram tráfego que excede a largura de banda da rede da instância, os dados de entrada e saída acumulam-se nos buffers de entrada e saída. Esse acúmulo consome memória adicional além do armazenamento normal de dados.
Diagnosticar
Verifique se o uso de tráfego de entrada e saída atingiu 100%.
-
Execute
MEMORY STATSe verifique seclients.normalocupa uma quantidade excessiva de memória.Notaclients.normalreporta a memória total consumida pelos buffers de entrada e saída de todas as conexões normais de clientes. Um valor alto aqui confirma que o acúmulo no buffer está impulsionando o pico de memória.
Resolver
Identifique a causa do pico de tráfego.
Aumente a largura de banda da rede da instância. Para detalhes, consulte Manually increase the bandwidth of an instance e Enable bandwidth auto scaling.
Atualize as especificações da instância para fornecer capacidade de buffer suficiente. Para detalhes, consulte Change the configurations of an instance.
Cliente lento causando acúmulo no buffer de saída
Quando um cliente não consegue consumir respostas com rapidez suficiente, os dados não entregues acumulam-se no buffer de saída do servidor. O Redis aloca memória para cada resposta enfileirada, o que pode crescer significativamente quando os clientes ficam atrasados.
Diagnosticar
No redis-cli, execute MEMORY DOCTOR e verifique o valor de big_client_buf. Se big_client_buf for igual a 1, pelo menos um cliente possui um buffer de saída superdimensionado consumindo memória significativa.
Resolver
Execute CLIENT LIST e procure clientes com um valor alto de omem. O campo omem reporta a memória usada pelo buffer de saída de um cliente. Verifique se o cliente identificado apresenta problemas de desempenho que o impedem de consumir respostas com rapidez suficiente.
Soluções para alta memória em um nó de dados
Sintomas
Para instâncias com arquitetura cluster, o uso elevado de memória em um nó de dados específico é indicado pelos seguintes sintomas:
Você recebe um alerta de uso de memória do CloudMonitor. A mensagem de alerta indica que o uso de memória de um nó de dados específico excedeu o limiar.
O relatório de diagnóstico da instância mostra um desbalanceamento no uso de memória.
Na página de monitoramento de desempenho, você nota que o uso geral de memória da instância é baixo, mas um nó de dados específico apresenta alto uso de memória.
Causa
Se o uso geral de memória da instância estiver baixo enquanto o uso de um nó de dados específico estiver alto, isso indica um desbalanceamento no uso de memória.
Soluções
Verificar e dividir chaves grandes
Encontrar chaves grandes
Use o recurso offline key analysis para encontrar quaisquer chaves grandes.
Para mais métodos de localização de chaves grandes, consulte Large keys and hotkeys.
Dividir chaves grandes
Por exemplo, divida uma chave HASH com dezenas de milhares de membros em várias chaves HASH menores, cada uma com um número razoável de membros. Em uma instância cluster, dividir chaves grandes ajuda significativamente a equilibrar o uso de memória entre os shards de dados.
Verificar o uso de hash tag
Se você estiver usando uma hash tag que causa concentração de dados, considere dividi-la em múltiplas hash tags de acordo com a lógica da sua aplicação. Isso ajuda a distribuir os dados de forma mais uniforme entre diferentes shards de dados.
Atualizar a especificação da instância
Atualizar a especificação da instância aumenta a memória disponível para cada shard e pode ser uma solução temporária para desbalanceamento de memória. Para etapas detalhadas, consulte Change instance configuration.
O sistema inicia uma pré-verificação de desbalanceamento de dados durante a alteração da especificação da instância. Se o tipo de instância selecionado não conseguir lidar com o problema de desbalanceamento de dados, o sistema reportará um erro. Selecione um tipo de instância com especificações superiores e tente novamente.
Após atualizar as especificações da instância, o desbalanceamento de uso de memória pode ser aliviado. No entanto, o desbalanceamento também pode ocorrer em recursos de largura de banda e CPU.
Apêndice 1: Uso de memória do Redis
A memória de uma instância Redis consiste em três componentes principais:
Componente de memória | Descrição |
Memória de link (dinâmica) | Inclui memória para o buffer de entrada, buffer de saída, sobrecarga JIT, links falsos de Lua e o cache de execução Lua. Execute o comando INFO para verificar as informações de cache do cliente na seção Clients da saída. Nota Os buffers de entrada e saída estão associados a cada conexão de cliente e geralmente são pequenos. No entanto, ao executar operações baseadas em intervalo ou quando chaves grandes são transferidas lentamente, a memória usada por esses buffers pode aumentar, afetando a área de dados e podendo causar um erro de falta de memória (OOM). |
Memória de dados | Esta é a área de dados do usuário, que armazena as informações reais de valor. Geralmente é o foco principal da análise. |
Memória de gerenciamento (estática) | Esta área é pequena e relativamente constante após a inicialização. Consiste na sobrecarga de memória das tabelas hash de gerenciamento de dados, do buffer de replicação e do buffer AOF (aproximadamente 32 MB a 64 MB). Nota Para um número muito grande de chaves (por exemplo, centenas de milhões), esta área pode consumir uma quantidade significativa de memória. |
O gerenciamento ineficaz de memória dinâmica causa a maioria dos cenários de OOM. Por exemplo, o enfileiramento de requisições durante a limitação de taxa pode fazer com que a memória dinâmica aumente rapidamente. Scripts Lua excessivamente complexos ou mal escritos também podem levar a OOM. Para prevenir esses problemas, recomendamos Tair (Enterprise Edition), que fornece controle aprimorado sobre a memória dinâmica.