Quando uma única chave do TairSearch acumula muitos documentos, o uso de memória pode exceder a capacidade do shard de dados e causar um erro de out-of-memory (OOM). O comando TFT.MSEARCH resolve esse problema ao permitir a divisão de uma chave grande em chaves menores distribuídas por vários shards de dados, consultando todas elas em uma única solicitação. O TairProxy encaminha a solicitação para cada shard em paralelo; em seguida, pontua, classifica e agrega os resultados antes de retorná-los ao cliente.
Tipos de instância compatíveis
Recomendamos usar o TFT.MSEARCH com instâncias de divisão de leitura/gravação ou instâncias cluster no modo proxy que incluam o TairProxy. Não recomendamos usar o TFT.MSEARCH com instâncias cluster no modo de conexão direta ou com instâncias padrão sem o TairProxy.
Como funciona
O TairSearch oferece dois comandos de pesquisa:
|
Comando |
Escopo |
|
|
Consulta uma única chave |
|
|
Consulta várias chaves com a mesma configuração de schema |
Caminho de escrita
Ao receber solicitações de escrita do cliente, o TairProxy roteia cada chave para o shard de dados apropriado com base nos hash slots.
Figura 1. Caminho de escrita: TairProxy distribuindo chaves para shards de dados 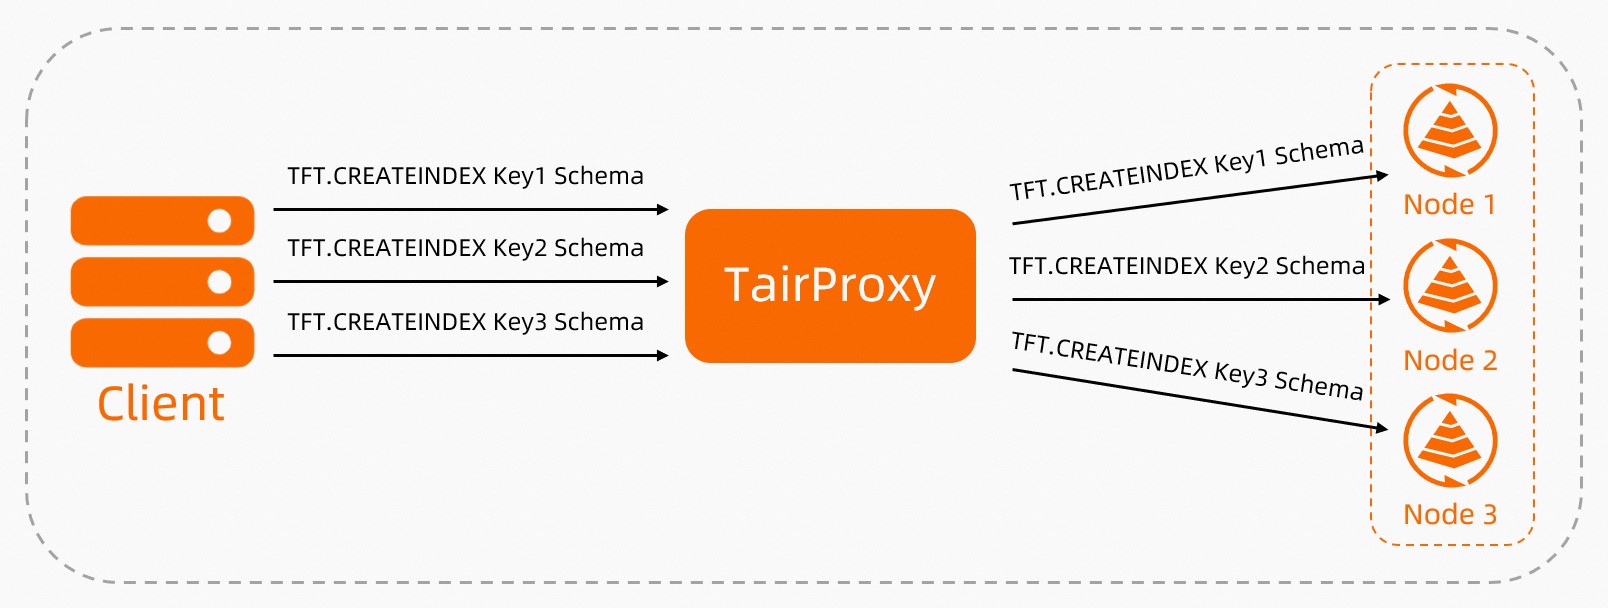
Caminho de leitura
Quando o cliente envia uma solicitação TFT.MSEARCH, o TairProxy executa as seguintes etapas:
Encaminha a consulta para cada shard de dados que contém as chaves solicitadas.
Cada shard pesquisa suas chaves e retorna os documentos correspondentes.
O TairProxy pontua, classifica e agrega todos os resultados.
Retorna o conjunto final de resultados ao cliente.
Figura 2. Caminho de leitura: TFT.MSEARCH entre shards de dados 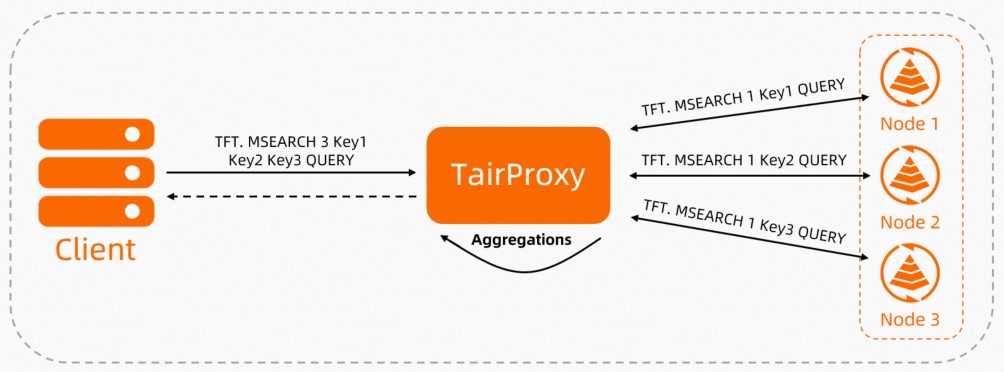
O TFT.MSEARCH exige a definição de uma lógica própria de divisão de chaves. O Tair não distribui documentos automaticamente entre as chaves. Você controla como os documentos são roteados e como as chaves são nomeadas.
Pré-requisitos
Antes de usar o TFT.MSEARCH:
Todas as chaves a serem pesquisadas devem compartilhar a mesma configuração de schema (
mappingsesettingsidênticos).Divida a chave grande em várias chaves menores e distribua-as pelos shards de dados de uma instância cluster. Se estiver usando uma instância standalone, atualize-a primeiro para uma instância cluster; depois, divida a chave grande em chaves menores e distribua-as aos shards de dados.
Pesquisar documentos entre shards de dados
Sintaxe do comando
TFT.MSEARCH <num_keys> <key1> [key2 ...] '<JSON query>'O primeiro argumento após TFT.MSEARCH indica o número de chaves a pesquisar. Esse valor deve corresponder à quantidade de nomes de chaves listados. O corpo da consulta JSON usa a mesma sintaxe do TFT.SEARCH.
Exemplo: pesquisar dados recentes em chaves semanais
Este exemplo demonstra como usar o TFT.MSEARCH para buscar conteúdo em alta armazenado em chaves particionadas por tempo.
Configuração do cenário:
Cada chave armazena uma semana de dados recentes — aproximadamente 1.000.000 de documentos por dia (7.000.000 por chave).
Uma nova chave é criada no início de cada semana e mantida por duas semanas. Chaves expiradas são excluídas.
Os nomes das chaves seguem o formato
FLOW_<start_date>_<end_date>.Cada documento possui quatro campos:
datetime(long),author(text),uid(long) econtent(text, analisado comjieba).
Etapa 1: Criar índices
Crie duas chaves com configurações de schema idênticas. O nome da chave codifica o intervalo de datas.
TFT.CREATEINDEX FLOW_20230109_15 '{
    "mappings": {
        "properties": {
            "datetime": {
                "type": "long"
            },
            "author": {
                "type": "text"
            },
            "uid": {
                "type": "long"
            },
            "content": {
                "type": "text",
                "analyzer": "jieba"
            }
        }
    }
}'

TFT.CREATEINDEX FLOW_20230116_23 '{
    "mappings": {
        "properties": {
            "datetime": {
                "type": "long"
            },
            "author": {
                "type": "text"
            },
            "uid": {
                "type": "long"
            },
            "content": {
                "type": "text",
                "analyzer": "jieba"
            }
        }
    }
}'
Etapa 2: Adicionar documentos
TFT.ADDDOC FLOW_20230109_15 '{
    "datetime": 20230109001209340,
    "author": "Hot TV series",
    "uid": 7884455,
    "content": "The movie will be screened during the Spring Festival"
}'

TFT.ADDDOC FLOW_20230116_23 '{
    "datetime": 20230118011304250,
    "author": "Fashionable commodities",
    "uid": 100093,
    "content": "Launch a new line of zodiac series products for the Year of the Rabbit"
}'
Etapa 3: Consultar ambas as chaves
Pesquise conteúdo relacionado a "Chinese zodiac of the Year of the Rabbit" em ambas as chaves, ordenado por tempo:
TFT.MSEARCH 2 FLOW_20230109_15 FLOW_20230116_23 '{
    "query": {
        "match": {
            "content": "Chinese zodiac of the Year of the Rabbit"
        }
    },
    "sort": [
        {"datetime": {"order": "desc"}}
    ],
    "size": 10,
    "reply_with_keys_cursor": true,
    "keys_cursor": {
        "FLOW_2023010916": 0,
        "FLOW_202301623": 0
    }
}'
Saída esperada:
{
    "hits": {
        "hits": [
            {
                "_id": "20230118011304250",
                "_index": "FLOW_20230116_23",       // (1)
                "_score": 1,
                "_source": {
                    "datetime": 20230118011304250,
                    "author": "Fashionable commodities",
                    "uid": 100093,
                    "content": "Launch a new line of zodiac series products for the Year of the Rabbit"
                }
            }
        ],
        "max_score": 1,
        "total": {
            "relation": "eq",
            "value": 1
        }
    },
    "aux_info": {
        "index_crc64": 14159192555612760957,
        "keys_cursor": {                            // (2)
            "FLOW_20230109_15": 0,
            "FLOW_20230116_23": 1
        }
    }
}
(1) O campo _index identifica a chave de origem do documento.
(2) O campo aux_info.keys_cursor representa o estado de paginação para a próxima solicitação. Um valor igual a 0 indica que nenhum documento dessa chave foi incluído nesta página.
Paginação com TFT.MSEARCH
O TFT.SEARCH usa from + size para paginação. O TFT.MSEARCH emprega um mecanismo diferente, pois os resultados vêm de múltiplas chaves independentes: size controla quantos documentos retornar, enquanto keys_cursor rastreia a posição dentro de cada chave para que a próxima consulta continue de onde a anterior parou.
Parâmetros de paginação
|
Parâmetro |
Tipo |
Obrigatório |
Descrição |
|
|
integer |
Sim |
Quantidade de documentos a retornar nesta página |
|
|
boolean |
Não |
Defina como |
|
|
object |
Não |
Posição inicial dentro de cada chave para a próxima consulta. Padrão: |
Funcionamento da paginação
Execute o TFT.MSEARCH com
sizee"reply_with_keys_cursor": true. O Tair buscasizedocumentos de cada chave; em seguida, pontua, classifica e agrega os melhoressizeresultados.A resposta inclui um objeto
keys_cursorque registra quantos documentos de cada chave foram consumidos para gerar essa página.Passe o valor de
keys_cursorrecebido na resposta como parâmetrokeys_cursorna próxima solicitação. O Tair retomará cada chave a partir da posição registrada.
Exemplo
Com size=10 e três chaves (key0, key1, key2):
O Tair busca 10 documentos de cada chave (30 no total), pontua e classifica-os, e retorna os 10 melhores.
-
Suponha que os 10 melhores resultados tenham sido extraídos dos primeiros 2 registros de
key0, dos primeiros 5 dekey1e dos primeiros 3 dekey2. A resposta incluirá:{"keys_cursor": {"key0": 2, "key1": 5, "key2": 3}} Na próxima consulta, passe esse valor de
keys_cursor. O Tair retomará a partir da posição 3 emkey0, posição 6 emkey1e posição 4 emkey2.