AI Agents precisam rastrear continuamente o contexto em conversas de múltiplas rodadas, tarefa que exige baixa latência e alta concorrência da camada de memória. Este artigo usa o cenário de "pedido de comida com uma frase" no Taobao Flash Sale como estudo de caso para demonstrar como construir um sistema de memória de curto prazo de alto desempenho para AI Agents usando estruturas de dados do Tair, bloqueios distribuídos e recursos de dimensionamento elástico.
Contexto de negócios
O AI Agent do Taobao Flash Sale permite aos usuários concluir todo o processo de pedido, das recomendações ao checkout e pagamento, usando linguagem natural. O objetivo é reduzir o tempo tradicional de pedido, de 3 a 5 minutos, para menos de 30 segundos.
Quando um usuário diz: "Peça para mim um Baiya Juexian da Chagee com menos açúcar, sem gelo e entregue no meu escritório", o AI Agent subjacente deve concluir uma série de operações em segundos: reconhecimento de intenção, análise de endereço, busca de product, correspondência de especificações, adição de itens ao carrinho e finalização do pedido. Cada etapa depende de uma memória precisa da conversa anterior.
No projeto de "pedido de comida com uma frase", colaboração entre Taobao Flash Sale e Qianwen, o Tair atua como núcleo da camada de memória de curto prazo do AI Agent. Com base nesse cenário real de negócios, este artigo apresenta práticas essenciais para gerencie memória de AI Agents com o Tair, incluindo design de modelo de dados e controle de concorrência.
Cenários aplicáveis
Os padrões de design deste tópico aplicam-se aos seguintes cenários de AI Agent:
Agentes conversacionais que mantêm contexto em conversas de múltiplas rodadas, como bots de atendimento ao cliente, assistentes de compras e assistentes pessoais.
Cenários interativos em tempo real sensíveis à latência de ponta a ponta, exigindo operações de leitura e gravação na memória no nível de milissegundos.
Invocações simultâneas de múltiplas ferramentas com risco de gravações concorrentes, como quando um AI Agent chama várias ferramentas ao mesmo tempo.
Serviços online com tráfego flutuante que demandam dimensionamento elástico.
Por que sistemas de memória precisam do Tair
O sistema de memória de um AI Agent é extremamente sensível à latência. De acordo com a Lei de Little (Concorrência ≈ QPS × Latência), se a latência de acesso à memória aumentar de 5 ms para 50 ms, o número de requisições em trânsito multiplica-se por dez. Isso pode esgotar rapidamente recursos como conexões, threads e filas. Como cada rodada de conversa envolve múltiplas leituras e gravações na memória, a latência acumula-se, podendo causar enfileiramento, timeouts e até falhas em cascata.
A diferença entre 5 ms e 50 ms não é apenas uma otimização de experiência do usuário; é a linha divisória entre um sistema capaz de escalar estavelmente e um que não consegue. Essa é a razão principal pela qual o AI Agent do Taobao Flash Sale escolheu o Tair para sua camada de memória. Com seu kernel multithread proprietário, o Tair oferece baixa latência estável. Isso mantém o acesso à memória dentro de um limiar seguro, prevenindo fundamentalmente um ciclo vicioso de degradação de desempenho sob alta concorrência.
Arquitetura geral
A camada de memória (Memory service) do AI Agent do Taobao Flash Sale situa-se entre o orquestrador do agente e os serviços de ferramentas subjacentes, usando o Tair para gerencie o estado no nível de sessão.
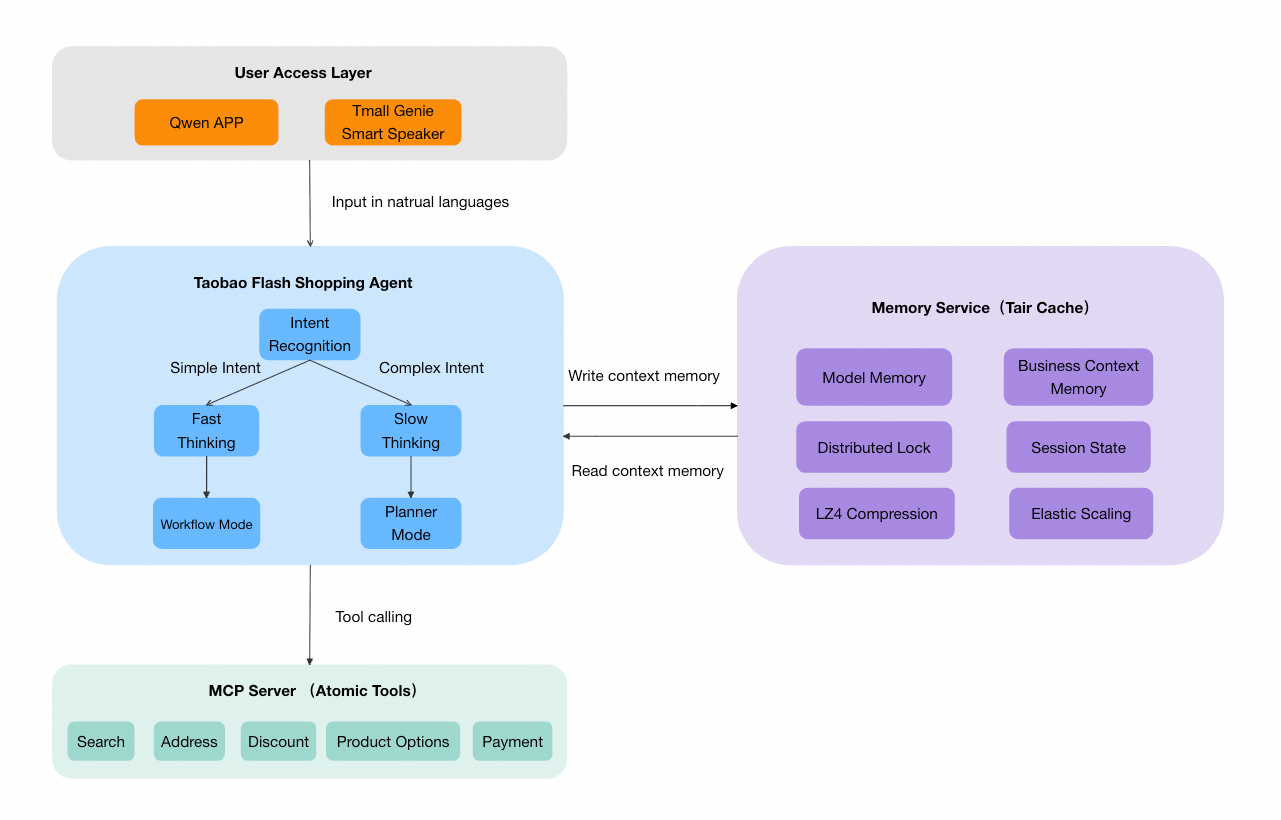
Classificação de memória e modelo de dados
O AI Agent do Taobao Flash Sale escolheu o Tair como mecanismo de armazenamento de memória de curto prazo por vários motivos principais:
Baixa latência: O fluxo conversacional de um agente é extremamente sensível ao tempo de resposta. O kernel multithread proprietário do Tair fornece capacidades de leitura e gravação no nível de microssegundos, atendendo às demandas de interação em tempo real.
Estruturas de dados variadas: O Tair permite mapear diferentes tipos de memória para as estruturas de dados mais adequadas, simplificando o desenvolvimento de aplicações.
Dimensionamento elástico: O Tair suporta dimensionamento contínuo de cluster e largura de banda expansível, permitindo expansão rápida durante picos de tráfego sem impactar as operações de negócios.
Gerenciamento de ciclo de vida via TTL: A memória de sessão expira naturalmente, e o mecanismo de TTL remove automaticamente os dados vencidos.
A memória de curto prazo divide-se em duas categorias principais, cada uma mapeada para uma estrutura de dados diferente do Tair:
Memória do modelo — List
A memória do modelo armazena o histórico de conversas para processamento pelo modelo de linguagem grande (LLM). Em cada rodada, o agente registra a entrada do usuário e sua própria resposta, passando-os como contexto para o modelo durante a próxima inferência.
Esse histórico fica armazenado em uma List do Tair, com uma chave por sessão:
Key:  memory:model:{sessionId}
Type: List

Example data:
[
  {"role": "user",      "content": "I'd like to order a milk tea."},
  {"role": "assistant", "content": "I found 3 milk tea shops near you...", "cards": [...]},
  {"role": "user",      "content": "This one, less sugar and no ice."},
  {"role": "assistant", "content": "Selected: Baiya Juexian, less sugar, no ice, large..."}
]
Operações principais:
# After each conversation turn, append the new dialogue record
RPUSH memory:model:{sessionId} "{Conversation Record JSON}"

# Before model inference, read the last N turns as context
LRANGE memory:model:{sessionId} -{N} -1

# Set a session expiration time (e.g., 30 minutes)
EXPIRE memory:model:{sessionId} 1800O sistema converte dados brutos de conversa, incluindo texto e rich media como cards, em um formato de linguagem natural que o modelo compreende mais facilmente. Isso reduz o consumo de tokens.
Memória de contexto de negócios — Hash
A memória de contexto de negócios armazena informações de estado estruturadas do processo de negócios. A camada de ferramentas do agente e os processadores de intenção consultam e atualize essas informações ao executar a lógica de negócios.
Essa memória divide-se em seis submódulos por domínio de negócios e fica armazenada em um Hash do Tair:
Key:  memory:context:{sessionId}
Type: Hash

Field structure:
{
  "session":      "{Session metadata: user ID, channel, session stage, etc.}",
  "search":       "{Search status: current query, search results, recommended product list, etc.}",
  "order":        "{Order status: shopping cart contents, selected SKU, item quantity, etc.}",
  "conversation": "{Conversation status: current intent, previous intent, intent switch flag, etc.}",
  "coupon":       "{Coupon information: available coupons, selected coupon, etc.}",
  "bizState":     "{Business state: shipping address, delivery method, payment status, etc.}"
}
Operações principais:
# Update a single sub-module (e.g., when the user confirms a shipping address)
HSET memory:context:{sessionId} bizState "{Updated Business State JSON}"

# Read a specific sub-module
HGET memory:context:{sessionId} order

# Read all context at once (for scenarios requiring global information, like intent recognition)
HGETALL memory:context:{sessionId}

# Set an expiration time
EXPIRE memory:context:{sessionId} 1800As capacidades de leitura e gravação no nível de campo da estrutura de dados Hash permitem atualize cada módulo de negócios independentemente, sem interferir nos demais. Isso evita condições de corrida associadas a padrões de leitura-modifique-gravação em um objeto json completo. Por exemplo, quando o módulo de busca atualize as recomendações de products, isso não afeta o módulo de pedidos, que pode estar gravando dados no carrinho de compras simultaneamente.
Comparação de estruturas de dados
|
Tipo de memória |
Estrutura de dados |
Motivo |
|
Histórico de conversas |
List |
Conversas são dados de séries temporais ordenados. A estrutura de dados List suporta anexações ordenadas (RPUSH) e leituras por intervalo (LRANGE). |
|
Memória de contexto de negócios |
Hash |
A memória divide-se em vários campos por domínio. A estrutura de dados Hash suporta leituras e gravações independentes no nível de campo, prevenindo condições de corrida. |
|
Sinalizadores de estado de sessão |
String |
A estrutura de dados String é adequada para sinalizadores de estado atômicos (como o estágio da sessão) que exigem operações simples. |
|
Bloqueio distribuído |
String |
Implementado usando SET NX EX para garantir segurança de concorrência. |
Segurança de concorrência: Bloqueios distribuídos
Em aplicações reais, podem ocorrer gravações concorrentes na mesma sessão. Por exemplo, se um usuário enviar mensagens em rápida sucessão ou fornecer novas entradas enquanto uma resposta em streaming está em andamento, múltiplas requisições podem tentar modifique os dados de memória da mesma sessão simultaneamente.
O AI Agent do Taobao Flash Sale usa um bloqueio distribuído do Tair para proteger a consistência de leitura e gravação da memória. O bloqueio aplica-se no nível individual da sessão:
# Acquire a session-level distributed lock (with a 3-second timeout to prevent deadlocks)
SET lock:memory:{sessionId} {requestId} NX EX 3

# After acquiring the lock, perform memory read and write operations
HSET memory:context:{sessionId} order "{Updated Order Status}"
RPUSH memory:model:{sessionId} "{New Conversation Record}"

# Release the lock after the operation is complete (using a Lua script to ensure only the lock owner can release it)
EVAL
  if redis.call('GET', KEYS[1]) == ARGV[1] then
    return redis.call('DEL', KEYS[1])
  else
    return 0
endA granularidade do bloqueio está no nível da sessão (sessionId), não sendo um bloqueio global. Isso significa que não há contenção de bloqueio entre sessões de usuários diferentes, evitando impacto no throughput geral do sistema. O timeout do bloqueio é defina em alguns segundos para prevenir bloqueios prolongados caso o processo detentor do bloqueio encerre inesperadamente.
Lidando com picos de tráfego
Durante o evento de Pacotes Vermelhos do Festival da Primavera do Qianwen, o AI Agent do Taobao Flash Sale lidou com uma carga de concorrência mais de 10 vezes superior ao pico estimado. Cada conversa de usuário pode acionar dezenas de operações do Tair (leitura de histórico, update de estado, operações de bloqueio, etc.), amplificando as requisições concorrentes do agente em um volume de operações do Tair de uma ordem de grandeza maior.
A camada de memória do AI Agent do Taobao Flash Sale é construída sobre o Tair (compatível com Redis). Em comparação com uma implantação de Redis autogerenciada, as vantagens do Tair em desempenho de kernel, dimensionamento elástico e operações foram críticas para lidar com esse pico de tráfego.
Desempenho do kernel do Tair
O Tair utiliza um modelo multithread, entregando até três vezes o desempenho de leitura e gravação de uma instância de Redis open source da mesma especificação. Isso significa que, para o mesmo tamanho de instância, o Tair consegue lidar com três vezes o throughput operacional do Redis open source.
Essa vantagem de desempenho é particularmente crítica em cenários de AI Agent. Uma única conversa de usuário pode acionar dezenas de operações do Tair, como leitura de histórico de conversas, update de contexto de negócios e aquisição ou liberação de bloqueios distribuídos. Com o modelo single-threaded do Redis open source, o banco de dados pode facilmente tornar-se um gargalo sob alta concorrência. O kernel multithread do Tair permite que um único nó utilize totalmente os recursos de CPU multicore, possibilitando lidar com maior concorrência sem necessidade de adicionar mais nós.
Dimensionamento elástico e contínuo
No fluxo conversacional de um agente, os dados de memória exibem um padrão típico de leitura intensiva: o agente deve ler o histórico completo de conversas e o contexto de negócios antes de cada rodada de inferência (operações de leitura), enquanto uma operação de gravação ocorre apenas para anexar um novo registro ao final de cada rodada. A proporção de leitura para gravação geralmente fica entre 5:1 e 10:1.
O Tair suporta uma arquitetura de cluster com divisão de leitura/gravação. O Tair distribui automaticamente as requisições de leitura para as réplicas de leitura, enquanto as requisições de gravação são roteadas para o nó primário. É possível ajustar flexivelmente o número de réplicas de leitura de 1 a 9 e dimensionar horizontalmente o cluster de 2 a 256 shards. Aumente linearmente o throughput adicionando réplicas de leitura ou shards antes de um pico de tráfego e reduza-os depois para diminuir custos.
Exemplo
Tráfego normal: Um cluster de 8 shards com 1 réplica de leitura por shard atende às necessidades diárias de negócios.
Evento do Festival da Primavera (pico de tráfego de 5x a 10x):
Opção 1: Expandir para 5 réplicas de leitura por shard para aumentar linearmente o throughput de leitura.
Opção 2: Expandir para um cluster de 16 shards com 3 réplicas de leitura por shard para dobrar a capacidade de leitura e gravação.
Essas operações de dimensionamento são completamente transparentes para seus serviços. Clusters tradicionais de Redis podem gerar erros como -ASK e -TRYAGAIN durante a migração de slots. Para cenários conversacionais baseados em agentes, qualquer falha de requisição pode levar à interrupção da conversa ou perda de memória. A edição cloud-native do Tair alcança dimensionamento contínuo por meio de otimizações no nível de kernel — os dados migram atomicamente como um slot inteiro (em vez de chave por chave), prevenindo a divisão de slots. Simultaneamente, um componente de controle centralizado coordena o comportamento do cluster, resultando em maior eficiência de migração e tomada de decisão mais precisa.
Durante a fase final da migração de dados, a latência das requisições de gravação para o slot correspondente pode aumentar ligeiramente, mas as requisições não falharão. Para o service de memória do agente, isso significa que algumas requisições podem experimentar um pequeno aumento na latência, mas não haverá perda de dados ou erros de requisição.
Dimensionamento elástico de largura de banda
Além da pressão de QPS, o evento também apresentou um desafio significativo de largura de banda. Cada leitura de memória pelo AI Agent envolve a transferência de histórico de conversas e contexto de negócios, resultando em uma carga de dados por requisição muito maior em comparação com leituras simples de chave-valor em cenários tradicionais de cache. Durante os horários de pico de negócios, a largura de banda pode tornar-se um gargalo antes da CPU ou da memória.
A arquitetura do Tair fornece duas camadas de elasticidade:
Dimensionamento horizontal para largura de banda do cluster: Em uma arquitetura de cluster, aumente a largura de banda total da instância adicionando mais balanceadores de carga (LBs). Um único LB tem limite de largura de banda de 20 Gbps. Quando o número de shards excede oito, adicione LBs conforme necessário sem interromper as conexões existentes.
-
Largura de banda expansível: Quando o tráfego instantâneo excede a largura de banda fixa, o sistema dimensiona automaticamente a largura de banda em segundos (até um máximo de 288 MB/s por nó). O sistema libera automaticamente a largura de banda quando o tráfego diminui e cobra apenas pelo valor de burst utilizado. A largura de banda expansível opera independentemente para cada shard. Se um shard sofrer gargalo de largura de banda devido a uma hot key, apenas a largura de banda desse shard será expandida automaticamente, deixando os outros shards inalterados.
NotaA largura de banda expansível é particularmente adequada para picos de tráfego imprevisíveis comuns em cenários de AI Agent. Em comparação com a pré-compra de um pacote de largura de banda fixa de alta especificação, o bursting sob demanda é mais econômico.
Limpeza automática via TTL
Ao defina um TTL razoável (por exemplo, 30 minutos) em todas as chaves de sessão, o uso de memória diminui automaticamente após os picos de tráfego, sem intervenção manual. Combinado com o dimensionamento elástico do Tair, isso permite gerenciamento de recursos totalmente automatizado: expansão para picos, redução para vales e limpeza automática de dados expirados.
Como resultado, todo o service de memória permaneceu estável durante o surto de tráfego do Festival da Primavera, com a latência P99 consistentemente controlada no nível de milissegundos.
Resumo e perspectivas
No caso de uso de "pedido de comida com uma frase" para o Taobao Flash Sale, o Tair serviu como armazenamento principal para a camada de memória de curto prazo do AI Agent, fornecendo as seguintes capacidades essenciais:
|
Capacidade |
Implementação |
Problema resolvido |
|
Acesso de baixa latência |
Leituras e gravações em memória com Tair |
Atende aos requisitos de tempo real do fluxo conversacional do agente. |
|
Modelagem flexível de dados |
Combinação de estruturas de dados List, Hash e String |
Adapta-se a diferentes tipos de memória, como histórico de conversas e contexto de negócios. |
|
Gerenciamento de ciclo de vida |
Expiração automática com TTL |
Remove dados automaticamente após o término de uma sessão, reduzindo custos operacionais. |
|
Segurança de concorrência |
Bloqueios distribuídos (SET NX EX) |
Garante consistência de dados durante gravações concorrentes de múltiplas requisições. |
|
Resiliência elástica |
Divisão de leitura/gravação e largura de banda expansível |
Suporta picos massivos de tráfego (como um pico de 10x durante o evento do Festival da Primavera) com elasticidade contínua. |
À medida que a tecnologia de AI Agent evolui, o gerenciamento de memória avança para níveis mais profundos. Planos futuros incluem a construção de capacidades de memória de longo prazo para armazenar preferências de usuários e padrões históricos de comportamento. Isso permitirá ao agente lembrar não apenas "o que foi dito nesta conversa", mas também "quem é este usuário e do que ele gosta".
O sistema de memória para AI Agents está evoluindo do "nível de conversa" para o "nível de usuário", e o Tair continuará a desempenhar um papel crítico nessa evolução.