À medida que as cargas de trabalho de monitoramento aumentam, um único coletor frequentemente não consegue sustentar gravações de alta frequência, e a latência de consulta cresce sob carga concorrente. O TairTS, módulo de séries temporais integrado ao Tair (Enterprise Edition), resolve ambos os problemas com consultas de latência em milissegundos e acumulação de gravações segura para concorrência. Este tópico mostra como usar o TairTS para criar um sistema de monitoramento de granularidade fina.
Conceitos principais
O TairTS organiza dados de séries temporais usando dois identificadores:
|
Identificador |
Função |
Exemplo |
|
pkey (chave primária) |
Agrupa séries temporais relacionadas |
|
|
skey (chave secundária) |
Identifica uma série específica dentro do grupo |
|
Outros recursos essenciais:
|
Recurso |
Descrição |
|
Compressão Gorilla |
Reduz custos de armazenamento ao aplicar o algoritmo Gorilla com um layout otimizado para dados de séries temporais |
|
TTL por skey |
Cada skey possui seu próprio tempo de vida (TTL), o que permite a renovação automática dos dados com base em janelas de tempo |
|
Agregação em comando único |
Execute consultas em lote com downsampling, filtragem baseada em atributos e filtragem multinível em um único comando para reduzir a interação de rede |
Arquitetura
Figura 1. Arquitetura de monitoramento de granularidade fina 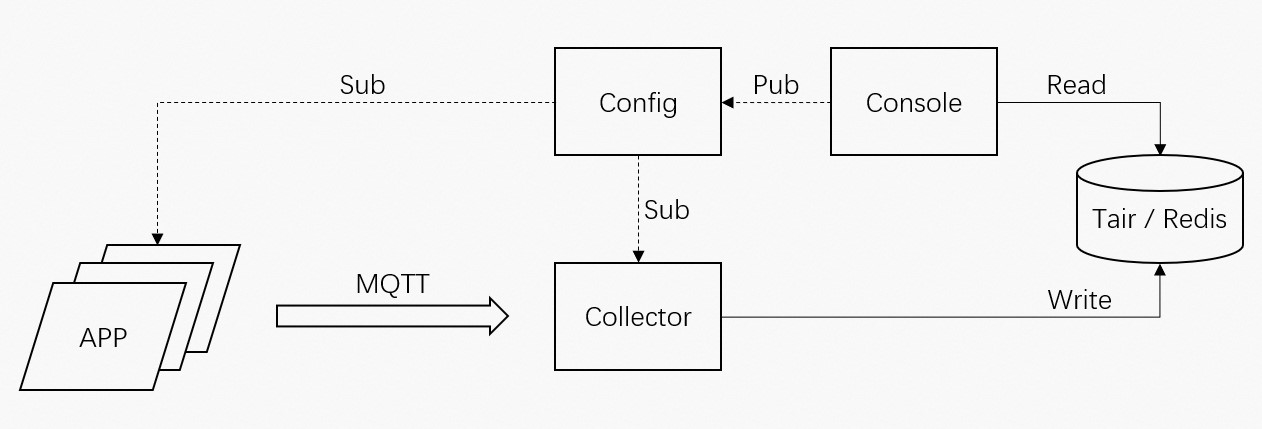
O sistema de monitoramento funciona da seguinte forma:
O console envia configurações de monitoramento de granularidade fina para a aplicação.
A aplicação envia as configurações para os coletores usando MQ Telemetry Transport (MQTT).
Os coletores processam os dados recebidos e os gravam nos bancos de dados Tair usando comandos do TairTS.
Gerencie consultas de alta concorrência
O TairTS suporta operações agregadas — downsampling, filtragem baseada em atributos, consulta em lote e filtragem multinível com funções numéricas — tudo em uma única consulta. Isso reduz a interação de rede e retorna resultados em milissegundos, permitindo a detecção imediata de problemas.
Gerencie gravações de alta concorrência
Conforme as aplicações escalam, um único coletor pode não acompanhar o volume de gravações recebidas. O TairTS resolve isso com o comando extsrawincr, que acumula valores entre gravações concorrentes em vez de sobrescrevê-los. Vários coletores gravando na mesma skey e no mesmo timestamp produzem um resultado cumulativo correto, reduzindo o uso de memória sem perda de dados.
O exemplo a seguir demonstra gravações concorrentes de dois coletores na mesma pkey (cpu_load) e skey (app1):
import com.aliyun.tair.tairts.TairTs;
import com.aliyun.tair.tairts.params.ExtsAggregationParams;
import com.aliyun.tair.tairts.params.ExtsAttributesParams;
import com.aliyun.tair.tairts.results.ExtsSkeyResult;
import redis.clients.jedis.Jedis;

public class test {

    protected static final String HOST = "127.0.0.1";
    protected static final int PORT = 6379;

    public static void main(String[] args) {
        try {
            Jedis jedis = new Jedis(HOST, PORT, 2000 * 100);
            if (!"PONG".equals(jedis.ping())) {
                System.exit(-1);
            }
            TairTs tairTs = new TairTs(jedis);
            // Use the following code if you want to work with a cluster instance:
            //TairTsCluster tairTsCluster = new TairTsCluster(jedisCluster);

            String pkey = "cpu_load";
            String skey1 = "app1";
            long startTs = (System.currentTimeMillis() - 100000) / 1000 * 1000;
            long endTs = System.currentTimeMillis() / 1000 * 1000;
            String startTsStr = String.valueOf(startTs);
            String endTsStr = String.valueOf(endTs);

            tairTs.extsdel(pkey, skey1);
            long num = 5;

            // Concurrently update data in Collector A.
            for (int i = 0; i < num; i++) {
                double val = i;
                long ts = startTs + i*1000;
                String tsStr = String.valueOf(ts);
                ExtsAttributesParams params = new ExtsAttributesParams();
                params.dataEt(1000000000);
                String addRet = tairTs.extsrawincr(pkey, skey1, tsStr, val, params);
            }

            ExtsAggregationParams paramsAgg = new ExtsAggregationParams();
            paramsAgg.maxCountSize(10);
            paramsAgg.aggAvg(1000);

            System.out.println("Updated result of Collector A:");
            ExtsSkeyResult rangeByteRet = tairTs.extsrange(pkey, skey1, startTsStr, endTsStr, paramsAgg);
            for (int i = 0; i < num; i++) {
                System.out.println("    ts: " + rangeByteRet.getDataPoints().get(i).getTs() + ", value: " + rangeByteRet.getDataPoints().get(i).getDoubleValue());
            }

            // Concurrently update data in Collector B.
            for (int i = 0; i < num; i++) {
                double val = i;
                long ts = startTs + i*1000;
                String tsStr = String.valueOf(ts);
                ExtsAttributesParams params = new ExtsAttributesParams();
                params.dataEt(1000000000);
                String addRet = tairTs.extsrawincr(pkey, skey1, tsStr, val, params);
            }

            System.out.println("Updated result of Collector B:");
            rangeByteRet = tairTs.extsrange(pkey, skey1, startTsStr, endTsStr, paramsAgg);
            for (int i = 0; i < num; i++) {
                System.out.println("    ts: " + rangeByteRet.getDataPoints().get(i).getTs() + ", value: " + rangeByteRet.getDataPoints().get(i).getDoubleValue());
            }
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}
Ambos os coletores chamam extsrawincr com os mesmos timestamps e valores. Após o Coletor A gravar 5 pontos de dados, a consulta retorna:
Updated result of Collector A:
    ts: 1597049266000, value: 0.0
    ts: 1597049267000, value: 1.0
    ts: 1597049268000, value: 2.0
    ts: 1597049269000, value: 3.0
    ts: 1597049270000, value: 4.0
Depois que o Coletor B grava os mesmos valores, o comando extsrawincr acumula os novos valores sobre os existentes:
Updated result of Collector B:
    ts: 1597049266000, value: 0.0
    ts: 1597049267000, value: 2.0
    ts: 1597049268000, value: 4.0
    ts: 1597049269000, value: 6.0
    ts: 1597049270000, value: 8.0
Cada valor é duplicado porque ambos os coletores contribuíram com quantidades iguais. Esse comportamento de acumulação torna o comando extsrawincr seguro para gravações concorrentes de múltiplos coletores.