Este tutorial demonstra como construir um sistema de busca multimodal usando TairVector e Chinese-CLIP. Ao concluir este tutorial, seu sistema poderá receber uma consulta em texto e retornar imagens correspondentes ou receber uma imagem e retornar descrições textuais compatíveis.
Como funciona
A busca multimodal funciona porque o CLIP codifica imagens e texto no mesmo espaço vetorial. Como os embeddings compartilham um sistema de coordenadas comum, é possível medir diretamente a distância entre uma consulta de texto e qualquer imagem, sem traduzir uma modalidade para a outra. Uma consulta como "um cachorro correndo" aproxima-se de imagens de cachorros correndo, mesmo que essas imagens nunca tenham sido rotuladas com essa frase exata.
O Chinese-CLIP é um modelo CLIP open-source da DAMO Academy, desenvolvido com base nas arquiteturas Text Transformer e ResNet. Este tutorial utiliza a variante RN50, que gera embeddings de 1.024 dimensões.
O TairVector armazena esses embeddings e recupera os vizinhos mais próximos por meio de um algoritmo de vizinho mais próximo aproximado (ANN), com suporte de indexação HNSW. Para obter mais informações sobre o TairVector, consulte Vector.
Pré-requisitos
Antes de começar, verifique se você tem:
Uma instância Tair em execução, com endpoint e senha disponíveis
Python 3.8 ou superior
Uma GPU com suporte a CUDA
-
Os seguintes pacotes Python instalados:
O Chinese-CLIP é instalado diretamente do GitHub, não do PyPI. Execute ambos os comandos acima.
Pacote
Finalidade
tairCliente Python do Tair para operações do TairVector
torchRuntime do PyTorch necessário para o Chinese-CLIP
PillowCarregamento e processamento de imagens
matplotlibExibição das imagens resultantes
Chinese-CLIP
Modelo de embedding para imagens e texto
pip3 install tair torch Pillow matplotlib pip3 install git+https://github.com/OFA-Sys/Chinese-CLIP.git -
Dados de exemplo:
Imagens: mais de 7.000 fotos de animais de estimação do conjunto de dados Extreme Mart, baixadas para um diretório local (por exemplo,
/home/CLIP_Demo)Texto: três descrições de exemplo — "a dog", "a white dog" e "a running white dog"
Etapa 1: Conectar-se ao Tair
Importe todas as dependências e defina uma função de conexão. Substitua host e password pelos valores da sua instância Tair. Para contas personalizadas, defina password como username:password.
# -*- coding: utf-8 -*-
from tair import Tair
from tair.tairvector import DistanceMetric
from tair import ResponseError

from typing import List
import torch
from PIL import Image
import pylab
from matplotlib import pyplot as plt
import os
import cn_clip.clip as clip
from cn_clip.clip import available_models

def get_tair() -> Tair:
    """Connect to a Tair instance.
    * host: the endpoint of your Tair instance.
    * port: the port number. Default: 6379.
    * password: the password. For custom accounts, use the username:password format.
    """
    tair: Tair = Tair(
        host="r-8vbehg90y9rlk9****pd.redis.rds.aliyuncs.com",
        port=6379,
        db=0,
        password="D******3",
        decode_responses=True
    )
    return tair
Etapa 2: Criar índices vetoriais
Crie dois índices HNSW: um para embeddings de imagem e outro para embeddings de texto. Ambos utilizam o produto interno (IP) como métrica de distância e dimensão de 1.024, compatível com a saída do Chinese-CLIP RN50.
def create_index():
    """Create vector indexes for image and text embeddings.
    * Index names: index_images, index_texts
    * Vector dimension: 1024 (matches Chinese-CLIP RN50 output)
    * Distance metric: IP (inner product)
    * Index algorithm: HNSW
    """
    ret = tair.tvs_get_index("index_images")
    if ret is None:
        tair.tvs_create_index("index_images", 1024, distance_type="IP",
                              index_type="HNSW")
    ret = tair.tvs_get_index("index_texts")
    if ret is None:
        tair.tvs_create_index("index_texts", 1024, distance_type="IP",
                              index_type="HNSW")
Etapa 3: Gerar e armazenar embeddings
Use o Chinese-CLIP para codificar imagens e texto e armazene cada embedding no TairVector com o comando TVS.HSET.
Embeddings de imagem: o caminho de cada arquivo de imagem torna-se a chave, e seu vetor de 1.024 dimensões torna-se o valor:
def insert_images(image_dir):
    """Generate image embeddings with CLIP and store them in TairVector.
    Each image is stored as:
    * Index: index_images
    * Key: image file path (e.g., test/images/boxer_18.jpg)
    * Value: 1024-dimensional embedding vector
    """
    file_names = [f for f in os.listdir(image_dir) if (f.endswith('.jpg') or f.endswith('.jpeg'))]
    for file_name in file_names:
        image_feature = extract_image_features(image_dir + "/" + file_name)
        tair.tvs_hset("index_images", image_dir + "/" + file_name, image_feature)

def extract_image_features(img_name):
    """Extract a 1024-dimensional embedding from an image using CLIP."""
    image_data = Image.open(img_name).convert("RGB")
    infer_data = preprocess(image_data)
    infer_data = infer_data.unsqueeze(0).to("cuda")
    with torch.no_grad():
        image_features = model.encode_image(infer_data)
    image_features /= image_features.norm(dim=-1, keepdim=True)
    return image_features.cpu().numpy()[0]  # [1, 1024]
Embeddings de texto: cada string de texto torna-se a chave:
def upsert_text(text):
    """Generate a text embedding with CLIP and store it in TairVector.
    Each text is stored as:
    * Index: index_texts
    * Key: the text content (e.g., "a running dog")
    * Value: 1024-dimensional embedding vector
    """
    text_features = extract_text_features(text)
    tair.tvs_hset("index_texts", text, text_features)

def extract_text_features(text):
    """Extract a 1024-dimensional embedding from a text string using CLIP."""
    text_data = clip.tokenize([text]).to("cuda")
    with torch.no_grad():
        text_features = model.encode_text(text_data)
    text_features /= text_features.norm(dim=-1, keepdim=True)
    return text_features.cpu().numpy()[0]  # [1, 1024]
Não é necessário armazenar o texto ou a imagem de consulta no TairVector. Apenas os embeddings indexados precisam ser armazenados previamente.
Etapa 4: Executar a busca multimodal
Use topK para controlar a quantidade de resultados retornados. Um valor menor de distance indica maior similaridade.
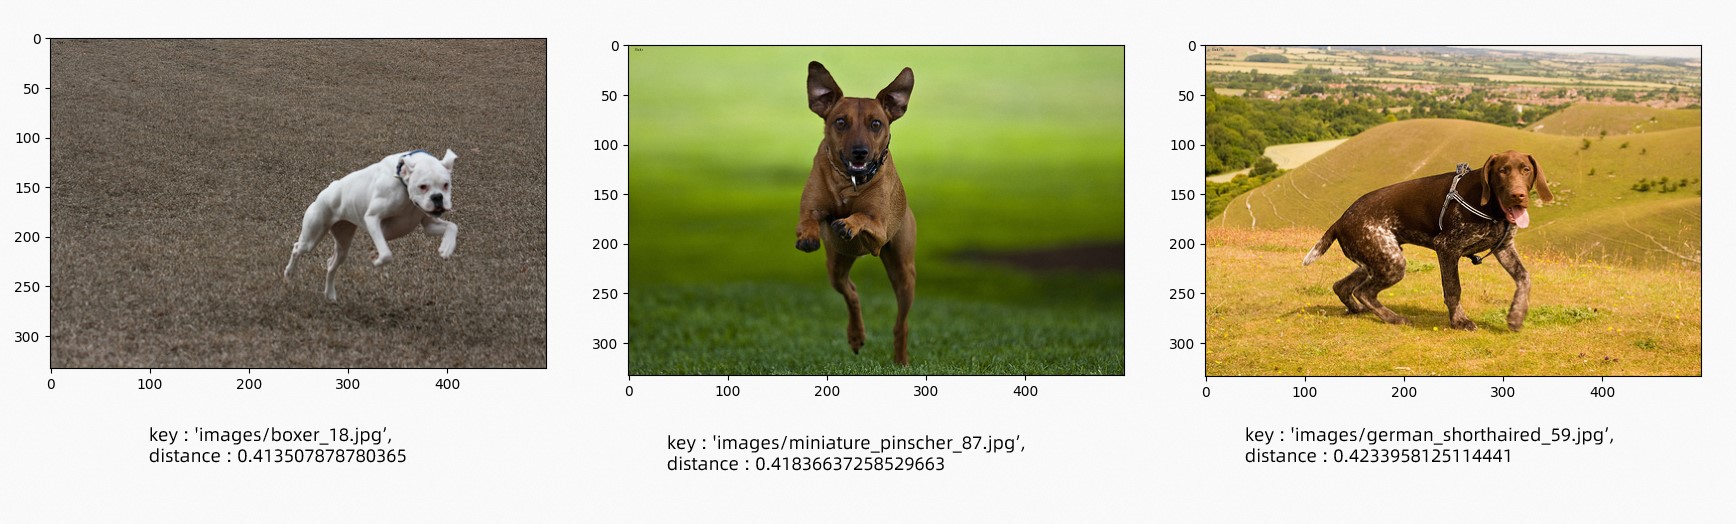
Busca de texto para imagem: converte uma consulta de texto em embedding e pesquisa no índice de imagens:
def query_images_by_text(text, topK):
    """Text-to-image search: find images that match a text description.
    Returns image keys and distance scores. Lower distance = higher similarity.
    """
    text_feature = extract_text_features(text)
    result = tair.tvs_knnsearch("index_images", topK, text_feature)
    for k, s in result:
        print(f'key : {k}, distance : {s}')
        img = Image.open(k.decode('utf-8'))
        plt.imshow(img)
        pylab.show()
Busca de imagem para texto: converte uma imagem de consulta em embedding e pesquisa no índice de textos:
def query_texts_by_image(image_path, topK=3):
    """Image-to-text search: find text descriptions that match an image.
    Returns text keys and distance scores. Lower distance = higher similarity.
    """
    image_feature = extract_image_features(image_path)
    result = tair.tvs_knnsearch("index_texts", topK, image_feature)
    for k, s in result:
        print(f'text : {k}, distance : {s}')
Execute o fluxo completo
if __name__ == "__main__":
    # Connect to Tair and create vector indexes for images and texts.
    tair = get_tair()
    create_index()
    # Load the Chinese-CLIP model (RN50 variant).
    model, preprocess = clip.load_from_name("RN50", device="cuda", download_root="./")
    model.eval()

    # Store image embeddings. Replace the path with your dataset directory.
    insert_images("/home/CLIP_Demo")
    # Store text embeddings.
    upsert_text("a dog")
    upsert_text("a white dog")
    upsert_text("a running white dog")

    # Text-to-image search: find the top 3 images matching "a running dog".
    query_images_by_text("a running dog", 3)
    # Image-to-text search: find text descriptions matching the specified image.
    query_texts_by_image("/home/CLIP_Demo/boxer_18.jpg", 3)
Resultados
Busca de texto para imagem: consulta "a running dog", 3 principais resultados:
Busca de imagem para texto: imagem de entrada:
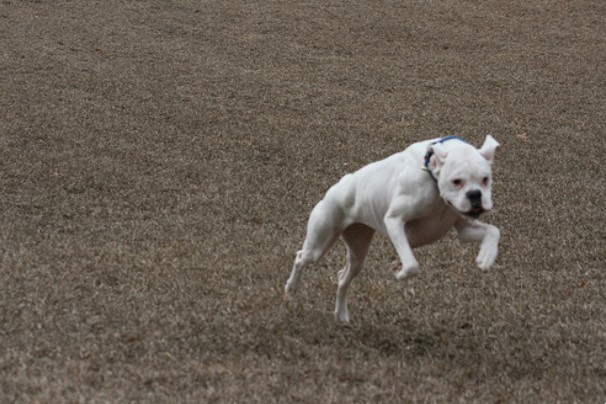
Resultados classificados por similaridade (menor distância = maior similaridade):
{
  "results": [
    {
      "text": "a running white dog",
      "distance": "0.4052203893661499"
    },
    {
      "text": "a white dog",
      "distance": "0.44666868448257446"
    },
    {
      "text": "a dog",
      "distance": "0.4553511142730713"
    }
  ]
}
Próximos passos
O Tair é um banco de dados em memória com indexação HNSW integrada, ideal para recuperação em tempo real. Aplique esse padrão em casos de uso como:
Recomendação de produtos: receba uma descrição textual e retorne imagens de produtos correspondentes
Legendagem de imagens: forneça uma imagem de produto e obtenha descrições candidatas
Modalidades estendidas: substitua o Chinese-CLIP por outro modelo de embedding para viabilizar recuperação vídeo-texto ou áudio-texto