Como banco de dados chave-valor de alto desempenho, o Tair (Redis OSS-compatible) armazena grandes volumes de dados críticos para seus negócios. Para garantir a segurança dos dados, o Tair (Redis OSS-compatible) oferece diversas soluções de recuperação de desastres.
Evolução das arquiteturas de recuperação de desastres
O mecanismo de recuperação de desastres garante a consistência dos dados e a disponibilidade do service caso uma instância falhe devido a eventos inesperados, como mau funcionamento de hardware ou quedas de energia no data center.
Figura 1. Evolução das arquiteturas de recuperação de desastres

|
Solução de recuperação de desastres |
Nível de proteção |
Descrição |
|
★★★☆☆ |
O nó mestre e o nó réplica são implantados em máquinas diferentes na mesma zona. Se um nó falhar, o sistema de alta disponibilidade (HA) executa automaticamente um failover para evitar interrupções de service causadas por ponto único de falha (SPOF). |
|
|
★★★★☆ |
O nó mestre e o nó réplica residem em duas zonas distintas na mesma região. Caso uma zona fique indisponível devido a fatores como quedas de energia ou falhas de rede, o sistema HA realiza um failover para manter a instância disponível. |
|
|
★★★★★ |
Uma instância do Global Distributed Cache consiste em várias instâncias filhas que sincronizam dados em tempo real por canais dedicados. Um gerenciador de canais monitora a integridade das instâncias filhas e trata exceções, como failovers. Essa solução é ideal para cenários como recuperação de desastres geográfica, redundância geográfica ativa, roteamento de usuários para o ponto de acesso à aplicação mais próximo e distribuição de carga. |
Solução de HA de zona única
Todas as arquiteturas de instância suportam arquitetura de HA de zona única. O sistema HA monitora a integridade dos nós mestre e réplica e executa automaticamente um failover para prevenir interrupções de service causadas por SPOF.
Arquitetura de implantação | Descrição |
Figura 2. Arquitetura de HA para instância padrão de réplica dupla  A instância de arquitetura padrão utiliza configuração mestre-réplica de dois nós. Se o sistema HA detectar falha no nó mestre, iniciará automaticamente um failover, promovendo o nó réplica a novo nó mestre. Quando o nó mestre original se recuperar, reconectar-se-á como novo nó réplica. | |
Figura 3. Arquitetura de HA para instância de cluster com múltiplas réplicas  Na arquitetura de cluster com múltiplas réplicas, os dados ficam armazenados em shards de dados. Cada shard possui configuração de múltiplas réplicas com nós implantados em máquinas diferentes para garantir alta disponibilidade. Caso um nó mestre falhe, o sistema executará automaticamente um failover para manter a disponibilidade do service. | |
Figura 4. Arquitetura de HA para instância de divisão de leitura/escrita 
|
Recuperação de desastres multizona
O Tair (Redis OSS-compatible) fornece arquitetura de recuperação de desastres que abrange múltiplas zonas. Se seus services estiverem implantados em única região e exigirem alto nível de recuperação de desastres, selecione a opção multizona ao criar a instância. Para obter instruções, consulte Create an instance.
Figura 5. Criar instância de recuperação de desastres de zona 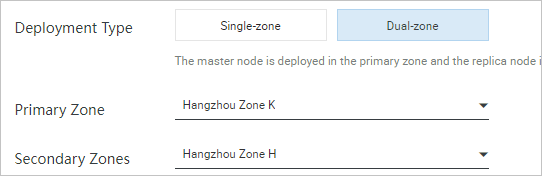
Após a criação da instância, cria-se uma instância réplica com as mesmas especificações da instância primária na zona secundária. Os dados são sincronizados entre as zonas primária e secundária por canal de replicação dedicado.
Se a zona primária sofrer falha de energia ou de rede, o sistema promove a instância réplica a instância mestre e chama a API do Config Server para atualizar as informações de roteamento do proxy. Além disso, o Tair (Redis OSS-compatible) otimiza o mecanismo de sincronização do Redis. Semelhante ao recurso GTID no MySQL, o Tair usa Opid global para gerenciar pontos de sincronização. Um thread em segundo plano sem bloqueio executa a busca do Opid, e o binlog AOF é enviado de forma assíncrona com limitação de taxa, garantindo o desempenho do service Redis.
Figura 6. Processo de sincronização de dados de instância de recuperação de desastres de zona 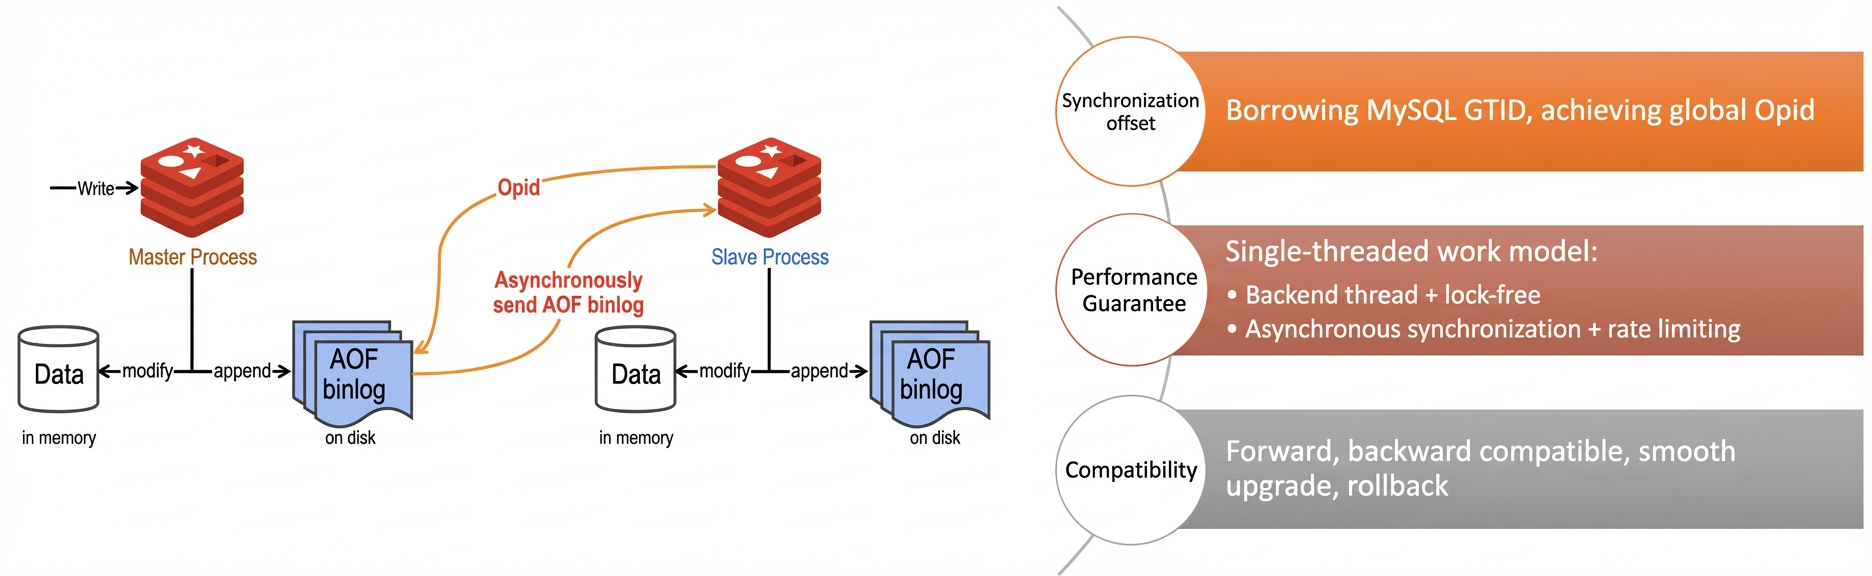
Recuperação de desastres entre regiões
À medida que seus negócios se expandem globalmente, arquitetura de acesso entre regiões pode resultar em alta latência e experiência de usuário ruim. O recurso Global Distributed Cache do Tair reduz essa latência entre regiões e oferece as seguintes vantagens:
Crie ou especifique diretamente instâncias filhas para sincronização. Isso elimina projetos complexos de redundância no nível da aplicação, simplifica significativamente o desenvolvimento e permite foco na lógica central do negócio.
Permite implementar rapidamente recuperação de desastres geográfica e redundância geográfica ativa.
Esse recurso é adequado para sincronização de dados entre regiões e implantações globais em setores como multimídia, jogos e comércio eletrônico. Para mais informações, consulte Global Distributed Cache.
Figura 7. Arquitetura do Global Distributed Cache do Tair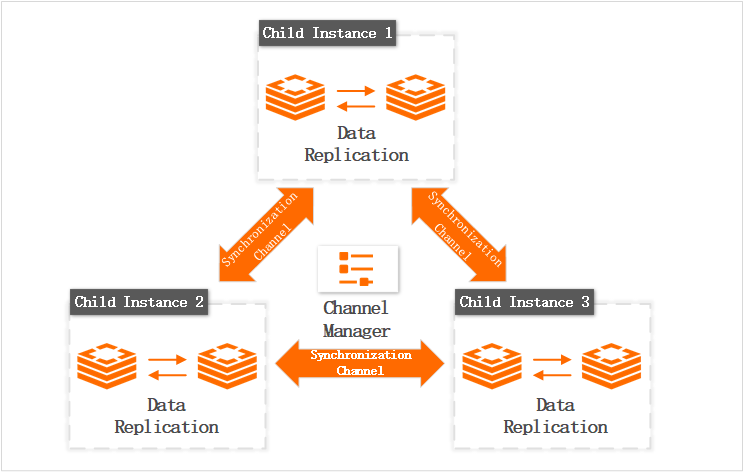
Resposta a falhas
Falhas como mau funcionamento de hardware, quedas de energia no data center e desastres naturais podem ser classificadas como falhas de nó mestre ou falhas no nível da zona. Embora raras, podem impedir temporariamente a gravação de dados, causar problemas transitórios de conexão ou até levar a tempo de inatividade ou perda de dados. A confiabilidade da instância está intimamente ligada à sua arquitetura; arquiteturas de cluster geralmente oferecem maior confiabilidade. Para minimizar o impacto das falhas, instâncias com implantações de múltiplas réplicas e multizona executam failover automaticamente, reduzindo significativamente o tempo de inatividade. As seções a seguir descrevem como instâncias com diferentes soluções de recuperação de desastres respondem a falhas.
Resposta a falha de nó
Quando um nó mestre falha:
Instância com múltiplas réplicas em zona única (por exemplo, nó mestre e nó réplica): o sistema promove o nó réplica com menor latência de replicação a novo nó mestre e atualiza as informações de roteamento.
-
Instância implantada em várias zonas: o sistema promove nó réplica em outra zona a novo nó mestre e atualiza as informações de roteamento. No entanto, isso pode resultar em acesso entre zonas entre sua instância e outros services.
NotaEm arquitetura de cluster multizona, se existirem nós réplica tanto na zona primária quanto na secundária, o failover promoverá preferencialmente nó réplica da zona primária para evitar acesso entre zonas na aplicação.
Resposta a falha no nível da zona
Quando ocorre falha no nível da zona, como queda de energia ou incêndio que torne todo o data center indisponível:
Instância implantada em zona única: a instância fica indisponível. Aguarde a recuperação da zona. Durante esse período, crie nova instância em outra zona usando dados de backup históricos.
Instância implantada em várias zonas: o sistema aciona failover automático.
Para máxima confiabilidade, implante em várias zonas e crie múltiplas réplicas em cada zona para minimizar significativamente o tempo de inatividade. Contudo, equilibre a probabilidade de falha, a importância dos dados e os custos associados.
Os princípios anteriores também se aplicam às instâncias filhas do Global Distributed Cache. A falha de única instância filha não afeta a disponibilidade das demais. Recomendamos implantar instâncias filhas em várias zonas para evitar falhas na gravação de dados caso uma única instância filha falhe.
Resposta a falha no nível da região
Os dados de backup automático ficam armazenados na mesma região da instância. Se ocorrer desastre no nível da região, os dados de backup também ficarão indisponíveis. Para implementar recuperação de desastres entre regiões, configure instância do Global Distributed Cache do Tair (Redis OSS-compatible) ou use o Data Transmission Service (DTS) para sincronizar dados entre regiões. Para mais informações sobre o Global Distributed Cache, consulte @xref node="14010" Global Distributed Cache @/xref .
Documentos relacionados
Avoid Cross-Zone Failover by Customizing Node Count
@xref node="14010" Global Distributed Cache @/xref