Os analisadores processam e tokenizam campos de texto para que o TairSearch crie índices e responda a consultas de texto completo. Cada analisador executa três etapas sequenciais: filtros de caracteres, tokenizador e filtros de tokens. O TairSearch oferece nove analisadores integrados. Para necessidades específicas, crie um analisador personalizado combinando componentes individuais.
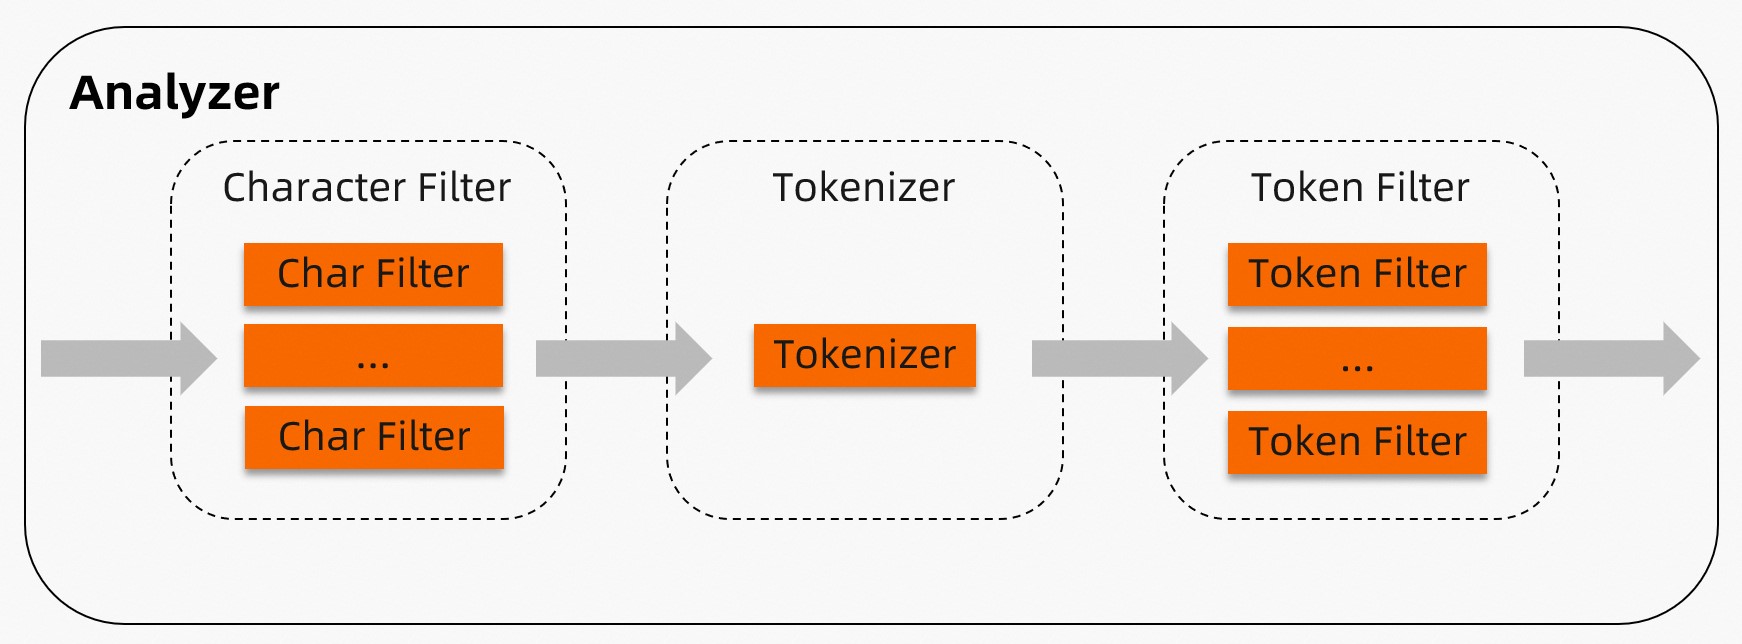
|
Etapa |
Finalidade |
Quantidade por analisador |
|
Filtro de caracteres |
Pré-processa o texto bruto antes da tokenização (por exemplo, substitui |
Zero ou mais, executados em ordem |
|
Tokenizador |
Divide o texto pré-processado em tokens |
Exatamente um |
|
Filtro de tokens |
Pós-processa cada token (por exemplo, converte para minúsculas, remove stop words, aplica stemming) |
Zero ou mais, executados em ordem |
Escolha um analisador
|
Analisador |
Indicado para |
Critério de tokenização |
Converte para minúsculas |
Filtra stop words |
|
Standard |
Maioria dos idiomas |
Limites de palavras Unicode |
Sim |
Sim |
|
Stop |
Maioria dos idiomas (foco em stop words) |
Caracteres não alfabéticos |
Sim |
Sim |
|
Jieba |
Texto em chinês |
Dicionário treinado |
Apenas tokens em inglês |
Sim |
|
IK |
Texto em chinês (compatível com Elasticsearch) |
Dicionário treinado (dois modos) |
Sim (padrão) |
Opcional |
|
Pattern |
Lógica de delimitadores personalizados |
Expressão regular |
Opcional |
Opcional |
|
Whitespace |
Texto pré-tokenizado ou estruturado |
Espaços em branco |
Não |
Não |
|
Simple |
Texto ocidental, sem distinção entre maiúsculas e minúsculas |
Caracteres não alfabéticos |
Sim |
Não |
|
Keyword |
Campos de correspondência exata |
Sem divisão (campo inteiro = um token) |
Não |
Não |
|
Language |
Idiomas naturais específicos |
Regras específicas do idioma |
Sim |
Sim |
Funcionamento
O analisador processa documentos em três etapas sequenciais.
Etapa 1 — Filtro de caracteres: Zero ou mais filtros de caracteres pré-processam o texto bruto do documento. A execução segue a ordem da lista. Por exemplo, um filtro de caracteres de mapeamento pode substituir "(:" por "happy" antes do início da tokenização.
Etapa 2 — Tokenizador: Um único tokenizador divide o texto (possivelmente filtrado) em tokens. Por exemplo, o tokenizador whitespace divide "I am very happy" em ["I", "am", "very", "happy"].
Etapa 3 — Filtro de tokens: Zero ou mais filtros de tokens pós-processam os tokens gerados pelo tokenizador. A execução segue a ordem da lista. Por exemplo, o filtro stop remove palavras comuns como "the" e "is".
Analisadores integrados
Standard
O analisador standard é a opção padrão para a maioria dos idiomas. Ele divide o texto nos limites de palavras Unicode (conforme o Unicode Standard Annex #29), converte todos os tokens para minúsculas e remove stop words comuns.
Components: tokenizador standard → filtro de tokens lowercase → filtro stop
Nenhum filtro de caracteres incluído.
Parâmetros opcionais:
|
Parâmetro |
Descrição |
Padrão |
|
|
Array de stop words para filtragem. Substitui totalmente a lista padrão. |
Veja abaixo |
|
|
Comprimento máximo de caracteres por token. Tokens que excedem esse limite são divididos no ponto de corte. |
255 |
Stop words padrão:
["a", "an", "and", "are", "as", "at", "be", "but", "by", "for", "if", "in",
 "into", "is", "it", "no", "not", "of", "on", "or", "such", "that", "the",
 "their", "then", "there", "these", "they", "this", "to", "was", "will", "with"]
Exemplos de configuração:
// Default configuration
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "standard"
      }
    }
  }
}
// Custom stop words and token length
{
"mappings": {
"properties": {
"f0": {
"type": "text",
"analyzer": "my_analyzer"
}
}
},
"settings": {
"analysis": {
"analyzer": {
"my_analyzer": {
"type": "standard",
"max_token_length": 10,
"stopwords": ["memory", "disk", "is", "a"]
}
}
}
}
}Stop
O analisador stop divide o texto em qualquer caractere não alfabético, converte todos os tokens para minúsculas e remove stop words.
Components: tokenizador lowercase → filtro stop
Parâmetros opcionais:
|
Parâmetro |
Descrição |
Padrão |
|
|
Array de stop words para filtragem. Substitui totalmente a lista padrão. |
Igual ao standard |
Exemplos de configuração:
// Default configuration
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "stop"
      }
    }
  }
}
// Custom stop words
{
"mappings": {
"properties": {
"f0": {
"type": "text",
"analyzer": "my_analyzer"
}
}
},
"settings": {
"analysis": {
"analyzer": {
"my_analyzer": {
"type": "stop",
"stopwords": ["memory", "disk", "is", "a"]
}
}
}
}
}Jieba
Recomendado para textos em chinês, o analisador jieba divide o texto usando segmentação baseada no dicionário jieba, converte tokens em inglês para minúsculas e remove stop words.
Components: tokenizador jieba → filtro de tokens lowercase → filtro stop
O analisador jieba carrega um dicionário integrado de 20 MB na memória. O sistema carrega apenas uma cópia globalmente. O primeiro uso do jieba pode causar um breve pico de latência durante o carregamento do dicionário.
Palavras em dicionários personalizados não podem conter espaços nem nenhum dos seguintes caracteres:
\t,\n,,,。
Parâmetros opcionais:
| Parâmetro | Descrição | Padrão |
|---|---|---|
userwords |
Array de strings adicionadas ao dicionário padrão. Consulte o dicionário padrão do Jiebadicionário padrão do jieba. | Vazio |
use_hmm |
Usa um modelo oculto de Markov (HMM) para lidar com palavras fora do vocabulário. | true |
stopwords |
Array de stop words para filtragem. Substitui totalmente a lista padrão. Consulte as stop words padrão do Jiebastop words padrão do jieba. | Lista integrada |
Exemplos de configuração:
// Default configuration
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "jieba"
      }
    }
  }
}
// Custom dictionary, stop words, and HMM
{
"mappings": {
"properties": {
"f0": {
"type": "text",
"analyzer": "my_analyzer"
}
}
},
"settings": {
"analysis": {
"analyzer": {
"my_analyzer": {
"type": "jieba",
"stopwords": ["memory", "disk", "is", "a"],
"userwords": ["Redis", "open-source", "flexible"],
"use_hmm": true
}
}
}
}
}IK
O analisador IK divide textos em chinês e é compatível com o plug-in do analisador IK para Alibaba Cloud Elasticsearch. Oferece suporte a dois modos:
ik_max_word: identifica todos os tokens possíveis.ik_smart: filtra os resultados do modoik_max_wordpara identificar os tokens mais prováveis.
Componentes: tokenizador IK (sem filtros de tokens por padrão)
Parâmetros opcionais:
|
Parâmetro |
Descrição |
Padrão |
|
|
Array de stop words para filtragem. Substitui totalmente a lista padrão. |
Igual ao standard |
|
|
Array de strings adicionadas ao dicionário padrão do IK. Consulte o dicionário padrão do IK. |
Vazio |
|
|
Array de quantificadores adicionados ao dicionário padrão de quantificadores do IK. Consulte o dicionário padrão de quantificadores. |
Vazio |
|
|
Converte letras maiúsculas em minúsculas antes da tokenização. |
|
Se o dicionário personalizado contiver letras maiúsculas, defina enable_lowercase como false. A conversão para minúsculas ocorre antes da divisão; portanto, entradas em maiúsculas no dicionário nunca corresponderiam.
Exemplos de configuração:
// Default configuration: both IK modes
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "ik_smart"
      },
      "f1": {
        "type": "text",
        "analyzer": "ik_max_word"
      }
    }
  }
}
// Custom stop words, dictionary, and quantifiers
{
"mappings": {
"properties": {
"f0": {
"type": "text",
"analyzer": "my_ik_smart_analyzer"
},
"f1": {
"type": "text",
"analyzer": "my_ik_max_word_analyzer"
}
}
},
"settings": {
"analysis": {
"analyzer": {
"my_ik_smart_analyzer": {
"type": "ik_smart",
"stopwords": ["memory", "disk", "is", "a"],
"userwords": ["Redis", "open-source", "flexible"],
"quantifiers": ["ns"],
"enable_lowercase": false
},
"my_ik_max_word_analyzer": {
"type": "ik_max_word",
"stopwords": ["memory", "disk", "is", "a"],
"userwords": ["Redis", "open-source", "flexible"],
"quantifiers": ["ns"],
"enable_lowercase": false
}
}
}
}
}Pattern
O analisador pattern divide o texto usando uma expressão regular. Por padrão, o texto correspondente atua como delimitador (os tokens correspondem ao texto entre as ocorrências). Ele também converte tokens para minúsculas e filtra stop words.
Components: tokenizador pattern → filtro de tokens lowercase → filtro stop
Parâmetros opcionais:
|
Parâmetro |
Descrição |
Padrão |
|
|
Expressão regular. O texto correspondente ao padrão serve como delimitador. Consulte a sintaxe RE2. |
|
|
|
Array de stop words. Substitui totalmente a lista padrão. |
Igual ao standard |
|
|
Converte tokens para minúsculas. |
|
|
|
Defina como |
Vazio (sensível a maiúsculas e minúsculas) |
Exemplos de configuração:
// Default configuration
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "pattern"
      }
    }
  }
}
// Custom pattern with case-insensitive matching
{
"mappings": {
"properties": {
"f0": {
"type": "text",
"analyzer": "my_analyzer"
}
}
},
"settings": {
"analysis": {
"analyzer": {
"my_analyzer": {
"type": "pattern",
"pattern": "\\'([^\\']+)\\'",
"stopwords": ["aaa", "@"],
"lowercase": false,
"flags": "CASE_INSENSITIVE"
}
}
}
}
}Whitespace
O analisador whitespace divide o texto em caracteres de espaço em branco. Ele não converte tokens para minúsculas nem remove stop words.
Componentes: tokenizador whitespace
Parâmetros opcionais: Nenhum
Configuração:
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "whitespace"
      }
    }
  }
}
Simple
O analisador simple divide o texto em qualquer caractere não alfabético e converte todos os tokens para minúsculas. Ele não filtra stop words.
Componentes: tokenizador lowercase
Parâmetros opcionais: Nenhum
Configuração:
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "simple"
      }
    }
  }
}
Keyword
O analisador keyword trata todo o valor do campo como um único token, sem divisões. Utilize-o para campos que exigem consultas de correspondência exata, como IDs, códigos de status ou tags.
Componentes: tokenizador keyword
Parâmetros opcionais: Nenhum
Configuração:
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "keyword"
      }
    }
  }
}
Language
O analisador language oferece tokenização e remoção de stop words específicas para um conjunto fixo de idiomas: arabic, cjk, chinese, brazilian, czech, german, greek, persian, french, dutch e russian.
Parâmetros opcionais:
|
Parâmetro |
Descrição |
Padrão |
Idiomas suportados |
|
|
Array de stop words. Substitui a lista padrão. Consulte o Apêndice 4 para ver os valores padrão. |
Específico do idioma |
Todos, exceto |
|
|
Array de palavras cujos radicais não devem ser extraídos. Por exemplo, adicionar |
Vazio |
|
As stop words do analisador chinese não podem ser modificadas.
Exemplos de configuração:
// Default configuration (Arabic)
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "arabic"
      }
    }
  }
}
// Custom stop words and stem exclusion (German)
{
"mappings": {
"properties": {
"f0": {
"type": "text",
"analyzer": "my_analyzer"
}
}
},
"settings": {
"analysis": {
"analyzer": {
"my_analyzer": {
"type": "german",
"stopwords": ["ein"],
"stem_exclusion": ["speicher"]
}
}
}
}
}Analisadores personalizados
Crie um analisador personalizado quando nenhum analisador integrado atender às suas necessidades. Defina o analisador em settings e referencie-o pelo nome em mappings.
Parâmetros:
|
Parâmetro |
Obrigatório |
Descrição |
Valores válidos |
|
|
Sim |
Identifica este item como um analisador personalizado. |
|
|
|
Sim |
Tokenizador a ser usado. Apenas um permitido. |
|
|
|
Não |
Array de filtros de caracteres aplicados antes da tokenização. |
|
|
|
Não |
Array de filtros de tokens aplicados após a tokenização. |
|
Exemplo: analisador personalizado com substituição de emoticons e remoção de stop words
// Character filters replace emoticons and expand "&" before tokenization.
// The whitespace tokenizer splits on spaces.
// Token filters lowercase and remove stop words.
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "my_custom_analyzer"
      }
    }
  },
  "settings": {
    "analysis": {
      "analyzer": {
        "my_custom_analyzer": {
          "type": "custom",
          "tokenizer": "whitespace",
          "filter": ["lowercase", "stop"],
          "char_filter": ["emoticons", "conjunctions"]
        }
      },
      "char_filter": {
        "emoticons": {
          "type": "mapping",
          "mappings": [":) => _happy_", ":( => _sad_"]
        },
        "conjunctions": {
          "type": "mapping",
          "mappings": ["&=>and"]
        }
      }
    }
  }
}
Apêndice 1: Filtros de caracteres suportados
Filtro de caracteres mapping
Substitui strings especificadas usando pares chave-valor. Quando a entrada contém uma chave, o sistema a substitui pelo valor correspondente. É possível usar vários filtros de caracteres de mapeamento em um único analisador.
Parâmetros:
|
Parâmetro |
Obrigatório |
Descrição |
|
|
Sim |
Array de regras de substituição. Cada regra deve usar o formato |
Exemplo de configuração:
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "my_custom_analyzer"
      }
    }
  },
  "settings": {
    "analysis": {
      "analyzer": {
        "my_custom_analyzer": {
          "type": "custom",
          "tokenizer": "standard",
          "char_filter": ["emoticons"]
        }
      },
      "char_filter": {
        "emoticons": {
          "type": "mapping",
          "mappings": [":) => _happy_", ":( => _sad_"]
        }
      }
    }
  }
}
Apêndice 2: Tokenizadores suportados
whitespace
Divide o texto em caracteres de espaço em branco. Tokens que excedem max_token_length são divididos no limite.
Parâmetros opcionais:
|
Parâmetro |
Descrição |
Padrão |
|
|
Comprimento máximo de caracteres por token. Tokens que excedem esse limite são divididos no ponto de corte. |
255 |
Exemplos de configuração:
// Default configuration
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "my_custom_analyzer"
      }
    }
  },
  "settings": {
    "analysis": {
      "analyzer": {
        "my_custom_analyzer": {
          "type": "custom",
          "tokenizer": "whitespace"
        }
      }
    }
  }
}
// Custom max token length
{
"mappings": {
"properties": {
"f0": {
"type": "text",
"analyzer": "my_custom_analyzer"
}
}
},
"settings": {
"analysis": {
"analyzer": {
"my_custom_analyzer": {
"type": "custom",
"tokenizer": "token1"
}
},
"tokenizer": {
"token1": {
"type": "whitespace",
"max_token_length": 2
}
}
}
}
}standard
Divide o texto usando o algoritmo de Segmentação de Texto Unicode (Unicode Standard Annex #29). Adequado para a maioria dos idiomas.
Parâmetros opcionais:
|
Parâmetro |
Descrição |
Padrão |
|
|
Comprimento máximo de caracteres por token. Tokens que excedem esse limite são divididos no ponto de corte. |
255 |
Exemplos de configuração:
// Default configuration
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "my_custom_analyzer"
      }
    }
  },
  "settings": {
    "analysis": {
      "analyzer": {
        "my_custom_analyzer": {
          "type": "custom",
          "tokenizer": "standard"
        }
      }
    }
  }
}
// Custom max token length
{
"mappings": {
"properties": {
"f0": {
"type": "text",
"analyzer": "my_custom_analyzer"
}
}
},
"settings": {
"analysis": {
"analyzer": {
"my_custom_analyzer": {
"type": "custom",
"tokenizer": "token1"
}
},
"tokenizer": {
"token1": {
"type": "standard",
"max_token_length": 2
}
}
}
}
}classic
Divide o texto usando regras gramaticais do inglês e trata padrões específicos de forma especial:
Divide na pontuação e a remove. Pontos (
.) cercados por caracteres que não são espaços em branco são mantidos — por exemplo,red.applenão é dividido, masred. appleproduzredeapple.Divide em hífens, a menos que o token contenha dígitos (interpretado como número de produto e mantido intacto).
Reconhece endereços de e-mail e nomes de host como tokens únicos.
Tokens que excedem max_token_length são ignorados, não divididos.
Parâmetros opcionais:
|
Parâmetro |
Descrição |
Padrão |
|
|
Comprimento máximo de caracteres por token. Tokens maiores que esse limite são ignorados. |
255 |
Exemplos de configuração:
// Default configuration
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "my_custom_analyzer"
      }
    }
  },
  "settings": {
    "analysis": {
      "analyzer": {
        "my_custom_analyzer": {
          "type": "custom",
          "tokenizer": "classic"
        }
      }
    }
  }
}
// Custom max token length
{
"mappings": {
"properties": {
"f0": {
"type": "text",
"analyzer": "my_custom_analyzer"
}
}
},
"settings": {
"analysis": {
"analyzer": {
"my_custom_analyzer": {
"type": "custom",
"tokenizer": "token1"
}
},
"tokenizer": {
"token1": {
"type": "classic",
"max_token_length": 2
}
}
}
}
}letter
Divide o texto em qualquer caractere não alfabético. Funciona bem para idiomas europeus.
Configuração:
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "my_custom_analyzer"
      }
    }
  },
  "settings": {
    "analysis": {
      "analyzer": {
        "my_custom_analyzer": {
          "type": "custom",
          "tokenizer": "letter"
        }
      }
    }
  }
}
lowercase
Divide o texto em qualquer caractere não alfabético e converte todos os tokens para minúsculas. Equivale a combinar o tokenizador letter com o filtro de tokens lowercase, mas é mais rápido porque percorre o documento apenas uma vez.
Configuração:
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "my_custom_analyzer"
      }
    }
  },
  "settings": {
    "analysis": {
      "analyzer": {
        "my_custom_analyzer": {
          "type": "custom",
          "tokenizer": "lowercase"
        }
      }
    }
  }
}
keyword
Trata toda a entrada como um único token, sem divisão. Geralmente combinado com um filtro de tokens como lowercase.
Configuração:
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "my_custom_analyzer"
      }
    }
  },
  "settings": {
    "analysis": {
      "analyzer": {
        "my_custom_analyzer": {
          "type": "custom",
          "tokenizer": "keyword"
        }
      }
    }
  }
}
jieba
Divide texto em chinês usando um dicionário treinado. Recomendado para campos em idioma chinês.
Palavras em dicionários personalizados não podem conter espaços nem nenhum dos seguintes caracteres: \t, \n, ,, 。
Parâmetros opcionais:
|
Parâmetro |
Descrição |
Padrão |
|
|
Array de strings adicionadas ao dicionário padrão. Consulte o dicionário padrão do jieba. |
Vazio |
|
|
Usa um modelo oculto de Markov (HMM) para lidar com palavras fora do vocabulário. |
|
Exemplos de configuração:
// Default configuration
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "my_custom_analyzer"
      }
    }
  },
  "settings": {
    "analysis": {
      "analyzer": {
        "my_custom_analyzer": {
          "type": "custom",
          "tokenizer": "jieba"
        }
      }
    }
  }
}
// Custom dictionary
{
"mappings": {
"properties": {
"f1": {
"type": "text",
"analyzer": "my_custom_analyzer"
}
}
},
"settings": {
"analysis": {
"analyzer": {
"my_custom_analyzer": {
"type": "custom",
"tokenizer": "token1"
}
},
"tokenizer": {
"token1": {
"type": "jieba",
"userwords": ["Redis", "open-source", "flexible"],
"use_hmm": true
}
}
}
}
}pattern
Divide o texto usando uma expressão regular. O texto correspondente atua como delimitador por padrão. Use o parâmetro group para tratar o texto correspondente como tokens.
Parâmetros opcionais:
|
Parâmetro |
Descrição |
Padrão |
|
|
Expressão regular. Consulte a sintaxe RE2. |
|
|
|
Controla o uso do resultado da regex. |
|
|
|
Defina como |
Vazio (sensível a maiúsculas e minúsculas) |
Exemplo de comportamento do group:
Regex: "a(b+)c", entrada: "abbbcdefabc"
group: 0→ tokens:[ abbbc, abc ](correspondências completas)group: 1→ tokens:[ bbb, b ](primeiro grupo de captura)
Exemplos de configuração:
// Default configuration
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "my_custom_analyzer"
      }
    }
  },
  "settings": {
    "analysis": {
      "analyzer": {
        "my_custom_analyzer": {
          "type": "custom",
          "tokenizer": "pattern"
        }
      }
    }
  }
}
// Custom pattern with capture group
{
"mappings": {
"properties": {
"f1": {
"type": "text",
"analyzer": "my_custom_analyzer"
}
}
},
"settings": {
"analysis": {
"analyzer": {
"my_custom_analyzer": {
"type": "custom",
"tokenizer": "pattern_tokenizer"
}
},
"tokenizer": {
"pattern_tokenizer": {
"type": "pattern",
"pattern": "AB(A(\\w+)C)",
"flags": "CASE_INSENSITIVE",
"group": 2
}
}
}
}
}IK
Divide texto em chinês. Oferece suporte a dois modos:
ik_max_word: identifica todos os tokens possíveis (granularidade máxima).ik_smart: identifica os tokens mais prováveis (granularidade mais grossa).
Parâmetros opcionais:
|
Parâmetro |
Descrição |
Padrão |
|
|
Array de stop words. Substitui totalmente a lista padrão. |
Igual ao standard |
|
|
Array de strings adicionadas ao dicionário padrão do IK. Consulte o dicionário padrão do IK. |
Vazio |
|
|
Array de quantificadores adicionados ao dicionário padrão de quantificadores. Consulte o dicionário padrão de quantificadores. |
Vazio |
|
|
Converte letras maiúsculas em minúsculas antes da tokenização. |
|
Se o dicionário personalizado contiver letras maiúsculas, defina enable_lowercase como false. A conversão para minúsculas ocorre antes da divisão.
Exemplos de configuração:
// Default configuration: both IK modes
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "my_custom_ik_smart_analyzer"
      },
      "f1": {
        "type": "text",
        "analyzer": "my_custom_ik_max_word_analyzer"
      }
    }
  },
  "settings": {
    "analysis": {
      "analyzer": {
        "my_custom_ik_smart_analyzer": {
          "type": "custom",
          "tokenizer": "ik_smart"
        },
        "my_custom_ik_max_word_analyzer": {
          "type": "custom",
          "tokenizer": "ik_max_word"
        }
      }
    }
  }
}
// Custom dictionary, stop words, and quantifiers
{
"mappings": {
"properties": {
"f0": {
"type": "text",
"analyzer": "my_custom_ik_smart_analyzer"
},
"f1": {
"type": "text",
"analyzer": "my_custom_ik_max_word_analyzer"
}
}
},
"settings": {
"analysis": {
"analyzer": {
"my_custom_ik_smart_analyzer": {
"type": "custom",
"tokenizer": "my_ik_smart_tokenizer"
},
"my_custom_ik_max_word_analyzer": {
"type": "custom",
"tokenizer": "my_ik_max_word_tokenizer"
}
},
"tokenizer": {
"my_ik_smart_tokenizer": {
"type": "ik_smart",
"userwords": ["The tokenizer for the Chinese language", "The custom stop words"],
"stopwords": ["about", "test"],
"quantifiers": ["ns"],
"enable_lowercase": false
},
"my_ik_max_word_tokenizer": {
"type": "ik_max_word",
"userwords": ["The tokenizer for the Chinese language", "The custom stop words"],
"stopwords": ["about", "test"],
"quantifiers": ["ns"],
"enable_lowercase": false
}
}
}
}
}Apêndice 3: Filtros de tokens suportados
classic
Remove o possessivo 's do final dos tokens e retira pontos de siglas. Por exemplo, Fig. torna-se Fig.
Configuração:
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "my_custom_analyzer"
      }
    }
  },
  "settings": {
    "analysis": {
      "analyzer": {
        "my_custom_analyzer": {
          "type": "custom",
          "tokenizer": "classic",
          "filter": ["classic"]
        }
      }
    }
  }
}
elision
Remove elisões especificadas do início dos tokens. Usado principalmente para texto em francês (por exemplo, l'avion → avion).
Parâmetros opcionais:
|
Parâmetro |
Descrição |
Padrão |
|
|
Array de elisões a serem removidas. Substitui totalmente a lista padrão. |
|
|
|
Define se a correspondência de elisão diferencia maiúsculas de minúsculas. |
|
Exemplos de configuração:
// Default configuration
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "my_custom_analyzer"
      }
    }
  },
  "settings": {
    "analysis": {
      "analyzer": {
        "my_custom_analyzer": {
          "type": "custom",
          "tokenizer": "whitespace",
          "filter": ["elision"]
        }
      }
    }
  }
}
// Custom elisions with case-sensitive matching
{
"mappings": {
"properties": {
"f0": {
"type": "text",
"analyzer": "my_custom_analyzer"
}
}
},
"settings": {
"analysis": {
"analyzer": {
"my_custom_analyzer": {
"type": "custom",
"tokenizer": "whitespace",
"filter": ["elision_filter"]
}
},
"filter": {
"elision_filter": {
"type": "elision",
"articles": ["l", "m", "t", "qu", "n", "s", "j"],
"articles_case": true
}
}
}
}
}lowercase
Converte todos os tokens para minúsculas.
Parâmetros opcionais:
|
Parâmetro |
Descrição |
Valores válidos |
|
|
Aplica regras de conversão para minúsculas específicas do idioma. Se não definido, aplicam-se as regras padrão do inglês. |
|
Exemplos de configuração:
// Default configuration (English)
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "my_custom_analyzer"
      }
    }
  },
  "settings": {
    "analysis": {
      "analyzer": {
        "my_custom_analyzer": {
          "type": "custom",
          "tokenizer": "whitespace",
          "filter": ["lowercase"]
        }
      }
    }
  }
}
// Language-specific lowercasing (Greek and Russian)
{
"mappings": {
"properties": {
"f0": {
"type": "text",
"analyzer": "my_custom_greek_analyzer"
},
"f1": {
"type": "text",
"analyzer": "my_custom_russian_analyzer"
}
}
},
"settings": {
"analysis": {
"analyzer": {
"my_custom_greek_analyzer": {
"type": "custom",
"tokenizer": "whitespace",
"filter": ["greek_lowercase"]
},
"my_custom_russian_analyzer": {
"type": "custom",
"tokenizer": "whitespace",
"filter": ["russian_lowercase"]
}
},
"filter": {
"greek_lowercase": {
"type": "lowercase",
"language": "greek"
},
"russian_lowercase": {
"type": "lowercase",
"language": "russian"
}
}
}
}
}snowball
Extrai o radical de cada token. Por exemplo, cats torna-se cat e running torna-se run.
Parâmetros opcionais:
|
Parâmetro |
Descrição |
Padrão |
Valores válidos |
|
|
Idioma cujas regras de stemming devem ser aplicadas. |
|
|
Exemplos de configuração:
// Default configuration (English)
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "my_custom_analyzer"
      }
    }
  },
  "settings": {
    "analysis": {
      "analyzer": {
        "my_custom_analyzer": {
          "type": "custom",
          "tokenizer": "whitespace",
          "filter": ["snowball"]
        }
      }
    }
  }
}
// English stemming with standard tokenizer
{
"mappings": {
"properties": {
"f0": {
"type": "text",
"analyzer": "my_custom_analyzer"
}
}
},
"settings": {
"analysis": {
"analyzer": {
"my_custom_analyzer": {
"type": "custom",
"tokenizer": "standard",
"filter": ["my_filter"]
}
},
"filter": {
"my_filter": {
"type": "snowball",
"language": "english"
}
}
}
}
}stop
Remove stop words do fluxo de tokens.
Parâmetros opcionais:
|
Parâmetro |
Descrição |
Padrão |
|
|
Array de stop words. Substitui totalmente a lista padrão. |
Igual ao standard |
|
|
Define se a correspondência de stop words é insensível a maiúsculas e minúsculas. |
|
Exemplos de configuração:
// Default configuration
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "my_custom_analyzer"
      }
    }
  },
  "settings": {
    "analysis": {
      "analyzer": {
        "my_custom_analyzer": {
          "type": "custom",
          "tokenizer": "whitespace",
          "filter": ["stop"]
        }
      }
    }
  }
}
// Custom stop words with case-insensitive matching
{
"mappings": {
"properties": {
"f0": {
"type": "text",
"analyzer": "my_custom_analyzer"
}
}
},
"settings": {
"analysis": {
"analyzer": {
"my_custom_analyzer": {
"type": "custom",
"tokenizer": "standard",
"filter": ["stop_filter"]
}
},
"filter": {
"stop_filter": {
"type": "stop",
"stopwords": ["the"],
"ignore_case": true
}
}
}
}
}asciifolding
Converte caracteres alfabéticos, numéricos e simbólicos fora do bloco Unicode Latin Basic em seus equivalentes ASCII. Por exemplo, é torna-se e e ü torna-se u. Use este filtro para normalizar caracteres acentuados em texto europeu.
Configuração:
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "my_custom_analyzer"
      }
    }
  },
  "settings": {
    "analysis": {
      "analyzer": {
        "my_custom_analyzer": {
          "type": "custom",
          "tokenizer": "standard",
          "filter": ["asciifolding"]
        }
      }
    }
  }
}
length
Remove tokens menores ou maiores que os comprimentos de caracteres especificados.
Parâmetros opcionais:
|
Parâmetro |
Descrição |
Padrão |
|
|
Número mínimo de caracteres que um token deve ter para ser mantido. |
|
|
|
Número máximo de caracteres que um token pode ter para ser mantido. |
|
Exemplos de configuração:
// Default configuration
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "my_custom_analyzer"
      }
    }
  },
  "settings": {
    "analysis": {
      "analyzer": {
        "my_custom_analyzer": {
          "type": "custom",
          "tokenizer": "whitespace",
          "filter": ["length"]
        }
      }
    }
  }
}
// Keep only tokens between 2 and 5 characters
{
"mappings": {
"properties": {
"f0": {
"type": "text",
"analyzer": "my_custom_analyzer"
}
}
},
"settings": {
"analysis": {
"analyzer": {
"my_custom_analyzer": {
"type": "custom",
"tokenizer": "whitespace",
"filter": ["length_filter"]
}
},
"filter": {
"length_filter": {
"type": "length",
"max": 5,
"min": 2
}
}
}
}
}Normalização
Normaliza caracteres específicos do idioma. Use arabic_normalization para texto em árabe e persian_normalization para texto em persa. Combine este filtro com o tokenizador standard para obter melhores resultados.
Configuração:
{
  "mappings": {
    "properties": {
      "f0": {
        "type": "text",
        "analyzer": "my_arabic_analyzer"
      },
      "f1": {
        "type": "text",
        "analyzer": "my_persian_analyzer"
      }
    }
  },
  "settings": {
    "analysis": {
      "analyzer": {
        "my_arabic_analyzer": {
          "type": "custom",
          "tokenizer": "arabic",
          "filter": ["arabic_normalization"]
        },
        "my_persian_analyzer": {
          "type": "custom",
          "tokenizer": "arabic",
          "filter": ["persian_normalization"]
        }
      }
    }
  }
}
Apêndice 4: Stop words padrão para analisadores de idioma
arabic
["من","ومن","منها","منه","في","وفي","فيها","فيه","و","ف","ثم","او","أو","ب","بها","به","ا","أ","اى","اي","أي","أى","لا","ولا","الا","ألا","إلا","لكن","ما","وما","كما","فما","عن","مع","اذا","إذا","ان","أن","إن","انها","أنها","إنها","انه","أنه","إنه","بان","بأن","فان","فأن","وان","وأن","وإن","التى","التي","الذى","الذي","الذين","الى","الي","إلى","إلي","على","عليها","عليه","اما","أما","إما","ايضا","أيضا","كل","وكل","لم","ولم","لن","ولن","هى","هي","هو","وهى","وهي","وهو","فهى","فهي","فهو","انت","أنت","لك","لها","له","هذه","هذا","تلك","ذلك","هناك","كانت","كان","يكون","تكون","وكانت","وكان","غير","بعض","قد","نحو","بين","بينما","منذ","ضمن","حيث","الان","الآن","خلال","بعد","قبل","حتى","عند","عندما","لدى","جميع"]cjk
["with","will","to","this","there","then","the","t","that","such","s","on","not","no","it","www","was","is","","into","their","or","in","if","for","by","but","they","be","these","at","are","as","and","of","a"]brazilian
["uns","umas","uma","teu","tambem","tal","suas","sobre","sob","seu","sendo","seja","sem","se","quem","tua","que","qualquer","porque","por","perante","pelos","pelo","outros","outro","outras","outra","os","o","nesse","nas","na","mesmos","mesmas","mesma","um","neste","menos","quais","mediante","proprio","logo","isto","isso","ha","estes","este","propios","estas","esta","todas","esses","essas","toda","entre","nos","entao","em","eles","qual","elas","tuas","ela","tudo","do","mesmo","diversas","todos","diversa","seus","dispoem","ou","dispoe","teus","deste","quer","desta","diversos","desde","quanto","depois","demais","quando","essa","deles","todo","pois","dele","dela","dos","de","da","nem","cujos","das","cujo","durante","cujas","portanto","cuja","contudo","ele","contra","como","com","pelas","assim","as","aqueles","mais","esse","aquele","mas","apos","aos","aonde","sua","e","ao","antes","nao","ambos","ambas","alem","ainda","a"]czech
["a","s","k","o","i","u","v","z","dnes","cz","tímto","budeš","budem","byli","jseš","muj","svým","ta","tomto","tohle","tuto","tyto","jej","zda","proc","máte","tato","kam","tohoto","kdo","kterí","mi","nám","tom","tomuto","mít","nic","proto","kterou","byla","toho","protože","asi","ho","naši","napište","re","což","tím","takže","svých","její","svými","jste","aj","tu","tedy","teto","bylo","kde","ke","pravé","ji","nad","nejsou","ci","pod","téma","mezi","pres","ty","pak","vám","ani","když","však","neg","jsem","tento","clánku","clánky","aby","jsme","pred","pta","jejich","byl","ješte","až","bez","také","pouze","první","vaše","která","nás","nový","tipy","pokud","muže","strana","jeho","své","jiné","zprávy","nové","není","vás","jen","podle","zde","už","být","více","bude","již","než","který","by","které","co","nebo","ten","tak","má","pri","od","po","jsou","jak","další","ale","si","se","ve","to","jako","za","zpet","ze","do","pro","je","na","atd","atp","jakmile","pricemž","já","on","ona","ono","oni","ony","my","vy","jí","ji","me","mne","jemu","tomu","tem","temu","nemu","nemuž","jehož","jíž","jelikož","jež","jakož","nacež"]german
["wegen","mir","mich","dich","dir","ihre","wird","sein","auf","durch","ihres","ist","aus","von","im","war","mit","ohne","oder","kein","wie","was","es","sie","mein","er","du","daß","dass","die","als","ihr","wir","der","für","das","einen","wer","einem","am","und","eines","eine","in","einer"]greek
["ο","η","το","οι","τα","του","τησ","των","τον","την","και","κι","κ","ειμαι","εισαι","ειναι","ειμαστε","ειστε","στο","στον","στη","στην","μα","αλλα","απο","για","προσ","με","σε","ωσ","παρα","αντι","κατα","μετα","θα","να","δε","δεν","μη","μην","επι","ενω","εαν","αν","τοτε","που","πωσ","ποιοσ","ποια","ποιο","ποιοι","ποιεσ","ποιων","ποιουσ","αυτοσ","αυτη","αυτο","αυτοι","αυτων","αυτουσ","αυτεσ","αυτα","εκεινοσ","εκεινη","εκεινο","εκεινοι","εκεινεσ","εκεινα","εκεινων","εκεινουσ","οπωσ","ομωσ","ισωσ","οσο","οτι"]persian
["انان","نداشته","سراسر","خياه","ايشان","وي","تاكنون","بيشتري","دوم","پس","ناشي","وگو","يا","داشتند","سپس","هنگام","هرگز","پنج","نشان","امسال","ديگر","گروهي","شدند","چطور","ده","و","دو","نخستين","ولي","چرا","چه","وسط","ه","كدام","قابل","يك","رفت","هفت","همچنين","در","هزار","بله","بلي","شايد","اما","شناسي","گرفته","دهد","داشته","دانست","داشتن","خواهيم","ميليارد","وقتيكه","امد","خواهد","جز","اورده","شده","بلكه","خدمات","شدن","برخي","نبود","بسياري","جلوگيري","حق","كردند","نوعي","بعري","نكرده","نظير","نبايد","بوده","بودن","داد","اورد","هست","جايي","شود","دنبال","داده","بايد","سابق","هيچ","همان","انجا","كمتر","كجاست","گردد","كسي","تر","مردم","تان","دادن","بودند","سري","جدا","ندارند","مگر","يكديگر","دارد","دهند","بنابراين","هنگامي","سمت","جا","انچه","خود","دادند","زياد","دارند","اثر","بدون","بهترين","بيشتر","البته","به","براساس","بيرون","كرد","بعضي","گرفت","توي","اي","ميليون","او","جريان","تول","بر","مانند","برابر","باشيم","مدتي","گويند","اكنون","تا","تنها","جديد","چند","بي","نشده","كردن","كردم","گويد","كرده","كنيم","نمي","نزد","روي","قصد","فقط","بالاي","ديگران","اين","ديروز","توسط","سوم","ايم","دانند","سوي","استفاده","شما","كنار","داريم","ساخته","طور","امده","رفته","نخست","بيست","نزديك","طي","كنيد","از","انها","تمامي","داشت","يكي","طريق","اش","چيست","روب","نمايد","گفت","چندين","چيزي","تواند","ام","ايا","با","ان","ايد","ترين","اينكه","ديگري","راه","هايي","بروز","همچنان","پاعين","كس","حدود","مختلف","مقابل","چيز","گيرد","ندارد","ضد","همچون","سازي","شان","مورد","باره","مرسي","خويش","برخوردار","چون","خارج","شش","هنوز","تحت","ضمن","هستيم","گفته","فكر","بسيار","پيش","براي","روزهاي","انكه","نخواهد","بالا","كل","وقتي","كي","چنين","كه","گيري","نيست","است","كجا","كند","نيز","يابد","بندي","حتي","توانند","عقب","خواست","كنند","بين","تمام","همه","ما","باشند","مثل","شد","اري","باشد","اره","طبق","بعد","اگر","صورت","غير","جاي","بيش","ريزي","اند","زيرا","چگونه","بار","لطفا","مي","درباره","من","ديده","همين","گذاري","برداري","علت","گذاشته","هم","فوق","نه","ها","شوند","اباد","همواره","هر","اول","خواهند","چهار","نام","امروز","مان","هاي","قبل","كنم","سعي","تازه","را","هستند","زير","جلوي","عنوان","بود"]french
["ô","être","vu","vous","votre","un","tu","toute","tout","tous","toi","tiens","tes","suivant","soit","soi","sinon","siennes","si","se","sauf","s","quoi","vers","qui","quels","ton","quelle","quoique","quand","près","pourquoi","plus","à","pendant","partant","outre","on","nous","notre","nos","tienne","ses","non","qu","ni","ne","mêmes","même","moyennant","mon","moins","va","sur","moi","miens","proche","miennes","mienne","tien","mien","n","malgré","quelles","plein","mais","là","revoilà","lui","leurs","","toutes","le","où","la","l","jusque","jusqu","ils","hélas","ou","hormis","laquelle","il","eu","nôtre","etc","est","environ","une","entre","en","son","elles","elle","dès","durant","duquel","été","du","voici","par","dont","donc","voilà","hors","doit","plusieurs","diverses","diverse","divers","devra","devers","tiennes","dessus","etre","dessous","desquels","desquelles","ès","et","désormais","des","te","pas","derrière","depuis","delà","hui","dehors","sans","dedans","debout","vôtre","de","dans","nôtres","mes","d","y","vos","je","concernant","comme","comment","combien","lorsque","ci","ta","nບnmoins","lequel","chez","contre","ceux","cette","j","cet","seront","que","ces","leur","certains","certaines","puisque","certaine","certain","passé","cependant","celui","lesquelles","celles","quel","celle","devant","cela","revoici","eux","ceci","sienne","merci","ce","c","siens","les","avoir","sous","avec","pour","parmi","avant","car","avait","sont","me","auxquels","sien","sa","excepté","auxquelles","aux","ma","autres","autre","aussi","auquel","aujourd","au","attendu","selon","après","ont","ainsi","ai","afin","vôtres","lesquels","a"]dutch
["andere","uw","niets","wil","na","tegen","ons","wordt","werd","hier","eens","onder","alles","zelf","hun","dus","kan","ben","meer","iets","me","veel","omdat","zal","nog","altijd","ja","want","u","zonder","deze","hebben","wie","zij","heeft","hoe","nu","heb","naar","worden","haar","daar","der","je","doch","moet","tot","uit","bij","geweest","kon","ge","zich","wezen","ze","al","zo","dit","waren","men","mijn","kunnen","wat","zou","dan","hem","om","maar","ook","er","had","voor","of","als","reeds","door","met","over","aan","mij","was","is","geen","zijn","niet","iemand","het","hij","een","toen","in","toch","die","dat","te","doen","ik","van","op","en","de"]russian
["а","без","более","бы","был","была","были","было","быть","в","вам","вас","весь","во","вот","все","всего","всех","вы","где","да","даже","для","до","его","ее","ей","ею","если","есть","еще","же","за","здесь","и","из","или","им","их","к","как","ко","когда","кто","ли","либо","мне","может","мы","на","надо","наш","не","него","нее","нет","ни","них","но","ну","о","об","однако","он","она","они","оно","от","очень","по","под","при","с","со","так","также","такой","там","те","тем","то","того","тоже","той","только","том","ты","у","уже","хотя","чего","чей","чем","что","чтобы","чье","чья","эта","эти","это","я"]