O ApsaraDB RDS for PostgreSQL garante alta disponibilidade por meio de failover automático. Se a instância primária ficar indisponível, o failover promove automaticamente a instância standby para primária. O endpoint permanece inalterado, portanto sua aplicação se conecta automaticamente à nova instância primária. Você também pode executar um failover manual.
Pré-requisitos
A instância deve ser da High-availability Edition ou da Cluster Edition.
Instâncias da Basic Edition não possuem instância standby e, portanto, não oferecem suporte a failover.
A desativação temporária do failover automático está disponível apenas para instâncias da High-availability Edition e da Cluster Edition que utilizam discos cloud.
Contexto
Failover automático: este recurso é ativado por padrão. Se a instância primária falhar, o sistema executa o failover automaticamente para a instância standby. Para saber o que aciona um failover, consulte Failover causes.
Failover manual: você pode iniciar um failover manual mesmo com o failover automático ativado. Isso é útil para simulações de recuperação de desastres ou para conectar-se ao nó mais próximo em implantações com múltiplas zonas de disponibilidade.
Nas instâncias da série de alta disponibilidade, os dados são sincronizados em tempo real entre os nós primário e secundário. Apenas o nó primário pode ser acessado; o nó secundário atua exclusivamente como backup e não processa tráfego de aplicações.
Instâncias somente leitura pertencentes à série de alta disponibilidade também oferecem suporte à alternância entre banco de dados primário e secundário e permitem visualizar os logs de alternância.
Impacto
-
A alternância entre instância primária e secundária causa uma interrupção de serviço que normalmente dura 15 segundos ou menos. Verifique se sua aplicação conta com um mecanismo de reconexão automática.
Se sua aplicação utiliza uma versão antiga do componente Druid para gerenciamento de conexões com o banco de dados, ela pode falhar ao reconectar automaticamente após uma desconexão. Para evitar esse problema, atualize o componente Druid para a versão 1.1.16 ou posterior.
Se a instância primária tiver instâncias somente leitura associadas, essas instâncias podem apresentar um atraso de dados de alguns minutos após a alternância. Isso ocorre porque o RDS precisa reconstruir a tarefa de replicação e sincronizar os dados incrementais.
A alternância entre instância primária e secundária não altera o endpoint da instância, mas o endereço IP subjacente pode mudar. Recomendamos utilizar o endpoint para garantir que sua aplicação continue funcionando corretamente durante a alternância.
Caso a instância enfrente uma falha grave, a alternância pode levar mais tempo do que o habitual.
Realizar um failover manual
Acesse a página Instances. Na barra de navegação superior, selecione a região onde a instância RDS está localizada. Em seguida, localize a instância RDS e clique em seu ID.
No painel de navegação à esquerda, clique em Service Availability.
Na seção Availability Information, clique em Switch Primary/Secondary Instance.
-
Selecione um horário para a alternância e clique em OK.
NotaDiversas operações — como gerenciar bancos de dados e contas ou alterar o tipo de rede — ficam indisponíveis durante um failover. Para evitar interrupções de serviço, recomendamos selecionar Within Specified Time Range.
Desativar temporariamente o failover automático
A alternância automática está ativada por padrão. Quando o nó primário falha, o RDS alterna automaticamente para o nó secundário. Você pode desativar temporariamente a alternância automática nos seguintes cenários:
Para evitar qualquer impacto na disponibilidade do sistema durante grandes promoções de vendas.
Para impedir que uma alternância introduza variáveis inesperadas durante atualizações críticas de aplicações.
Durante grandes eventos ou períodos de garantia de estabilidade, quando você não deseja que uma alternância entre instância primária e standby afete a estabilidade do sistema.
Acesse a página Instances. Na barra de navegação superior, selecione a região onde a instância RDS está localizada. Em seguida, localize a instância RDS e clique em seu ID.
No painel de navegação à esquerda, clique em Service Availability.
-
Na seção Availability Information, clique em Automatic Primary/Secondary Switchover.
NotaSe o botão Automatic Primary/Secondary Switchover não estiver visível, confirme que sua instância é da High-availability Edition.
-
Selecione Temporarily Disable, defina o End Time for Temporary Disablement e clique em OK.
NotaAo atingir o End Time for Temporary Disablement, o failover automático é reativado automaticamente.
Por padrão, o failover automático é desativado temporariamente por um dia. É possível definir o horário de término em até sete dias a partir da data atual.
Após concluir a configuração, você pode verificar o prazo de expiração da desativação temporária na página Service Availability.
Visualizar logs de alternância entre instância primária e secundária
Acesse a página Instances. Na barra de navegação superior, selecione a região onde a instância RDS está localizada. Em seguida, localize a instância RDS e clique em seu ID.
No painel de navegação à esquerda, clique em Service Availability.
-
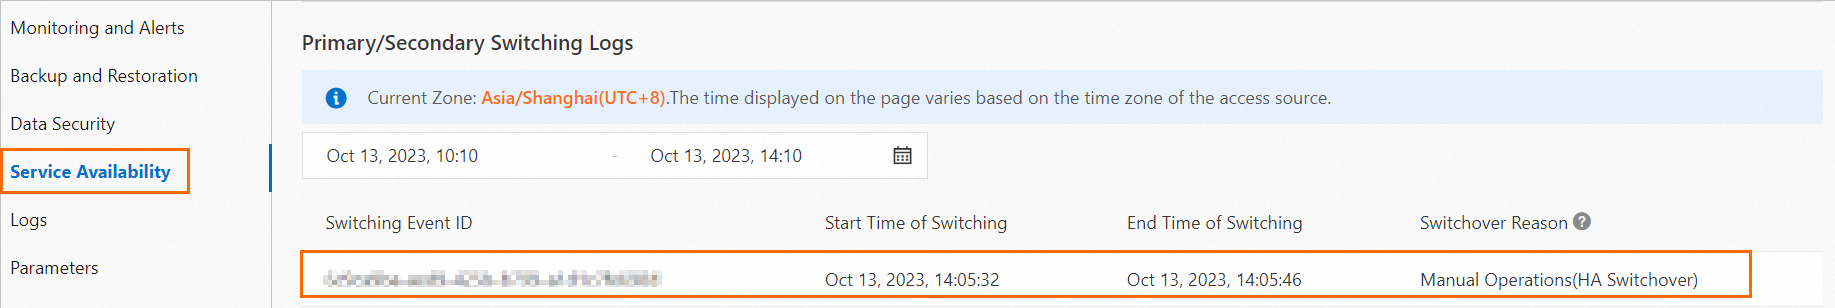
Na seção Primary/Secondary Switchover Logs, especifique um intervalo de tempo para consultar os logs.
Perguntas frequentes
-
P: Após um failover, é necessário alternar manualmente de volta para a instância primária original?
R: Não. Os dados nas instâncias primária e standby são idênticos. Após o failover, a antiga instância standby passa a ser a nova instância primária. Nenhuma ação adicional é necessária.
-
P: Já se passaram mais de 10 minutos desde um failover, mas o status da instância ainda não voltou para Running. Qual pode ser a causa e como resolver?
R: Durante um failover de alta disponibilidade no ApsaraDB RDS, conexões de longa duração podem não detectar a mudança de status. Se um timeout de socket não estiver configurado, a aplicação aguardará indefinidamente por uma resposta do banco de dados, o que pode levar centenas de segundos até a desconexão. Nesse período, algumas conexões com o banco de dados podem não funcionar corretamente, resultando em numerosos erros de execução de SQL. Para evitar essas conexões inválidas e reduzir o tempo de inatividade, recomendamos configurar connectTimeout e socketTimeout para impedir que a aplicação aguarde indefinidamente em caso de erros de rede.
Os valores ideais de timeout dependem da carga de trabalho e dos padrões de uso do seu negócio. Para cargas de trabalho de processamento de transações online (OLTP), recomenda-se um connectTimeout de 1 a 2 segundos e um socketTimeout de 60 a 90 segundos. Esses valores são apenas de referência.
APIs relacionadas
|
API |
Descrição |
|
Alterna os nós primário e secundário de uma instância RDS. |
|
|
Ativa ou desativa a alternância automática entre instância primária e secundária em uma instância RDS. |
|
|
Recupera a configuração de alternância automática entre instância primária e secundária de uma instância RDS. |