Divide uma trajetória em uma matriz de subtrajetórias. Há três sobrecargas disponíveis: divisão por geometria, por regra e por índice.
A função retorna trajectory[]. Use unnest() para expandir o resultado em linhas individuais.
Sintaxe
SELECT unnest(ST_split(a, '{0}'::int[] || '{0,1,3,5}'::int[] || ST_leafcount(a) - 1)) FROM traj;
-- Result: 4 rows
Parâmetros
|
Parâmetro |
Tipo |
Descrição |
|
|
trajectory |
A trajetória a ser dividida. |
|
|
geometry |
O objeto de geometria usado como limite de divisão. Suporta apenas Point e MultiPoint. |
|
|
float8 |
O raio do buffer ao redor da geometria Point, em metros. A trajetória é dividida ao cruzar o limite do buffer. |
|
|
text |
String JSON que especifica uma regra de divisão. Consulte Regras de divisão. |
|
|
int[] |
Índices dos pontos de divisão. A indexação começa em 0. |
Como funciona
Divisão por geometria
Informe uma geometria Point ou MultiPoint e um raio de buffer. A função cria um buffer circular ao redor de cada ponto e divide a trajetória ao cruzar o limite de um buffer.
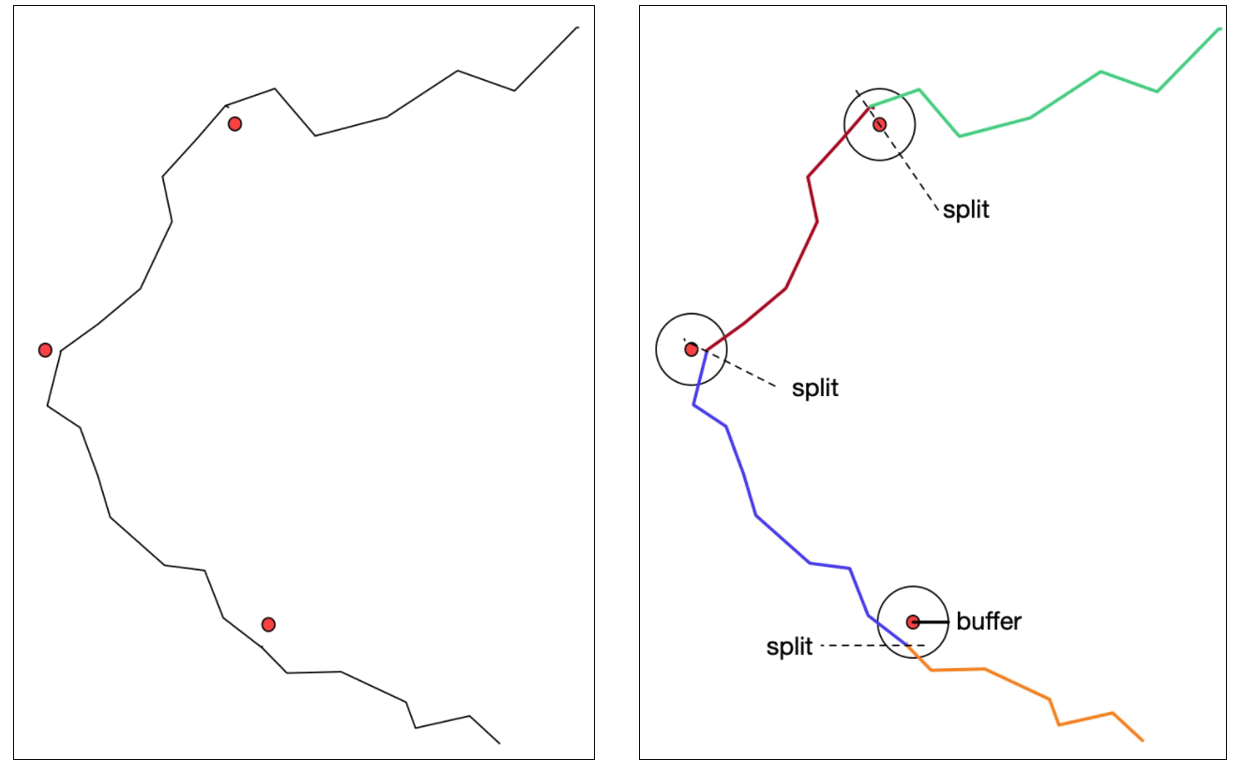
Se nenhuma parte da trajetória interceptar qualquer buffer, não ocorre divisão e a função retorna a trajetória original inalterada.
Divisão por regra
Informe uma string JSON com exatamente uma chave de regra. O comportamento depende da família da regra:
As regras **
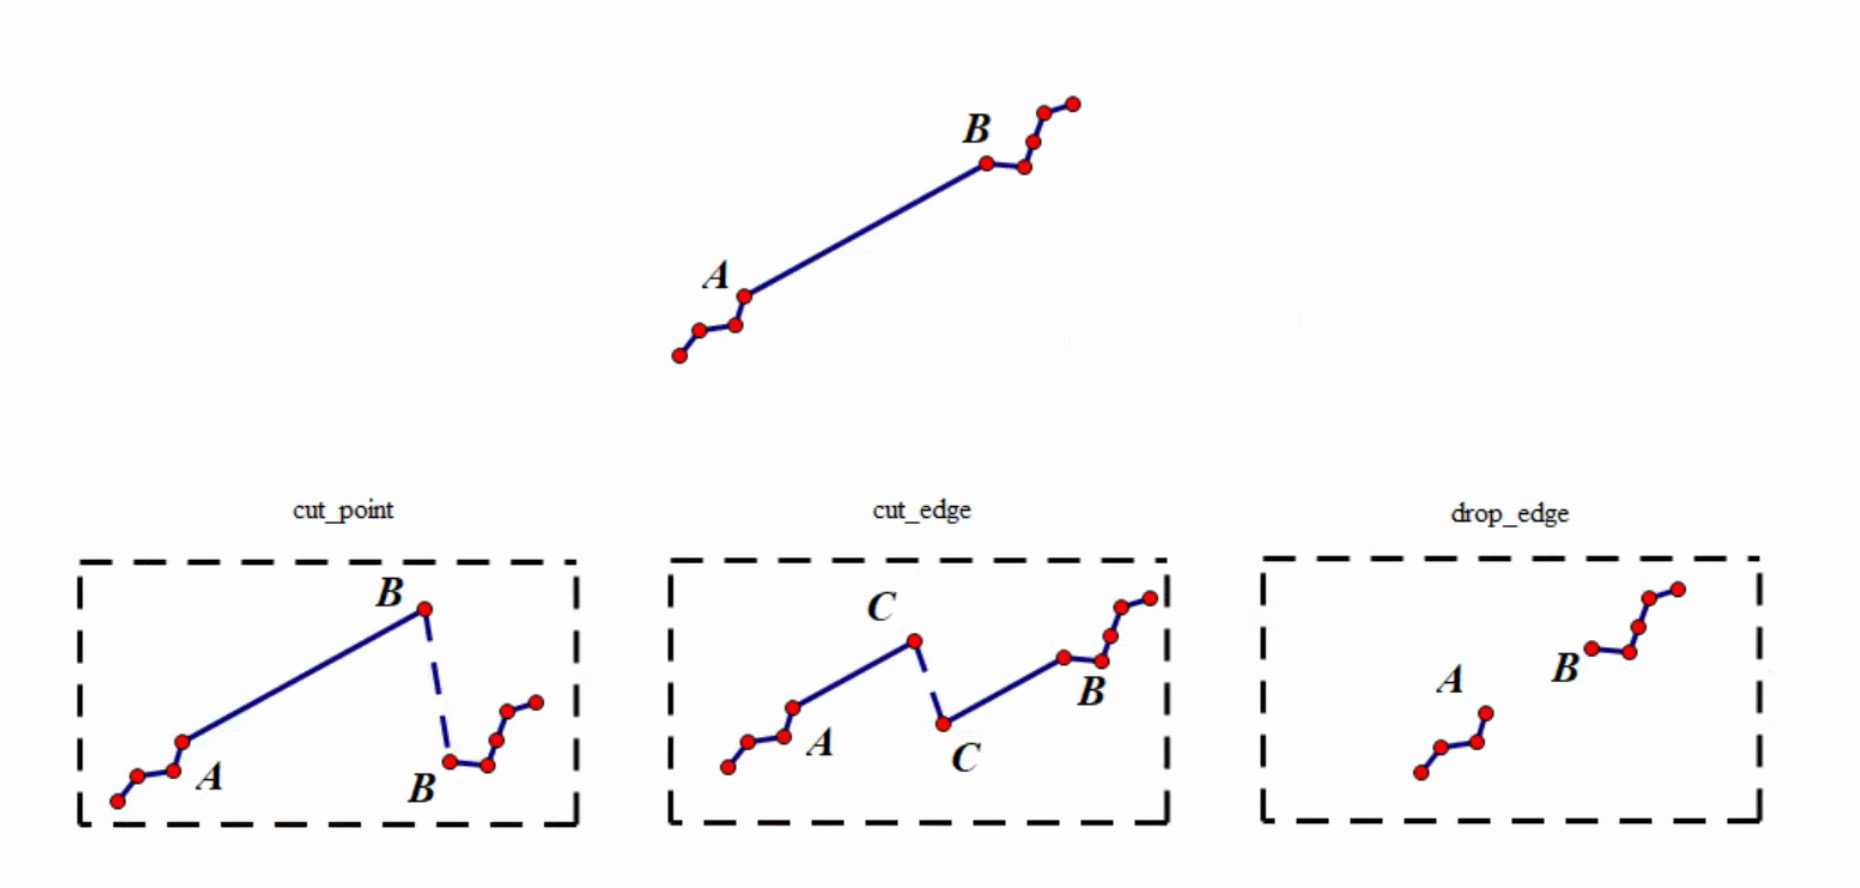
cut_point.*** dividem a trajetória em pontos de amostragem específicos (ponto B no diagrama).As regras **
cut_edge.*** dividem a trajetória em arestas específicas (ponto C no diagrama).As regras **
drop_edge.*** removem completamente as arestas correspondentes. Use-as para limpar ruídos dos dados de trajetória, como remover segmentos muito longos causados por perda de sinal de GPS ou grandes saltos posicionais.
Regras de divisão
|
Regra |
Tipo de valor |
Descrição |
|
|
Inteiro positivo |
Divide a cada N pontos de amostragem. |
|
|
Inteiro positivo |
Divide em N partes iguais. Se a trajetória tiver menos arestas que N, cada aresta se tornará uma subtrajetória independente. |
|
|
Intervalo de tempo positivo |
Divide em intervalos de tempo regulares. Opcionalmente, especifique um horário de referência: |
|
|
Inteiro par positivo |
Divide de forma que cada subtrajetória fique dentro de uma célula de grade Geohash na precisão especificada. Os dados da trajetória devem usar coordenadas de latitude e longitude. |
|
|
Intervalo de tempo |
Remove arestas com duração maior que a especificada. |
|
|
Ponto flutuante |
Remove arestas com distância euclidiana 2D maior que a especificada. Se todas as arestas forem maiores que o limiar, retorna |
Divisão por índice
Informe uma matriz de índices de pontos. Para n índices, a função retorna n-1 subtrajetórias. Os pontos inicial e final da trajetória não precisam estar incluídos na matriz de índices.
Exemplos
Preparar dados de amostra
SELECT unnest(ST_split(a, '{0}'::int[] || '{0,1,3,5}'::int[] || ST_leafcount(a) - 1)) FROM traj;
-- Result: 4 rows
Divisão por geometria
Divida a trajetória sempre que ela passar a até 23.000 metros de qualquer ponto em MULTIPOINT(100 30, 105 35, 110 35). Isso gera 4 subtrajetórias.
SELECT unnest(ST_split(a, '{0}'::int[] || '{0,1,3,5}'::int[] || ST_leafcount(a) - 1)) FROM traj;
-- Result: 4 rows
SELECT unnest(ST_split(a, '{0}'::int[] || '{0,1,3,5}'::int[] || ST_leafcount(a) - 1)) FROM traj;
-- Result: 4 rowsCaso limite: Se o radius_of_buffer for muito pequeno e a trajetória não interceptar nenhuma zona de buffer, não ocorre divisão e a função retorna a trajetória original como uma matriz de um único elemento.
Divisão por regra
Todos os exemplos a seguir usam a mesma trajetória de 19 pontos definida inline.
SELECT unnest(ST_split(a, '{0}'::int[] || '{0,1,3,5}'::int[] || ST_leafcount(a) - 1)) FROM traj;
-- Result: 4 rows**cut_point.max_point — divide a cada 4 pontos (gera 5 subtrajetórias)**
SELECT unnest(ST_split(a, '{0}'::int[] || '{0,1,3,5}'::int[] || ST_leafcount(a) - 1)) FROM traj;
-- Result: 4 rows**cut_point.max_point — divide a cada 10 pontos (gera 2 subtrajetórias)**
SELECT unnest(ST_split(a, '{0}'::int[] || '{0,1,3,5}'::int[] || ST_leafcount(a) - 1)) FROM traj;
-- Result: 4 rows**cut_point.max_point — divide a cada 3 pontos (gera 7 subtrajetórias)**
SELECT unnest(ST_split(a, '{0}'::int[] || '{0,1,3,5}'::int[] || ST_leafcount(a) - 1)) FROM traj;
-- Result: 4 rows**cut_point.even_divide — divide em 100 partes iguais**
Como a trajetória tem apenas 18 arestas (19 pontos) e 18 < 100, cada aresta se torna uma subtrajetória independente. O resultado é uma matriz de 18 subtrajetórias, cada uma com leafcount 2.
SELECT unnest(ST_split(a, '{0}'::int[] || '{0,1,3,5}'::int[] || ST_leafcount(a) - 1)) FROM traj;
-- Result: 4 rows**cut_edge.geohash — divide por precisão Geohash 2 (gera 4 subtrajetórias)**
SELECT unnest(ST_split(a, '{0}'::int[] || '{0,1,3,5}'::int[] || ST_leafcount(a) - 1)) FROM traj;
-- Result: 4 rows**cut_edge.geohash — divide por precisão Geohash 20 (gera 19 subtrajetórias)**
SELECT unnest(ST_split(a, '{0}'::int[] || '{0,1,3,5}'::int[] || ST_leafcount(a) - 1)) FROM traj;
-- Result: 4 rows**drop_edge.spatial_distance_2d — remove arestas mais longas que 13 (gera 1 subtrajetória)**
SELECT unnest(ST_split(a, '{0}'::int[] || '{0,1,3,5}'::int[] || ST_leafcount(a) - 1)) FROM traj;
-- Result: 4 rows**drop_edge.spatial_distance_2d — remove arestas mais longas que 10 (gera 7 subtrajetórias)**
SELECT unnest(ST_split(a, '{0}'::int[] || '{0,1,3,5}'::int[] || ST_leafcount(a) - 1)) FROM traj;
-- Result: 4 rows**drop_edge.spatial_distance_2d — limiar de 1 (todas as arestas removidas)**
Quando o limiar é menor que o comprimento de todas as arestas, a função remove todas as arestas e retorna uma matriz vazia.
SELECT unnest(ST_split(a, '{0}'::int[] || '{0,1,3,5}'::int[] || ST_leafcount(a) - 1)) FROM traj;
-- Result: 4 rows**cut_edge.time_interval — divide a cada 50 minutos (gera 5 subtrajetórias)**
SELECT unnest(ST_split(a, '{0}'::int[] || '{0,1,3,5}'::int[] || ST_leafcount(a) - 1)) FROM traj;
-- Result: 4 rows**cut_edge.time_interval — divide a cada 1 hora com horário de referência em 2000-01-01 (gera 4 subtrajetórias)**
Use unnest() para expandir a matriz em linhas individuais.
SELECT unnest(ST_split(a, '{0}'::int[] || '{0,1,3,5}'::int[] || ST_leafcount(a) - 1)) FROM traj;
-- Result: 4 rowsDivisão por índice
3 índices — 2 subtrajetórias
SELECT unnest(ST_split(a, '{0}'::int[] || '{0,1,3,5}'::int[] || ST_leafcount(a) - 1)) FROM traj;
-- Result: 4 rows6 índices (com duplicatas e pontos de limite) — 4 subtrajetórias
A função aceita valores de índice duplicados e índices de limite explícitos (0 e leafcount-1). Após a deduplicação e ordenação, 5 pontos de divisão exclusivos geram 4 subtrajetórias.
SELECT unnest(ST_split(a, '{0}'::int[] || '{0,1,3,5}'::int[] || ST_leafcount(a) - 1)) FROM traj;
-- Result: 4 rows