O que é um modelo relacional?
Visão geral do modelo relacional
O modelo relacional do Quick BI é uma estrutura de modelagem de dados para junções e análises de múltiplas tabelas. Ele resolve problemas fundamentais da modelagem física tradicional — ineficiência, imprecisão e flexibilidade analítica limitada — sendo ideal para análises multidimensionais em cenários de negócios complexos.
No modelo relacional, posicione as tabelas relacionadas na tela e configure as chaves de junção. Não é necessário gerenciar dados em baixo nível nem especificar explicitamente o tipo de junção.
Esse modelo aumenta a eficiência da modelagem e garante a precisão dos dados. O Quick BI ajusta dinamicamente o SQL da consulta com base nos campos e nas configurações de relacionamento no momento da execução, assegurando resultados exatos. Como funciona o modelo relacional.
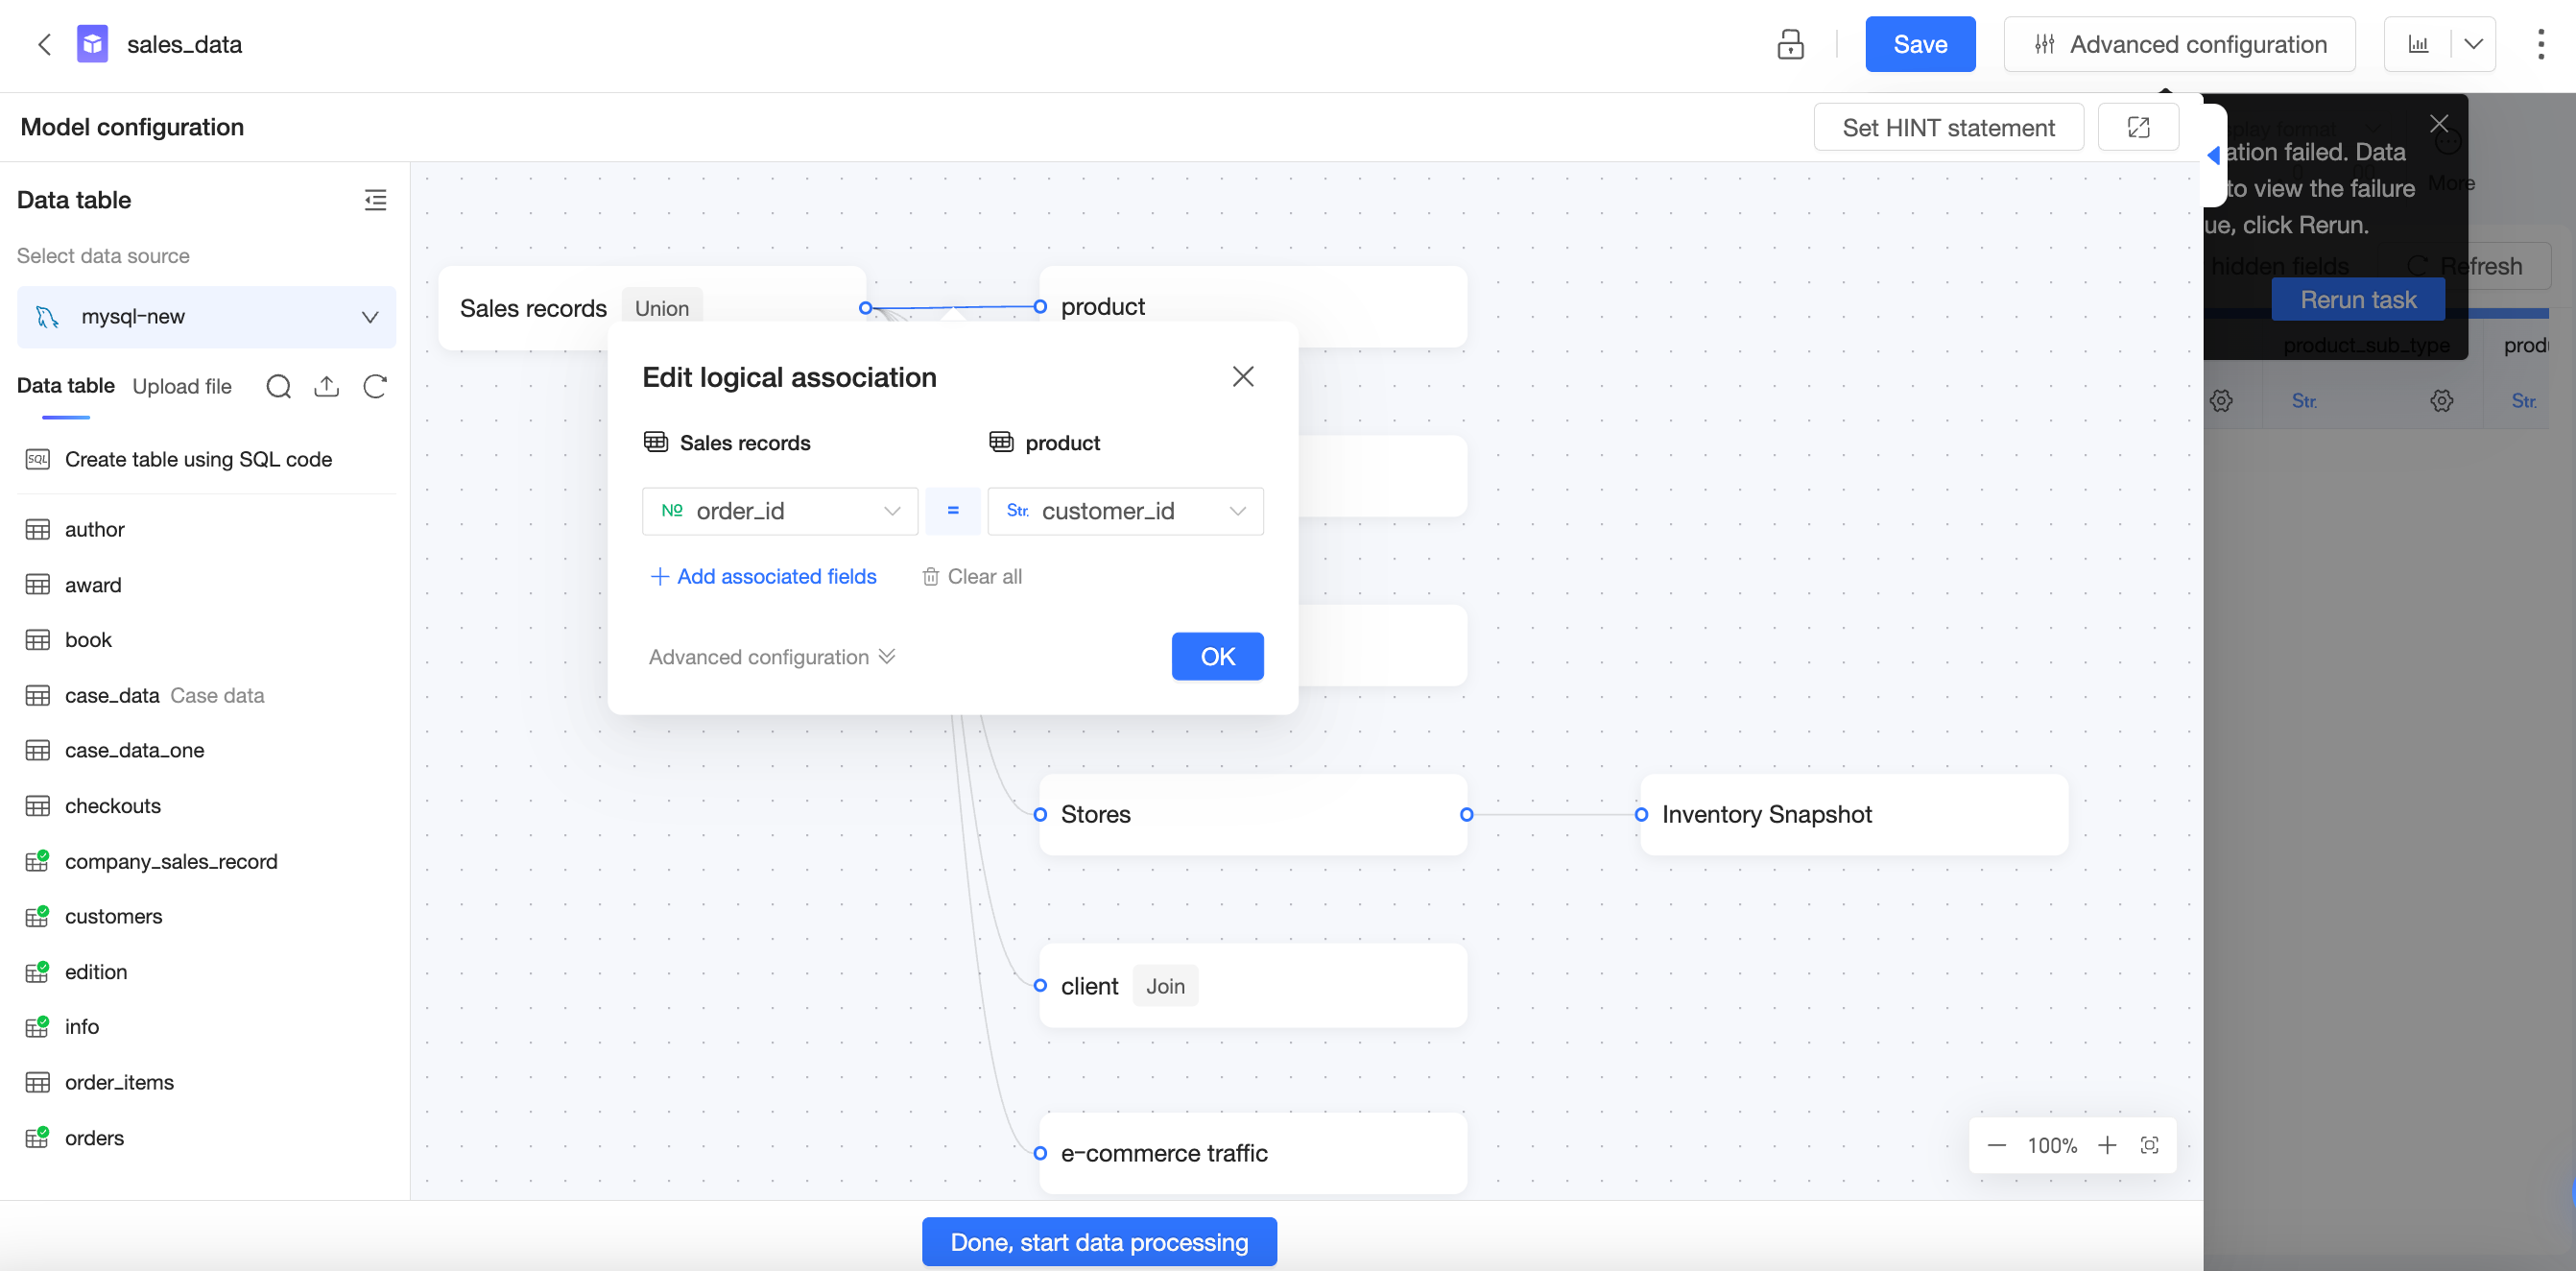
Valor principal do modelo relacional
Contexto e desafios
Em versões anteriores do Quick BI, as tabelas eram conectadas por junções físicas (left join, full join etc.) para gerar uma única tabela ampla. Como as junções físicas podem duplicar dados, os usuários precisavam conhecer previamente a integridade e a unicidade de seus dados. Às vezes, as tabelas de source exigiam pré-processamento, como pré-agregação. Isso tornava a modelagem física complexa, custosa e propensa a erros.
Para resolver esses desafios, o Quick BI introduziu o modelo relacional, adicionando capacidades de modelagem de relacionamentos à modelagem física existente. Isso aumenta a eficiência e a flexibilidade para modelos de dados complexos.
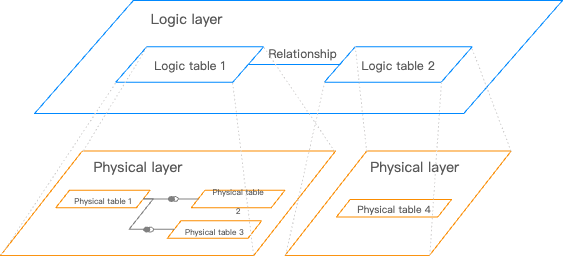
Vantagens
Modelagem de dados simplificada: Defina chaves de junção sem precisar especificar tipos de junção. O modelo relacional gerencia automaticamente as conexões e garante a integridade dos dados.
Prevenção contra duplicação de dados: Não é necessário pré-processar dados quando as granularidades diferem. O modelo relacional resolve automaticamente a duplicação para assegurar cálculos corretos.
Suporte a mais casos de uso analíticos com menos modelos: Um único modelo relacional abrangente pode substituir vários modelos específicos por cenário, reduzindo a quantidade de conjuntos de dados e simplificando a manutenção.
Para obter mais informações, consulte Vantagens do modelo relacional.
Comparação entre modelos físicos e relacionais
|
Modelo físico |
Modelo relacional |
|
|
|
|
Problemas:
|
Soluções:
|
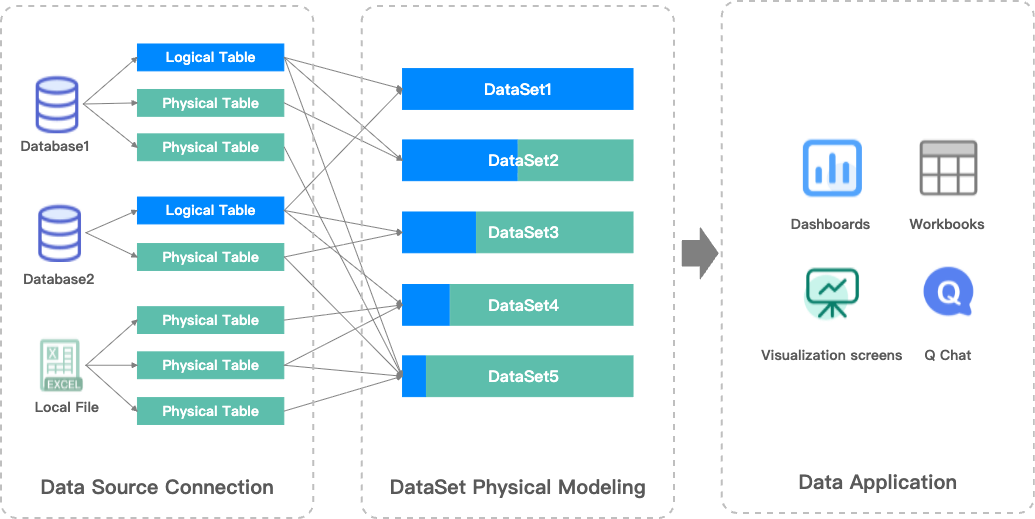
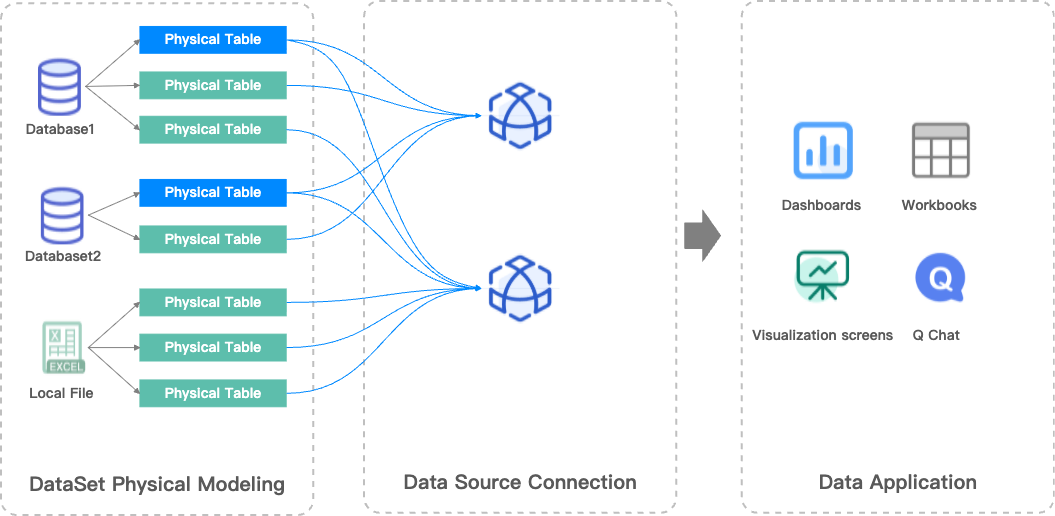
Conceitos principais
Tabelas de fatos e tabelas de dimensões
Tabelas de fatos e tabelas de dimensões são dois tipos comuns de tabelas na modelagem de dados.
Tabela de fatos: Armazena medidas de negócios quantificáveis e contém dados relacionados a eventos de negócios (fatos). Por exemplo, em uma plataforma de educação online, uma tabela de fatos pode incluir o número de alunos que concluíram um curso, médias de notas em testes e tempo total de estudo.
Tabela de dimensões: Armazena atributos descritivos e contém dados relacionados ao contexto de negócios (dimensões). Por exemplo, uma tabela de dimensões pode incluir tipo de curso, nível escolar do aluno, nome do instrutor e data de estudo.
Essas tabelas são vinculadas por meio de campos comuns. Isso permite conectar dimensões e medidas durante as consultas para realizar análises multidimensionais.
Exemplo
Tabelas de fatos
Pedidos
|
Order ID |
Date |
Product ID |
Quantity |
Amount |
|
1 |
2025-12-01 |
A |
1 |
50 |
|
2 |
2025-12-01 |
A |
2 |
100 |
|
3 |
2025-12-01 |
B |
3 |
60 |
|
4 |
2025-12-02 |
C |
1 |
10 |
Registros de estoque
|
Date |
Product ID |
Inventory |
|
2025-12-01 |
A |
10 |
|
2025-12-01 |
B |
20 |
|
2025-12-01 |
C |
5 |
|
2025-12-02 |
C |
4 |
Tabela de dimensões
|
Product ID |
Product Name |
Category |
Brand |
|
A |
Breeze Facial Tissues (Case) |
Household Supplies |
Breeze |
|
B |
M&G File Folders (Set) |
Stationery |
M&G |
|
C |
Oishi Prawn Crackers (Large Bag) |
Food |
Oishi |
Camadas na modelagem de dados
Um modelo de dados define os relacionamentos entre tabelas que orientam o Quick BI sobre como consultar suas tabelas de banco de dados.
Camada lógica e camada física
O modelo de dados do Quick BI possui duas camadas:
-
Camada lógica:
Ao abrir a tela de modelagem de dados, você vê primeiro a camada lógica. Na maioria dos casos, trabalhe apenas aqui.
Os relacionamentos (linhas que conectam as tabelas) definem como os nós se relacionam. Cada nó é uma tabela lógica — seja uma tabela única, uma consulta SQL personalizada ou uma tabela ampla criada por junções físicas ou uniões de múltiplas tabelas ou consultas SQL personalizadas.
A modelagem na camada lógica constrói o modelo de dados completo.
-
Camada física:
A partir de qualquer tabela lógica, acesse sua tela física (a camada física).
A camada física utiliza junções e uniões físicas tradicionais para definir relacionamentos entre múltiplas tabelas físicas. Cada nó é uma tabela de banco de dados ou uma consulta SQL personalizada.
A modelagem na camada física cria uma tabela ampla fixa, que então se torna um único nó lógico na camada lógica.
|
Camada lógica |
Camada física |
|
Linhas de relacionamento |
Diagramas de Venn |
|
|
|
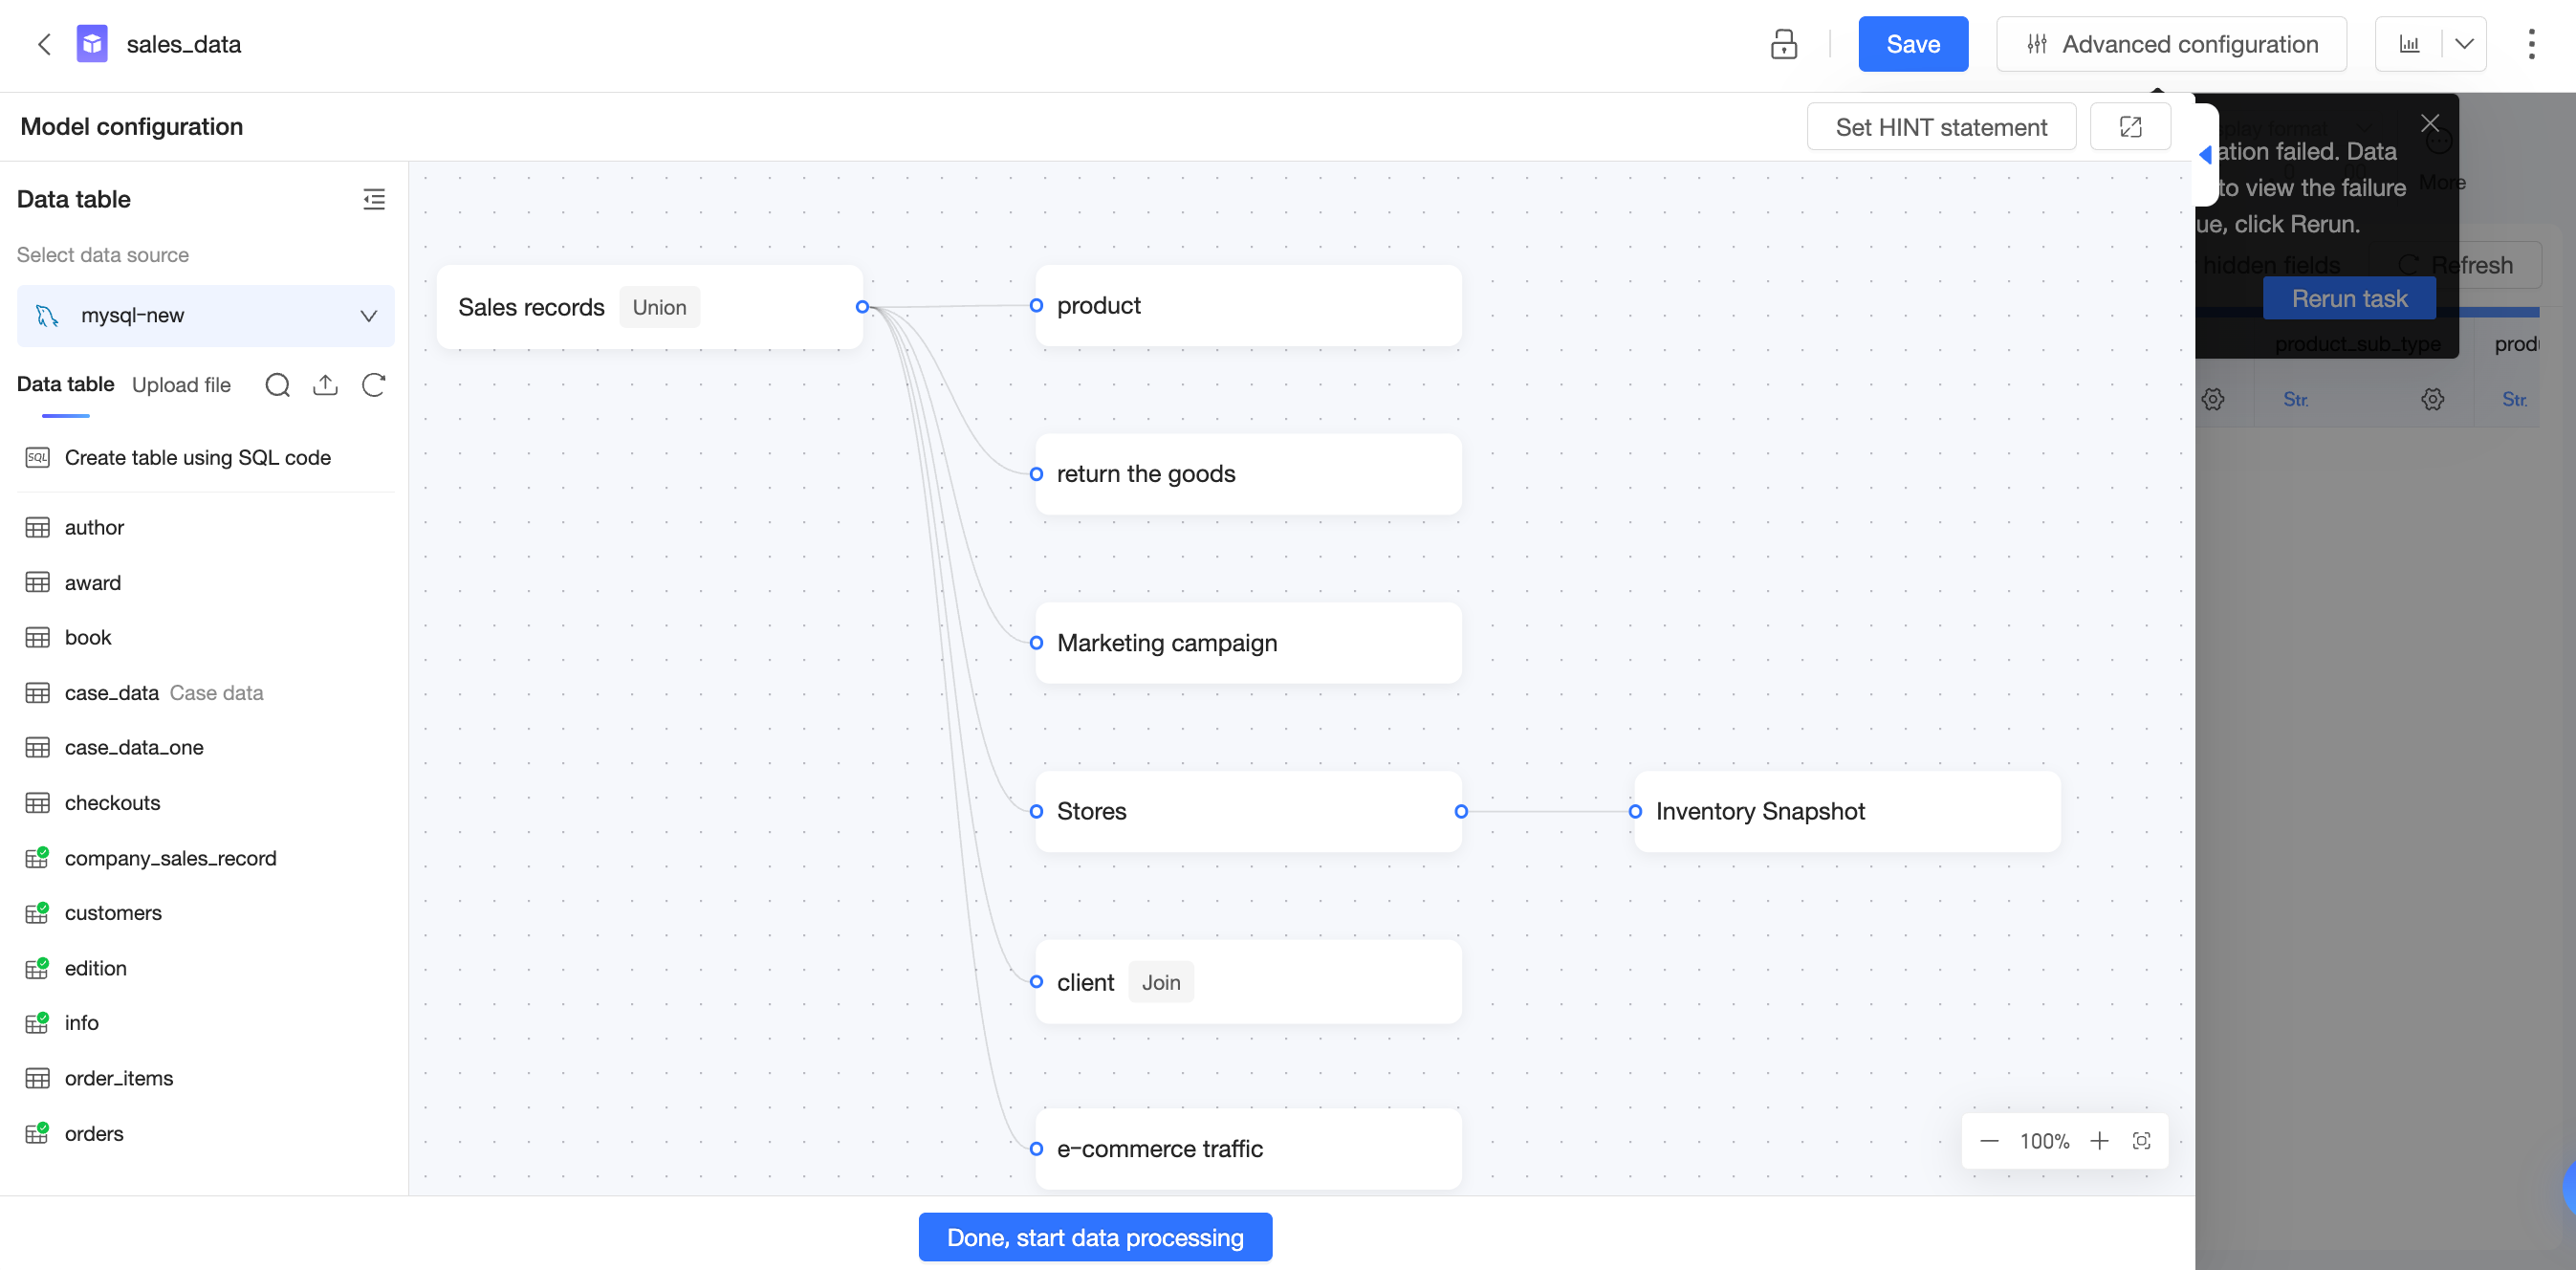
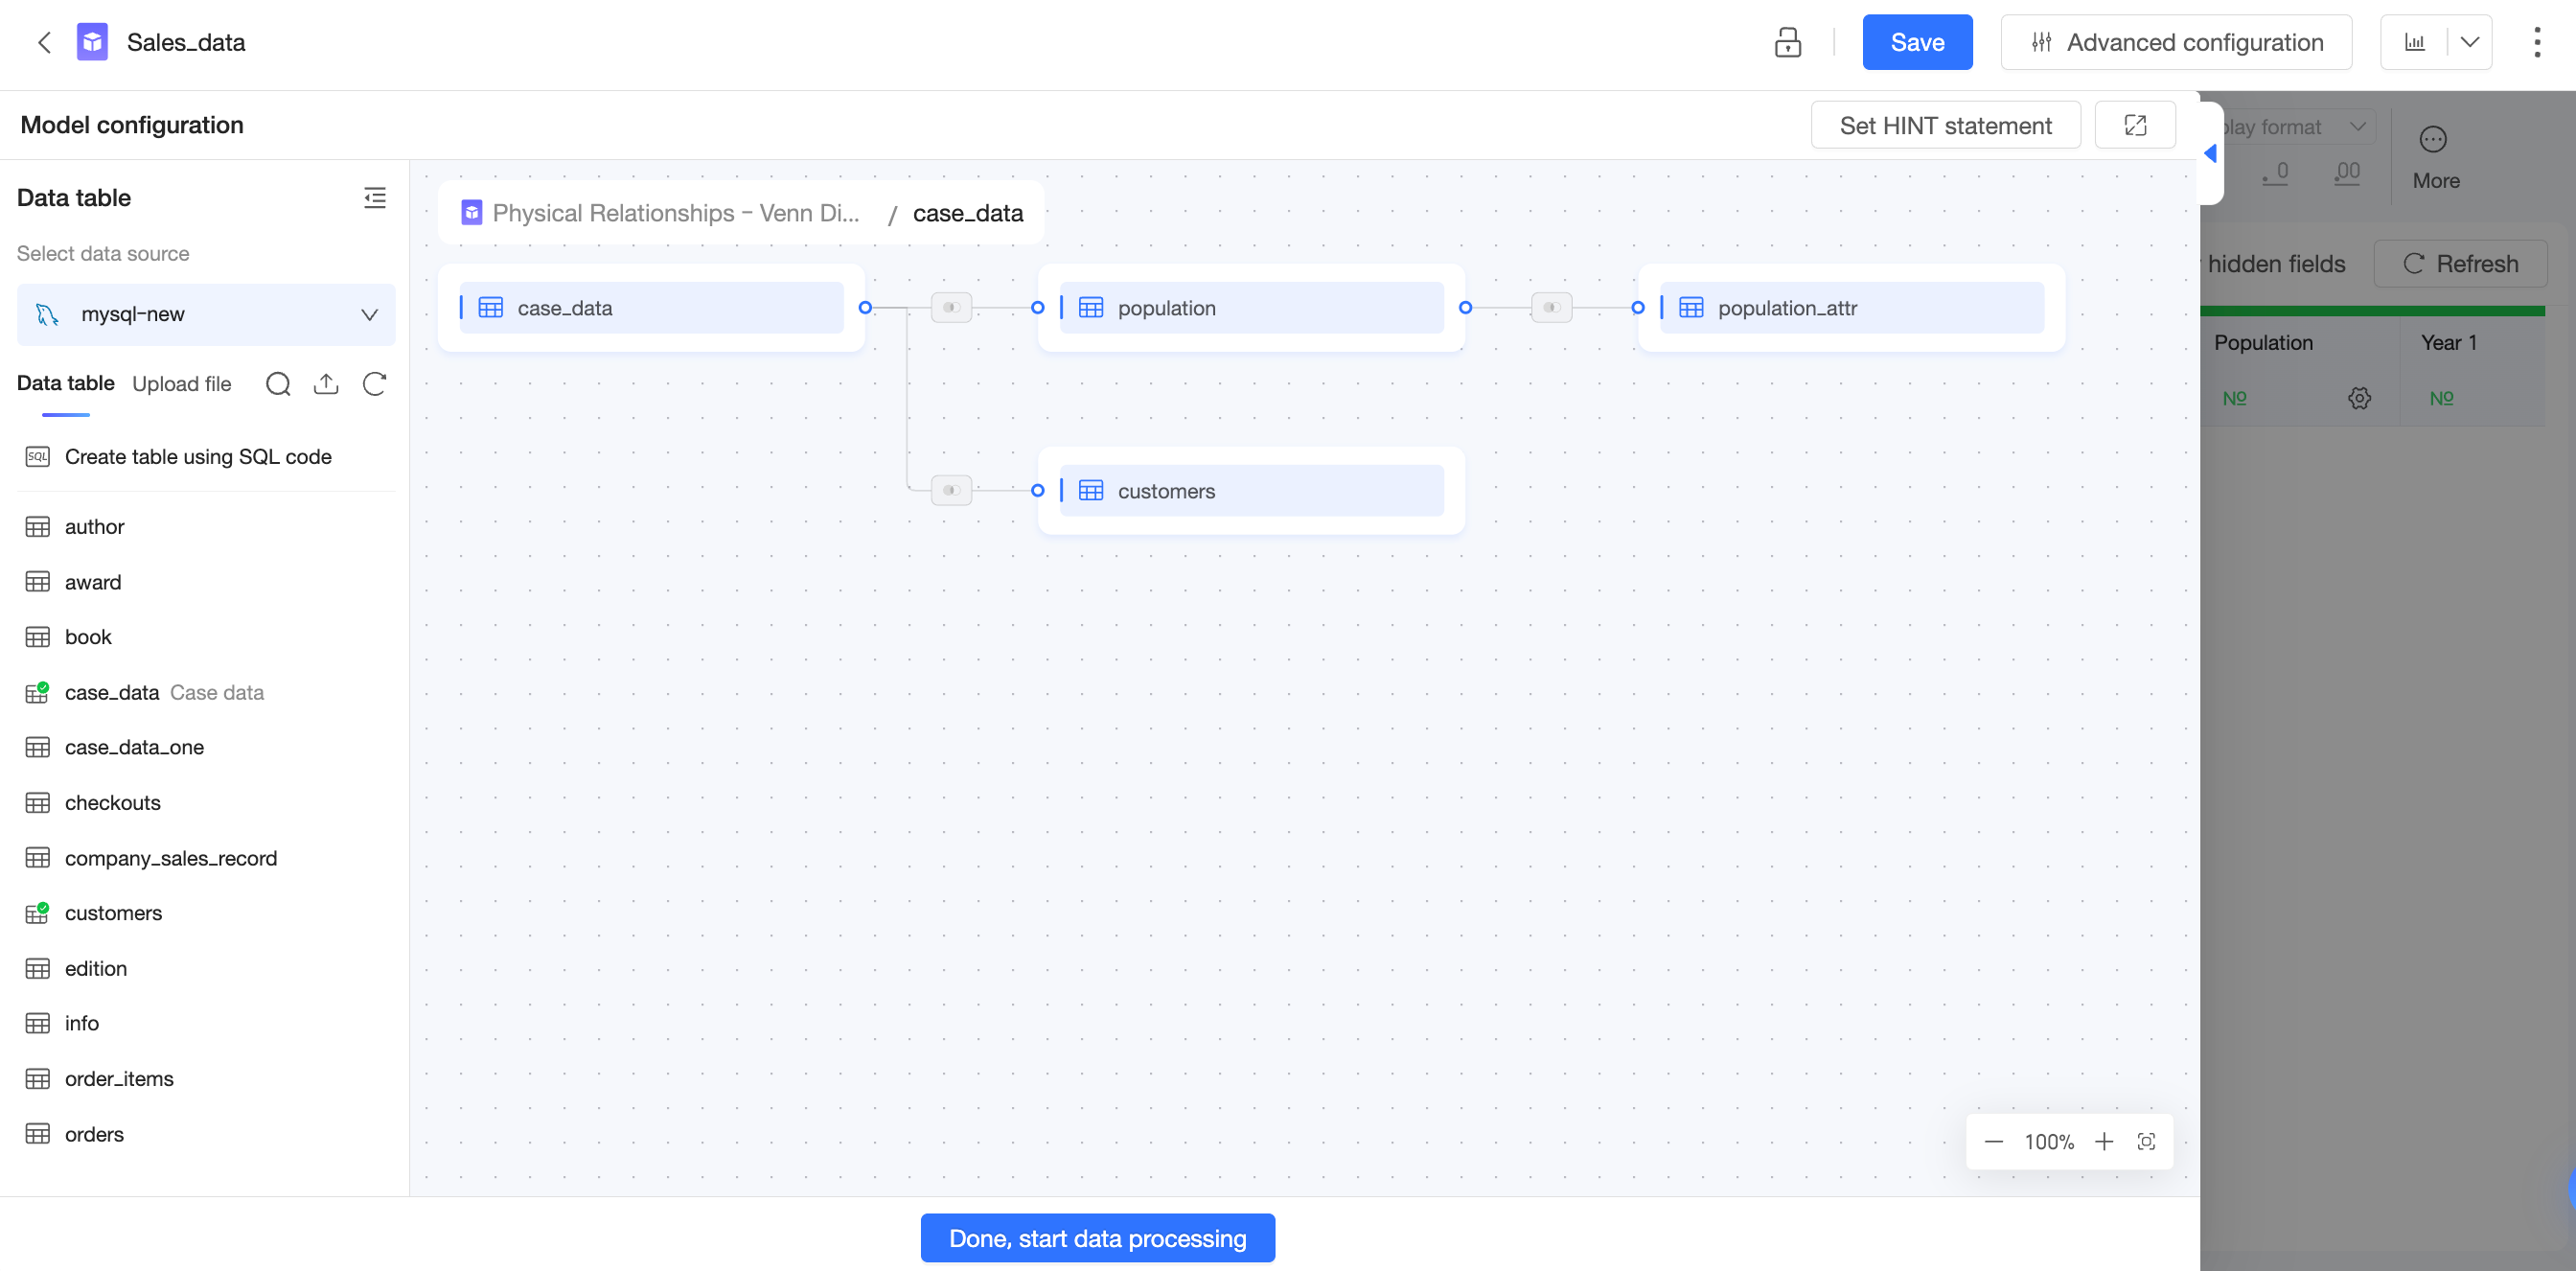
Relacionamento entre as camadas lógica e física
Na camada lógica, as tabelas lógicas são conectadas por relacionamentos que formam o modelo relacional. Você não especifica tipos de junção e o resultado não é uma tabela ampla fixa.
Cada tabela lógica possui seu próprio modelo físico. Acesse a camada física clicando duas vezes em uma tabela lógica ou clique em no ícone  e selecione Go to Physical Canvas. Na camada física, as tabelas são conectadas usando junções ou uniões com tipos de junção explícitos, produzindo uma tabela ampla completa.
Cada tabela lógica na camada lógica tem um modelo físico correspondente (seja um modelo de tabela única ou de múltiplas tabelas) na camada física.
Nas versões anteriores do Quick BI, o modelo de dados tinha apenas uma camada física. A versão 6,1 e posteriores adicionaram uma camada lógica, habilitando o modelo relacional.
Cardinalidade e integridade referencial
Ao configurar um relacionamento, clique em More Options para definir a cardinality e a referential integrity. O Quick BI usa essas configurações para selecionar o tipo de junção mais adequado. Uma configuração precisa melhora o desempenho da consulta.
Se você não estiver familiarizado com a distribuição dos seus dados ou com os conceitos de cardinality e referential integrity, não altere as configurações padrão. Configurações incorretas podem levar a erros como duplicação ou perda de dados.
Ajuste as configurações de cardinality e referential integrity para otimizar o desempenho da consulta apenas se tiver um entendimento claro da distribuição dos seus dados e certeza de que ela não mudará no futuro.
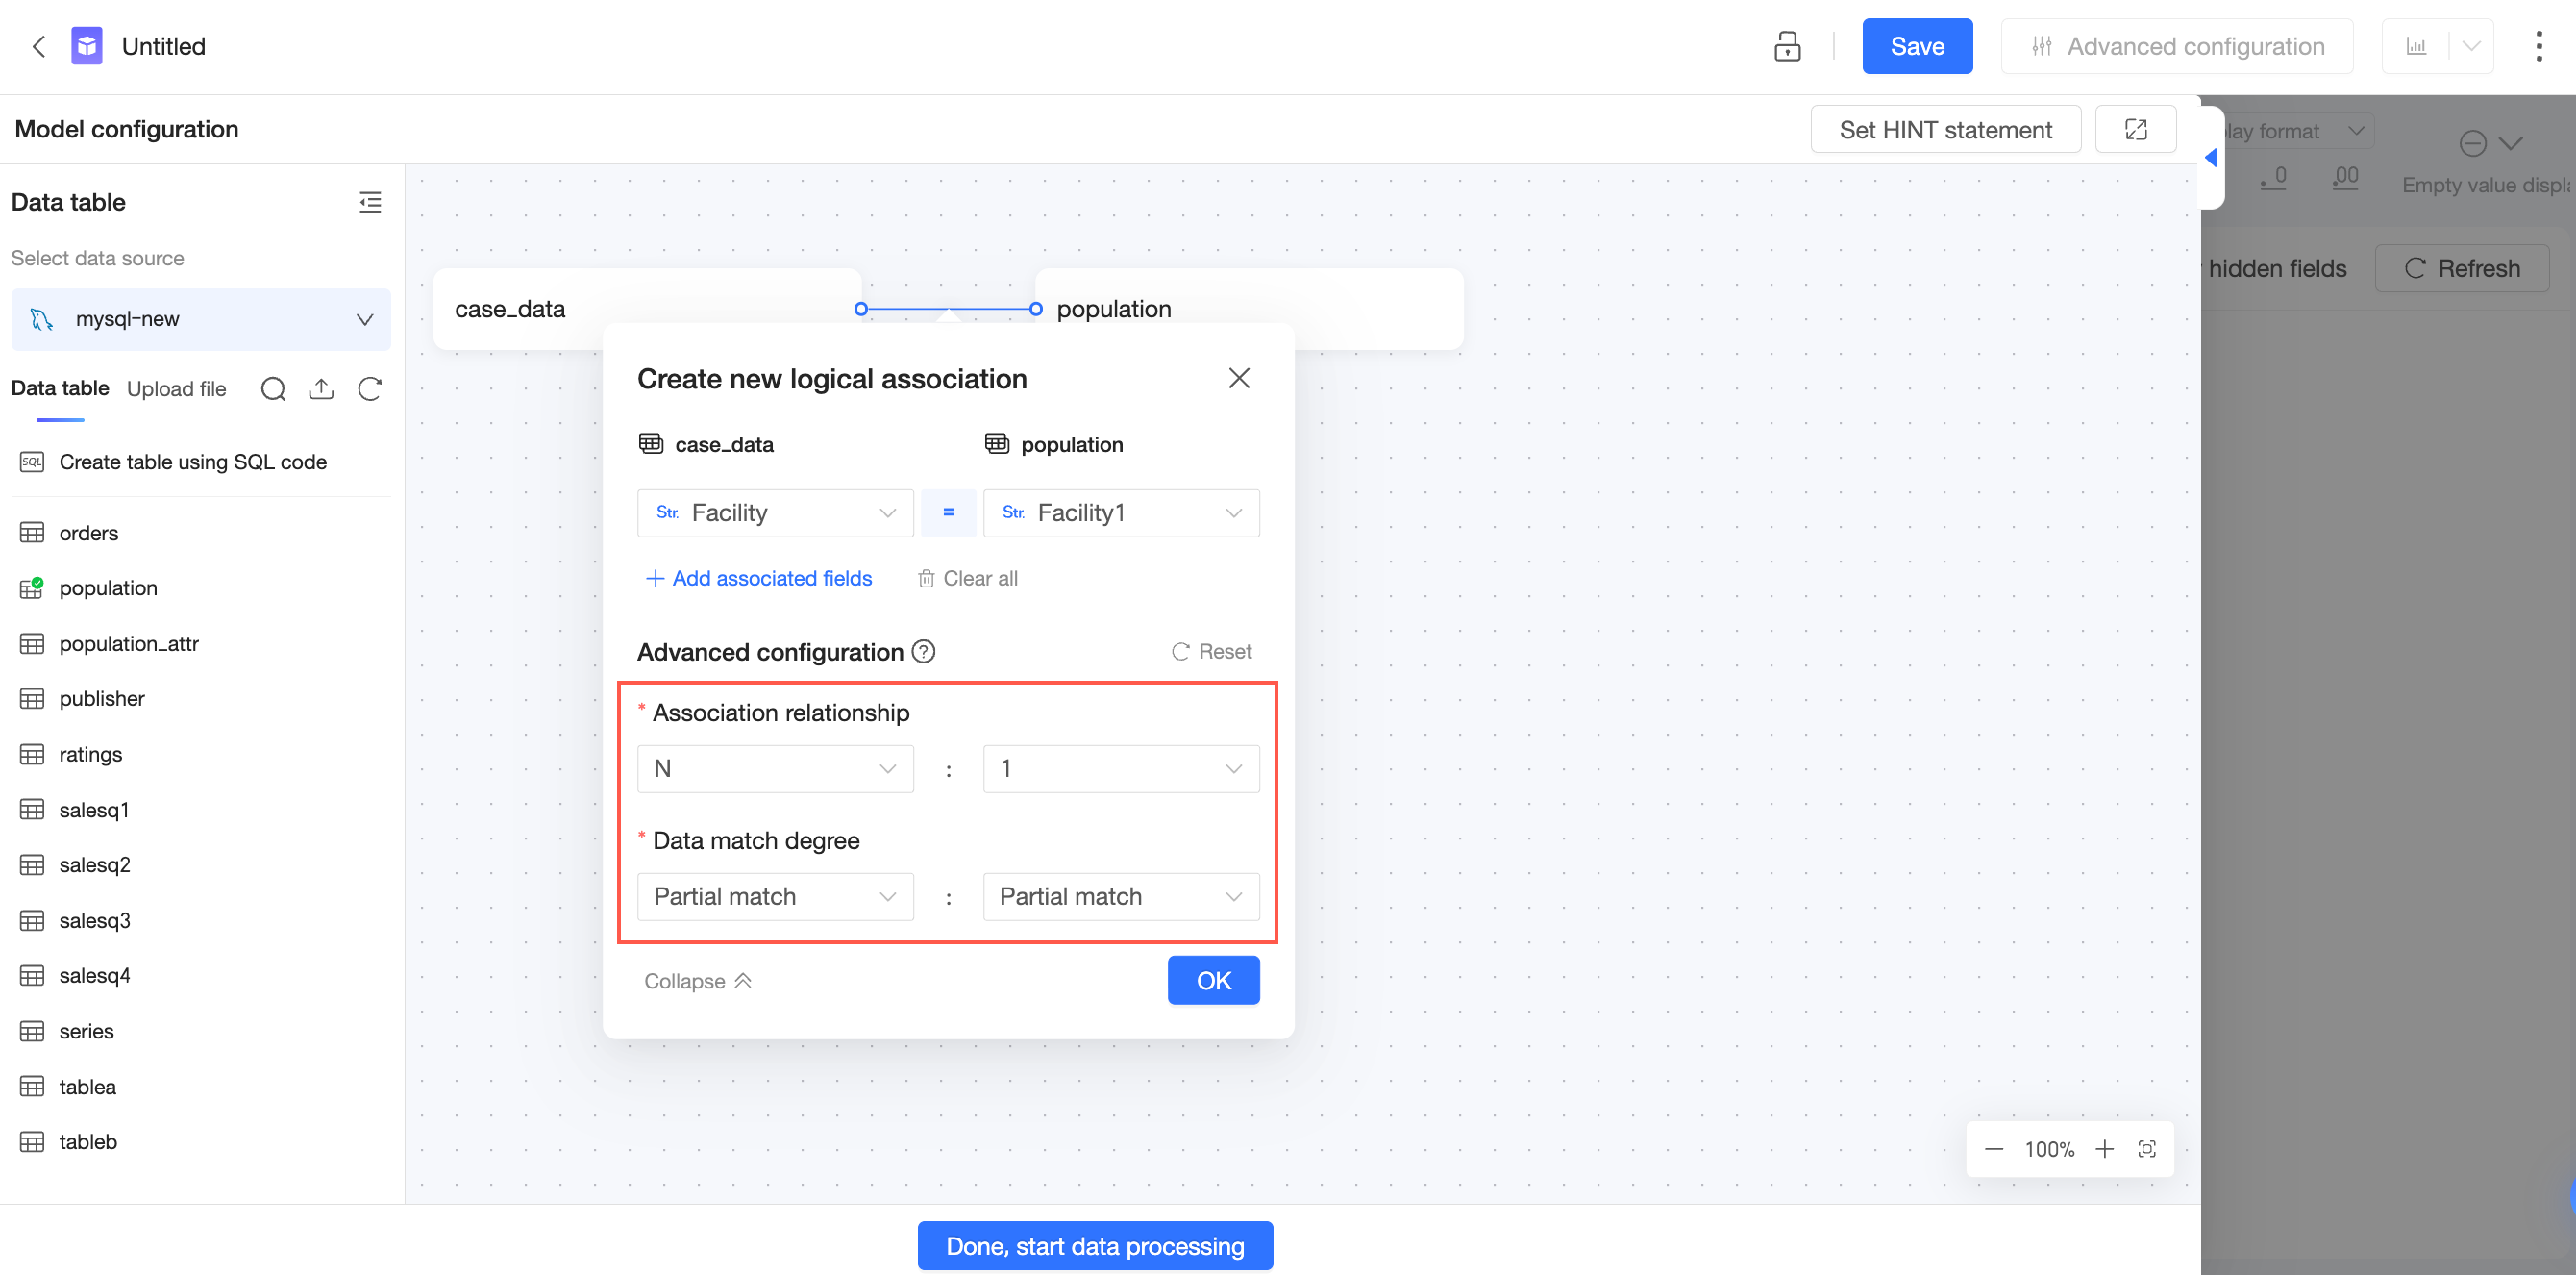
Cardinalidade
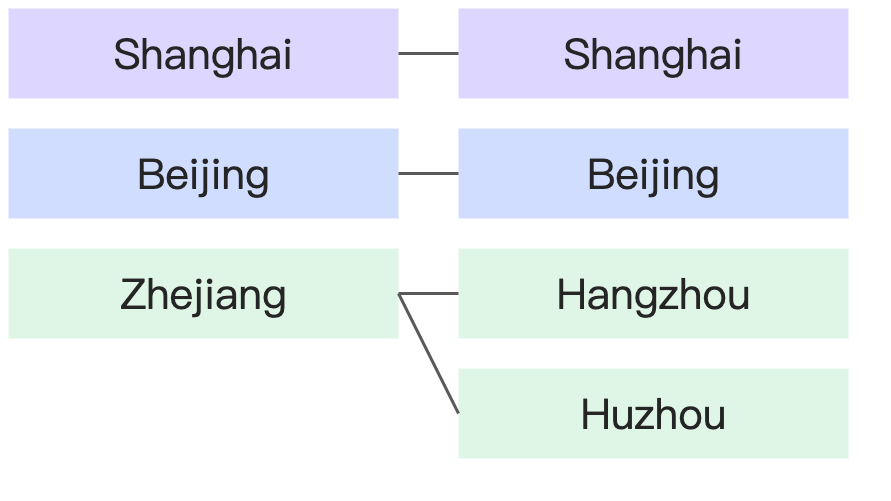
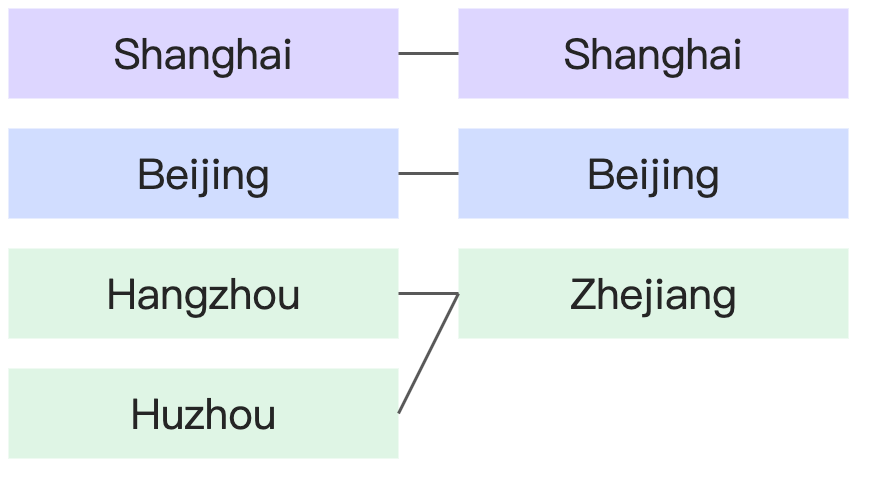
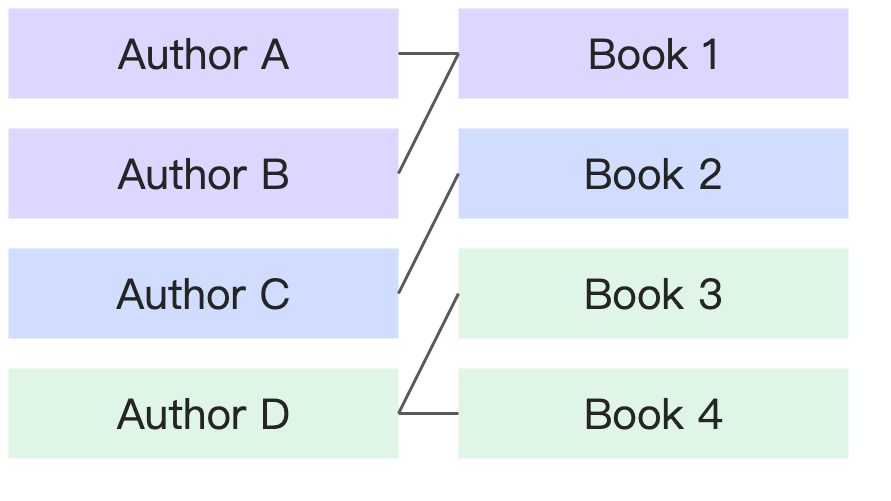
A cardinalidade descreve se os valores da chave de junção em uma tabela são únicos e como os valores da chave de junção em duas tabelas correspondem entre si.
1: O campo contém valores únicos.
N: O campo contém valores não únicos (muitos).
|
Cardinalidade |
Exemplo |
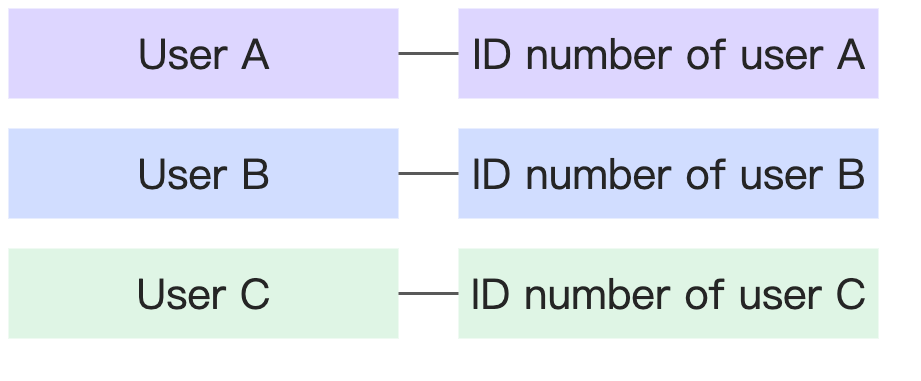
Diagrama |
|
1:1 |
Cada pessoa tem um número de CPF único, e cada número de CPF corresponde a apenas uma pessoa. |
|
|
1:N |
Cada estado corresponde a muitas cidades, mas cada cidade corresponde a apenas um estado. |
|
|
N:1 |
|
|
|
N:N |
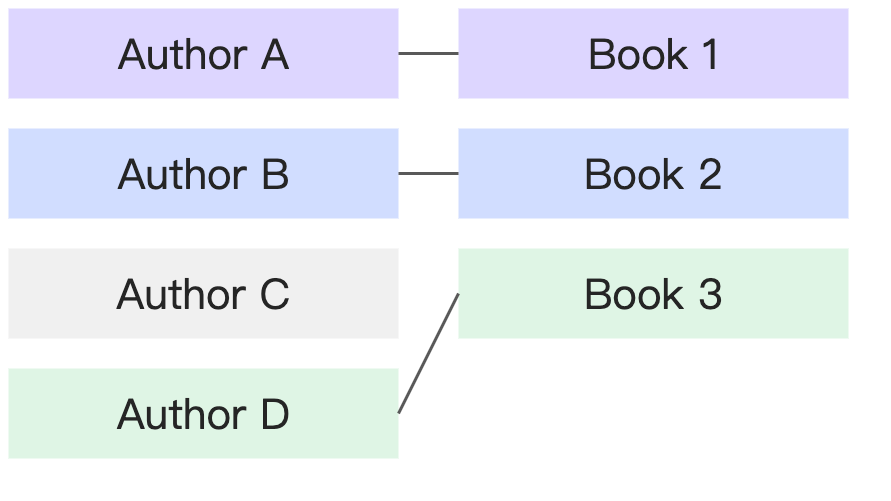
Um livro pode ter muitos autores, e um autor pode ter muitos livros. |
|
Integridade referencial
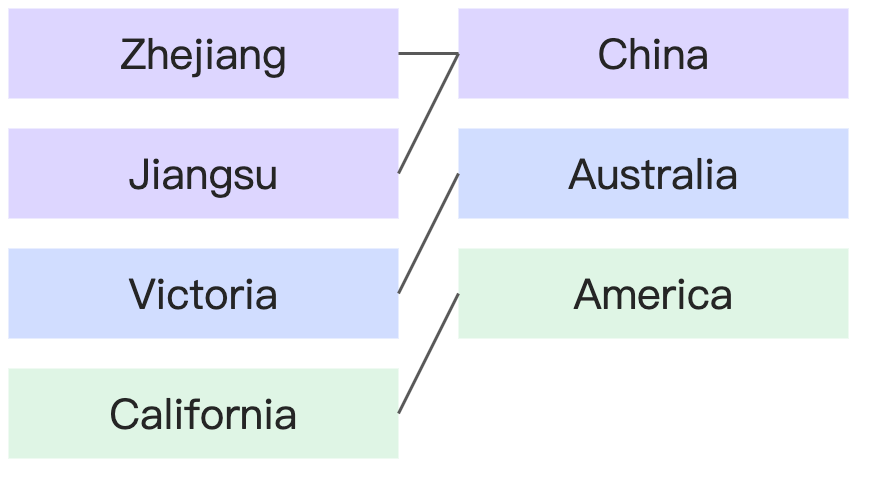
A integridade referencial descreve se os valores da chave de junção em uma tabela podem ser completamente correspondidos aos valores em outra tabela. Em outras palavras, descreve a completude dos dados.
Alguns registros correspondem: Alguns valores de campo em uma tabela não têm correspondência na outra tabela.
Todos os registros correspondem: Todos os valores de campo em uma tabela têm uma correspondência na outra tabela.
|
Integridade referencial |
Exemplo |
Diagrama |
|
All records match : All records match |
Todo país tem estados correspondentes, e todo estado tem um país correspondente. |
|
|
Some records match : All records match |
Todo livro tem um autor correspondente, mas alguns autores podem não ter um livro correspondente (por exemplo, ainda não publicaram). |
|
|
All records match : Some records match |
||
|
Some records match : Some records match |
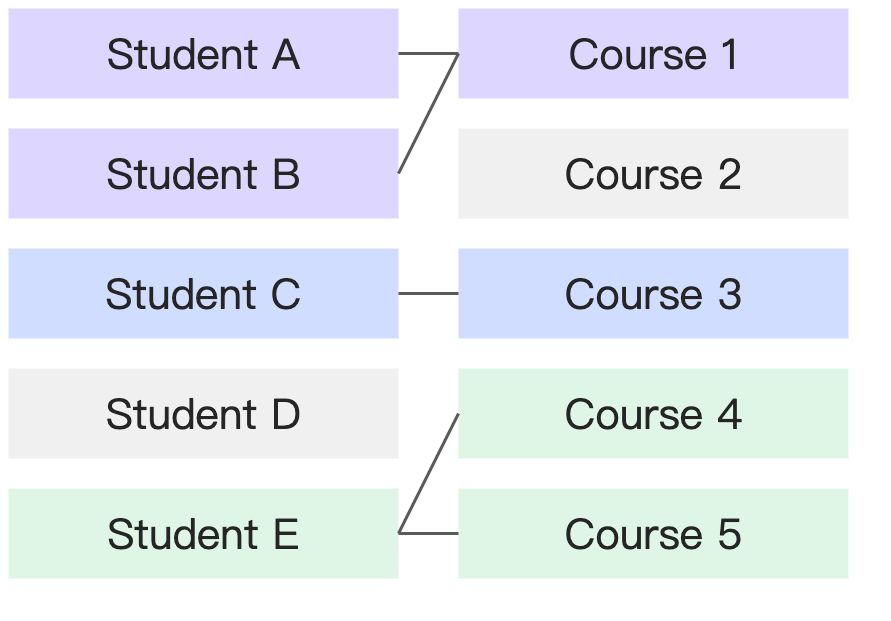
Alguns alunos não têm um curso correspondente (ainda não se matricularam), e alguns cursos não têm alunos correspondentes (ninguém se matriculou). |
|
Casos de uso do modelo relacional
Casos de uso do modelo relacional
Caso de uso 1: Modelagem simples para usuários de negócios
Se você tem conhecimento limitado de SQL ou banco de dados, utilize o modelo relacional para modelagem de dados.
Configurar um modelo relacional é mais simples do que a modelagem física — especifique a chave de junção entre duas tabelas e mantenha os valores padrão para configurações avançadas. O modelo relacional evita a duplicação de dados sem exigir que você compreenda a integridade ou unicidade dos dados, reduzindo a barreira de modelagem e melhorando a precisão.
Exemplo
Um departamento de RH cria um sistema de pontos para incentivar os funcionários a participar de atividades de treinamento. Os funcionários ganham pontos ao frequentar eventos e podem trocá-los por presentes. O banco de dados possui duas tabelas:
Tabela de pontos ganhos: Data, ID do Funcionário, Departamento, Nome da Atividade, Pontos Ganhos
Tabela de pontos resgatados: Data, ID do Funcionário, Departamento, Nome do Presente, Pontos Gastos
O relacionamento entre a tabela de pontos ganhos e a tabela de pontos resgatados é o seguinte:
|
Tabela de pontos ganhos - Tabela de pontos resgatados |
||
|
Cardinalidade |
N:N |
Um funcionário pode participar de várias atividades para ganhar pontos e também pode resgatar pontos várias vezes. Portanto, o campo "ID do Funcionário" não é único em nenhuma das tabelas. |
|
Integridade referencial |
Some records match : All records match |
Um funcionário pode ganhar pontos, mas nunca resgatá-los. Nesse caso, o registro do funcionário existe na "Tabela de pontos ganhos", mas não na "Tabela de pontos resgatados". Se um funcionário nunca ganhou pontos, ele não pode resgatá-los. Portanto, um registro não pode existir na "Tabela de pontos resgatados" se não existir também na "Tabela de pontos ganhos". |
O analista de RH precisa verificar os pontos restantes por funcionário. Uma junção física em "ID do Funcionário" duplicaria os dados porque o campo não é único em nenhuma das tabelas. A abordagem correta de modelagem física — agregar ambas as tabelas por "ID do Funcionário" antes de juntar — exige habilidades de pré-processamento de dados.
Com o modelo relacional, o analista cria um relacionamento em "ID do Funcionário" e o Quick BI agrega automaticamente os dados durante o cálculo para garantir a precisão.
A lógica de cálculo está descrita em Como funciona o modelo relacional.
Caso de uso 2: Melhorar a reutilização de conjuntos de dados
Um usuário de TI pode arrastar todas as tabelas relacionadas para a tela lógica e construir um único modelo relacional abrangente. Os usuários de negócios então selecionam os campos necessários. Isso elimina a necessidade de criar diversas tabelas amplas para diferentes cenários analíticos, evitando a proliferação de conjuntos de dados.
Neste caso de uso, os usuários de TI devem configurar as definições de cardinalidade e integridade referencial com base nas características dos dados para otimizar o desempenho da consulta.
Exemplo
Vamos retornar ao exemplo do sistema de pontos do departamento de RH:
Tabela de pontos ganhos: Data, ID do Funcionário, Departamento, Nome da Atividade, Pontos Ganhos
Tabela de pontos resgatados: Data, ID do Funcionário, Departamento, Nome do Presente, Pontos Gastos
Diferentemente do exemplo anterior, esta empresa possui uma equipe de TI centralizada que prepara conjuntos de dados para todos os analistas. O departamento de RH envia solicitações de dados para três cenários. Com a modelagem física, a equipe de TI precisa criar três conjuntos de dados separados.
|
Cenário |
Descrição |
Abordagem de modelagem |
|
Cenário 1 |
Analisar a contagem de participantes e pontos ganhos para cada atividade. |
Tabela de pontos ganhos (modelo de tabela única) |
|
Cenário 2 |
Analisar o número de pessoas e resgates para cada presente. |
Tabela de pontos resgatados (modelo de tabela única) |
|
Cenário 3 |
Analisar os pontos restantes de cada funcionário e criar um ranking. |
Juntar as tabelas de pontos ganhos e pontos resgatados após agregar cada uma por "ID do Funcionário". |
Como as duas tabelas têm granularidades diferentes, uma junção física direta duplica os dados. A pré-agregação por "ID do Funcionário" perde campos de detalhe como "Nome da Atividade" e "Nome do Presente", tornando impossíveis as análises dos Cenários 1 e 2. A modelagem física, portanto, exige três conjuntos de dados separados.
Com um modelo relacional, um único conjunto de dados é suficiente. O Quick BI seleciona automaticamente o método de cálculo apropriado com base nos campos usados em cada análise.
|
Cenário |
Descrição |
Abordagem de modelagem |
Campos utilizados |
Tratamento do modelo |
|
Cenário 1 |
Analisar a contagem de participantes e pontos ganhos para cada atividade. |
Chave de junção: ID do Funcionário N:N Some : All |
Dimensão: Nome da Atividade Medidas: ID do Funcionário (contagem distinta), Pontos Ganhos (soma) |
Consulta de tabela única |
|
Cenário 2 |
Analisar o número de pessoas e resgates para cada presente. |
Dimensão: Nome do Presente Medidas: ID do Funcionário (contagem distinta), Pontos Gastos (soma) |
Consulta de tabela única |
|
|
Cenário 3 |
Analisar os pontos restantes de cada funcionário e criar um ranking. |
Dimensão: ID do Funcionário Medida: SUM(Pontos Ganhos) - SUM(Pontos Gastos) |
Junção após agregação |
A lógica de cálculo está descrita em Como funciona o modelo relacional.
Limitações
Limitações de desempenho
Para evitar a duplicação de dados, o modelo relacional gera SQL mais complexo com subconsultas adicionais e aninhamento mais profundo, o que pode degradar o desempenho da consulta. O impacto aumenta conforme o volume de dados e a complexidade do modelo.
Se você conhece bem a distribuição dos seus dados, ajuste as configurações de cardinalidade e integridade referencial para otimizar o desempenho. Classificação de desempenho:
Cardinalidade: 1:1 > 1:N = N:1 > N:N
Integridade Referencial: All records match : All records match > All records match : Some records match = Some records match : All records match > Some records match : Some records match
Se você não estiver familiarizado com a distribuição dos seus dados ou com os conceitos de "cardinalidade" e "integridade referencial", não altere as configurações padrão. Configurações incorretas podem levar a erros como duplicação ou perda de dados.
Ajuste as configurações de "cardinalidade" e "integridade referencial" para otimizar o desempenho da consulta apenas se tiver um entendimento claro da distribuição dos seus dados e certeza de que ela não mudará no futuro.
Se você exigir o máximo desempenho de consulta e possuir fortes habilidades de processamento de dados, use a modelagem física tradicional para evitar a sobrecarga computacional do modelo relacional.
Limitações de volume de dados
Quando as medidas vêm de múltiplas tabelas lógicas, o Quick BI consulta cada tabela separadamente e junta os resultados. Para garantir a eficiência da consulta e a estabilidade do serviço, cada consulta tem um limite de volume de dados de 10.000 linhas. Como funciona o modelo relacional.
Esse limite de 10.000 linhas aplica-se a dados agregados. Por exemplo, se a chave de junção for "Região" e a dimensão da consulta for "Tipo de Produto", a consulta da tabela lógica agregará por ambos os campos e retornará as primeiras 10.000 linhas.
A paginação não consegue recuperar dados além do limite de 10.000 linhas. Se sua consulta exigir uma granularidade mais fina ou se sua dimensão tiver muitos valores únicos, o modelo relacional poderá retornar dados incompletos. Nesses casos, utilize junções físicas tradicionais.
Limitações de recursos
O modelo relacional introduziu mudanças significativas no processamento subjacente de dados. Os seguintes recursos não são compatíveis com versões mais antigas:
Importar um conjunto de dados de uma versão mais recente para um ambiente mais antigo causa um erro. Atualize o ambiente de destino para a versão 6,1 ou posterior antes de importar.
-
A API
QueryDatasetDetailInfonão é mais compatível com conjuntos de dados do modelo relacional. UseQueryDatasetInfoem seu lugar.
O Quick BI v6.1 introduziu a versão inicial do modelo relacional. Os seguintes recursos atualmente suportam apenas conjuntos de dados de tabela lógica única (suporte a múltiplas tabelas planejado para versões futuras):
Preparação de dados
Condições de filtro complexas não podem referenciar campos de múltiplas tabelas lógicas. Recursos afetados:
Segurança em nível de linha: incluindo autorização de combinação condicional e autorização baseada em tag de usuário
Painel - Composite Query Control
Monitoramento e alerta - regra de alerta
Limitação de aceleração de extração: Se uma consulta envolver mais de três tabelas lógicas, o sistema ignora o mecanismo de aceleração e usa uma conexão direta.