Este tópico descreve o recurso Clustered Columnar Index (CCI).
As soluções de Online Transaction Processing (OLTP) e Online Analytical Processing (OLAP) baseiam-se na separação de leitura e escrita ou no modelo extract, transform, load (ETL). Essas soluções extraem dados de bancos de dados online e os carregam em um data warehouse para análise via T+1. No entanto, apresentam diversas desvantagens, como alto custo de armazenamento, baixa capacidade de processamento em tempo real e elevados custos de manutenção e conectividade.
Para lidar com o crescimento explosivo de dados, o PolarDB-X oferece o recurso CCI baseado no Object Storage Service (OSS). Esse recurso permite sincronizar dados orientados a linhas com dados orientados a colunas em tempo real e oferece as seguintes capacidades:
Suporte a OLTP integrado e análise de dados em tempo real, atendendo aos requisitos de cenários que envolvem OLTP e OLAP.
Suporte a roteamento inteligente e massively parallel processing (MPP) no PolarDB-X. A camada de computação identifica com precisão o tráfego de processamento transacional (TP) e o tráfego de processamento analítico (AP), roteando-os para diferentes mídias de armazenamento. Por padrão, essa camada também garante a ativação do MPP nos rastreamentos de AP para escanear CCIs, o que melhora significativamente as capacidades de análise de consultas.
Utilização do modelo Delta+Main para implementar atualizações em tempo real na ordem de segundos. O recurso integra-se ao Multi-Version Concurrency Control (MVCC) para garantir a leitura consistente de dados de snapshot a qualquer momento.
Observações de uso
O recurso CCI tem suporte apenas em instâncias Enterprise Edition com versão 5.4.19-16989811 ou posterior.
-
Apenas bancos de dados no modo AUTO oferecem suporte à criação de CCIs.
NotaPara obter informações sobre versionamento de instância, consulte Release notes.
Para saber como visualizar a versão de uma instância PolarDB-X, consulte Visualize e atualize a versão do mecanismo de uma instância PolarDB for Xscale.
Arquitetura
Armazenamento híbrido linha-coluna

Componentes principais
Os nós de computação (CNs) funcionam como ponto de entrada do sistema. Esses nós utilizam design stateless e incluem módulos como parser SQL, otimizador e executor. Os CNs realizam o roteamento distribuído de dados, computação, agendamento dinâmico, coordenação de transações distribuídas baseadas no protocolo Two-Phase Commit (2PC) e manutenção de índices secundários globais. Além disso, fornecem recursos de nível empresarial, como limitação de SQL e modo de três funções.
Os nós de dados (DNs) cuidam da persistência de dados orientados a linhas. Eles garantem a durabilidade dos dados e oferecem fortes garantias de consistência com base no protocolo Paxos de maioria múltipla. Os DNs usam MVCC para manter a visibilidade das transações distribuídas e também atendem aos requisitos de operações que precisam delegar tarefas de computação em arquiteturas distribuídas, como Project, Filter, Join e Aggregation.
O Global Meta Service (GMS) mantém metadados de sistema globalmente consistentes, incluindo metadados de tabela, schema e estatísticas. O GMS gerencia informações relacionadas à segurança, como contas de usuário e permissões, e fornece o service Timestamp Oracle (TSO).
O Change Data Capture (CDC) oferece capacidades de assinatura incremental totalmente compatíveis com os formatos e protocolos de binary logs do MySQL. Ele também fornece recursos de replicação primária/secundária compatíveis com os protocolos de replicação do MySQL.
O componente Columnar fornece CCIs persistentes, consome os binary logs de transações distribuídas em tempo real e constrói CCIs com base no OSS para atender aos requisitos de atualizações em tempo real. Quando combinado com CNs, o Columnar oferece capacidades de consulta com consistência de snapshot para CCIs.
Armazenamento orientado a colunas

Conceito de arquitetura
Com a crescente popularidade das tecnologias cloud-native, data warehouses cloud-native de nova geração, como Snowflake, e a arquitetura HTAP impulsionam continuamente a inovação. É evidente que, num futuro próximo, o armazenamento híbrido linha-coluna com capacidades HTAP se tornará um requisito padrão para bancos de dados. Portanto, é fundamental focar em aspectos voltados para o futuro, como custo-benefício, facilidade de uso e alto desempenho nos projetos atuais de armazenamento orientado a colunas.
O PolarDB-X oferece o recurso CCI. Por padrão, uma tabela orientada a linhas no PolarDB-X possui índices de chave primária e índices secundários. Um CCI é um índice secundário construído sobre uma estrutura orientada a colunas e válido para todas as colunas de uma tabela orientada a linhas. Uma tabela pode conter tanto dados orientados a linhas quanto dados orientados a colunas.
Recursos de arquitetura
-
Arquitetura cloud-native (armazenamento e computação desacoplados e custo-benefício)
O recurso CCI do PolarDB-X utiliza o OSS como armazenamento principal de dados, gerando custos equivalentes a um sexto ou até um décimo dos custos de armazenamento em disco local. O recurso também implementa uma alta taxa de compressão para dados orientados a colunas, que chega a ser de três a cinco vezes superior à de outros tipos de dados. Isso confere ao CCI uma vantagem competitiva em termos de redução de custos. Em cenários HTAP que envolvem armazenamento híbrido linha-coluna, os custos adicionais do armazenamento orientado a colunas podem ser mantidos entre 5% e 10% dos custos do armazenamento orientado a linhas.
O recurso CCI do PolarDB-X aproveita o modelo de duas camadas Delta+Main, semelhante à estrutura LSM e às tecnologias de exclusão por tag em sua camada de armazenamento, para garantir altas capacidades de atualização com alta concorrência mesmo utilizando o OSS. Múltiplas camadas de cache de dados locais e um mecanismo de estatísticas multinível também são empregados nos rastreamentos em que o recurso CCI lê dados do OSS, minimizando acessos remotos desnecessários aos dados armazenados no OSS.
-
Sistema de banco de dados distribuído (dimensionamento linear)
Em bancos de dados distribuídos tradicionais, os CCIs são geralmente construídos usando mecanismos de múltiplas réplicas baseados nos protocolos Paxos ou Raft. No entanto, OLTP e OLAP possuem requisitos de consulta distintos e diferentes graus de dependência de recursos. As políticas de particionamento de forte consistência e os mecanismos de dimensionamento entre diferentes réplicas podem limitar as capacidades de dimensionamento linear de TP e AP, degradando o desempenho do banco de dados.
O recurso CCI do PolarDB-X implementa transformação heterogênea de dados orientados a linhas para orientados a colunas (M:N) com base na sincronização em tempo real dos binary logs de transações distribuídas. O recurso define chaves de partição distribuídas e chaves de ordenação para os CCIs. O PolarDB-X utiliza técnicas de processamento paralelo distribuído para fornecer escalabilidade linear para consultas baseadas em CCI. As mídias de armazenamento orientadas a linhas e a colunas são isoladas entre si, permitindo dimensionar recursos de armazenamento e computação com facilidade. Em um ambiente distribuído, consultas baseadas em CCI podem se beneficiar de uma escalabilidade linear extrema.
-
Separação de leitura e escrita (arquitetura serverless com precificação pagamento conforme o uso para leituras)
O recurso CCI do PolarDB-X adota uma arquitetura de separação de leitura e escrita baseada em componentes. Essa arquitetura consiste em nós de column store e nós de computação. Os nós de column store são stateless e não lidam diretamente com solicitações de escrita de clientes externos; em vez disso, utilizam a tecnologia Group Commit para atualizar dados CCI em lote. Os nós de computação também são stateless, recuperam metadados columnar dos nós GMS e acessam diretamente os dados CCI armazenados no OSS.
Ao criar uma instância PolarDB-X, o sistema fornece automaticamente nós de column store. Esses nós executam continuamente e sincronizam os CCIs. Crie facilmente um CCI executando uma instrução DDL. Após a construção do CCI, os dados são gerados automaticamente e atualizados em tempo real. Utilize uma instância primária ou adquira uma instância somente leitura adicional para acessar índices de row store e CCIs. O modo serverless também é adequado para CNs stateless, com cobrança apenas pelo uso desses nós.
-
Combinação de armazenamento orientado a linhas e colunas (facilidade de uso, mecanismo SQL vetorizado integrado)
O PolarDB-X reutiliza o mecanismo SQL dos CNs para fornecer suas capacidades completas. Um otimizador de custos foi desenvolvido para cenários híbridos linha-coluna. Esse otimizador identifica rotas inteligentemente com base nos custos de execução, encaminhando consultas OLTP para rastreamentos de consulta de row store e consultas OLAP para rastreamentos baseados em CCI. Ele permite acessar diferentes dados orientados a linhas e colunas no nível de operador SQL, implementando totalmente as capacidades híbridas linha-coluna do HTAP, além de permitir acesso unificado a um conjunto de mecanismos SQL.
O PolarDB-X é totalmente compatível com vetorização. A estrutura de dados de chunk columnar é usada pelo operador TableScan para ler dados orientados a colunas. As computações subsequentes dos operadores também herdam totalmente a estrutura columnar em memória dos chunks, melhorando o desempenho da consulta com base na vetorização ponta a ponta. O operador TableScan para armazenamento orientado a linhas também é convertido dinamicamente em chunks columnares para implementar consultas híbridas linha-coluna com base em uma estrutura de dados unificada.
-
Warehouse unificado (Zero-ETL)
Data warehouses tradicionais usam ETL para sincronizar dados e aproveitam arquiteturas de computação paralela, como MPP e Bulk Synchronous Parallel (BSP), para lidar com consultas OLAP complexas. Contudo, em consultas online de alta concorrência (cenários de Serving), esses warehouses enfrentam gargalos na concorrência de recursos. Nesses casos, eles retornam dados aos bancos de dados OLTP para fornecer consultas online.
O PolarDB-X integra-se ao AnalyticDB for MySQL para fornecer um warehouse unificado. Esse warehouse aproveita dados CCI compartilhados com base no conceito zero-ETL. Ele também permite que várias partes realizem agregação de dados e consultas de correlação, oferecendo análises tradicionais de warehouse e data lake com base nas capacidades de warehousing do AnalyticDB for MySQL. A arquitetura híbrida linha-coluna com capacidades HTAP do PolarDB-X também pode ser usada para consultas concorrentes em dados online, eliminando a necessidade de ETL tradicional de dados.
Como os CCIs funcionam
Construção de CCIs
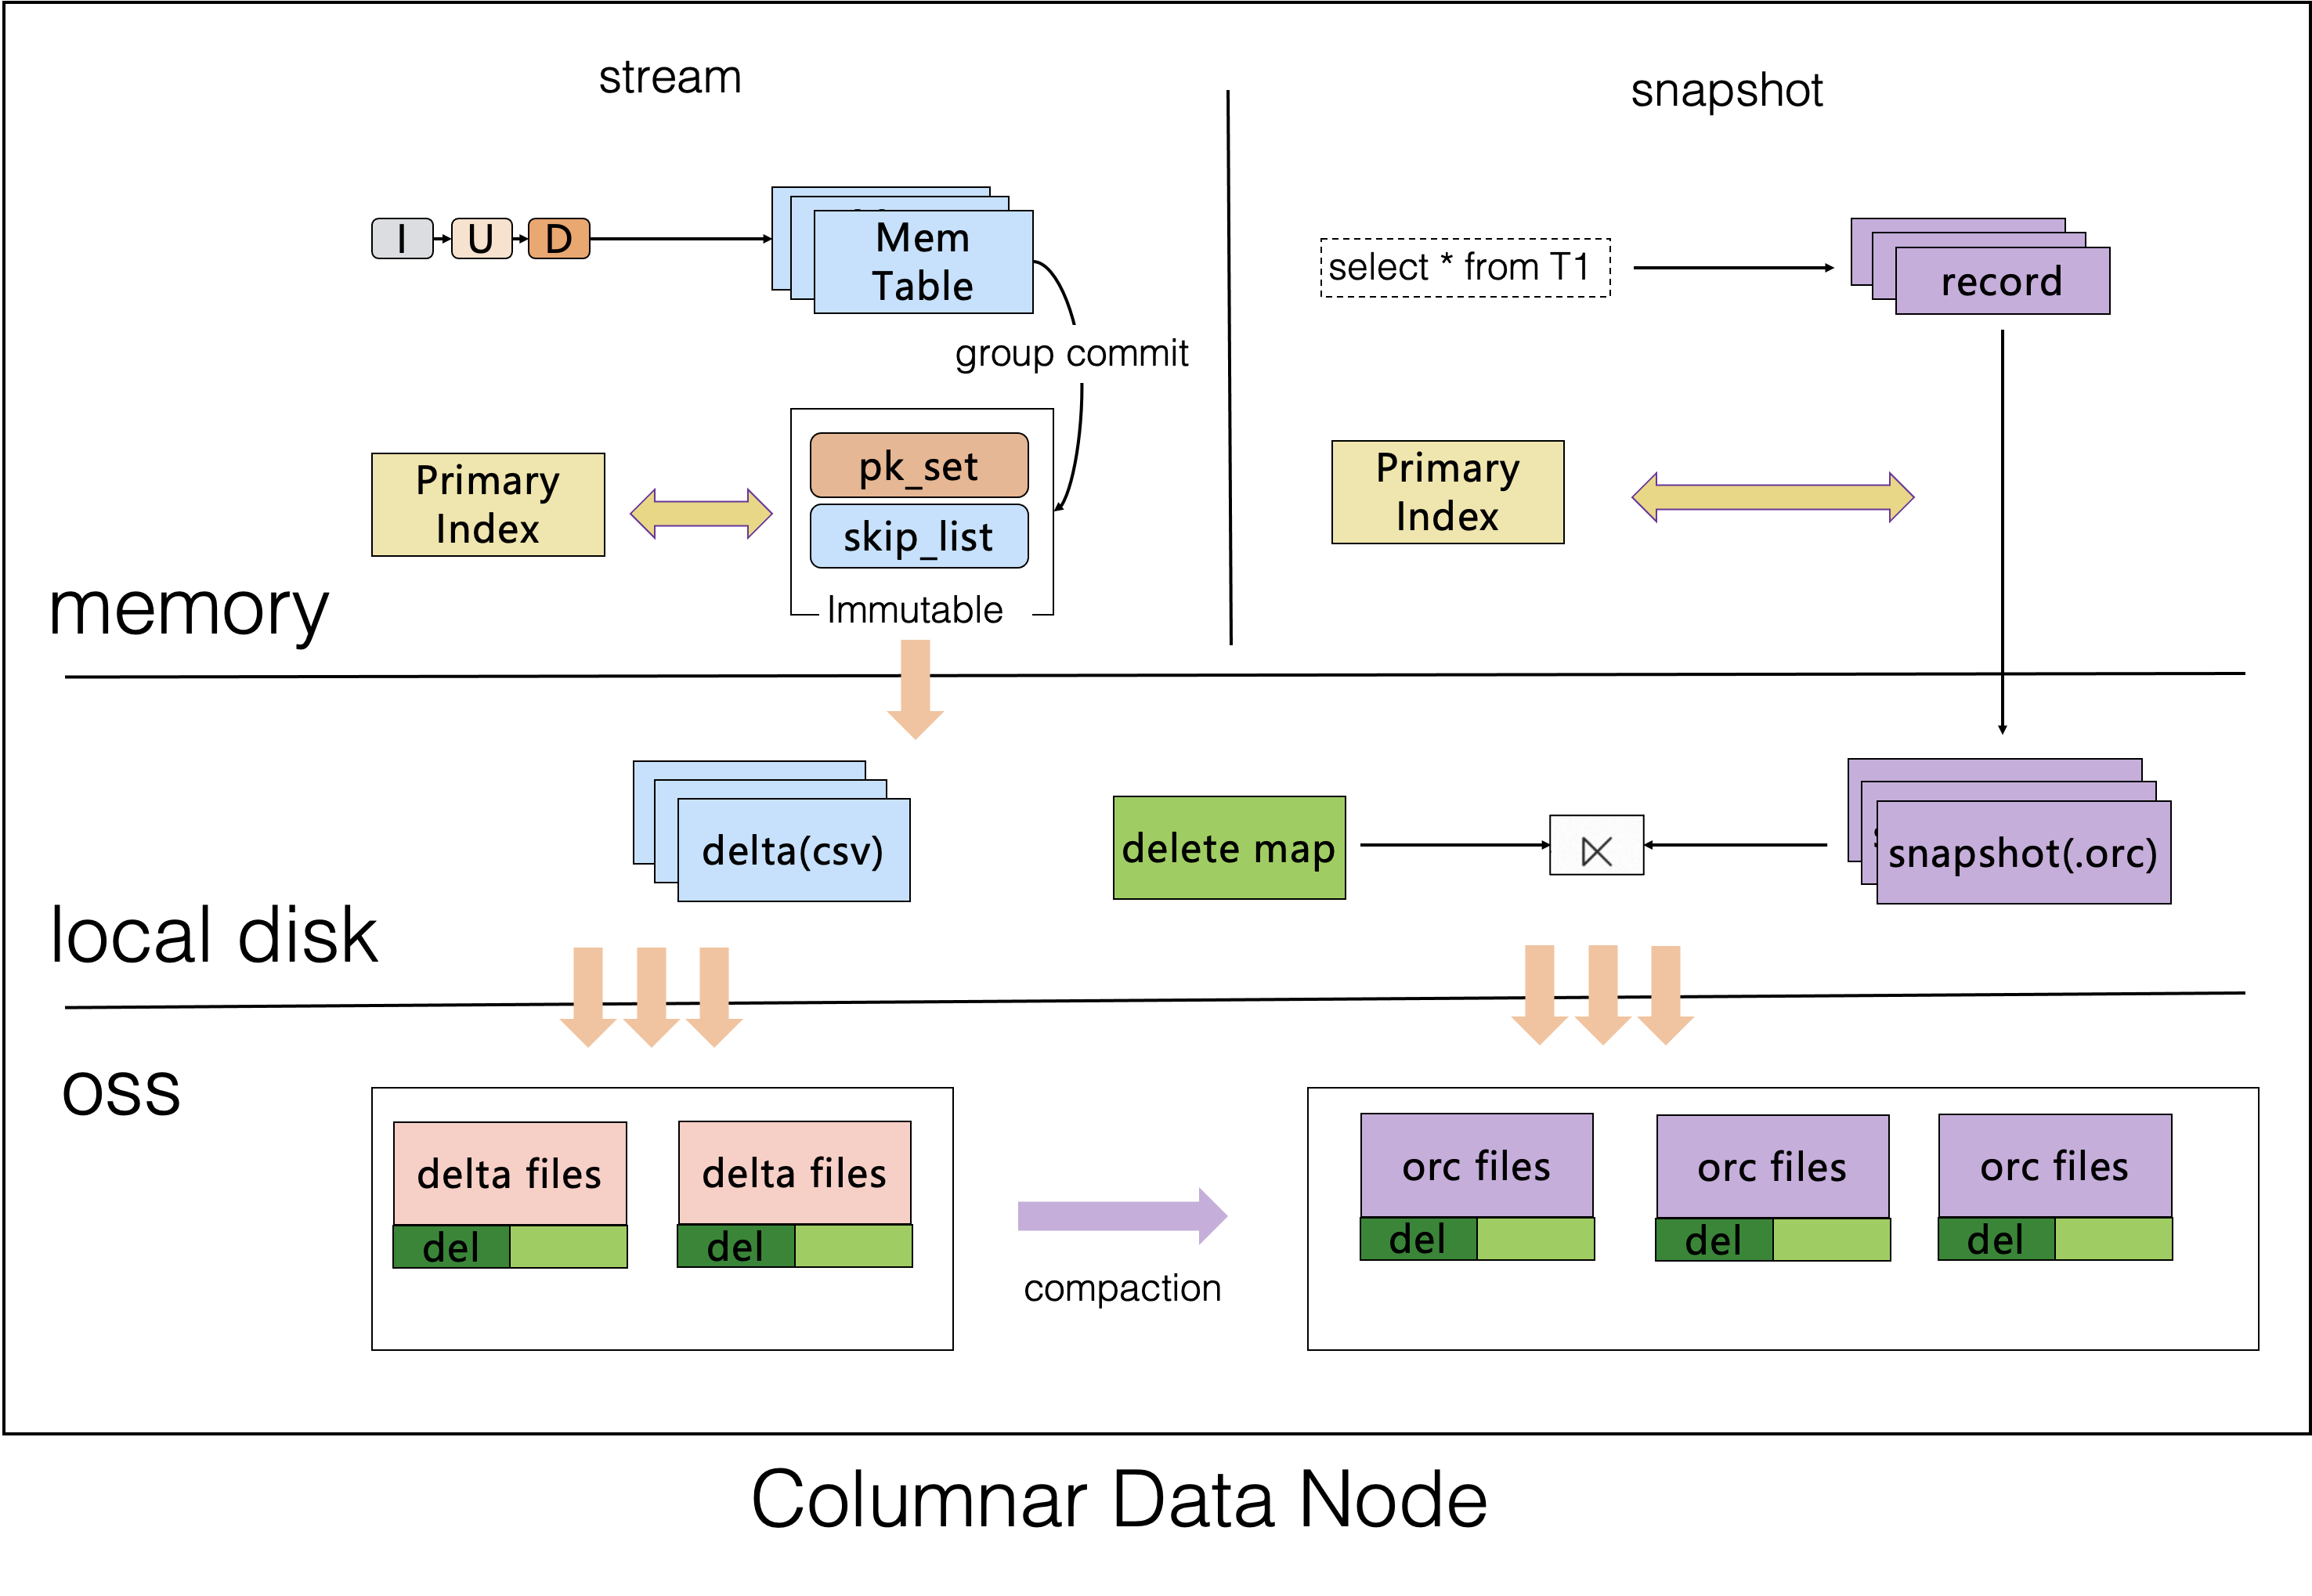
Os nós de column store constroem os CCIs. Os dados relacionados aos CCIs construídos são armazenados em objetos shard nos formatos CSV e ORC. O formato CSV armazena dados incrementais em tempo real. Dados incrementais excessivos são compactados oportunamente e despejados no formato ORC. O PolarDB-X otimizou os formatos CSV e ORC. Esses formatos otimizados herdam os recursos open source dos formatos nativos e garantem que ambos possam expressar completamente os protocolos de dados do MySQL.
Do ponto de vista da sincronização de dados, o processo de construção de CCIs envolve dois rastreamentos de sincronização paralelos: leitura completa de snapshot e sincronização incremental de dados. Em cenários em que os CCIs são construídos antes da importação de dados, apenas dados incrementais são sincronizados, e os nós de column store consomem simultaneamente binary logs para construir os CCIs. Em cenários em que os dados são parcialmente importados, seguidos pela construção dos CCIs e importação dos dados restantes, ocorre a sincronização de dados incrementais, e os nós de column store consomem simultaneamente dados incrementais existentes e dados completos para melhorar a eficiência da criação dos CCIs.
De uma perspectiva hierárquica, os nós de column store usam o modelo de duas camadas Delta+Main, semelhante à estrutura LSM e às tecnologias de exclusão por tag, para garantir sincronização de dados de baixa latência entre o armazenamento orientado a linhas e o orientado a colunas, além de atualizações de dados em tempo real na ordem de segundos. Os dados são gravados na MemTable em tempo real, armazenados em um arquivo CSV local e anexados ao arquivo CSV correspondente no OSS dentro de um ciclo de group commit. O arquivo local é denominado arquivo delta. O arquivo CSV no OSS não é armazenado permanentemente, sendo convertido periodicamente em um arquivo ORC por meio de compactação.
MPP

No PolarDB-X, os CNs lidam com o tráfego de consultas e análises. A figura anterior mostra que toda a cadeia de aceleração de consultas consiste em três níveis: otimizador, executor e mecanismo de armazenamento.
O PolarDB-X oferece um otimizador de custos adequado para cenários híbridos linha-coluna. Esse otimizador identifica rotas inteligentemente com base nos custos de execução, encaminhando consultas TP para rastreamentos de consulta de row store e consultas AP para rastreamentos baseados em CCI.
O PolarDB-X fornece um executor integrado adequado para cenários híbridos linha-coluna. Um conjunto de executores está disponível em cenários HTAP. A camada de operador também é vetorizada e suporta MPP. Em cenários de consultas complexas, recursos de múltiplos nós podem ser usados para computação paralela, atendendo aos requisitos de consultas complexas com alto throughput. Para eliminar a latência de rede causada pela arquitetura com recursos de computação e armazenamento desacoplados, a camada do executor também introduz tecnologia de cache local para carregar dados quentes em discos locais em tempo real, garantindo o atendimento aos requisitos de consultas de baixa latência.
No nível do mecanismo de armazenamento, a construção de CCIs habilita a atomicidade das transações confirmadas e garante a consulta de dados consistentes no nível de transação.
Tipos de service

Com a introdução do componente columnar, o PolarDB-X passou a oferecer um tipo adicional de service além das instâncias primárias e somente leitura. Esse novo tipo é conhecido como instâncias de column store somente leitura.
Instância primária: Por padrão, a instância primária permite consultar apenas dados orientados a linhas. No entanto, quando combinada com instâncias somente leitura, o endpoint da instância primária possibilita a separação transparente e fortemente consistente de leitura e escrita. A instância primária mantém a capacidade de consultar diretamente dados orientados a colunas. Os recursos de roteamento inteligente e consulta híbrida linha-coluna estarão disponíveis futuramente.
Instância somente leitura: Instâncias somente leitura permitem consultar dados orientados a linhas e dados CCI. Elas possuem endpoints dedicados somente leitura. As aplicações podem estabelecer conexões separadas a esses endpoints para executar operações de leitura. Ao se conectar a esses endpoints, as aplicações gerenciam independentemente as operações de leitura e escrita.
Instância de column store somente leitura: Instâncias de column store somente leitura permitem consultar exclusivamente dados CCI. Elas possuem endpoints dedicados somente leitura. As aplicações podem estabelecer conexões separadas a esses endpoints para executar operações de leitura. Essas instâncias consistem apenas em CNs e oferecem maior custo-benefício.
Cenário
O recurso CCI do PolarDB-X fornece uma solução HTAP unificada e pode ser utilizado em diversos cenários de negócios.
Cenários que exigem análise em tempo real de dados online na ordem de segundos, como negócios de relatórios em tempo real.
Cenários de data warehousing que dependem da grande capacidade de armazenamento de dados do PolarDB-X para agregar múltiplas fontes de dados upstream e utilizar o PolarDB-X como data warehouse dedicado.
Cenários de computação voltados para ETL que dependem das poderosas e flexíveis capacidades de computação dos CCIs do PolarDB-X.
O recurso CCI do PolarDB-X atende aos requisitos de cenários que envolvem TP e AP, fornecendo uma solução HTAP transparente e econômica baseada no OSS e em tecnologia de roteamento inteligente.
Testes de desempenho
Para obter informações sobre o teste TPC Benchmark-H (TPC-H) do PolarDB-X para Clustered Columnar Indexes (CCIs), consulte TPC-H test for clustered columnar index (100 GB).