Ao executar consultas analíticas em tabelas grandes do PolarDB, a varredura completa da tabela é o comportamento padrão: o IMCI carrega pacotes de dados do disco, descompacta-os e avalia cada linha. Em tabelas com centenas de milhões de linhas, esse processo é lento e sobrecarrega o cache LRU (Least Recently Used), reduzindo o total de consultas por segundo (QPS).
O recurso In-Memory Column Index (IMCI) do PolarDB resolve esse problema com pruning, técnica que filtra pacotes de dados inteiros antes do acesso pela consulta. O pruning reduz a E/S de disco, a sobrecarga de computação e a rotatividade no cache LRU. No benchmark TPC-H de 100 GB, o pruning diminui o tempo de consulta em até 50% para intervalos numéricos, enquanto índices bitmap reduzem o tempo de segundos para milissegundos em consultas de igualdade com baixa cardinalidade.
Este tópico descreve o funcionamento de cada método de pruning, quando utilizá-lo, suas limitações e a configuração necessária.
Como o IMCI organiza os dados
O IMCI organiza os dados das colunas em grupos de aproximadamente 64.000 linhas cada, armazenados na ordem de inserção, sem chave de ordenação. Como os dados não possuem ordenação inerente, o IMCI não filtra registros com a mesma precisão dos índices ordenados do InnoDB. Sem o pruning, todas as consultas carregam todos os pacotes de dados relevantes.
Após a avaliação de um pacote de dados por um pruner do IMCI, o pacote entra em um dos três estados seguintes:
|
Estado |
Significado |
Benefício |
|
Accept (AC) |
Todas as linhas correspondem |
Ignora a avaliação linha a linha; reduz a sobrecarga de computação |
|
Reject (RE) |
Nenhuma linha corresponde |
Ignora o carregamento do pacote do disco; reduz a E/S |
|
Partial accept (PA) |
Algumas linhas podem corresponder |
Varre cada linha no pacote para encontrar correspondências |
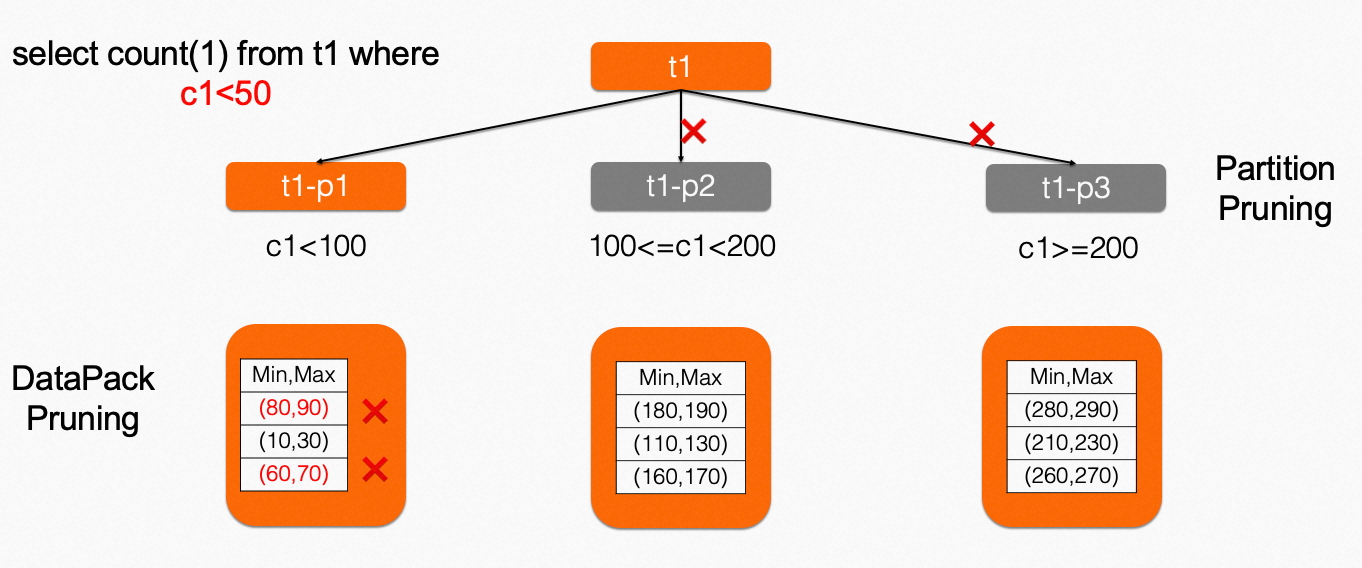
O IMCI suporta quatro métodos de pruning: partition pruning, statistics pruning (índices minmax e filtros Bloom), filtros Runtime e índices bitmap.
Escolha um método de pruning
Use a tabela a seguir para selecione um método com base nos seus dados e no tipo de consulta.
|
Método |
Mais indicado para |
Característica dos dados |
Tipo de consulta |
Configuração necessária |
|
Partition pruning |
Tabelas particionadas |
Dados divididos em intervalos não sobrepostos por tempo ou categoria |
Consultas com chave de partição na cláusula WHERE |
DDL para crie tabela particionada |
|
Índice Minmax |
Valores numéricos contínuos ou timestamps |
Dados ordenados ou agrupados (ex.: timestamps inseridos sequencialmente) |
Consultas de intervalo ( |
Automática |
|
Filtro Bloom |
Valores discretos de alta cardinalidade |
IDs ou códigos distribuídos aleatoriamente |
Consultas pontuais ( |
Automática |
|
Filtro Runtime |
Junções de múltiplas tabelas |
Tabela de dimensão pequena unida a tabela de fatos grande |
|
Nenhuma; gerado no momento da consulta |
|
Índice Bitmap |
Colunas de baixa cardinalidade onde o statistics pruning é ineficaz |
Valores distribuídos uniformemente entre os pacotes de dados |
Predicados |
Criação explícita por coluna |
O IMCI cria automaticamente índices minmax e filtros Bloom para tipos de colunas suportados. O partition pruning e os índices bitmap exigem configuração explícita. Os filtros Runtime não requerem configuração e são gerados dinamicamente durante a execução da consulta.
Partition pruning
O partition pruning filtra partições inteiras antes da leitura de qualquer dado. Quando uma cláusula WHERE inclui a chave de partição, o IMCI usa metadados da partição para identificar as correspondentes e ignora as demais.
O IMCI suporta três métodos de particionamento:
RANGE: Divide uma tabela em intervalos com pontos de limite definidos. O IMCI utiliza busca binária para localizar a partição correspondente.
LIST: Mapeia valores discretos para partições usando tuplas
<value, part_id>, também pesquisadas via busca binária.HASH: Enumera possíveis valores de entrada, aplica hash e determina em qual partição cada um se enquadra. Eficaz apenas para campos inteiros com poucos valores distintos.

Exemplo: particionamento por intervalo na data do pedido
Se a tabela orders estiver particionada por mês, a consulta a seguir acessará apenas a partição de janeiro de 2022:
SELECT * FROM orders WHERE order_date = '2022-01-01';O IMCI também aplica partition pruning por inferência de equivalência em junções. Por exemplo, se tanto R quanto S estiverem particionados na coluna a, a condição R.a = S.a AND R.a > 10 permite que o IMCI infira S.a > 10 e realize o pruning também nas partições de S.
Quando usar:
A maioria das consultas filtra pela chave de partição.
Você gerencie o ciclo de vida dos dados por partição (por exemplo, removendo partições antigas em vez de excluir linhas).
São necessárias partições de nível 1 ou nível 2 conforme os requisitos de negócio.
Quando não usar:
As consultas raramente incluem a chave de partição na cláusula WHERE. Nesse caso, o pruning não tem efeito.
A tabela é grande e não é possível execute DDL fora do horário de pico. Operações de DDL em tabelas grandes existentes são custosas.
Statistics pruning
O statistics pruning utiliza metadados leves por coluna, armazenados em memória, para decidir se um pacote de dados pode ser ignorado. Como as estatísticas residem na memória, sua avaliação não exige E/S de disco. Essa abordagem assemelha-se aos índices de data skipping no ClickHouse e ao Knowledge Grid do Infobright.
O IMCI fornece dois pruners baseados em estatísticas: índices minmax e filtros Bloom. Ambos são criados automaticamente.
Índice Minmax
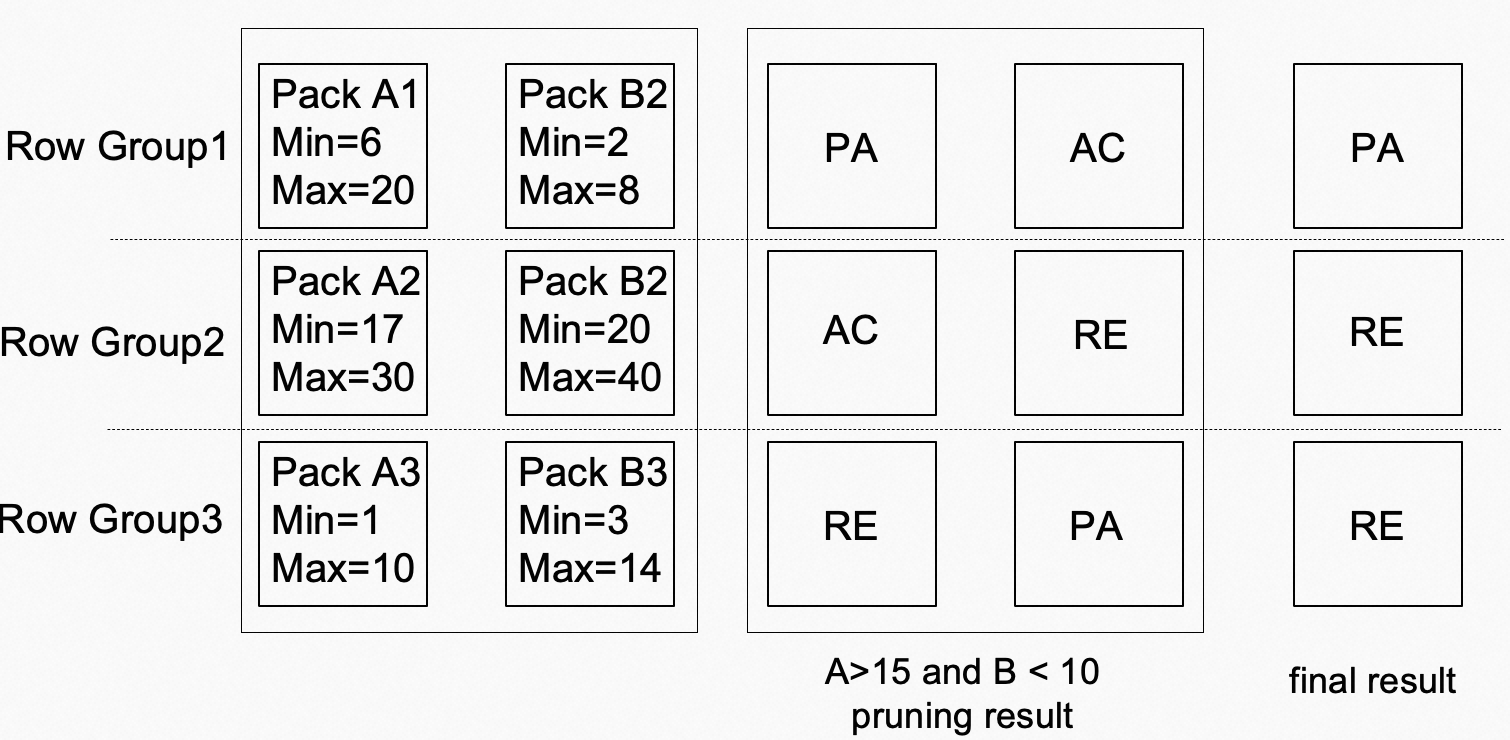
Um índice minmax armazena os valores mínimo e máximo de cada pacote de dados para uma coluna. Durante uma consulta, o IMCI compara o predicado de intervalo da consulta com esses limites. Se o intervalo da consulta não se sobrepor ao intervalo [min, max] de um pacote, o sistema o rejeita sem carregamento do disco.
Exemplo: Com a condição A > 15 AND B < 10 e três pacotes de dados por coluna, um índice minmax rejeita dois dos três pacotes, reduzindo a carga de varredura em dois terços.
Quando usar:
Colunas contêm valores contínuos, como timestamps, datas ou intervalos numéricos.
Os dados são inseridos em ordem aproximadamente classificada, de modo que os intervalos min/max por pacote sejam restritos e não sobrepostos.
Quando não usar:
Os valores da coluna estão distribuídos uniformemente por todos os pacotes. Intervalos min/max sobrepostos tornam o índice ineficaz.
Filtro Bloom
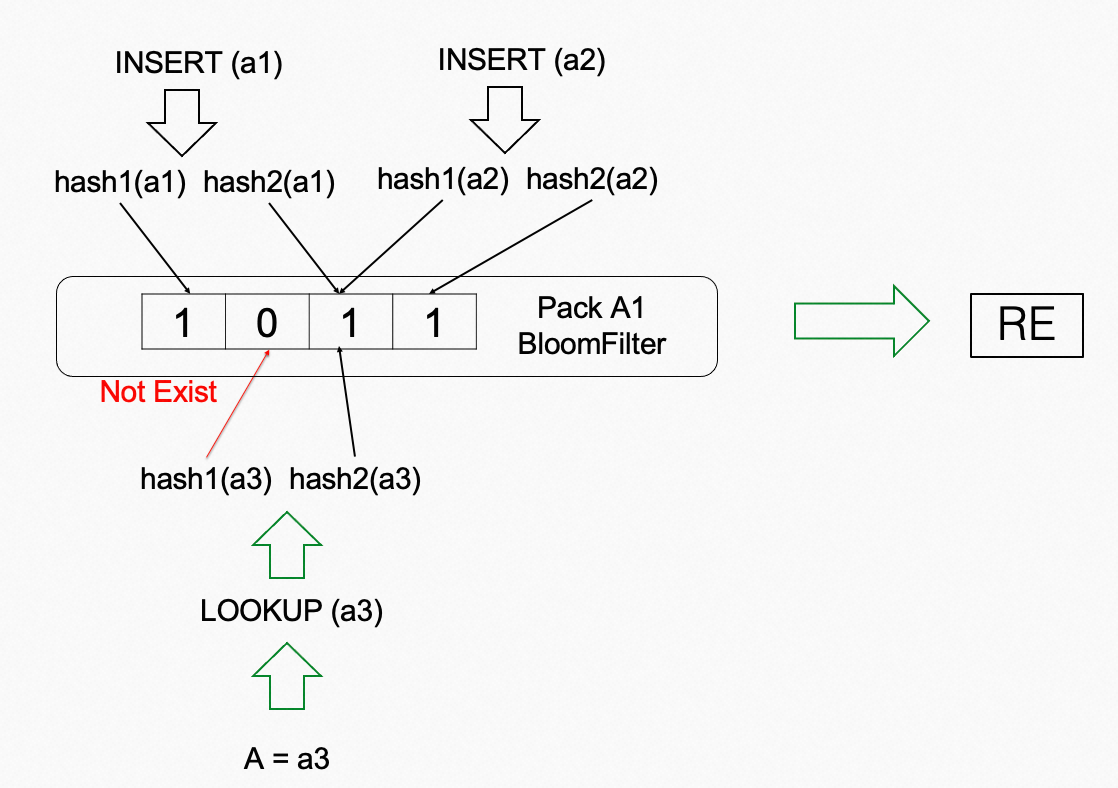
Um filtro Bloom é uma estrutura de dados probabilística que verifica a pertinência a um conjunto usando um array de bits e múltiplas funções de hash. Ao construir um filtro Bloom para um pacote de dados, o IMCI mapeia cada valor para vários bits. No momento da consulta, se qualquer bit mapeado for 0, o valor está definitivamente ausente e o pacote é rejeitado.
Filtros Bloom podem produzir falsos positivos, indicando que um valor está presente quando não está.
Quando usar:
Colunas contêm valores discretos de alta cardinalidade, como IDs gerados aleatoriamente, números de pedidos ou códigos de produtos.
Consultas usam predicados de igualdade (
=) ouIN.
Quando não usar:
Os valores da coluna estão distribuídos uniformemente entre os pacotes. Falsos positivos aumentam e a eficácia da filtragem diminui.
Combinação de índices minmax e filtros Bloom
O IMCI avalia ambos os pruners simultaneamente. Um pacote de dados é ignorado se pelo menos um pruner o rejeitar. O uso combinado melhora a cobertura de pruning em comparação com o uso isolado.
Suporte a colunas anuláveis
O IMCI permite criar índices minmax e filtros Bloom em colunas anuláveis, com suporte a predicados como IS NULL, IS NOT NULL, >, < e =.
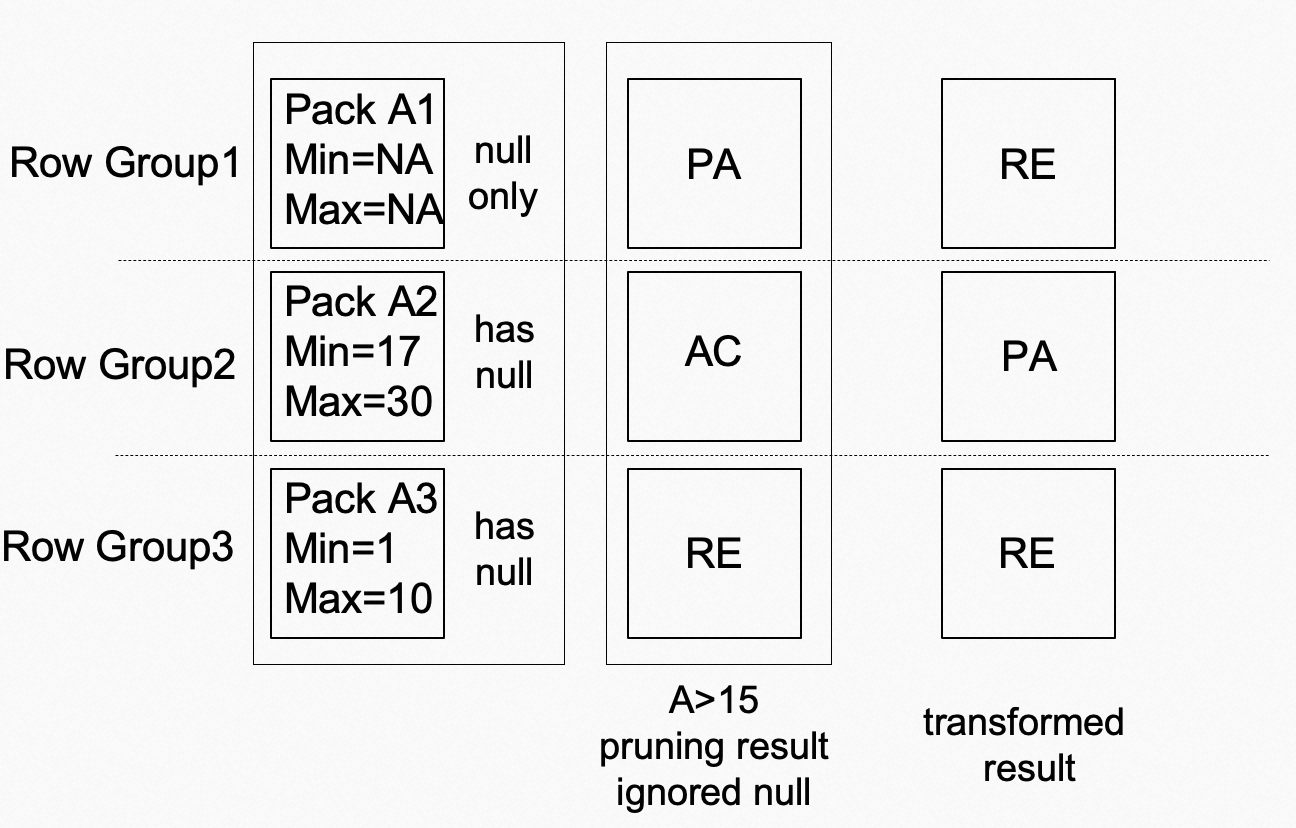
Ao construir um pruner, o IMCI exclui valores nulos dos cálculos de min/max. Um pacote contendo {1, 2, 3, NULL} terá min=1 e max=3. No momento da consulta, os resultados são calculados ignorando os nulos e depois ajustados com base na presença de nulos em cada pacote:
Um pacote contendo apenas nulos não pode sofrer pruning por predicados de valor.
Um pacote contendo parcialmente nulos ainda pode sofrer pruning com base em seu intervalo min/max de valores não nulos.
Exemplo: Com a condição A > 15 e três pacotes onde o Pacote A1 contém apenas nulos, e os Pacotes A2 e A3 contêm parcialmente nulos:
Avaliação sem nulos:
[PA, AC, RE]Ajuste para presença de nulos: O Pacote A1 (apenas nulos) não pode ser filtrado — converte-se para
RE.Resultado final:
[RE, PA, RE]. Os pacotes A1 e A3 sofrem pruning.
Melhoria da eficácia do pruning em dados distribuídos uniformemente
O statistics pruning é menos eficaz quando os valores estão distribuídos uniformemente entre os pacotes de dados, pois os intervalos min/max se sobrepõem e os filtros Bloom produzem mais falsos positivos.
Para melhorar a eficácia:
Reduza o tamanho do pacote de dados: Pacotes menores produzem índices mais granulares e intervalos min/max mais restritos. Observe que pacotes menores consomem mais memória.
Use uma chave de ordenação: O recurso de chave de ordenação do IMCI reordena os dados antes de criar estatísticas, agrupando valores semelhantes nos mesmos pacotes e melhorando a precisão do pruning.
Desative os pruners: Se o statistics pruning adicionar sobrecarga sem melhorar o desempenho da consulta (por exemplo, em colunas com distribuição uniforme), desative os pruners relevantes para essas consultas.
Filtros Runtime
Um filtro Runtime é gerado dinamicamente durante a execução da consulta. Ele captura o conjunto de resultados de um lado da junção (geralmente a tabela de dimensão menor) e o passa como filtro para o outro lado (geralmente a tabela de fatos maior) antes do início da varredura da tabela de fatos. À medida que a consulta avança e o filtro se torna mais restritivo (por exemplo, quando uma consulta TopK encontra melhores candidatos e eleva o limiar mínimo), mais pacotes sofrem pruning dinamicamente.
O IMCI suporta dois tipos de filtros Runtime:
Filtro Runtime Minmax: Gera uma expressão de intervalo (ex.:
id > 1 AND id < 100) a partir dos valores mínimo e máximo do conjunto de resultados do lado de construção (build-side).Filtro Runtime Bloom filter: Constrói um filtro Bloom sobre o conjunto de resultados do lado de construção para filtragem baseada em igualdade de colunas do tipo STRING.
Filtros Runtime do tipo Bloom filter aumentam a sobrecarga de memória e não são adequados para grandes conjuntos de resultados.
Exemplo: aceleração de uma hash join
SELECT * FROM sales JOIN items ON sales.item_id = items.id WHERE items.price > 1000Neste caso, items é a tabela de dimensão (pequena) e sales é a tabela de fatos (grande). O IMCI constrói um filtro Runtime a partir dos valores de item_id que satisfazem price > 1000. Se os IDs resultantes variarem de 1 a 100, o IMCI gera id > 1 AND id < 100 ou IN(id1, id2, id3 ...) e o passa para a varredura de sales, realizando o pruning de linhas antes das sondagens de junção.
Se existir um pruner minmax na coluna filtrada, o IMCI usa o filtro Runtime para realizar pruning adicional nos pacotes de dados, reduzindo tanto as linhas varridas quanto os pacotes carregados.
Filtros Runtime também se aplicam a consultas com GROUP BY e ORDER BY. Em cenários de processamento massivamente paralelo (MPP), eles reduzem o volume de dados transferidos entre nós.

Índices Bitmap
Um índice bitmap atribui um vetor de bits a cada valor distinto em uma coluna. Cada bit indica se aquele valor aparece em uma determinada linha. Para avaliar um predicado de filtro, o IMCI executa operações bitwise AND/OR nos vetores de bits relevantes e recupera diretamente os números das linhas correspondentes, sem carregar pacotes de dados completos.
Os índices bitmap são mais eficazes quando:
Colunas têm baixa cardinalidade (ex.: status, categoria, segmento de mercado) e os valores estão distribuídos uniformemente entre os pacotes de dados, tornando o statistics pruning ineficaz.
Consultas combinam múltiplos predicados de filtro com
ANDouOR.Consultas realizam agregações sem materializar linhas individuais, como
SELECT COUNT(*) FROM t WHERE ....
Em comparação com índices B-tree, índices bitmap usam menos espaço de armazenamento para colunas de baixa cardinalidade. No entanto, índices bitmap globais exigem bloqueio de toda a tabela em atualizações de linha, sendo mais adequados para cargas de trabalho com muitas leituras.

Benchmark de desempenho
Os resultados a seguir medem a aceleração por pruners e índices bitmap em 100 GB de dados TPC-H com concorrência 1, usando armazenamento em memória. Cargas de trabalho limitadas por E/S mostram maior melhoria.
Aceleração por Pruner (Q1–Q5)
Q1–Q3 testam a aceleração por índice minmax em partsupp.ps_suppkey (intervalo numérico). Q4–Q5 testam a aceleração por filtro Bloom em orders.o_clerk (igualdade de string e IN).
|
Consulta |
Sem pruners (s) |
Com pruners (s) |
|
Q1: |
0,11 |
0,05 |
|
Q2: |
0,14 |
0,07 |
|
Q3: |
0,13 |
0,06 |
|
Q4: |
0,89 |
0,43 |
|
Q5: |
1,85 |
1,35 |
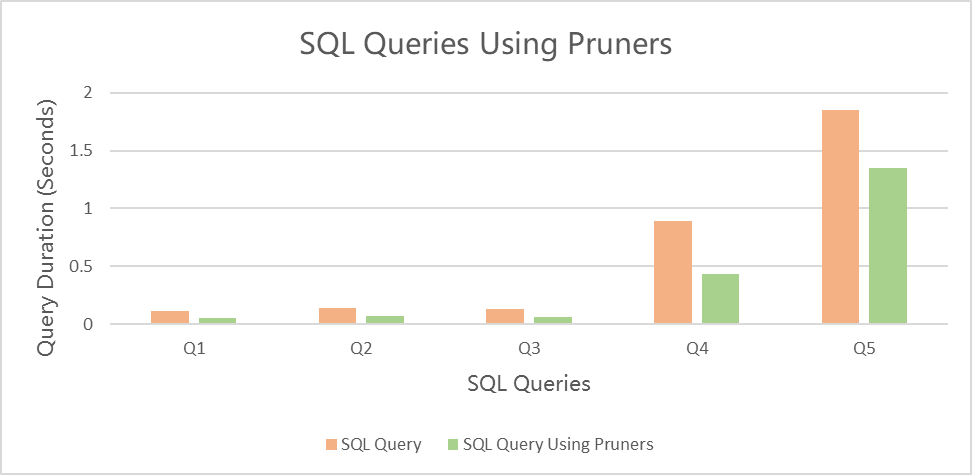
A taxa de aceleração é proporcional ao número de pacotes de dados filtrados.
Aceleração por índice Bitmap (Q6–Q9)
A coluna customer.c_mktsegment possui valores distribuídos uniformemente; portanto, apenas pruners (Q6–Q8) não oferecem benefício. Adicionar índices bitmap reduz drasticamente o tempo de consulta.
|
Consulta |
Sem pruners (s) |
Apenas com pruners (s) |
Com pruners + índices bitmap (s) |
|
Q6: |
1,43 |
1,43 |
0,03 |
|
Q7: |
3,49 |
3,49 |
0,07 |
|
Q8: |
2,48 |
2,48 |
1,09 |
|
Q9: |
1,25 |
0,05 |
0,05 |
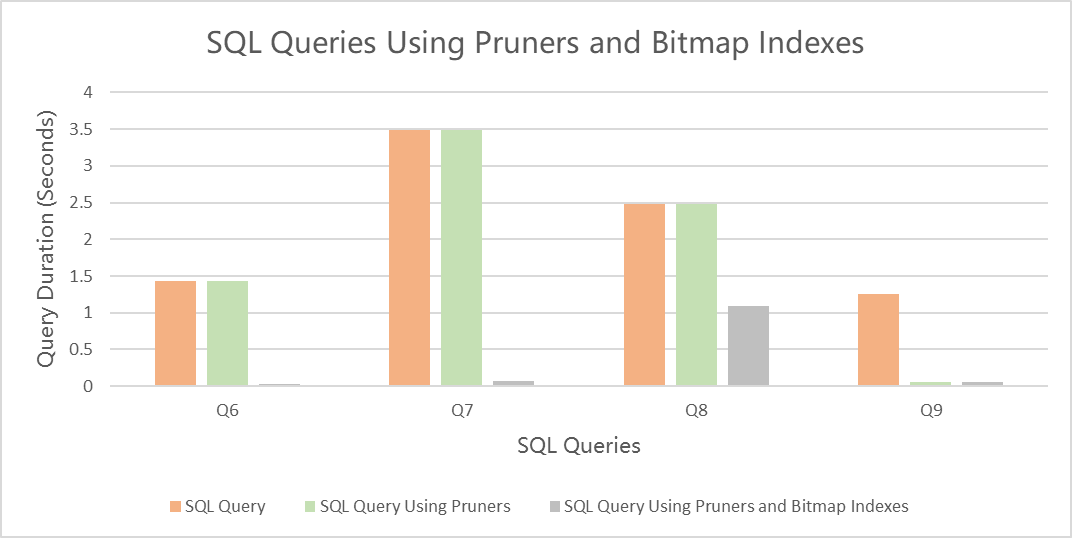
A consulta Q9 beneficia-se apenas dos pruners porque o predicado AND permite pruning minmax ou filtro Bloom em pelo menos uma coluna. Já a Q8 (OR) exige que ambas as colunas passem independentemente pelo filtro, cenário tratado com eficácia apenas por índices bitmap.
Próximos passos
Implementação do operador TopK no IMCI — Como o IMCI usa estatísticas para acelerar consultas TopK com o padrão ORDER BY ... LIMIT, incluindo como os filtros Runtime se tornam mais restritivos dinamicamente durante a execução da consulta.