O PolarDB for MySQL oferece busca full-text nativa em columnstore baseada no In-Memory Column Index (IMCI). Crie índices full-text diretamente em tabelas existentes e obtenha consultas fuzzy com latência de milissegundos por meio da função MATCH e da capacidade otimizada de aceleração de LIKE. Em comparação com soluções externas de mecanismos de busca, como o Elasticsearch, o IMCI garante consistência transacional entre dados e índices, elimina a latência de sincronização de dados e reduz a complexidade da arquitetura geral.
Conceitos principais
Para compreender a busca full-text no PolarDB IMCI, entenda os seguintes conceitos fundamentais:
|
Conceito |
Descrição |
|
Documento |
Unidade de dados brutos a ser indexada. No PolarDB IMCI, um documento refere-se especificamente a uma linha de dados no column store. |
|
Termo |
Unidade linguística básica extraída de um documento após o processamento pelo tokenizador. Representa a menor unidade para indexação e consulta. |
|
Tokenizador |
Componente que divide o texto bruto em uma sequência de termos. O PolarDB IMCI fornece vários tokenizadores (como |
|
Índice invertido |
Estrutura de dados central da busca full-text. Registra o mapeamento entre cada termo e a lista de documentos que o contêm. Composto por um dicionário de termos e posting lists, acelera as consultas de texto. |
|
Dicionário de termos |
Armazena a coleção de todos os termos e permite consultas rápidas. O PolarDB IMCI utiliza o algoritmo FST (Finite State Transducer) para construir o dicionário. A complexidade de tempo da consulta é O(len(term)), com baixo uso de espaço. |
|
Posting list |
Registra a lista de todos os IDs de documentos (números de linha de 64 bits no IMCI) que contêm um termo específico. O PolarDB IMCI usa o algoritmo RBM (Roaring Bitmap) para compactar e computar posting lists, oferecendo bom desempenho tanto em cenários de dados esparsos quanto densos. |
A tabela a seguir compara a solução integrada do PolarDB IMCI com a solução externa "banco de dados + Elasticsearch":
|
Dimensão de comparação |
Busca full-text do PolarDB IMCI |
Solução "Banco de dados + Elasticsearch" |
|
Consistência de dados |
Consistência forte. As atualizações de índice e as gravações de dados são concluídas na mesma transação e seguem os princípios ACID, eliminando riscos de latência ou inconsistência de dados. |
Consistência eventual. Os dados precisam ser sincronizados do banco de dados para o Elasticsearch, o que introduz latência. Não há garantia de atualidade dos dados nem de atomicidade transacional. |
|
Complexidade da arquitetura |
Simples. O recurso é integrado ao banco de dados. Nenhum componente novo é necessário, mantendo a arquitetura limpa. |
Complexa. Exige a implantação e manutenção de um cluster separado do Elasticsearch e de um pipeline de sincronização de dados, aumentando a heterogeneidade do sistema. |
|
Método de consulta |
Unificado. Todos os dados, estruturados e não estruturados, são consultados com SQL padrão. |
Fragmentado. É necessário usar tanto SQL quanto a DSL do Elasticsearch para consultas. Isso frequentemente resulta em consultas em duas etapas (primeiro no Elasticsearch, depois no banco de dados), adicionando latência e complexidade ao código. |
|
Custo de O&M |
Baixo. Reutiliza os sistemas de O&M e alta disponibilidade do PolarDB. Nenhuma habilidade dedicada de O&M ou recursos extras de servidor são necessários. |
Alto. Requer recursos de servidor dedicados e capacidades profissionais de O&M do Elasticsearch. Armazenar duas cópias dos dados também aumenta o custo de armazenamento. |
Como funciona
A busca full-text no PolarDB IMCI baseia-se na tecnologia de índice invertido. Ela converte dados de texto não estruturado em um índice estruturado, melhorando significativamente o desempenho de consultas por palavras-chave. O processo principal está ilustrado na figura a seguir:
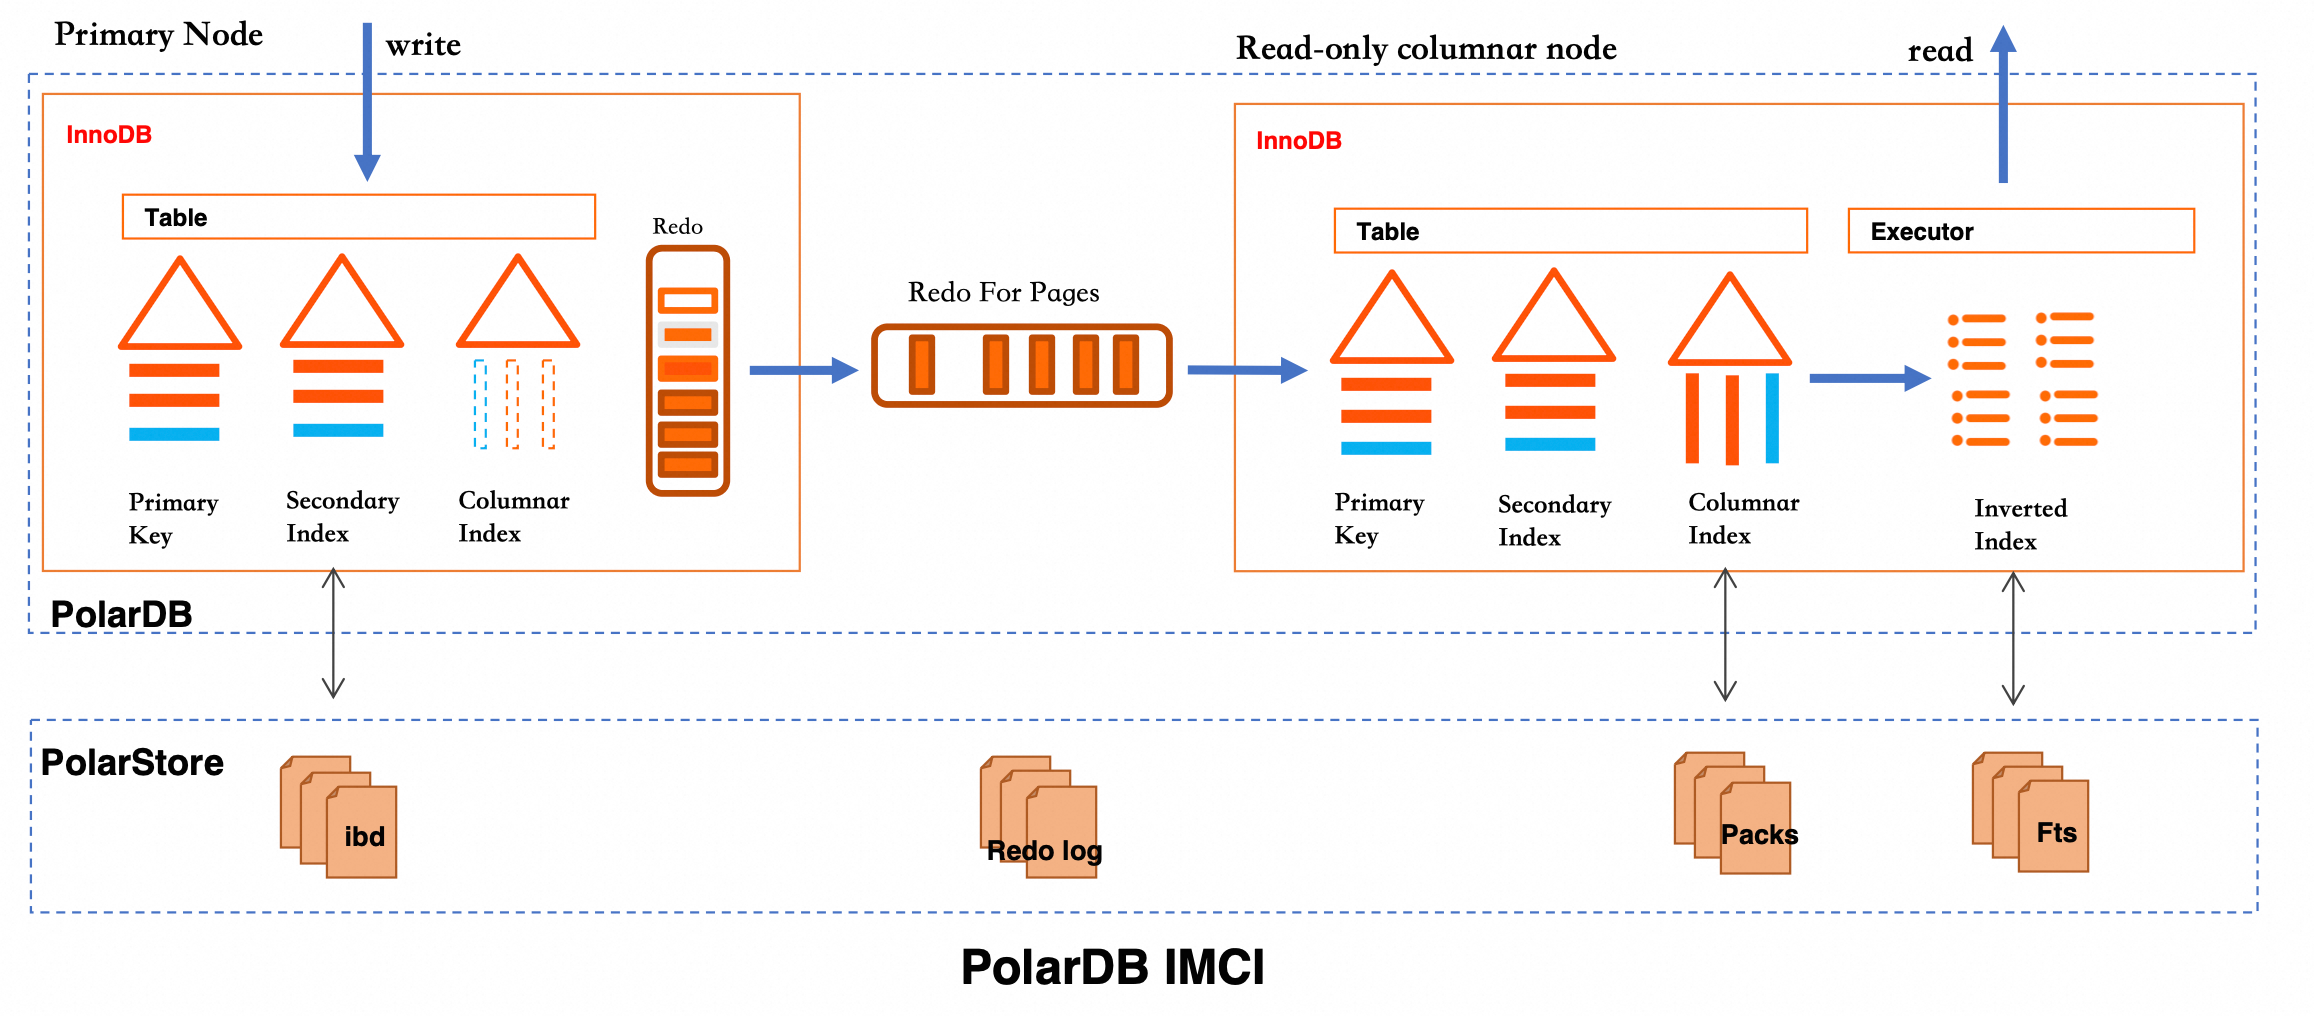
Durante a gravação de dados, o conteúdo da tabela InnoDB é sincronizado para arquivos Pack no PolarStore por meio do índice columnstore. Na fase de consulta, o executor constrói o índice invertido sobre os dados do columnstore e utiliza arquivos Fts para realizar a correspondência full-text de forma eficiente. Essa arquitetura permite que o row store e o column store trabalhem em conjunto, equilibrando o desempenho de gravação e a capacidade de consultas complexas.
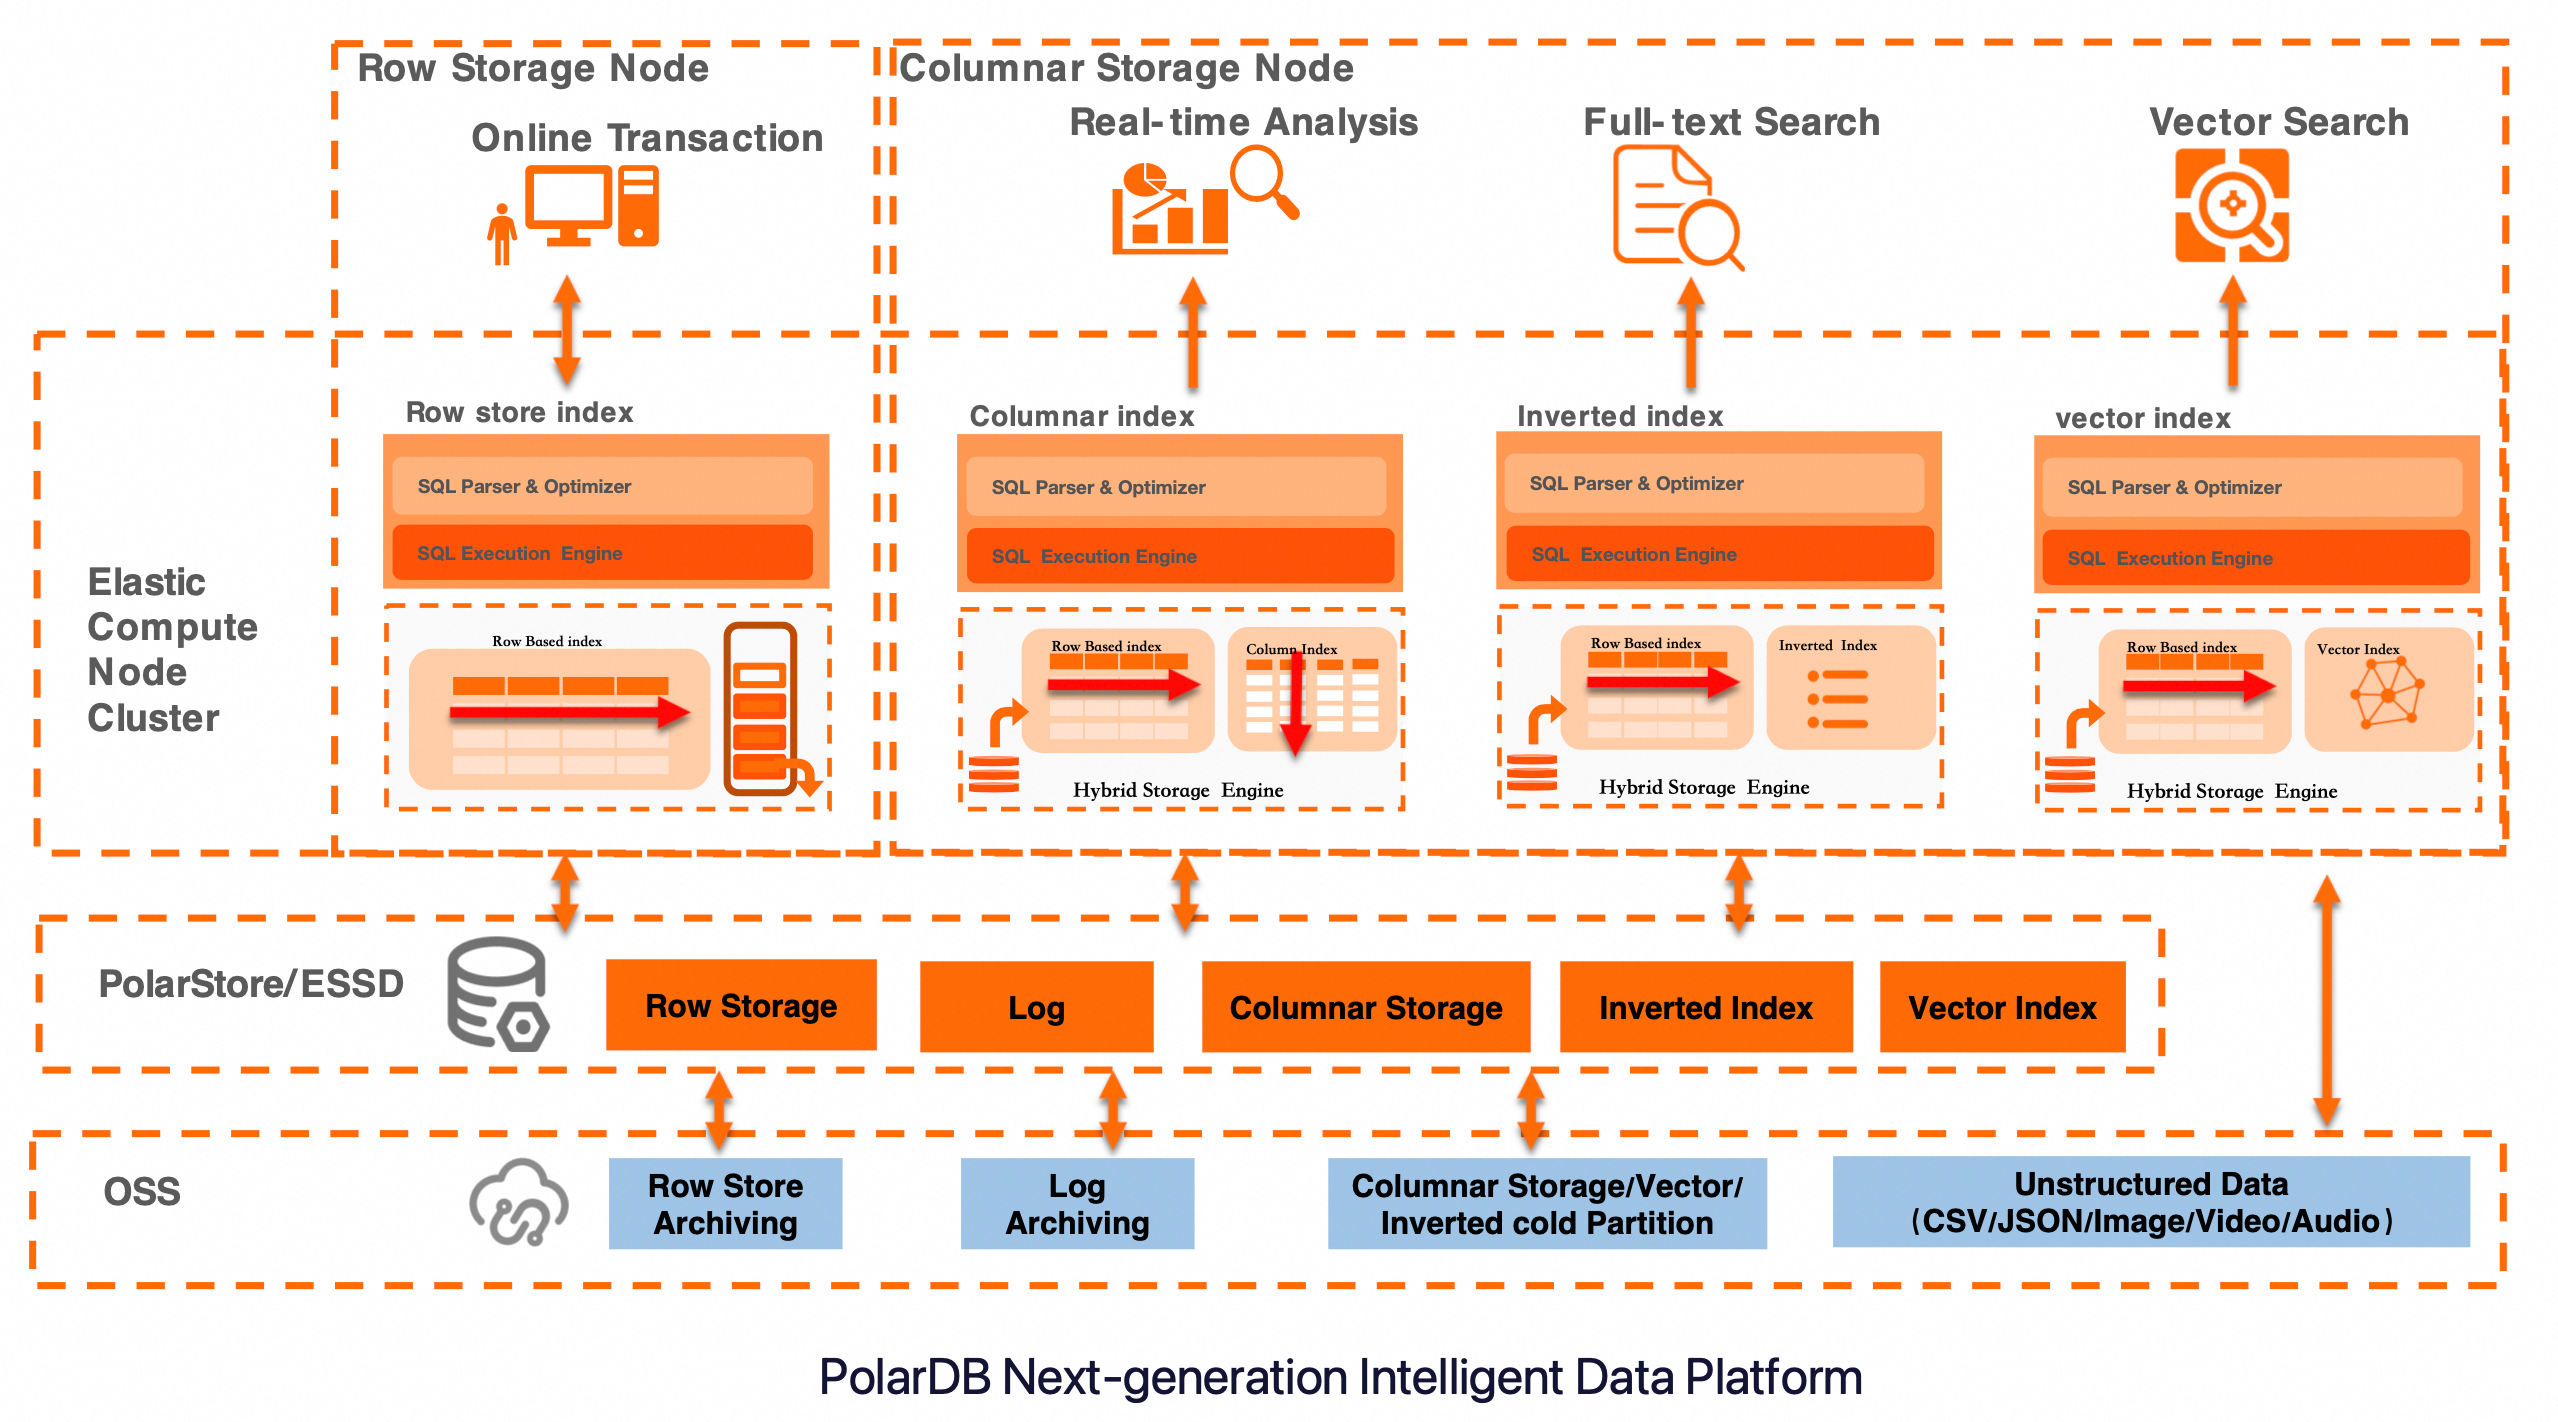
O PolarDB IMCI adota uma arquitetura unificada de armazenamento híbrido que suporta múltiplos modos de consulta. Conforme mostrado na figura, a busca full-text depende do Hybrid Storage Engine para criar e manter índices invertidos, garantindo uma busca textual eficiente. Além disso, combina nós de computação elástica com armazenamento em camadas para equilibrar gravações de alto throughput e consultas de baixa latência. Complementarmente, a capacidade integrada de índice vetorial suporta recuperação multimodal combinada de texto e vetores. Essa arquitetura aplica-se a cenários como busca de products em e-commerce, análise de logs e recuperação de bases de conhecimento. Ela oferece aos usuários uma plataforma de serviços de dados completa que integra OLTP, análises em tempo real, busca full-text e busca vetorial.
Tokenizadores
A tokenização é o processo de divisão de texto em termos e constitui a base da busca full-text. Escolher um tokenizador adequado é fundamental para a precisão e o desempenho da recuperação. O IMCI suporta os seguintes tokenizadores:
|
Tokenizador |
Descrição |
|
token |
Divide o texto com base em caracteres não alfanuméricos, como espaços e pontuação. Adequado para inglês e outros idiomas que usam espaços como separadores. |
|
ngram |
Divide o texto em termos contínuos com um comprimento predefinido de caracteres (n). |
|
jieba |
Baseado na biblioteca de tokenização chinesa |
|
ik |
Baseado no |
|
json |
Extrai valores de chave específicos ou elementos de array de um objeto JSON como termos, usando expressões JSONPath. Utilizado para recuperação aprofundada de dados JSON. |
Adicionalmente, o PolarDB IMCI fornece a função utilitária de tokenização dbms_imci.fts_tokenize para testar os resultados da tokenização. Ela suporta todos os tokenizadores e suas propriedades correspondentes. Resultados diferentes de tokenização podem fazer com que os resultados das consultas de índice full-text divirjam do esperado ou causem inconsistências entre MATCH e LIKE. Nesses casos, utilize essa função utilitária para verifique os resultados da tokenização.
Posting lists
De forma intuitiva, uma posting list (Postings List) é um conjunto de IDs de documentos. Seus pontos técnicos principais residem no armazenamento compactado altamente eficiente e na computação de alto desempenho (como interseções).
Em um índice full-text do PolarDB IMCI, uma posting list armazena o conjunto de números de linha de todas as linhas do índice columnstore que contêm um termo específico, juntamente com a frequência do termo correspondente (opcional) e a frequência do documento (opcional). Cada termo corresponde a uma única posting list.
O IMCI utiliza o algoritmo RBM (Roaring Bitmaps) para compactar e computar posting lists (ou seja, conjuntos de IDs de documentos).
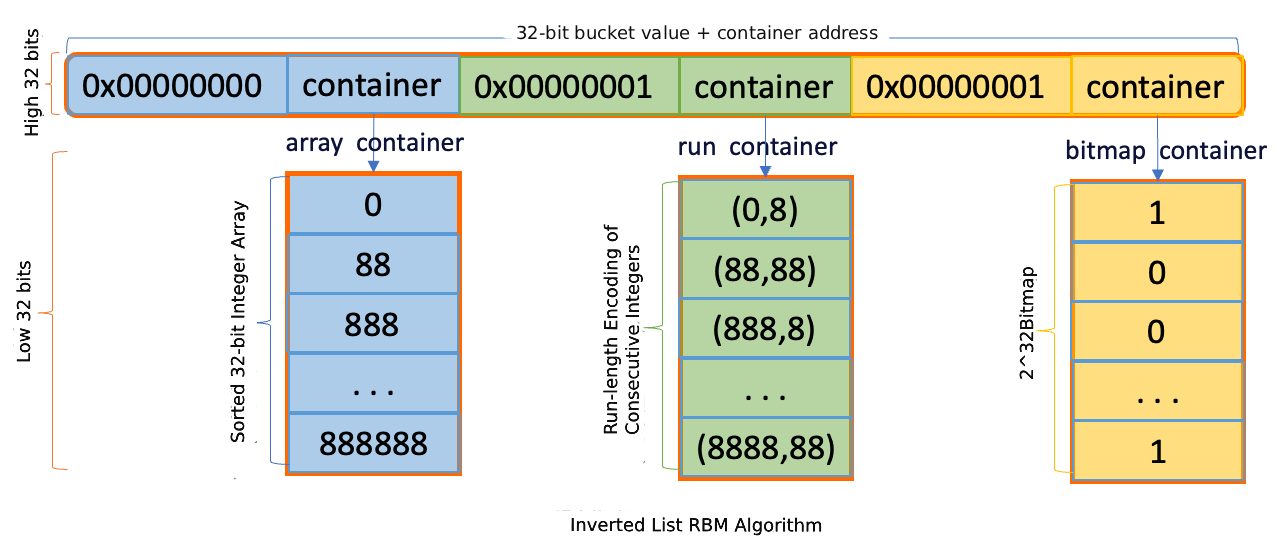
A implementação do RBM baseia-se na biblioteca CRoaring e selecione dinamicamente uma estratégia de armazenamento com base na densidade dos dados:
Se o número de IDs de documentos na posting list for menor que um limiar predefinido,
std::arrayserá usado para armazenamento.Caso o número exceda o limiar, o armazenamento muda para o tipo
roaring::Roaring64Mappara lidar com dados esparsos ou densos em grande escala, mantendo uma alta taxa de compactação.
Características de desempenho:
Suporta buscas com complexidade O(logN) durante a construção do índice.
Permite aceleração via instruções SIMD para operações de conjuntos, como interseção e união.
Oferece reorganização de espaço quando os dados são gravados em disco para reduzir fragmentação.
Possibilita o uso de valores
minimum/maximumpara filtragem rápida e otimização de iteradores durante as consultas.
Dicionário de termos
A ideia central de um índice invertido é usar um dicionário para localizar rapidamente a posting list à qual um termo está mapeado. Portanto, o design do dicionário de termos para posting lists é particularmente importante. Designs comuns incluem trie, árvore B+ e FST.
O IMCI emprega o algoritmo FST (Finite State Transducer) para construir o dicionário de termos, equilibrando eficiência de tempo e de espaço.
Eficiência de espaço: Ao compartilhar prefixos e sufixos comuns dos termos, o espaço de armazenamento é efetivamente comprimido.
Eficiência de tempo: A complexidade de tempo para buscar um termo é O(L), onde L é o comprimento do termo.
Por exemplo, suponha que os termos China, Chinese e love sejam inseridos em ordem e que seus deslocamentos de endereço de posting list sejam 5, 10 e 15. O dicionário construído é mostrado na figura a seguir. A imagem ilustra que o FST não apenas compartilha prefixos e sufixos comuns para economizar espaço, mas também garante que cada transição tenha um valor associado único. Uma consulta começa no estado inicial 0 e verifica cada caractere do termo em busca de uma aresta de saída correspondente. Se a aresta existir, a consulta acumula o valor associado. Caso contrário, verifica se o estado atual é um estado final. Por exemplo, "Chinese" acumula um valor associado de 15 e seu último caractere é um estado final, indicando que o termo existe no dicionário. Além disso, o cálculo de prefixo do FST é baseado em bytes, não em caracteres, suportando codificações como UTF-8. 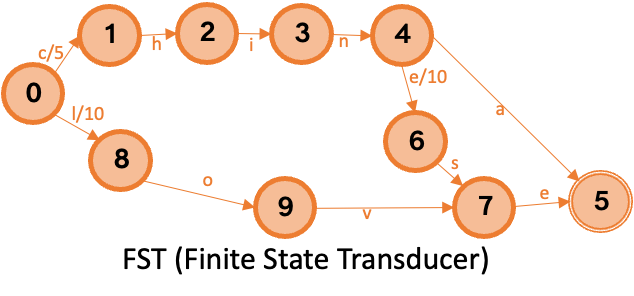
Construção de índice invertido
O PolarDB IMCI utiliza o algoritmo SPIMI para construir índices invertidos. Por meio de uma única varredura, tokenização e geração em lote do dicionário e das posting lists, ele suporta a construção eficiente de índices locais com uso controlado de memória.
Quando o índice full-text do PolarDB IMCI é construído com SPIMI, o IMCI lê continuamente os dados do columnstore da coluna alvo, tokeniza cada linha para obter um conjunto de termos e, em seguida, adiciona cada termo e seu número de linha correspondente a uma tabela hash, acumulando um valor de uso de memória. Quando o uso de memória excede o limiar de tamanho de segmento, o IMCI cria um dicionário a partir dos termos e posting lists na tabela hash, redefine a memória e continua com a próxima linha até que todos os dados do columnstore sejam processados. O processo principal para construir um dicionário (FST) a partir da tabela hash (std::unordered_map) é o seguinte: primeiro, ordena-se a tabela hash por termo (chave); depois, serializam-se todas as posting lists da tabela hash para o disco em ordem, registrando seus endereços de deslocamento relativo no disco; em seguida, adiciona-se cada termo e o endereço de deslocamento da posting list desse termo ao algoritmo FST para construir o dicionário; finalmente, compacta-se o dicionário, grava-se no disco e registram-se as informações do segmento atual (incluindo tamanho do dicionário, endereço inicial do dicionário, endereço inicial da posting list e intervalo de números de linha) nos metadados. O PolarDB não constrói um dicionário global para evitar ordenação externa (um dicionário global também precisaria ser dividido por prefixo para permitir a construção de um índice de termos sobre ele). Em vez disso, como o armazenamento columnstore usa um modelo de gravação append-only, o PolarDB adota um método de construção leve que produz múltiplos dicionários locais com base no limiar de memória, conforme mostrado na figura a seguir. Quando houver memória suficiente, aumente o limiar de memória ao máximo. Assim, mais instâncias do mesmo termo cairão no mesmo segmento invertido, economizando espaço e melhorando o desempenho da consulta. 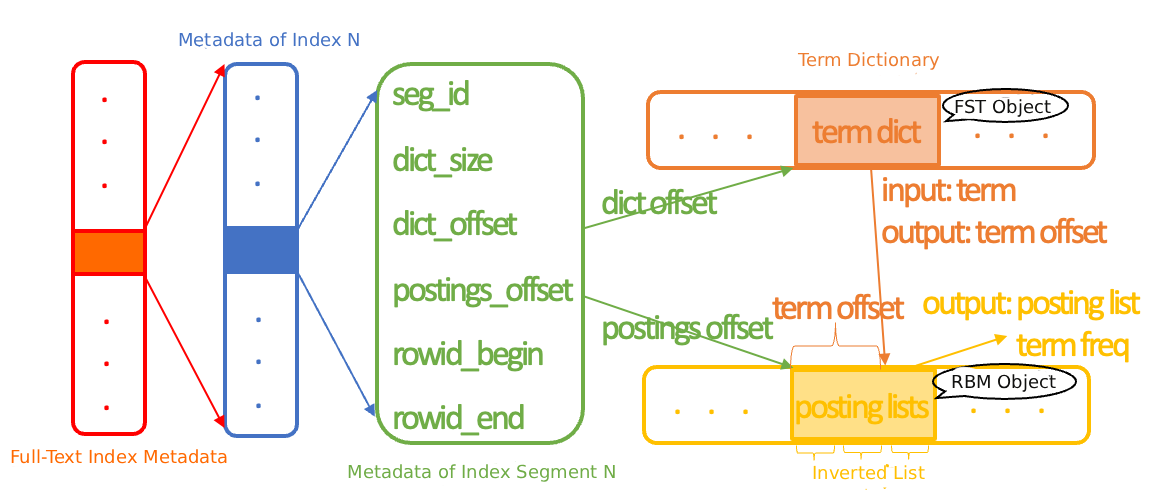
Além da construção normal de índice invertido descrita acima, o índice full-text do PolarDB IMCI também suporta a mesclagem assíncrona de índices invertidos quando o sistema está ocioso em segundo plano. O índice columnstore do PolarDB IMCI é um índice secundário de uma tabela regular. Em operações INSERT, os dados são sempre anexados ao mecanismo de armazenamento columnstore por coluna, na ordem de inserção. DELETE usa marcação para exclusão (mark-for-deletion), e UPDATE é convertido em DELETE seguido de INSERT. O IMCI utiliza o array InsertMask para marcar a versão de inserção de cada linha nos dados do columnstore para verificações de visibilidade, e usa lsm DeleteMask para marcar uma linha existente como excluída. Simultaneamente, operações em segundo plano, como Compactação assíncrona e Reciclagem, reorganizam dados e recuperam espaço. Como parte do mecanismo columnstore, o índice full-text do PolarDB IMCI também usa uma tarefa de Compactação assíncrona de índice invertido em segundo plano para limpar periodicamente os dados marcados como excluídos, economizando espaço e melhorando o desempenho das consultas. A mesclagem de índices invertidos usa o segmento invertido como unidade: múltiplos segmentos invertidos são mesclados em um novo segmento invertido, e os segmentos originais não são modificados. Isso evita que os objetos de snapshot de índice invertido usados pelas consultas se tornem inválidos. Quando a mesclagem termina, um novo snapshot de índice invertido é gerado, e novas consultas passam a usar esse novo snapshot. Graças ao método de construção local e ao design de marcação para exclusão, uma inserção em massa não aciona uma reconstrução global no índice full-text do PolarDB IMCI; apenas a parte incremental é construída. O custo de atualização também é muito baixo, pois requer apenas uma marca de exclusão, de modo que o desempenho de gravação não é afetado mesmo em cenários de atualizações frequentes. Adicionalmente, a mesclagem assíncrona periódica em segundo plano produz índices invertidos mais compactos para melhorar o desempenho das consultas. Combinado com a capacidade de consulta concorrente do column store, isso atende aos requisitos de resposta em nível de milissegundos mesmo em cenários de dados massivos.
Recuperação de índice invertido
O índice full-text do PolarDB IMCI suporta a função oficial MATCH do MySQL e o operador LIKE.
-
Função
MATCHO PolarDB IMCI permite o uso da função
MATCHpara busca full-text independentemente da existência de um índice full-text no row store. Se não houver índice no row store, a consulta é roteada diretamente para o nó do column store. Se existir um índice no row store, a consulta é distribuída inteligentemente com base na avaliação de custo. Para impedir que operações demoradas desencadeadas por um índice full-text nativo do MySQL durante a fase de otimização — como sincronização de tabelas auxiliares e carregamento de cache — afetem o desempenho do column store, o PolarDB ignora essas operações no início da distribuição da consulta.Durante a fase de execução, o IMCI oferece dois métodos de recuperação: o operador
FtsTableScane a expressãoMATCH. O primeiro obtém linhas correspondentes diretamente do índice invertido, sendo adequado para cenários com alta taxa de filtragem. O segundo busca o índice por número de linha, sendo ideal para cenários em que condições anteriores já filtraram a maior parte dos dados. A eficiência de execução de ambos os métodos depende da eficácia da filtragem de dados por outros predicados. O otimizador do column store estima a taxa de filtragem com base em estatísticas e selecione dinamicamente a estratégia ideal. Quando o método de operador é escolhido, o sistema reescreve automaticamente a funçãoMATCHpara os operadoresFtsTableScan + Filter.Como o índice full-text é construído de forma assíncrona, pode haver um breve atraso na visibilidade de novos dados. Por padrão, o executor do column store complementa os resultados da consulta com uma varredura completa da tabela sobre dados não indexados para garantir a integridade dos resultados. Um parâmetro controla se essa etapa deve ser ignorada, permitindo equilibrar flexivelmente desempenho e consistência em cenários de alta concorrência e grandes volumes de dados. Também é possível ajustar os parâmetros de construção do índice para aumentar a frequência de sincronização de dados e reduzir o escopo da varredura completa da tabela, melhorando ainda mais a eficiência da consulta.
-
Aceleração de
LIKESob condições específicas, o PolarDB IMCI suporta a conversão mútua entre
LIKEeMATCH. A conversão deLIKEparaMATCHé usada principalmente para acelerar consultas, reduzindo a sobrecarga de comparação linha a linha de grandes quantidades de strings em varreduras completas de tabela.Atualmente, essa conversão só entra em vigor quando o índice full-text do columnstore usa o tokenizador
ngrame o comprimento do tokenngramé menor ou igual ao comprimento da string de padrão doLIKE. Sob essa condição, o otimizador pode reescrever um predicado comoLIKE '%abc%'para os operadoresFtsTableScan + Filter, usando o índice invertido para filtrar rapidamente as linhas candidatas.No entanto, como o mecanismo de correspondência da tokenização
ngramdifere da semântica doLIKE(por exemplo,"abbc"é tokenizado emab,bbebc, que se sobrepõem aos tokensabebcde"abc"e podem ser falsamente julgados como correspondência), a expressãoLIKEoriginal é mantida como condição de filtro subsequente para verificação exata, garantindo a correção dos resultados.Esse mecanismo melhora significativamente o desempenho da consulta, equilibrando eficazmente a precisão semântica e a eficiência de execução.
O índice invertido do PolarDB IMCI consiste em múltiplos segmentos invertidos. Cada segmento invertido contém seus próprios metadados, um dicionário de termos e uma série de posting lists, onde cada termo corresponde unicamente a uma posting list. Os metadados registram informações como os endereços iniciais do dicionário e das posting lists. Esses metadados são pequenos e residem na memória por padrão para acelerar o acesso ao índice.
A recuperação do índice invertido é realizada por segmento invertido. O processo principal inclui ler os dados do dicionário, construir o objeto de dicionário FST (Finite State Transducer), buscar o termo alvo no dicionário e ler a posting list correspondente para construir o objeto de posting list RBM (Roaring Bitmap).
Especificamente, as consultas dividem-se em dois modos:
Consulta por operador: Percorre os metadados de todos os segmentos invertidos, obtém o endereço inicial do dicionário, carrega os dados do dicionário, constrói o objeto de dicionário e busca o termo alvo. Se o termo for encontrado, combina o endereço de deslocamento da posting list do termo com o endereço inicial no segmento para ler o objeto completo da posting list.
Consulta por expressão: Determina o conjunto de segmentos invertidos com base no número de linha, filtra adicionalmente pelo intervalo de números de linha nos metadados e, em seguida, execute uma busca no dicionário e leitura da posting list semelhante à consulta por operador nos segmentos invertidos correspondentes.
Para melhorar o desempenho, o IMCI suporta cache de dicionário de termos. Ele utiliza um mecanismo de cache LRU (Least Recently Used) independente, e o módulo de agendamento ajusta dinamicamente a cota de memória desse cache. Uma única posting list geralmente é pequena (a maioria requer apenas uma E/S de 4 KB), e as posting lists são numerosas, de modo que a taxa de acerto do cache e o benefício de armazená-las em cache são limitados. Por isso, o cache de posting lists é desativado por padrão para evitar desperdício de recursos de memória.
Esse design equilibra o uso de memória e a sobrecarga de E/S, garantindo a eficiência das consultas.
Casos de uso
O recurso de busca full-text do PolarDB IMCI aplica-se a diversos cenários de negócios que exigem busca rápida em conteúdo textual.
-
Busca de products em e-commerce e consultas no site
Em plataformas de e-commerce, os usuários frequentemente buscam products por palavra-chave. A correspondência fuzzy tradicional baseada em
LIKEtem baixo desempenho e não atende aos requisitos de resposta sob alta concorrência. Uma solução externa com Elasticsearch acelera a busca, mas sua latência de sincronização frequentemente faz com que os resultados incluam products deslistados, com preços alterados ou fora de estoque, degradando a experiência do usuário.O PolarDB IMCI fornece busca full-text nativa e constrói índices invertidos eficientes em campos de texto como títulos, descrições e atributos de products. As consultas realizam a correspondência de palavras-chave dentro do banco de dados, evitando latência entre sistemas e mantendo os resultados da busca fortemente consistentes com o estado em tempo real de cada product, como preço e inventário. O que o usuário encontra é exatamente o que ele pode comprar.
-
Análise de logs e observabilidade
Durante operações de O&M e troubleshooting, desenvolvedores e engenheiros precisam localizar rapidamente pilhas de erros, rastrear cadeias de requisições ou analisar comportamentos anômalos em volumes massivos de logs. A arquitetura ELK tradicional é poderosa, mas possui muitos componentes, implantação complexa e manutenção custosa. Além disso, introduz um atraso perceptível entre o momento em que os dados são gravados e o momento em que se tornam consultáveis.
Com o PolarDB IMCI, crie um índice full-text diretamente no campo
messageoucontentde uma tabela de logs e use SQL padrão para recuperação de logs com latência de milissegundos. Execute consultas interativas e rastreie contextos sem precisar construir uma plataforma separada de análise de logs. Isso simplifica significativamente a pilha tecnológica, reduz a sobrecarga de armazenamento e O&M, e torna a localização de problemas mais eficiente. -
Recuperação de documentos e bases de conhecimento
Para bases de conhecimento internas, manuais de products, FAQs ou centrais de ajuda, o requisito principal é permitir que os usuários encontrem rapidamente as informações necessárias. Depender de um mecanismo de busca externo exige a manutenção de lógica de escrita dupla, e o conteúdo pode facilmente ficar dessincronizado após uma atualização.
Construa um índice full-text no corpo do documento com o PolarDB IMCI e use um tokenizador chinês como
jiebaouikpara melhorar a precisão da tokenização. Assim, armazene e recupere conteúdo no mesmo banco de dados. O conteúdo torna-se pesquisável imediatamente após a atualização, o modelo de permissões reutiliza seu sistema existente e nenhum mecanismo extra de sincronização é necessário. O conteúdo publicado fica visível instantaneamente, e qualquer edição entra em vigor de imediato. -
Perfilamento de usuários e análise de comportamento
Operações precisas de usuários dependem da mineração aprofundada de texto não estruturado, como extrair interesses e preferências de comentários, tags e postagens. A abordagem tradicional exporta dados para um data warehouse ou sistema analítico, um processo complexo e com pouca atualidade.
O PolarDB IMCI permite a construção de índices com o tokenizador
jsonem campos JSON ou o tokenizadorjiebaem campos de texto longo. Uma única instrução SQL pode então combinar atributos estruturados, como idade e região, com semântica textual, como "gosta de esportes ao ar livre" ou "foca em custo-benefício", para análise conjunta. A segmentação de usuários e os insights de comportamento são concluídos em tempo real, sem migração de dados, suportando operações refinadas e recomendações personalizadas.
Benchmark de desempenho
O ESRally é a ferramenta oficial de benchmark do Elasticsearch da Elastic. Este tópico utiliza seu conjunto de dados integrado http_logs para avaliar o desempenho de recuperação do índice full-text columnstore do PolarDB IMCI.
Preparar o conjunto de dados
-
Obtenha o conjunto de dados:
Para detalhes sobre o conjunto de dados, consulte Elasticsearch Rally Hub. Obtenha o conjunto de dados da seguinte forma. O pacote compactado rally-track-data-http_logs.tar tem cerca de 1,7 GB. Após a descompactação, o conjunto de dados ocupa cerca de 32 GB e contém 247 milhões de linhas no total.
git clone https://github.com/elastic/rally-tracks.git cd rally-tracks ./download.sh http_logs -
Crie uma tabela:
Como um pequeno número de linhas no conjunto de dados contém dados JSON incompatíveis com o tipo JSON do MySQL, varchar(512) é usado para armazenar os dados JSON. Após a importação dos dados, uma coluna virtual é usada para extrair o campo request do JSON.
CREATE TABLE http_logs( logs varchar(4096) ); -
Importe os dados:
Use LOAD DATA para importar o conjunto de dados para o banco de dados.
LOAD DATA INFILE '/home/xxx/http_logs/documents-181998.json' INTO TABLE http_logs COLUMNS TERMINATED BY '\n'; ... ... -
Adicione uma coluna:
Use uma coluna virtual para extrair o campo request do JSON para testes de índice full-text.
ALTER TABLE http_logs ADD COLUMN request varchar(1024) AS (CASE WHEN json_valid(logs) THEN (json_unquote(json_extract(logs, '$.request'))) ELSE NULL END); -
Crie um índice columnstore:
O índice invertido columnstore faz parte do índice columnstore, portanto, crie primeiro o índice columnstore.
ALTER TABLE http_logs comment 'columnar=1'; -
Crie um índice invertido:
O índice invertido columnstore é criado modificando o comentário da coluna via DDL. A instrução DDL é concluída em segundos, e o índice invertido é construído assincronamente em segundo plano.
ALTER TABLE http_logs modify COLUMN request varchar(1024) AS (CASE WHEN json_valid(logs) THEN (json_unquote(json_extract(logs, '$.request'))) ELSE NULL END) comment 'imci_fts(type=2 mode=1)'; -
Visualize o índice invertido:
Após a criação do índice, execute as seguintes instruções para visualizar NUM_PACKS e NEXT_PACK_ID, respectivamente. NUM_PACKS indica o número de blocos de dados do columnstore, e NEXT_PACK_ID indica o número do bloco de dados até onde o índice invertido foi construído. Quando os dois valores estiverem próximos, o índice invertido estará construído.
SHOW imci indexes;
SHOW imci indexes fulltext;
Benchmark de desempenho
Após a construção do índice invertido, use a função MATCH para testar o desempenho de recuperação de termos de alta a baixa frequência. A figura a seguir mostra a comparação de desempenho de consulta entre LIKE, MATCH e MATCH_ANY do Doris no mesmo conjunto de dados.
Os resultados de testes single-threaded com dados quentes são os seguintes:
|
Consulta |
Termo de alta frequência |
Termo de frequência relativamente alta |
Termo de frequência relativamente baixa |
Termo de baixa frequência |
|
LIKE |
1 min 21,96 s |
1 min 18,44 s |
1 min 24,59 s |
1 min 31,19 s |
|
SIMD LIKE |
25,46 s |
22,80 s |
21,98 s |
21,60 s |
|
MATCH (biblioteca FTS proprietária) |
2,43 s |
0,25 s |
0,01 s |
0,00 s |
|
Doris MATCH_ANY (biblioteca CLucene) |
3,49 s |
0,24 s |
0,03 s |
0,03 s |
Conforme mostrado na tabela anterior, MATCH oferece uma melhoria significativa de desempenho em relação a LIKE e praticamente não é afetado pelo fato de os dados estarem quentes ou frios.
FAQ
P1: Quais são as vantagens da busca full-text do PolarDB IMCI em relação ao índice full-text integrado de um banco de dados tradicional como o MySQL InnoDB?
O PolarDB IMCI apresenta vantagens em desempenho, recursos e escalabilidade:
Desempenho: Baseado em armazenamento colunar e mecanismo de execução vetorizada, combinado com algoritmos como FST e RBM, o desempenho de consulta supera o dos índices tradicionais de row store, permitindo respostas rápidas em cenários de alta concorrência e volumes massivos de dados.
Recursos: Tokenizadores chineses integrados, como
jiebaeik, além do tokenizadorjson, atendem aos requisitos de cenários de negócios complexos.Impacto no desempenho de gravação: Os mecanismos otimizados de construção e atualização de índices têm um impacto muito menor no desempenho em cenários de gravação de alta frequência (INSERT/UPDATE) do que os índices full-text de bancos de dados tradicionais.
Escalabilidade horizontal: Beneficia-se da arquitetura de armazenamento e computação desacoplados do PolarDB, oferecendo boa escalabilidade horizontal.
P2: Como escolher um tokenizador adequado para meus dados de negócios?
Escolha um tokenizador com base no seu tipo de dados e requisitos de consulta:
Para texto em chinês: Use o tokenizador
jiebaouik. Ambos realizam tokenização semântica, melhorando a precisão da recuperação em chinês.Para texto em inglês ou delimitado por símbolos: Utilize o tokenizador
token. Ele divide o texto com base em espaços e pontuação.Para correspondência fuzzy ou busca de substring arbitrária: Opte pelo tokenizador
ngram. Ele divide o texto em frases de comprimento fixo (como bigramas e trigramas), sendo um ótimo substituto para consultas ineficientes do tipoLIKE '%keyword%'.Para conteúdo específico em campos JSON: Adote o tokenizador
json. Atualmente, ele suporta a construção de índices invertidos nos valores de um array JSON ou nas chaves de um objeto JSON.
Se não tiver certeza de qual tokenizador é o mais adequado, use a função dbms_imci.fts_tokenize para visualizar como diferentes tokenizadores processam um texto de amostra e, em seguida, escolha a estratégia de tokenização que melhor atenda às expectativas do seu negócio.