O recurso de failover com réplica quente no PolarDB aumenta a velocidade do failover e preserva o status das transações. Este tópico descreve o funcionamento desse recurso.
Informações básicas
A evolução da alta disponibilidade do ApsaraDB divide-se nas seguintes fases: alta disponibilidade (HA) primária/secundária, HA de memória compartilhada e HA nativa da nuvem do PolarDB. A HA primária/secundária apresenta problemas de latência de replicação em casos como DDL e transações grandes, pois utiliza replicação de log binário. A HA do PolarDB resolve essa questão de latência por meio de replicação física e melhora a escalabilidade com o armazenamento compartilhado do PolarStore. No entanto, interrupções de conexão e rollbacks de transações ainda ocorrem em cenários como atualizações de versão, gerando diversos erros de requisição no cliente da aplicação. O recurso de failover com réplica quente foi introduzido para lidar com desafios como atualização de versões menores, dimensionamento e recuperação de desastres. Esse recurso também é fundamental para a evolução do PolarDB para serverless.
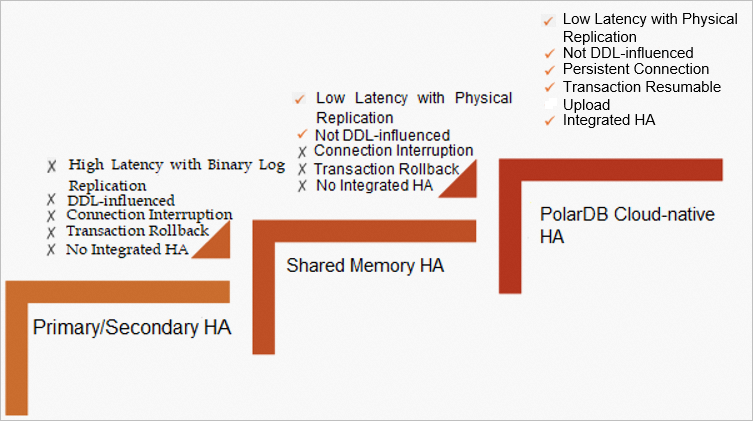 O recurso de failover com réplica quente do PolarDB otimiza três aspectos: detecção de falhas, velocidade de failover e experiência do usuário. Ele diferencia trocas programadas, como alterações de configuração do cluster e atualizações de versões menores, de situações de failover. Para enfrentar os desafios dos clientes, esse recurso combina várias técnicas:
Voting Disk Service (VDS): módulo de alta disponibilidade baseado na arquitetura de disco compartilhado que permite o gerenciamento autônomo dos nós do cluster. O VDS reduz significativamente o tempo necessário para detecção de falhas e seleção do nó primário.
Pré-busca global: com esse mecanismo, os nós de réplica quente podem pré-carregar vários módulos internos do mecanismo de armazenamento, diminuindo o tempo de failover.
Conexões persistentes e preservação de status de transação no PolarProxy: ao ativar esses recursos, o PolarDB executa operações e manutenção (O&M) ativas sem interromper seus services durante alterações de configuração do cluster ou atualizações de versões menores.
Escopo de aplicação
O recurso de failover com réplica quente é compatível com as seguintes versões do PolarDB for MySQL:
-
**Versão do mecanismo**:
MySQL 5.6. A versão de revisão deve ser 5.6.1.0.35 ou posterior.
MySQL 5.7. A versão de revisão deve ser 5.7.1.0.24 ou posterior.
MySQL 8.0.1. A versão de revisão deve ser 8.0.1.1.29 ou posterior.
MySQL 8.0.2. A versão de revisão deve ser 8.0.2.2.12 ou posterior.
PolarProxy version: versão 2.8.3 ou posterior.
Caso seu cluster seja da Standard Edition e você precise desse recurso, envie um ticket para entrar em contato conosco e obter assistência.
Observações de uso
Sem a réplica quente ativada em um nó somente leitura, pode ocorrer uma interrupção transitória de cerca de 20 a 30 segundos durante um failover primário/secundário. Certifique-se de que sua aplicação suporte reconexão automática. Com a réplica quente ativada, o failover é concluído entre 1 e 5 segundos.
O nó de réplica quente deve ter as mesmas especificações do nó primário.
-
Em determinadas versões de kernel, o módulo Voting Disk do recurso de alta disponibilidade usado no failover com réplica quente apresenta exclusividade mútua com o recurso IMCI (In-Memory Column Index). Confira os detalhes abaixo:
Clusters com **versão de kernel 8.0.1.1.43 ou posterior ou 8.0.2.2.24 ou posterior**: o recurso IMCI é totalmente compatível com o failover com réplica quente.
-
Clusters com **versão de kernel 8.0.1.1.42 ou 8.0.2.2.23**:
Se o cluster já possui um nó somente leitura com o failover com réplica quente ativado, adicione um nó IMCI somente leitura ao cluster.
Se o cluster já possui um nó IMCI somente leitura, não é possível ativar o failover com réplica quente em nenhum nó somente leitura do cluster.
-
Clusters com **versão de kernel anterior a 8.0.1.1.42 ou 8.0.2.2.23**: os recursos IMCI e failover com réplica quente são mutuamente exclusivos:
-
Se o cluster já possui um nó somente leitura com o failover com réplica quente ativado, não é possível adicionar um nó IMCI somente leitura ao cluster.
NotaPara adicionar um nó IMCI somente leitura ao cluster, use contact us para desativar o módulo de alta disponibilidade Voting Disk do recurso de failover com réplica quente. Após desativar o módulo, adicione o nó IMCI somente leitura. Note que todos os nós serão reiniciados automaticamente durante esse processo.
Se o cluster já possui um nó IMCI somente leitura, não é possível ativar o failover com réplica quente em nenhum nó somente leitura do cluster.
-
NotaQuando IMCI e réplica quente forem mutuamente exclusivos e você desejar ativar o failover com réplica quente no cluster, exclua primeiro o nó IMCI somente leitura existente.
Como funciona
As seguintes tecnologias principais implementam o recurso de failover com réplica quente no PolarDB:
-
New high availability module: VDS
Ao ativar o failover com réplica quente, o PolarDB inicia o VDS. Com a arquitetura de disco compartilhado do PolarDB, o VDS fornece gerenciamento autônomo, detecção de falhas e seleção de nó primário para os nós do cluster.
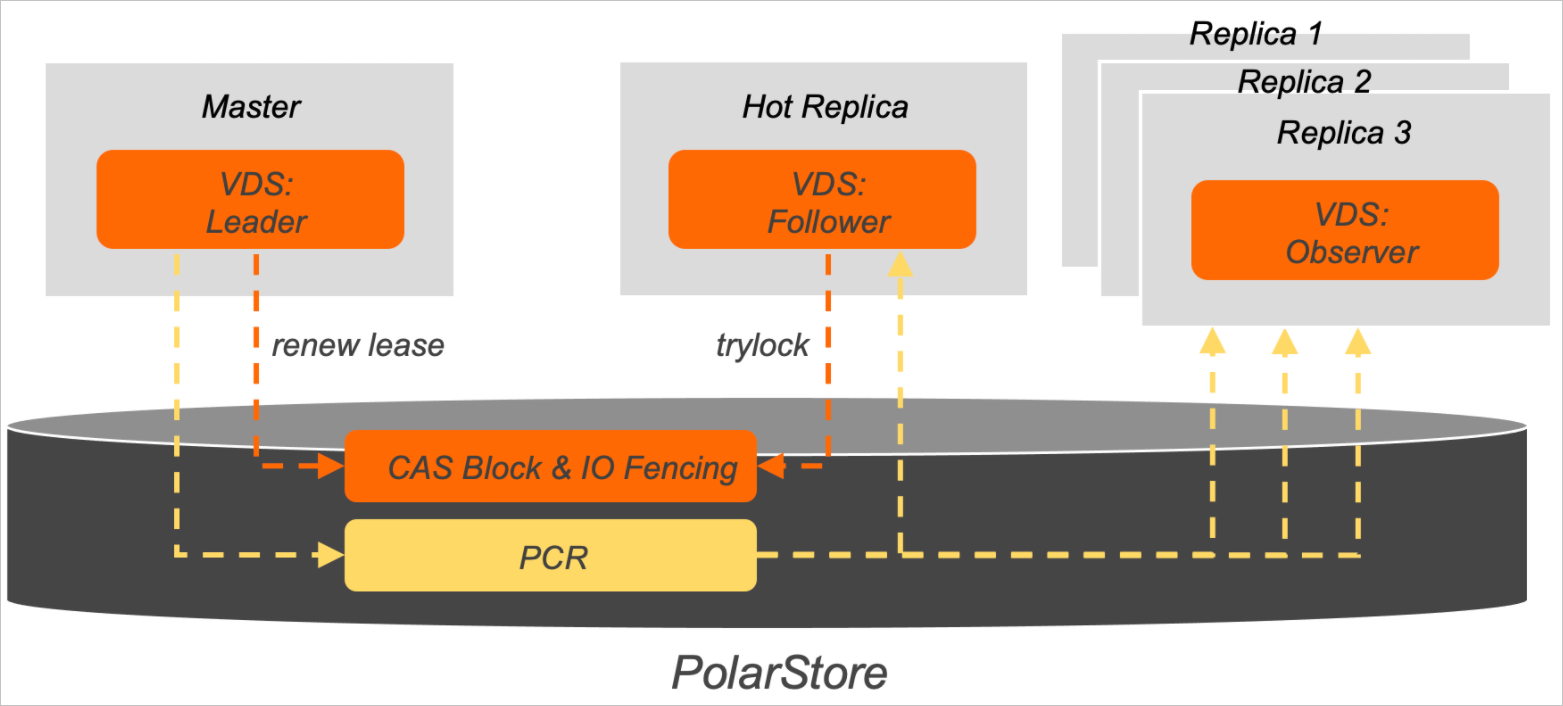 Detalhes sobre a arquitetura do VDS:
Cada nó de computação no VDS possui um thread independente. Os threads do VDS classificam-se em três categorias: Leader, Follower e Observer. Em um cluster PolarDB, os threads Leader executam no nó primário, os threads Follower executam no nó de réplica quente e os threads Observer executam nos nós somente leitura. Um cluster PolarDB pode conter um thread Leader, um thread Follower e vários threads Observer.
-
O VDS cria dois módulos de dados no PolarStore: Compare-and-Swap (CAS) Block e Polar Cluster Registry (PCR).
O CAS Block é um bloco de dados atômico que suporta operações CAS fornecidas pelo PolarStore. O CAS permite bloqueios distribuídos baseados em concessão (lease) no VDS e registra metadados como detentor do bloqueio e tempo de concessão. O nó primário e o nó de réplica quente de um cluster PolarDB usam semânticas de aquisição e renovação de bloqueio para detectar falhas e selecionar o nó primário.
O PCR armazena informações de gerenciamento de nós do PolarDB, como o status de topologia de um cluster. Threads Leader têm permissão para gravar dados no PCR, enquanto threads Follower e Observer têm apenas permissão de leitura. Quando um thread Follower é designado como Leader, o thread Leader original torna-se Follower. Somente o thread Leader mais recente tem permissão para gravar dados no PCR. O PCR também reconstrói a topologia.
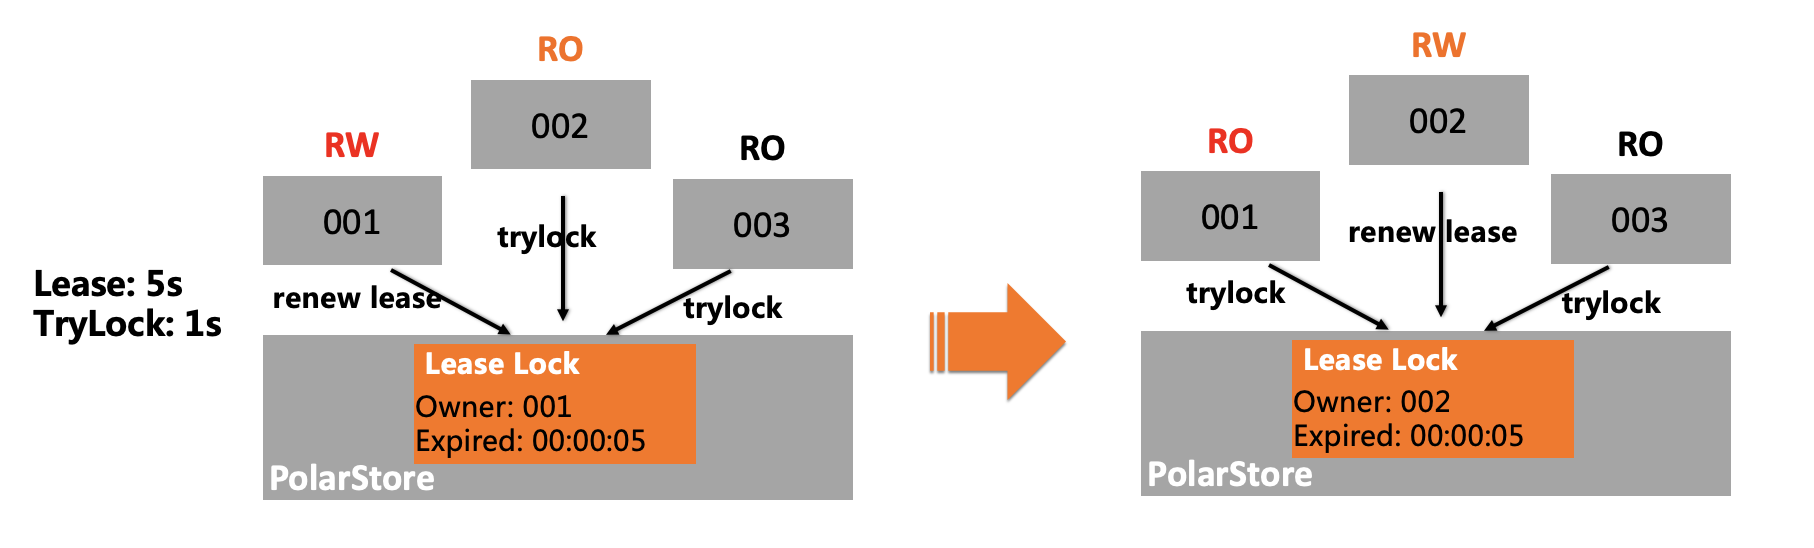
Geralmente, o nó primário fornece services de leitura e gravação, e o thread Leader correspondente renova regularmente seu bloqueio no VDS. Quando o nó primário fica indisponível, um nó de réplica quente assume o controle. O processo ocorre da seguinte forma:
Após a expiração da concessão do nó primário, um thread Follower é bloqueado e eleito como thread Leader. Nesse momento, o nó de réplica quente torna-se o nó primário.
Quando o nó primário original se recupera, ele falha ao adquirir um bloqueio. Então, o nó primário original é rebaixado para nó de réplica quente.
Ao concluir o processo de seleção do nó primário, o PCR transmite as novas informações de topologia para todos os threads Observer. Dessa forma, os nós somente leitura conectam-se automaticamente ao novo nó primário e restauram os links de sincronização para números de sequência de log (LSNs) e logs binários.
-
Global prefetching system
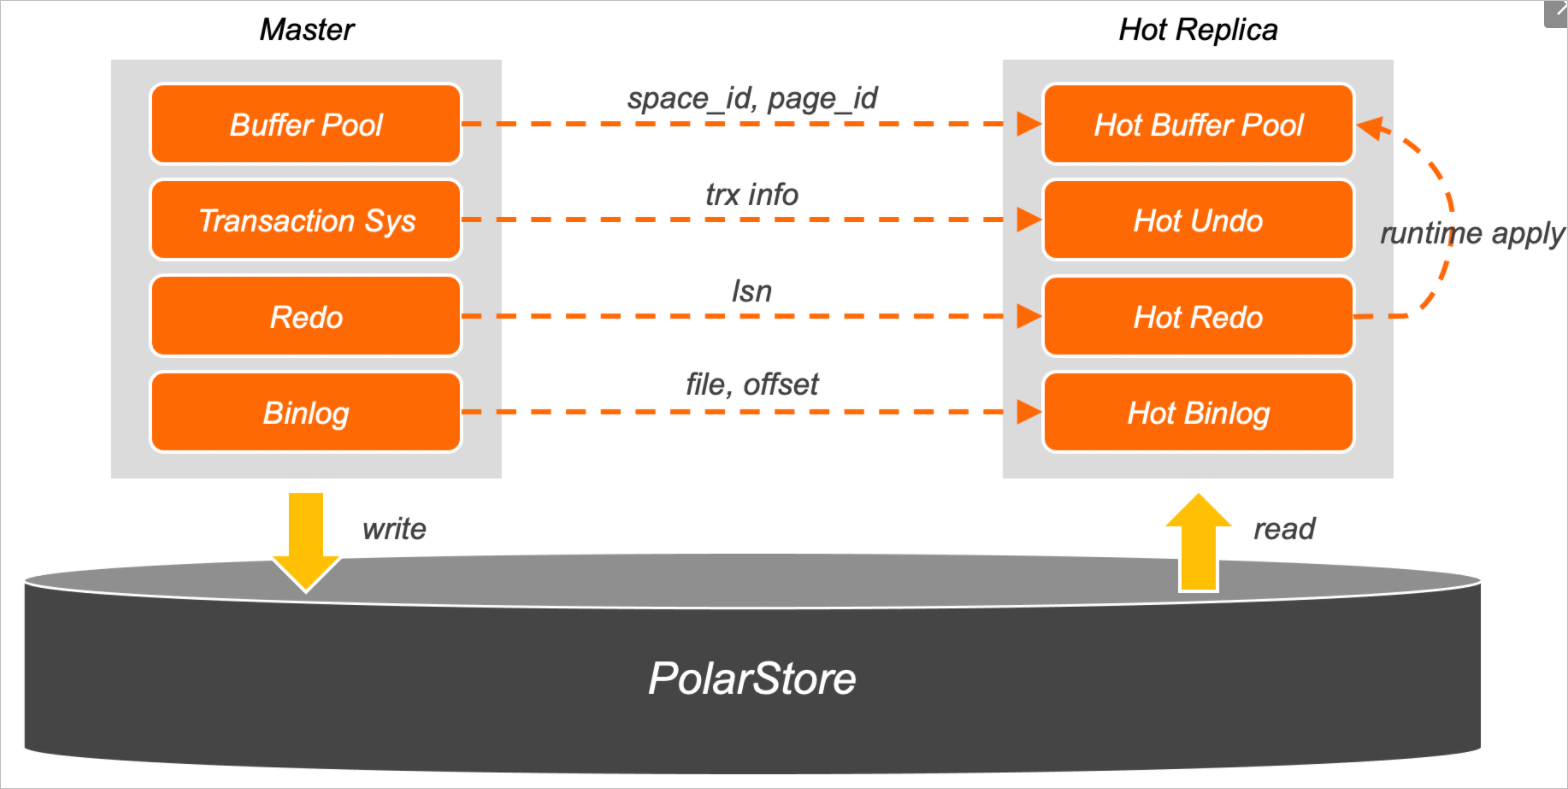
Comparado aos nós somente leitura comuns, o nó de standby quente é um tipo especial que reserva uma pequena parte dos recursos de CPU e memória para otimizar a velocidade de troca. O sistema de pré-busca global representa o módulo mais importante no failover com réplica quente. Ele sincroniza os metadados do nó primário em tempo real e pré-carrega dados essenciais na memória para acelerar o failover. Esse sistema consiste em quatro módulos: Buffer Pool, Undo, Redo e Binlog.
-
Buffer Pool
O módulo Buffer Pool monitora em tempo real a lista vinculada usada para implementar o algoritmo Least Recently Used (LRU) no buffer pool do nó primário e envia dados relevantes para o nó de réplica quente. O nó de réplica quente seleciona páginas acessadas frequentemente e as pré-carrega na memória, evitando degradação de desempenho causada por uma queda significativa na taxa de acerto do buffer pool quando um nó somente leitura é eleito como primário.
-
Undo
O módulo Undo pré-carrega dados do sistema de transações. Durante o failover, o PolarDB localiza transações pendentes nas páginas undo e reverte essas transações. Nós somente leitura processam apenas requisições de consultas analíticas em grande escala e não acessam transações não confirmadas do nó primário, resultando em longo tempo de espera de I/O para páginas undo. O recurso de failover com réplica quente pré-carrega páginas undo e as reproduz até a versão mais recente usando Runtime Apply, reduzindo o tempo de recuperação do sistema de transações.
-
Redo
O módulo Redo armazena em cache os logs redo dos nós de réplica quente e somente leitura na tabela hash redo da memória em tempo real.
-
Binlog
Com os logs binários ativados, as transações InnoDB no estado Prepare decidem confirmar ou reverter uma transação com base nesses logs. Ao executar muitas transações, o sistema pode levar vários segundos ou minutos para ler e analisar todos os logs binários. Os nós de réplica quente usam threads em segundo plano para armazenar assincronamente os logs binários mais recentes no cache de I/O e analisá-los antecipadamente, aumentando a velocidade do failover.
O PolarDB suporta conversão dinâmica entre nós de réplica quente e nós standby comuns. Em cenários reais, mantenha um nó de réplica quente ativado permanentemente ou ative o recurso apenas por um curto período durante alterações de configuração ou atualizações. O PolarDB permite configurar o nó primário e nós somente leitura com especificações diferentes. Contudo, pelo menos um nó somente leitura deve usar as mesmas especificações do nó primário para recuperação de desastres. Recomendamos configurar esse nó como réplica quente.
-
-
Persistent connections and transaction status preservation
No entanto, o failover ou a atualização quente podem afetar seu service e causar problemas como conexões transitórias, falhas de conexão e rollback de transações existentes. Isso aumenta a complexidade e os riscos do desenvolvimento de aplicações.
O PolarDB oferece o recurso Persistent connections. As conexões persistentes funcionam com o PolarProxy atuando como uma ponte de conexão entre sua aplicação e o PolarDB. Quando o banco de dados executa um failover primário/secundário, o PolarProxy conecta os nós do banco de dados à sua aplicação e restaura a sessão anterior, incluindo variáveis de sistema originais, variáveis de usuário, codificação de conjunto de caracteres e outras informações.
O recurso de conexões persistentes aplica-se apenas a conexões ociosas. Se a sessão atual tiver uma transação em execução no momento da troca de nó, o PolarProxy não conseguirá recuperar o contexto original da transação do PolarDB. O novo nó primário reverterá as transações não confirmadas e liberará os bloqueios de linha mantidos por elas. Nesse caso, não é possível manter as conexões persistentes. Para resolver esse problema, o PolarDB fornece o recurso de preservação de status de transação. A preservação de status de transação, combinada com conexões persistentes, permite um failover rápido para oferecer alta disponibilidade sem interromper seus services.
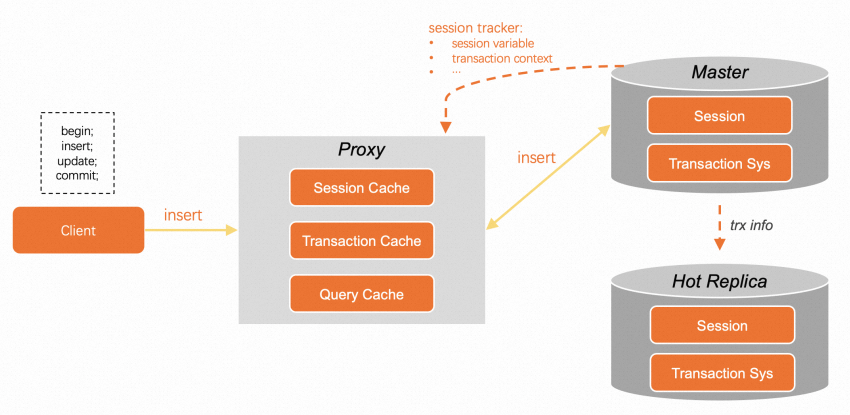
Diferente da replicação lógica baseada em logs binários, a arquitetura de replicação física permite que o PolarDB reconstrua as mesmas transações no nó de réplica quente assim como no nó primário.
Por exemplo, considere o processo de confirmação de uma transação em uma aplicação como BEGIN > INSERT > UPDATE > COMMIT, com o recurso de preservação de status de transação ativado. Após o início da execução da transação, o PolarProxy armazena em cache a instrução SQL executada mais recentemente enquanto encaminha a instrução SQL para o nó primário. Depois que a instrução INSERT é executada no nó primário, o PolarDB salva automaticamente o savepoint da instrução mais recente como parte das informações da transação. O rastreador de sessão retorna as informações atuais de sessão e transação para o PolarProxy. Em seguida, o PolarProxy salva temporariamente os dados no cache interno. Informações de sessão, como conjuntos de caracteres e variáveis de usuário, servem para manter as conexões. As informações de transação, como trx_id e undo_no, servem para preservar o status da transação. Além disso, as informações de transação são sincronizadas continuamente com a réplica quente por um link RDMA separado. Se os logs binários estiverem ativados para o banco de dados backend, o cache de log binário local correspondente a cada transação será sincronizado com o nó de réplica quente.
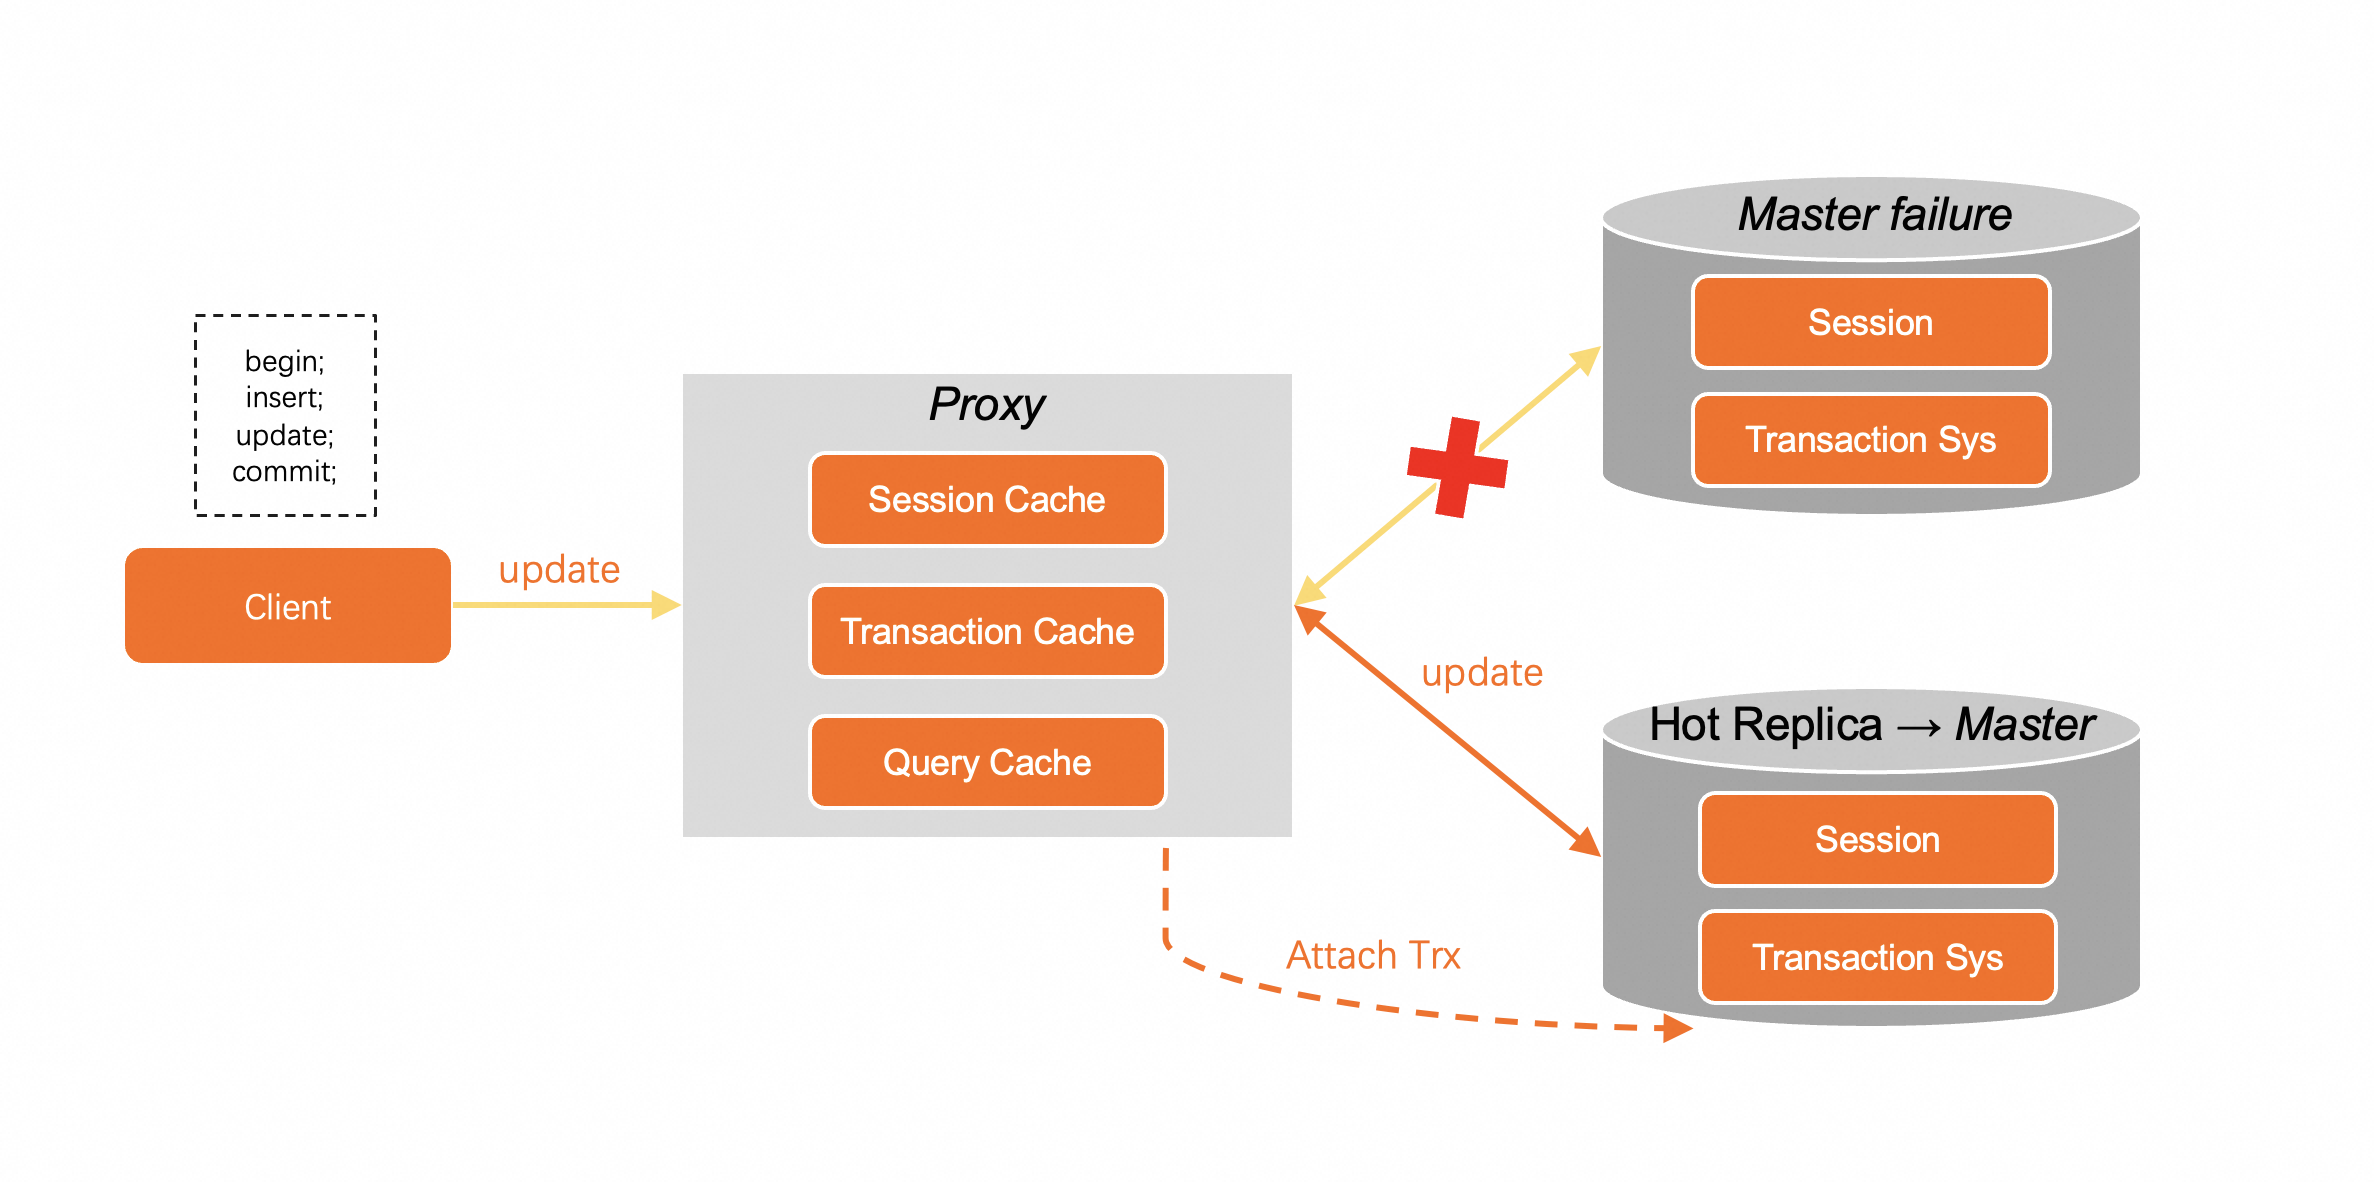
Suponha que o nó primário fique indisponível durante a execução da instrução UPDATE no PolarDB. O PolarProxy não transmite imediatamente o erro da camada subjacente para a conexão da aplicação, mas retém a requisição por um período. Após o failover, o novo nó primário constrói todas as transações não confirmadas com base nos logs redo e aguarda assincronamente pelas transações não confirmadas sem revertê-las. Ao detectar a mensagem de failover bem-sucedido, o PolarProxy usa as informações de sessão e transação armazenadas em cache para reconstruir a transação chamando a API Attach Trx do PolarDB. O PolarDB determina se as informações da transação são válidas com base nas informações do PolarProxy. Se forem válidas, elas serão vinculadas à conexão e revertidas para o savepoint do undo_no correspondente à última instrução (instrução UPDATE).
Após a reconstrução da transação, o PolarProxy reenvia a instrução UPDATE mais recente, que falhou na execução, para o novo nó primário a partir do cache de instruções SQL. Durante o processo de failover, nenhum erro de conexão ou transação é relatado na sua aplicação. A única diferença é que a instrução UPDATE pode ser mais lenta que o normal.
O recurso de failover com réplica quente otimiza a detecção de falhas, a velocidade de failover e a experiência no PolarDB ao combinar VDS, sistema de pré-busca global, conexões persistentes e preservação de status de transação. Atualize o cluster a qualquer momento sem preocupações com interrupções de conexão ou transação e aproveite a verdadeira elasticidade dos bancos de dados nativos da cloud.