PolarDB for MySQL 8.0 oferece o recurso de elastic parallel query (ePQ). Esse recurso é ativado automaticamente quando o volume de dados da consulta ultrapassa o limiar especificado, reduzindo significativamente o tempo de execução.
Introdução
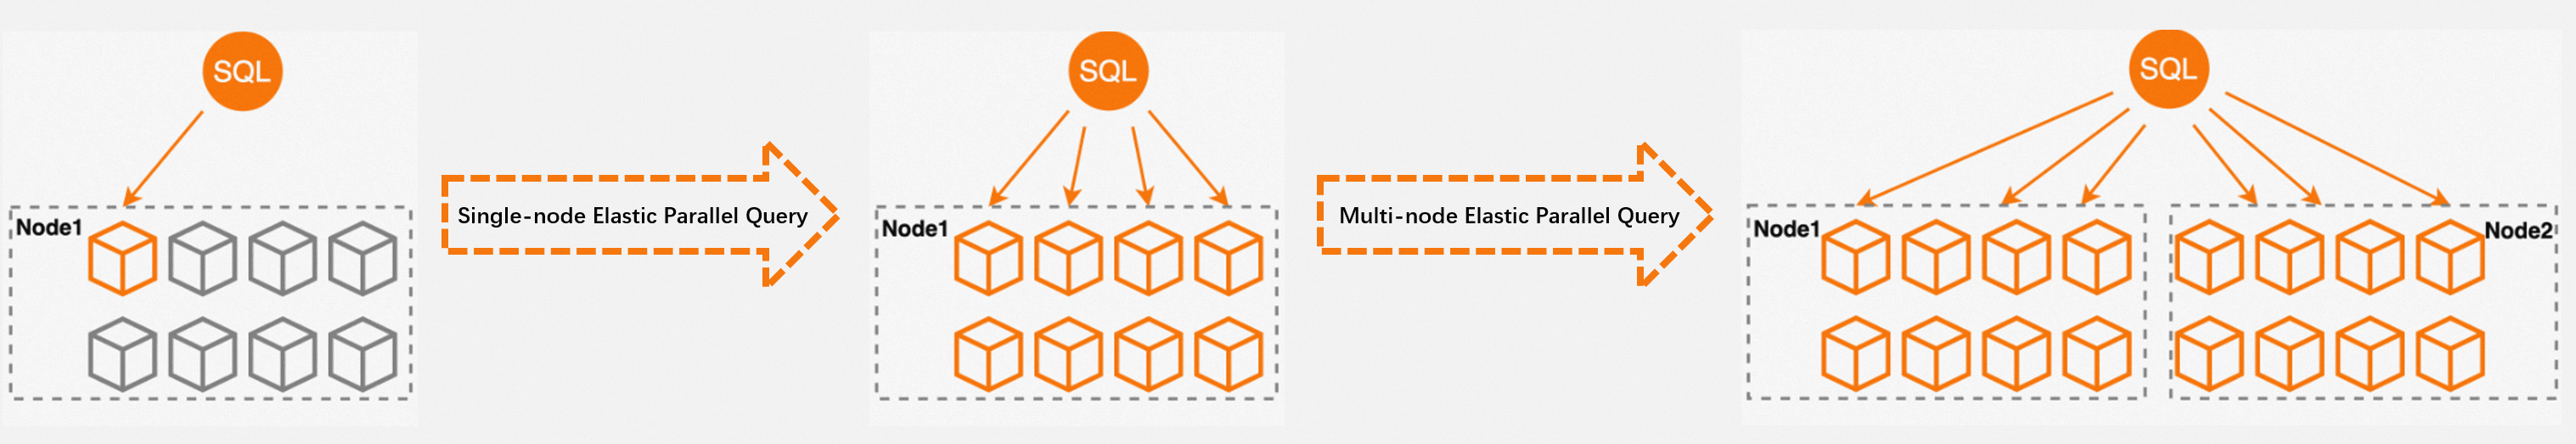
O recurso ePQ suporta dois mecanismos paralelos: elastic parallel query de nó único e elastic parallel query multinó. A elastic parallel query de nó único equivale ao recurso original de consulta paralela. Já a elastic parallel query multinó permite o agendamento adaptativo entre os nós de um cluster.
O PolarDB for MySQL 8.0.1 suporta apenas a elastic parallel query de nó único. Os dados da consulta são fragmentados em diferentes threads na camada de armazenamento. Essas threads executam em paralelo e retornam os resultados à thread líder. Em seguida, a thread líder mescla os resultados e devolve o resultado final aos usuários, aumentando a eficiência da consulta.
O PolarDB for MySQL 8.0.2 suporta tanto a elastic parallel query de nó único quanto a multinó. A versão multinó melhora significativamente as capacidades de aceleração linear e implementa computação paralela distribuída entre vários nós. A otimização baseada em custo permite planos de execução flexíveis e paralelos. Isso resolve possíveis gargalos na thread líder e desequilíbrios de carga nos workers das consultas de nó único, superando também as limitações de CPU, memória e I/O de um único nó. As visualizações globais de recursos e o agendamento adaptativo de tarefas de computação paralela aprimoram consideravelmente a capacidade de processamento, reduzem a latência das consultas, equilibram a carga de recursos entre os nós e melhoram a utilização geral dos recursos do cluster.
O recurso ePQ soluciona o problema de utilização baixa e desigual de recursos de CPU em instâncias de usuários na cloud, aproveitando ao máximo a capacidade de processamento paralelo de CPUs multicore dentro do cluster. A figura a seguir ilustra o processo em um cluster PolarDB for MySQL de 8 núcleos e 32 GB (especificações dedicadas).
Pré-requisitos
O cluster PolarDB for MySQL deve atender aos seguintes requisitos:
-
Elastic parallel query de nó único:
Mecanismo de banco de dados: versão 8.0.1 com revisão 8.0.1.0.5 ou posterior.
Edição do banco de dados: Enterprise Edition.
-
Elastic parallel query de nó único:
Mecanismo de banco de dados: versão 8.0.2 com revisão 8.0.2.1.4.1 ou posterior.
Edição do banco de dados: Enterprise Edition.
-
Elastic parallel query multinó:
Mecanismo de banco de dados: versão 8.0.2 com revisão 8.0.2.2.6 ou posterior.
Edição do banco de dados: Enterprise Edition.
Para saber como visualizar a versão de um cluster, consulte Query the engine version.
Cenários
O recurso ePQ aplica-se à maioria das instruções SELECT, como consultas em tabelas grandes, consultas multitable com instruções JOIN e consultas que envolvem grandes volumes de dados. Consultas curtas não se beneficiam significativamente desse recurso. Os diversos métodos paralelos tornam o recurso adequado para os seguintes cenários:
-
Consultas analíticas em grandes volumes de dados
Quando há quantidades médias ou grandes de dados, as instruções SQL para consultas analíticas costumam ser complexas e demoradas. Ative o recurso ePQ para reduzir linearmente o tempo de resposta.
-
Cargas de recursos desequilibradas
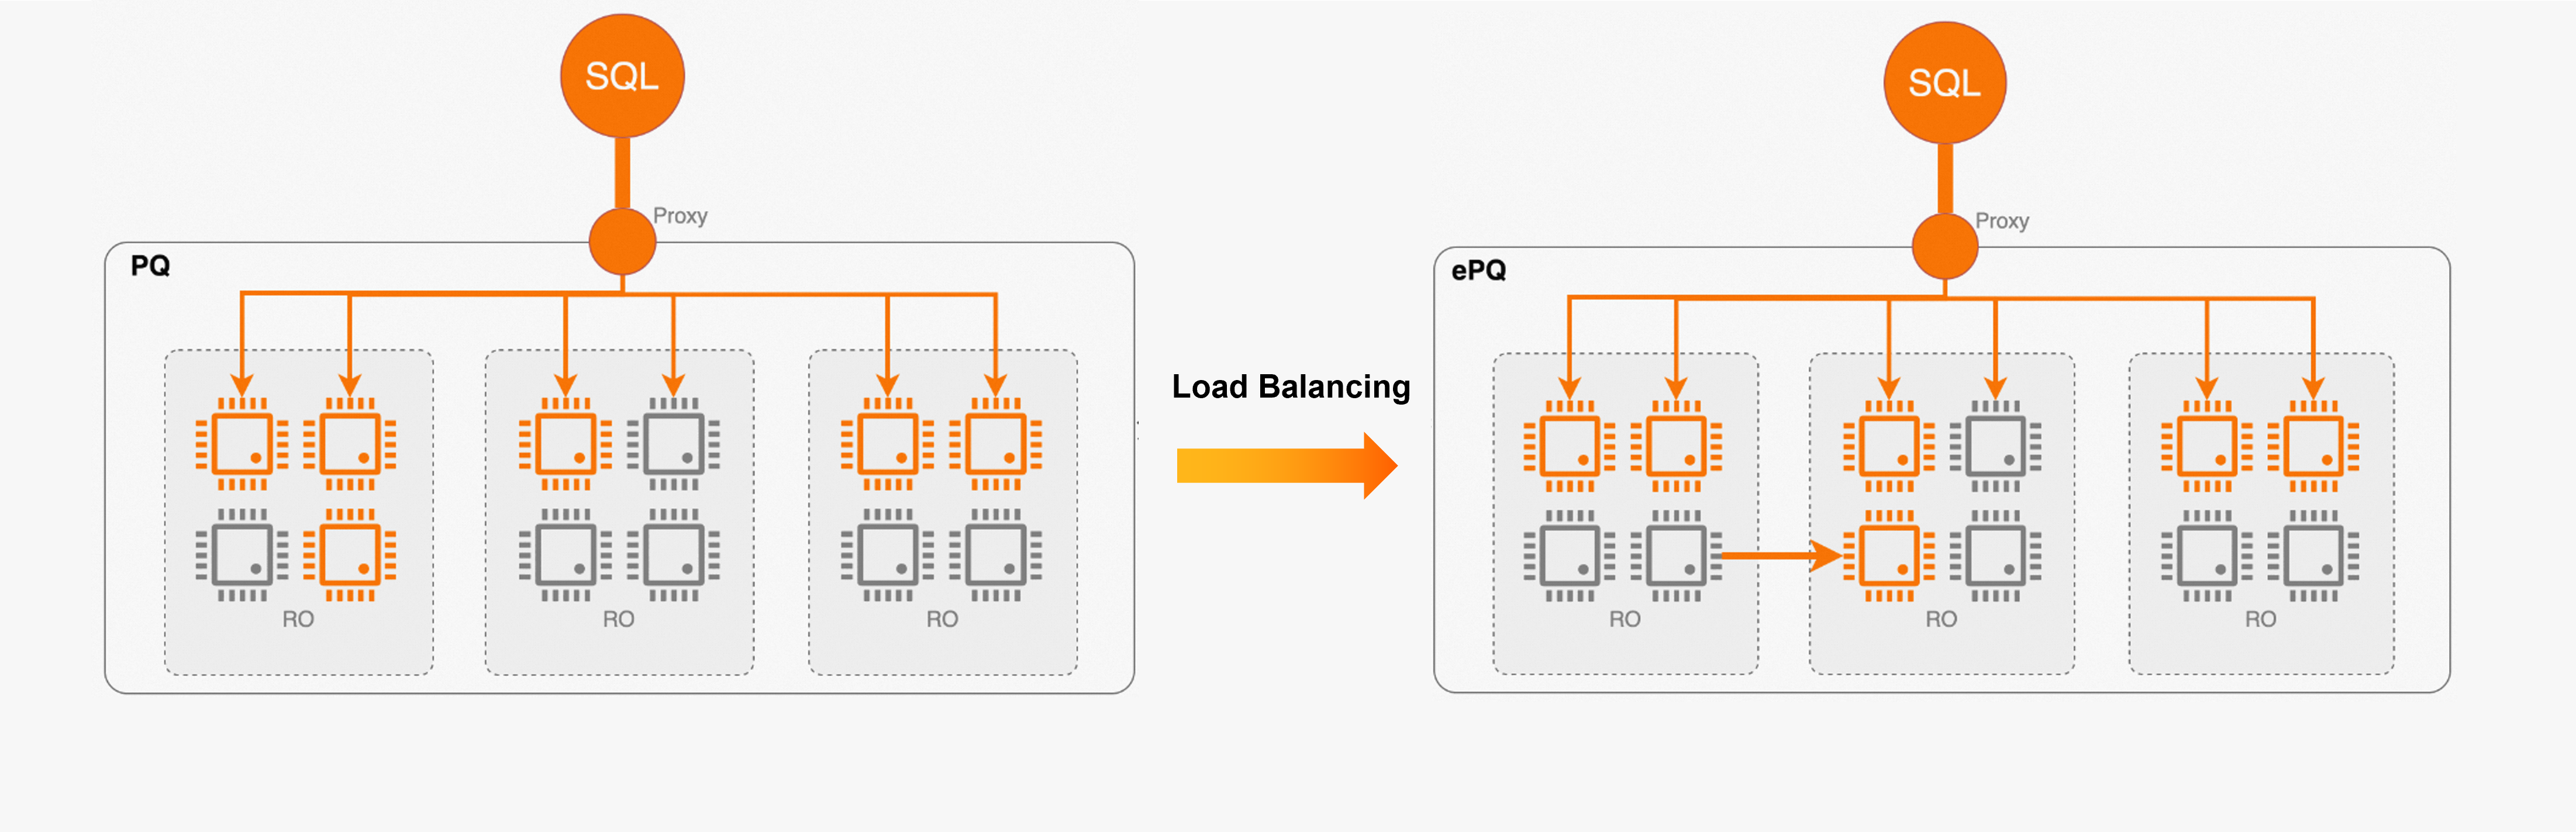
As capacidades de balanceamento de carga do PolarProxy ajudam a garantir que números semelhantes de conexões sejam criados para os nós de um cluster. No entanto, devido à complexidade computacional das consultas e às diferenças no uso de recursos, o balanceamento baseado em conexões não consegue evitar completamente o desequilíbrio de carga entre os nós. Assim como em outros bancos de dados distribuídos, os nós com hotspots impactam negativamente o PolarDB:
Se um nó somente leitura com hotspot causar consultas lentas, o nó primário pode não conseguir limpar os undo logs, resultando em inchaço do disco.
Se um nó somente leitura com hotspot causar operações lentas de aplicação de redo, o nó primário pode não conseguir liberar dados, reduzindo o desempenho do throughput de escrita.
O recurso ePQ introduz visualizações globais de recursos e agendamento adaptativo de tarefas com base nessas visualizações. Com base nos valores de resource usage e data affinity de cada nó, algumas ou todas as tarefas de consulta são agendadas para nós com recursos ociosos. Isso garante o grau de paralelismo (DOP) desejado e o uso equilibrado de recursos dentro do cluster.
-
Computação elástica
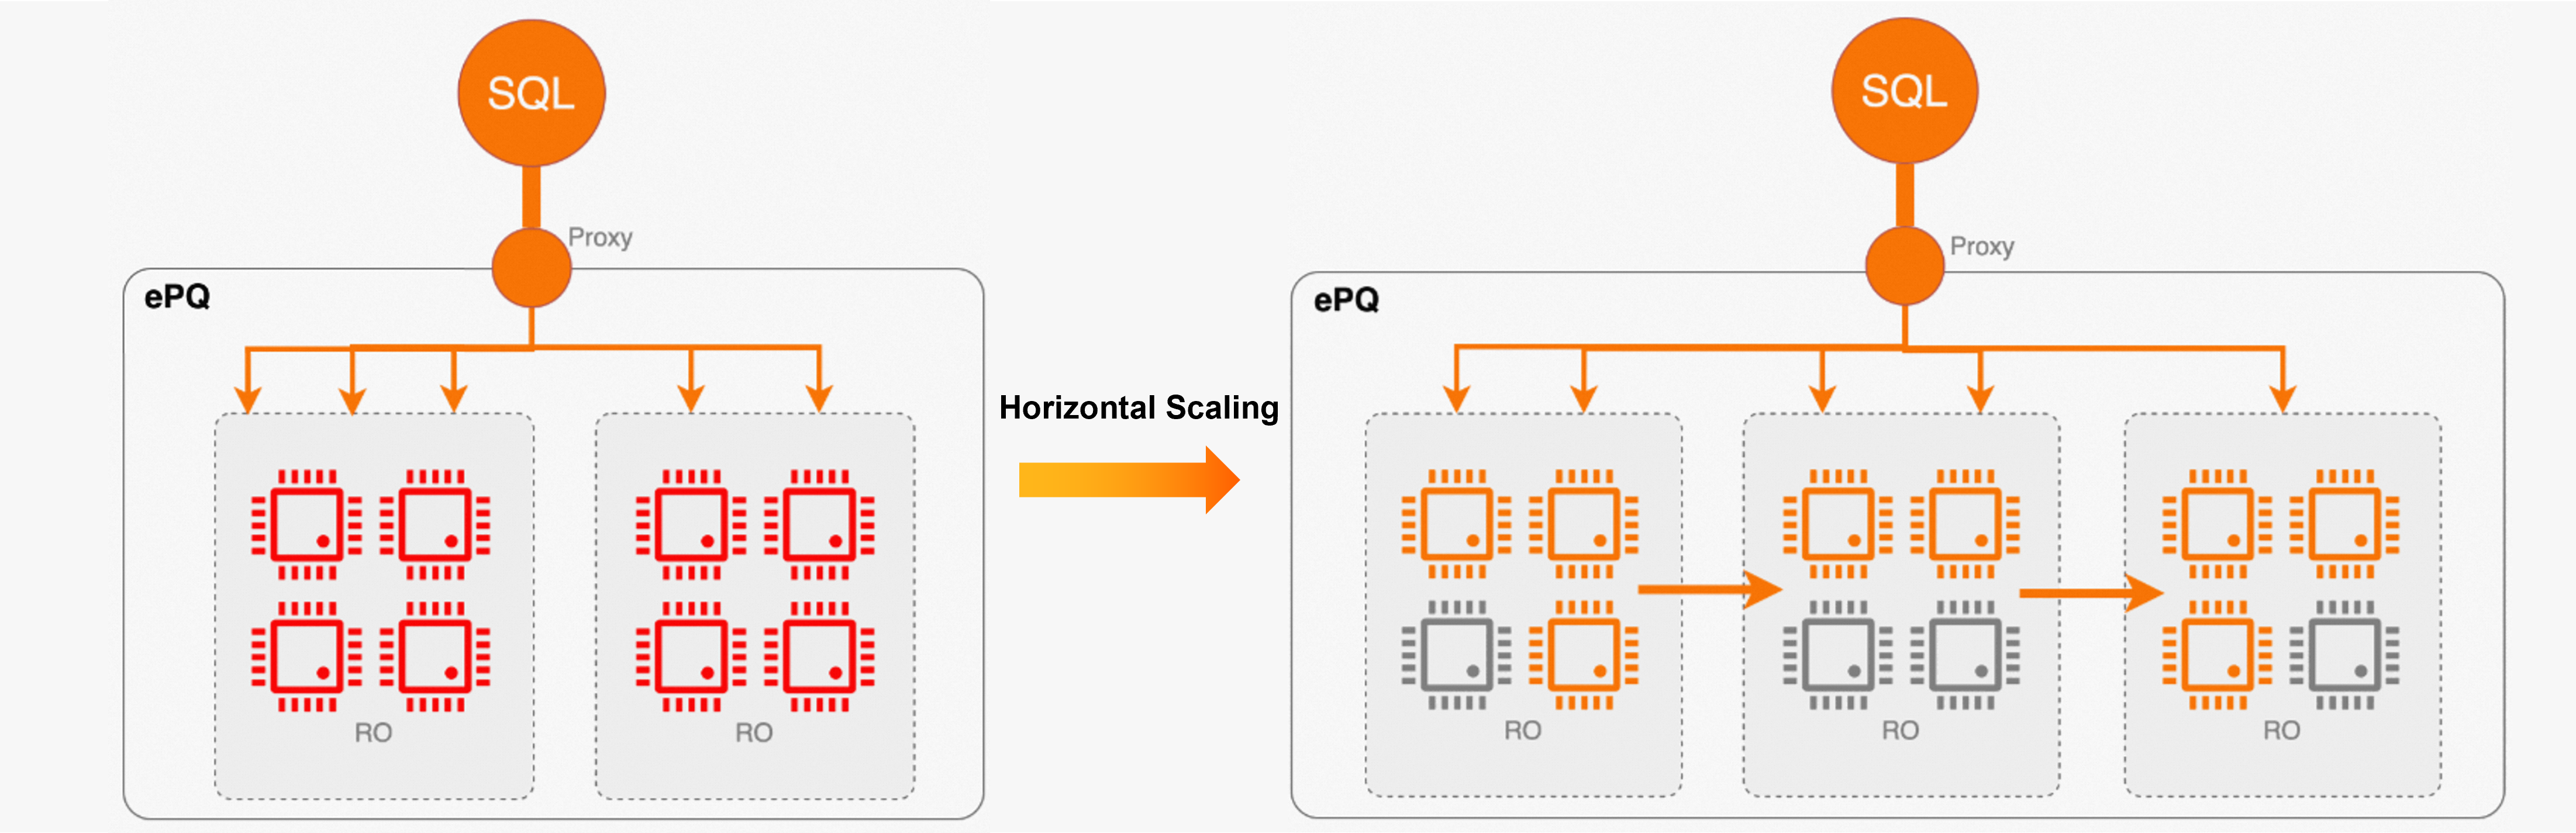
A elasticidade é uma das capacidades principais do PolarDB. O dimensionamento automático fornece elasticidade adequada para consultas curtas. Contudo, não é ideal para consultas analíticas complexas, pois uma única consulta não pode ser acelerada apenas adicionando nós em cenários de consulta em larga escala. Quando o recurso ePQ está ativado para um cluster, os novos nós adicionados pelo dimensionamento integram-se automaticamente ao cluster para compartilhar recursos de computação e aumentar a elasticidade.
-
Combinação de service online e offline
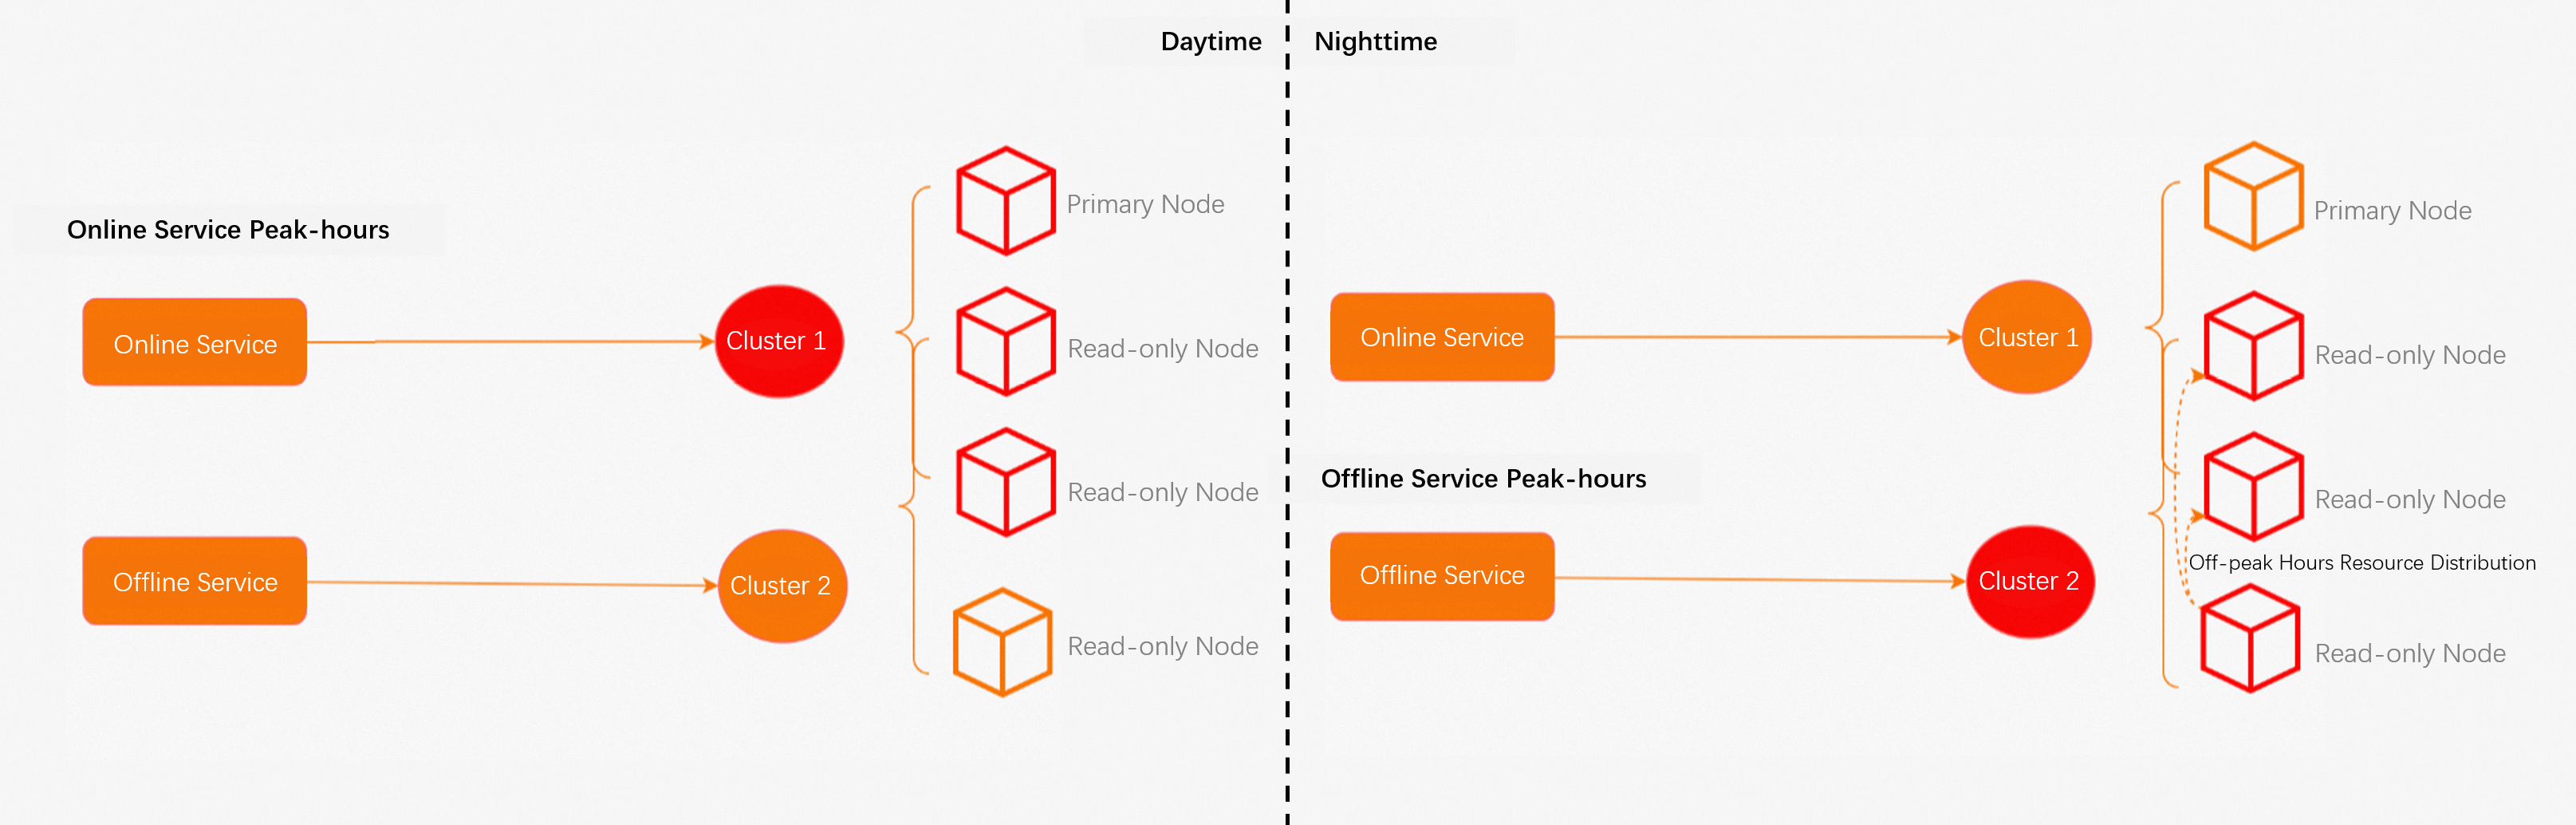
O método de isolamento mais eficaz consiste em direcionar o service transacional online e o service analítico offline para conjuntos de nós diferentes. Entretanto, essa abordagem aumenta os custos. Na maioria dos casos, esses service têm horários de pico distintos. Uma alternativa econômica é compartilhar os recursos do cluster entre eles e roteá-los para endpoints diferentes. Após ativar o recurso ePQ, os recursos ociosos são distribuídos para o service analítico offline durante os períodos de menor movimento do service transacional online, reduzindo custos e melhorando a eficiência.
Notas de uso
Para obter informações sobre como usar o recurso ePQ, consulte Get started.
Métricas de desempenho
O teste a seguir utiliza 100 GB de dados gerados com base no TPC Benchmark H (TPC-H) para examinar o desempenho de um cluster PolarDB for MySQL 8.0. Nesse teste, o cluster PolarDB possui quatro nós com 32 núcleos de CPU e 256 GB de memória (Dedicated). Para a elastic parallel query de nó único, o parâmetro max_parallel_degree foi definido como 32 e 0. Compare os dados de desempenho entre consulta sequencial, elastic parallel query de nó único com DOP de 32 e elastic parallel query de quatro nós com DOP de 128. Para mais detalhes, consulte Parallel query performance.
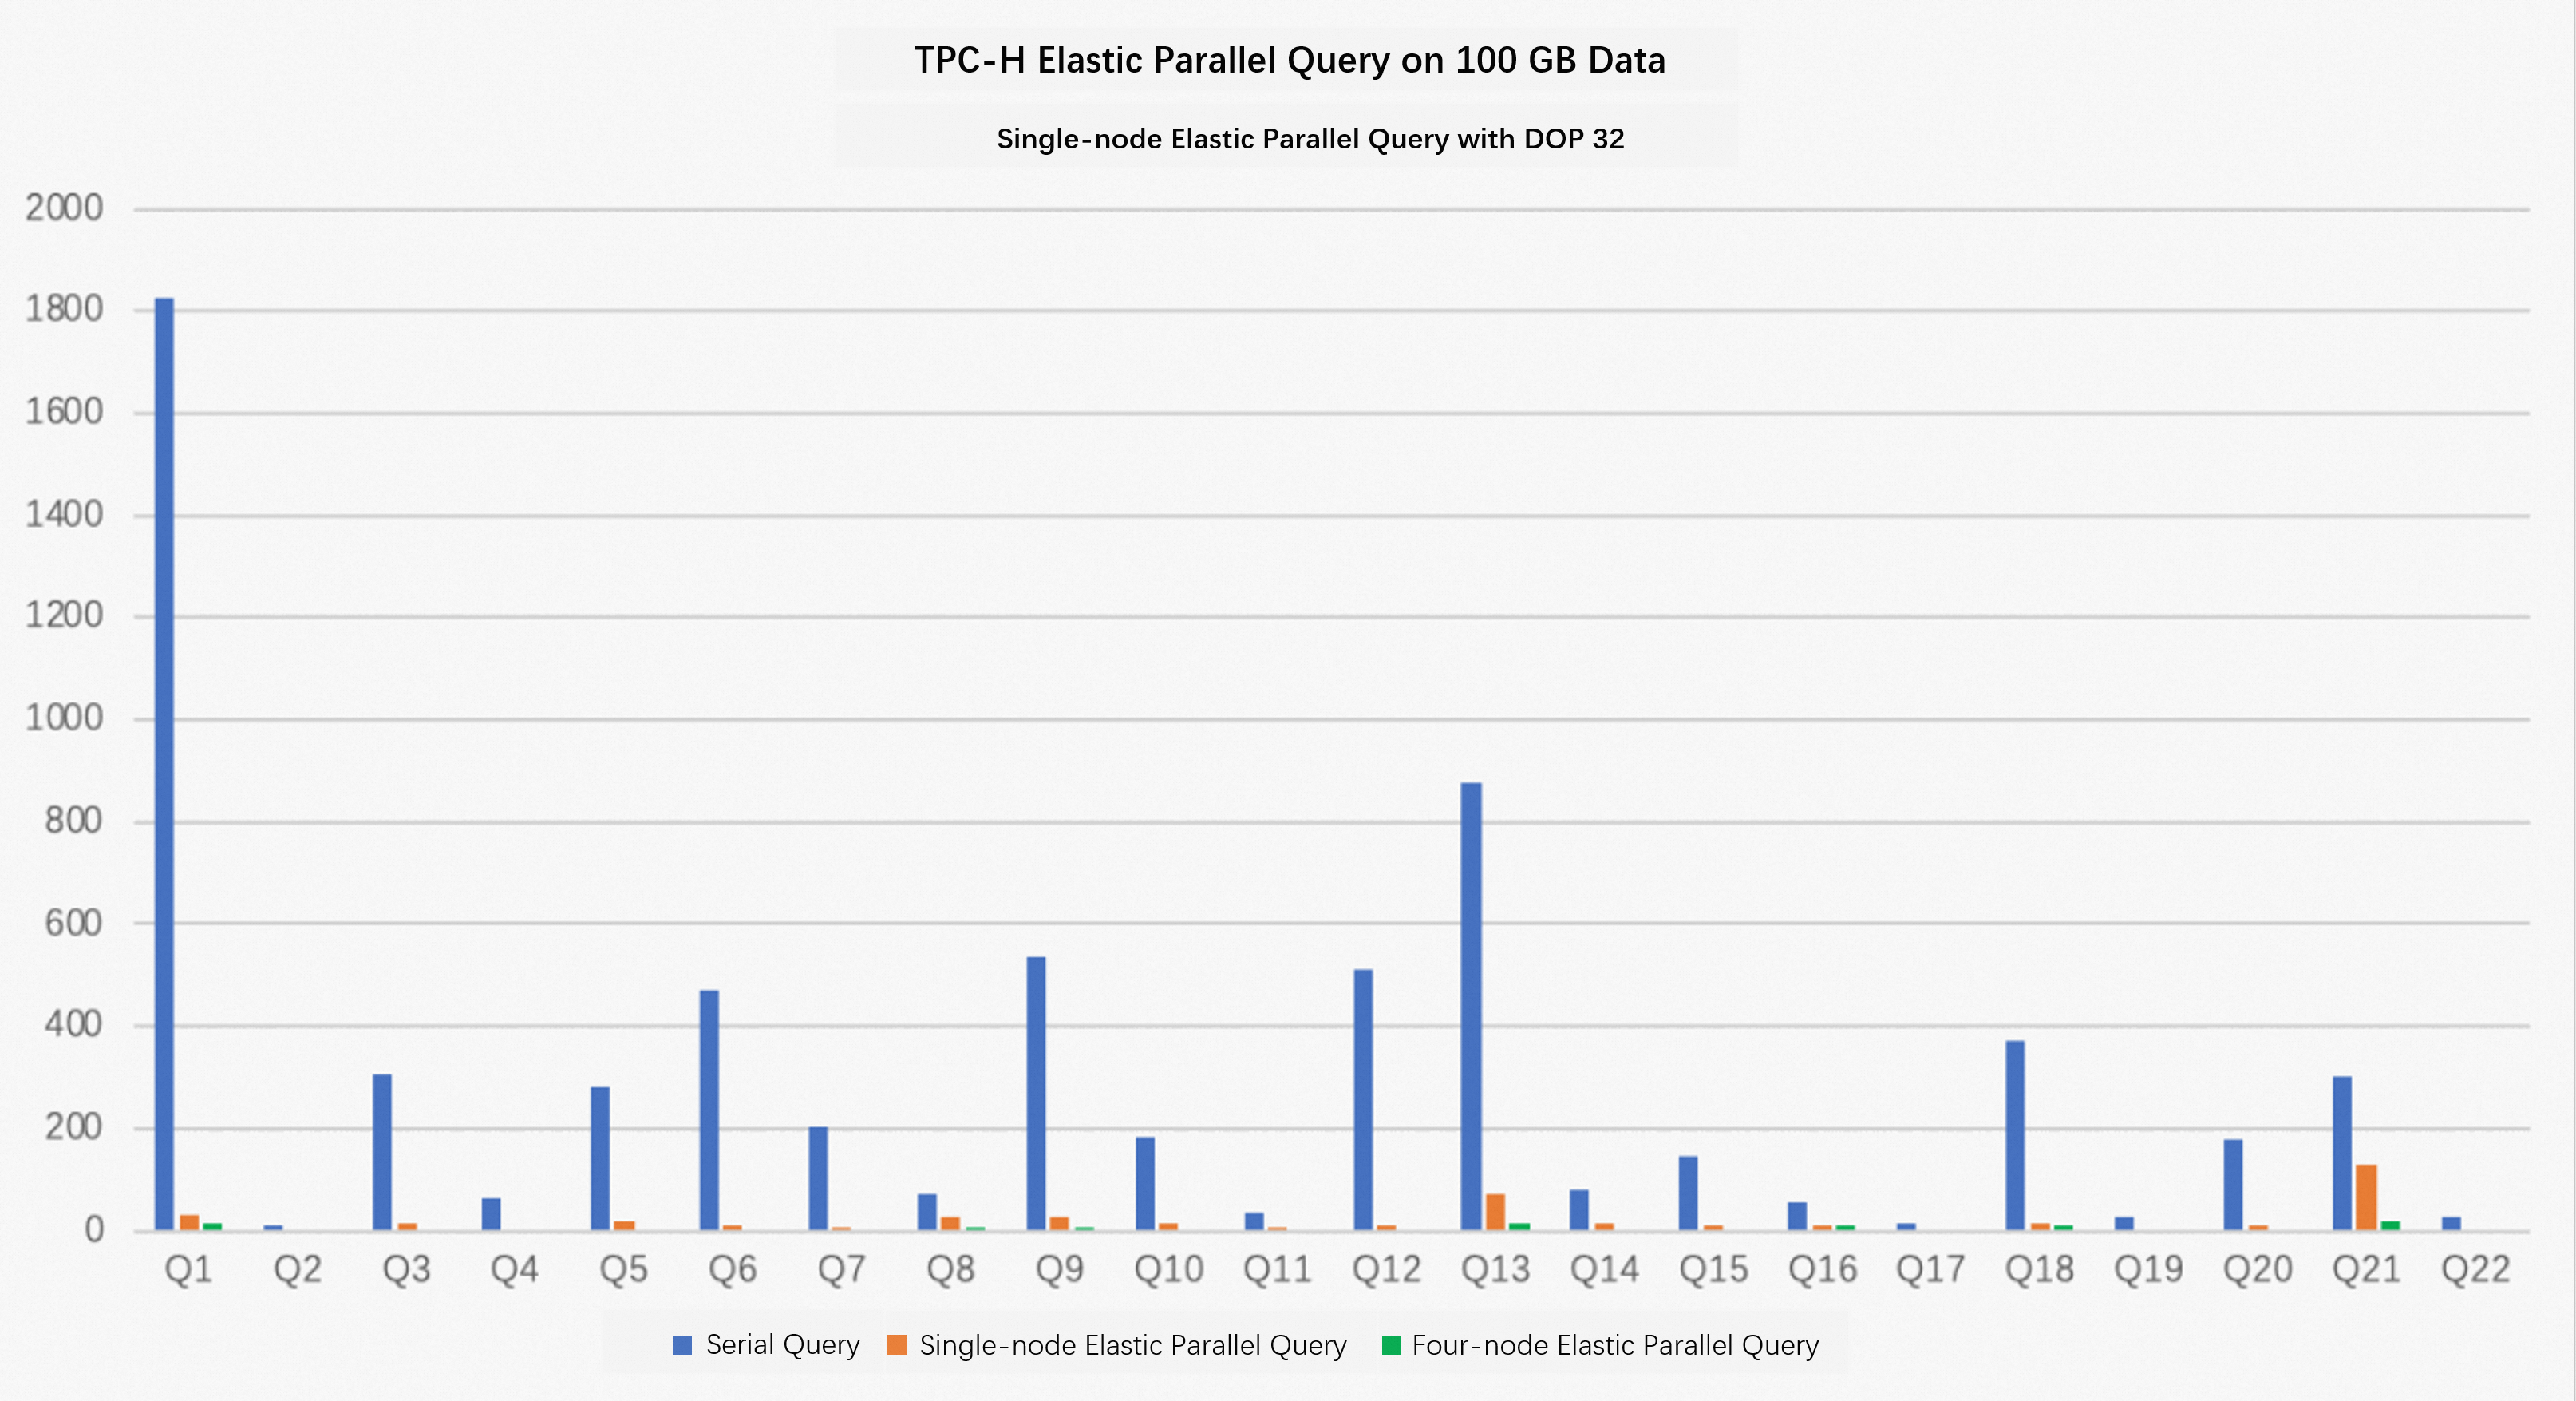
Os resultados acima mostram que 100% das consultas SQL do TPC-H foram aceleradas. A velocidade de consulta foi, em média, 17 vezes maior e, no máximo, 56 vezes maior.
When multi-node elastic parallel query is enabled, the query speed is 59 times faster on average and 159 times faster at maximum.
A implementação do TPC-H neste tópico baseia-se no benchmarking TPC-H. Estes resultados não podem ser comparados com os resultados oficiais publicados do TPC-H, pois os testes não atendem totalmente a todos os requisitos do TPC-H.
Visualizar planos de execução de elastic parallel query
Para saber como executar a instrução EXPLAIN e visualizar informações da elastic parallel query nos planos de execução, consulte Use EXPLAIN to view parallel query plans.
Termos
-
Parallel scan
Em um parallel scan, os workers varrem os dados de uma tabela em paralelo. Cada worker produz um resultado parcial e o retorna à thread líder. A thread líder reúne os resultados usando o nó gather e devolve o resultado final ao cliente.
-
Parallel joins em múltiplas tabelas
Se o recurso ePQ estiver ativado, a operação de join multitable é enviada aos workers para processamento paralelo. O otimizador do PolarDB seleciona a tabela ideal para parallel scan, mas não realiza parallel scan nas demais tabelas. Cada worker gera um resultado parcial e o envia à thread líder. Esta reúne os resultados por meio do nó gather e retorna o resultado final ao cliente.
-
Parallel sorting
O otimizador do PolarDB envia a operação ORDER BY para todos os workers visando a ordenação paralela. Cada worker produz um resultado parcial e o retorna à thread líder. A thread líder reúne, mescla e ordena todos os resultados parciais utilizando o nó gather merge, devolvendo o resultado final da ordenação ao cliente.
-
Parallel grouping
O otimizador do PolarDB envia a operação GROUP BY aos workers para processamento paralelo. Cada worker executa a operação GROUP BY em uma parte dos dados, gerando um resultado parcial retornado à thread líder. A thread líder reúne os resultados de todos os workers usando o nó gather. O otimizador do PolarDB decide se deve executar novamente uma operação GROUP BY na thread líder com base no plano de consulta. Por exemplo, se um loose index scan for usado para executar uma instrução GROUP BY, a thread líder não realizará outra operação GROUP BY. Caso contrário, ela executará a operação e retornará o resultado final ao cliente.
-
Parallel aggregation
Quando o recurso ePQ está ativado, a função de agregação é enviada a todos os workers para agregação paralela. O otimizador determina se deve realizar execução serial, agregação em uma fase ou agregação em duas fases com base no custo.
Agregação em uma fase: o otimizador distribui a operação de agregação aos workers. Como cada worker contém todos os dados dos grupos, a computação da segunda fase não é necessária. Cada worker calcula diretamente os resultados finais de agregação dos grupos, evitando que a thread líder precise realizar uma segunda agregação.
Agregação em duas fases: na primeira fase, cada worker envolvido na elastic parallel query realiza a agregação. Na segunda fase, o nó gather ou gather merge retorna os resultados gerados por cada worker à thread líder. Em seguida, a thread líder agrega os resultados de todos os workers para gerar o resultado final.
Agregação shuffle em duas fases: na primeira fase, cada worker na elastic parallel query executa a agregação. Na segunda fase, o nó repartition distribui o resultado gerado por cada worker para múltiplos workers, agrupados por colunas. Os workers concluem a computação final da agregação em paralelo. Por fim, os resultados da agregação são consolidados na thread líder.
O otimizador do PolarDB define o método específico de agregação com base no custo.
-
Parallel window function
O otimizador do PolarDB realiza a computação e distribui window functions aos workers para execução paralela com base nos custos. Cada worker processa uma parte dos dados. O método de distribuição é determinado pela chave da cláusula PARTITION BY nas window functions. Se as window functions não contiverem a cláusula PARTITION BY, a computação será serial. Se for possível realizar computação paralela posteriormente, as tarefas subsequentes serão distribuídas a múltiplos workers para execução com base no custo, garantindo a máxima paralelização.
-
Suporte a subconsultas
Em uma elastic parallel query, você pode usar uma das seguintes políticas para executar subconsultas:
-
Execução sequencial na thread líder
Se as subconsultas não suportarem processamento paralelo, elas serão executadas sequencialmente na thread líder. Por exemplo, se duas tabelas forem unidas por uma cláusula JOIN que referencie funções definidas pelo usuário (UDFs), as subconsultas serão realizadas em sequência.
-
Execução paralela na thread líder (uso de outro grupo de workers)
Após a geração de um plano de elastic parallel query, se o plano de execução da thread líder incluir subconsultas compatíveis com processamento paralelo, essas subconsultas não poderão ser executadas antecipadamente nem em paralelo com base na política de acesso compartilhado. Por exemplo, se as subconsultas incluírem window functions, elas não poderão ser executadas em paralelo sob a política de acesso compartilhado.
-
Acesso compartilhado
Depois que um plano de elastic parallel query é gerado, se os planos de execução dos workers referenciarem subconsultas que suportam processamento paralelo, o otimizador do PolarDB executa essas subconsultas paralelas antecipadamente. Dessa forma, os workers podem acessar diretamente os resultados das subconsultas.
-
Pushed down
Após a geração de um plano de elastic parallel query, se os planos de execução dos workers referenciarem subconsultas correlacionadas, os próprios workers executarão essas subconsultas.
-