PolarDB oferece o recurso de otimização de replicação física de DDL (Data Definition Language). Esse recurso otimiza completamente o caminho crítico de gravação de logs físicos no nó primário e de aplicação desses logs nos nós somente leitura. Ele reduz significativamente o tempo de execução das operações de DDL no nó primário e o atraso de replicação de logs físicos para análise de DDL nos nós somente leitura. Este tópico descreve como usar o recurso de otimização de replicação física de DDL.
Pré-requisitos
Os clusters PolarDB devem executar uma das seguintes versões. Você pode Consultar a versão do mecanismo para verificar a versão do seu cluster:
PolarDB for MySQL 8.0.1 com versão de revisão 8.0.1.1.10 ou posterior.
PolarDB for MySQL 5.7 com versão de revisão 5.7.1.0.10 ou posterior.
Limites
O recurso de otimização de replicação física de DDL paralelo oferece suporte apenas a operações de DDL que criam chaves primárias ou índices secundários. Índices de texto completo e índices espaciais não são suportados.
Para operações de DDL que modificam apenas metadados, como rename, essa otimização não é necessária, pois essas operações já são executadas rapidamente.
Este recurso de otimização não é suportado no PolarDB for MySQL 8.0.2 ou 5.6.
Informações de fundo
O PolarDB utiliza uma arquitetura de des agregação de armazenamento e computação, de modo que o nó primário e os nós somente leitura compartilham os mesmos dados armazenados. Isso reduz os custos de armazenamento e melhora a disponibilidade e a confiabilidade do cluster. Para implementar essa arquitetura, o PolarDB utiliza tecnologia de replicação física. Isso garante a consistência dos dados entre o nó primário e os nós somente leitura na arquitetura de armazenamento compartilhado e reduz a sobrecarga de E/S causada pelas operações de fsync do log binário (Binlog).
O InnoDB utiliza B-trees para manter os índices. No entanto, a maioria das operações lentas de DDL, como adicionar uma chave primária, adicionar um índice secundário ou executar optimize table, geralmente requer a reconstrução ou criação de índices B-tree. Isso gera um grande volume de logs físicos. As operações sobre logs físicos frequentemente estão no caminho crítico da execução de DDL, o que aumenta o tempo de execução das operações de DDL. Além disso, a replicação física exige que os nós somente leitura analisem e apliquem esses logs físicos recém-gerados. O grande volume de logs físicos gerado pelas operações de DDL pode afetar gravemente a sincronização de logs nos nós somente leitura e até mesmo tornar os nós somente leitura indisponíveis.
Para resolver esses problemas, o PolarDB oferece o recurso de otimização de replicação física de DDL. Esse recurso otimiza completamente o caminho crítico de gravação de logs físicos no nó primário e de aplicação de logs físicos nos nós somente leitura. Ele pode reduzir o tempo de execução de uma operação de DDL que cria uma chave primária no nó primário em até 20,6%. Também pode reduzir o atraso de replicação para análise de DDL nos nós somente leitura para aproximadamente 0,4% do tempo original.
Uso
Defina o seguinte parâmetro para ativar o recurso de otimização de replicação física de DDL.
Parâmetro | Nível | Descrição |
innodb_bulk_load_page_grained_redo_enable | Global | O switch para o recurso de otimização de replicação física de DDL. Valores válidos:
|
Teste de desempenho
-
Preparação do teste
-
Ambiente de teste
Cluster PolarDB for MySQL 8.0 com um nó primário e um nó somente leitura. O cluster usa a especificação de 16 núcleos e 128 GB.
O cluster possui 50 TB de espaço de armazenamento.
-
Esquema da tabela de teste
Execute a seguinte instrução para criar uma tabela chamada
t0:CREATE TABLE t0(a INT PRIMARY KEY, b INT) ENGINE=InnoDB; -
Dados da tabela de teste
Execute a seguinte instrução para gerar dados de teste aleatórios:
DELIMITER // CREATE PROCEDURE populate_t0() BEGIN DECLARE i int DEFAULT 1; WHILE (i <= $table_size) DO INSERT INTO t0 VALUES (i, 1000000 * RAND()); SET i = i + 1; END WHILE; END // DELIMITER ; CALL populate_t0();NotaAo executar o teste, substitua
$table_sizepelo número real de registros na tabela, como1000000.Este teste utiliza tabelas que contêm 1.000.000, 10.000.000, 100.000.000 e 1.000.000.000 de registros.
-
Operações de DDL utilizadas no teste
add primary keyadd secondary Indexoptimize table
-
-
Métodos de teste
Teste 1: Medir o tempo necessário para executar diferentes operações de DDL em tabelas com diferentes volumes de dados quando o recurso de otimização de replicação física de DDL está ativado ou desativado.
Teste 2: Quando o recurso de otimização de replicação física de DDL é usado em conjunto com o DDL paralelo, medir o tempo necessário para executar a operação
add secondary Indexem uma tabela que contém 1 bilhão de registros.Teste 3: Medir o desempenho do nó somente leitura, como se o status do nó é normal, o pico de utilização da CPU e o atraso de replicação, quando o recurso de otimização de replicação física de DDL está ativado ou desativado. O teste utiliza um cluster que contém uma tabela com 1 bilhão de registros e varia o número de operações de DDL simultâneas no nó primário (1, 2, 4, 6 e 8).
-
Resultados do teste
-
Teste 1
Quando o parâmetro innodb_bulk_load_page_grained_redo_enable está ativado ou desativado, a figura a seguir mostra o tempo, em segundos, necessário para executar a operação
add primary key(a)em tabelas com diferentes volumes de dados (1 milhão, 10 milhões, 100 milhões e 1 bilhão).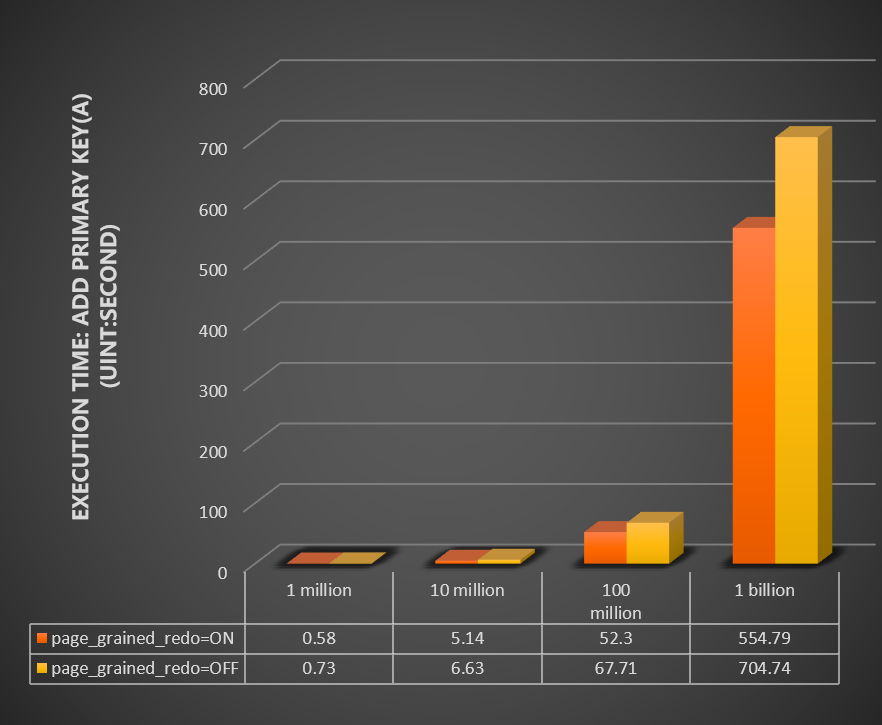
Quando o parâmetro innodb_bulk_load_page_grained_redo_enable está ativado ou desativado, a figura a seguir mostra o tempo, em segundos, necessário para executar a operação
optimize tableem tabelas com diferentes volumes de dados (1 milhão, 10 milhões, 100 milhões e 1 bilhão).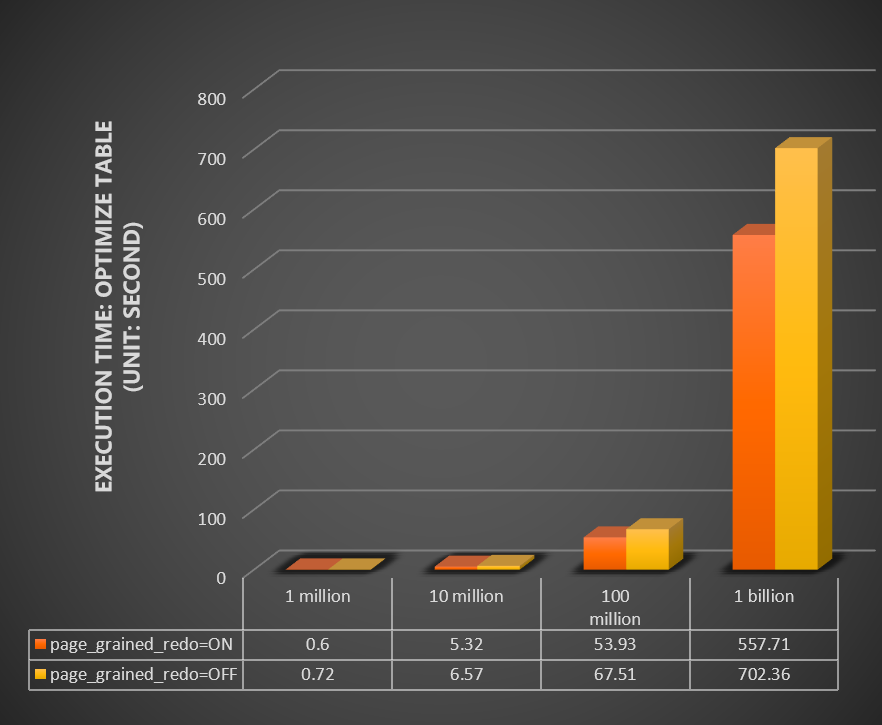
-
Teste 2
Os parâmetros innodb_polar_use_sample_sort e innodb_polar_use_parallel_bulk_load do DDL paralelo estão ativados neste teste. O teste utiliza uma tabela que contém 1 bilhão de registros e é executado com o parâmetro innodb_bulk_load_page_grained_redo_enable ativado ou desativado. Também utiliza diferentes quantidades de threads paralelas (ou seja, o parâmetro innodb_polar_parallel_ddl_threads definido como 1, 2, 4, 8, 16 e 32). O teste mede o tempo, em segundos, necessário para executar a operação
add secondary Index. A figura a seguir mostra os resultados.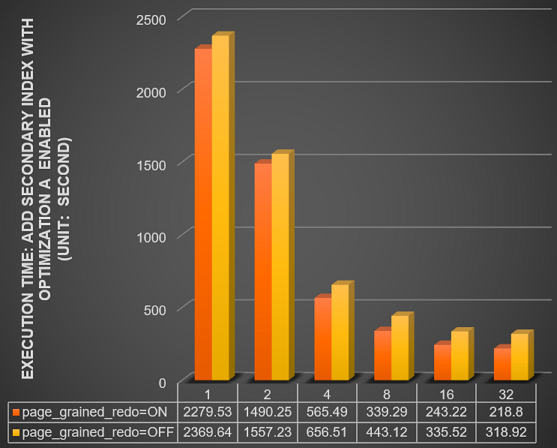
Os parâmetros innodb_polar_use_sample_sort e innodb_polar_use_parallel_bulk_load do DDL paralelo estão desativados neste teste. O teste utiliza uma tabela que contém 1 bilhão de registros e é executado com o parâmetro innodb_bulk_load_page_grained_redo_enable ativado ou desativado. Também utiliza diferentes quantidades de threads paralelas (1, 2, 4, 8, 16 e 32). O teste mede o tempo, em segundos, necessário para executar a operação
add secondary Index. A figura a seguir mostra os resultados.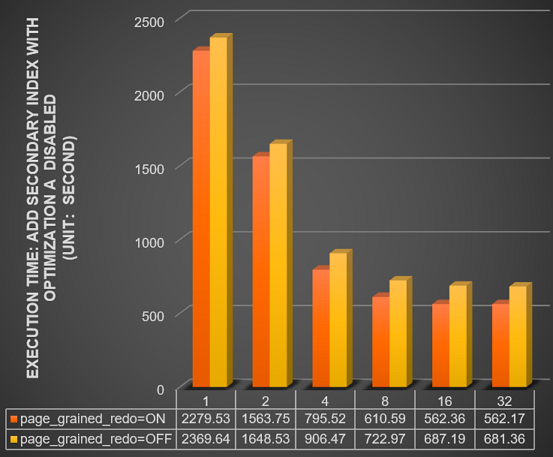
-
Teste 3
-
O parâmetro innodb_bulk_load_page_grained_redo_enable está ativado neste teste. O teste utiliza um cluster que contém uma tabela com 1 bilhão de registros. A tabela a seguir mostra o desempenho do nó somente leitura para diferentes quantidades de operações de DDL simultâneas no nó primário (1, 2, 4, 6 e 8).
Número de operações de DDL simultâneas
1
2
4
6
8
Status do nó somente leitura
Normal
Normal
Normal
Normal
Normal
Pico de utilização da CPU (%)
1.86
1.71
1.76
2.25
2.36
Pico de uso de memória (%)
10.37
10.80
10.88
11
11.1
Pico de IOPS de leitura (operações/segundo)
10965
10762
10305
10611
10751
Pico de atraso de replicação (segundos)
0
0.73
0.87
0.93
0.03
-
O parâmetro innodb_bulk_load_page_grained_redo_enable está desativado neste teste. O teste utiliza um cluster que contém uma tabela com 1 bilhão de registros. A tabela a seguir mostra o desempenho do nó somente leitura para diferentes quantidades de operações de DDL simultâneas no nó primário (1, 2, 4, 6 e 8).
NotaOs dados para quatro operações de DDL simultâneas foram coletados antes de o nó somente leitura ficar indisponível.
O símbolo
-na tabela indica que as operações de DDL relacionadas não puderam ser executadas para o número atual de operações de DDL simultâneas. Portanto, não há dados de teste disponíveis.
Número de operações de DDL simultâneas
1
2
4
6
8
Status do nó somente leitura
Normal
Normal
Indisponível
Indisponível
Indisponível
Pico de utilização da CPU (%)
4.2
9.5
10.3
-
-
Pico de uso de memória (%)
22.15
23.55
68.61
-
-
Pico de IOPS de leitura (operações/segundo)
9243
7578
7669
-
-
Pico de atraso de replicação (segundos)
0.8
14.67
211
-
-
-
-
Fale conosco
Se você tiver dúvidas sobre operações de DDL, Fale conosco.