PolarDB for MySQL Cada especificação de cluster possui uma capacidade máxima de armazenamento. O espaço de armazenamento pode se esgotar devido ao crescimento contínuo de dados, logs e arquivos temporários, o que pode bloquear o cluster no modo de somente leitura e afetar as operações normais. Este tópico descreve a composição do espaço de armazenamento e apresenta métodos para visualizar o uso, limpar arquivos e recuperar espaço.
Composição do espaço de armazenamento
Ao compreender a composição do espaço de armazenamento do PolarDB for MySQL, você pode gerenciá-lo de forma eficaz, localizar problemas com precisão e adotar medidas de otimização adequadas.

Arquivos de dados: Armazenam seus dados de negócios, como tabelas e índices.
-
Arquivos de log: Incluem Binlog, Redo logs e Undo logs. Esses arquivos de log podem crescer rapidamente durante grandes transações ou operações de escrita com alta concorrência.
NotaPolarDB for MySQL O Binlog é desativado por padrão nos clusters do PolarDB for MySQL. O sistema utiliza um log físico mais eficiente (Redo Log) como substituto. Se o Binlog não estiver ativado no seu cluster, ignore esta seção.
Arquivos temporários: Gerados durante operações como classificação (ORDER BY), agrupamento (GROUP BY) ou consultas de junção (join). Grandes transações não confirmadas também geram arquivos temporários de cache do Binlog.
Arquivos de sistema: Armazenam componentes essenciais necessários para a operação do banco de dados, como dicionários de dados, informações de transação e buffers de doublewrite. O mecanismo InnoDB gerencia esses arquivos, que são críticos para a consistência dos dados e a recuperação do cluster. Você não pode modificá-los diretamente.
Visualizar o uso do espaço de armazenamento
Você pode visualizar o uso do espaço de armazenamento do seu cluster de duas maneiras:
-
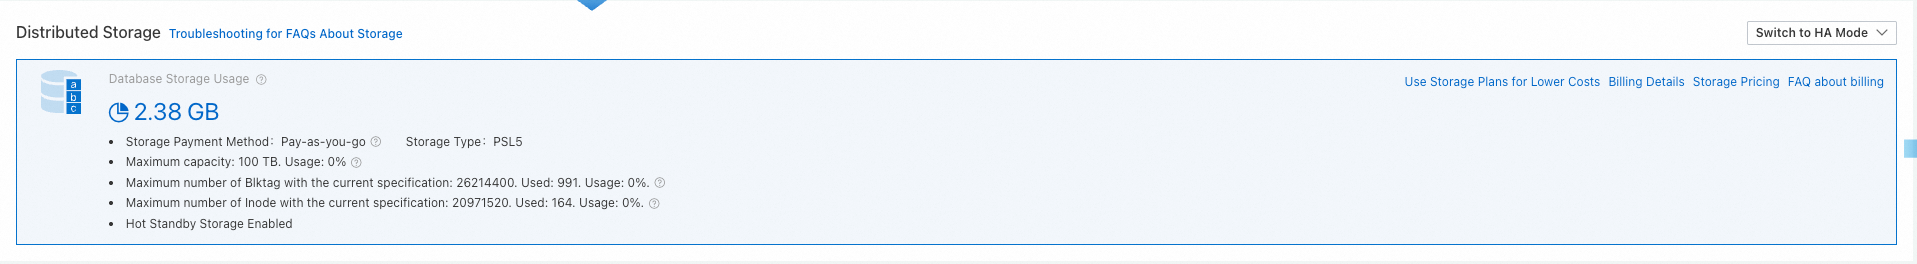
Acesse o PolarDB console, vá para a página Basic Information do cluster de destino e verifique a área Distributed Storage para visualizar a capacidade de armazenamento atual do cluster.
-
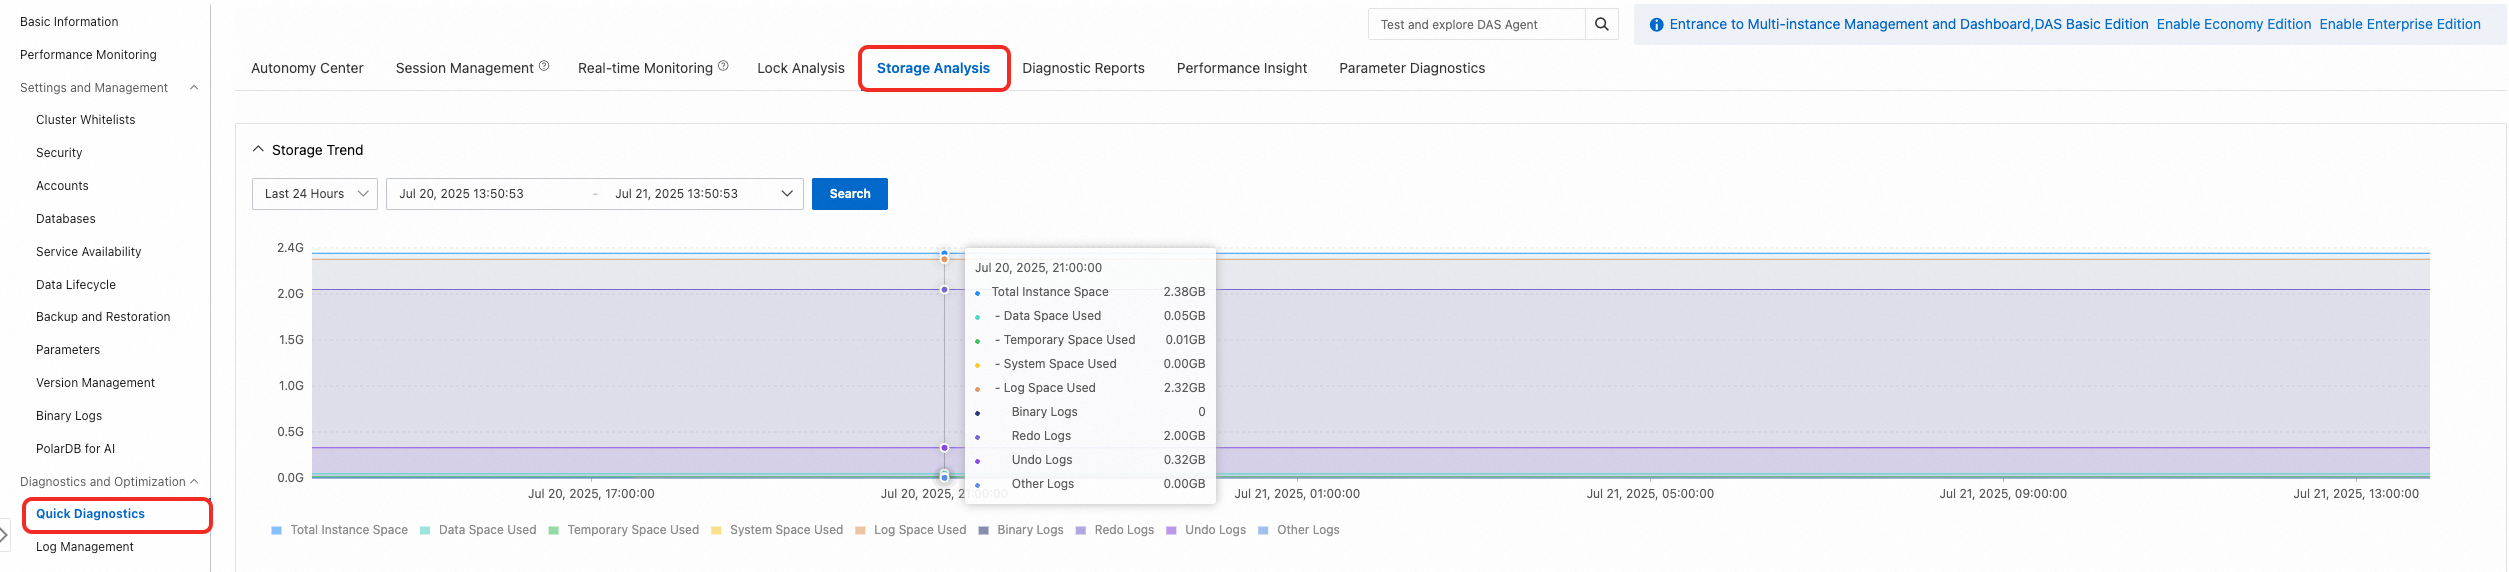
Acesse o PolarDB console, vá para a página do cluster de destino e verifique a aba Storage Analysis para visualizar o uso do espaço de armazenamento em um momento específico.
Limpar arquivos de dados e recuperar espaço de tabela
O espaço de armazenamento do PolarDB for MySQL pode ser consumido em excesso devido à falta de organização dos arquivos de dados por um longo período. Além disso, após usar o comando DELETE para excluir dados, o sistema apenas marca as posições dos registros ou páginas de dados como reutilizáveis, sem reduzir diretamente o tamanho do arquivo da tabela. Isso resulta em uma grande fragmentação de espaço, fazendo com que o armazenamento permaneça ocupado.
Ao limpar arquivos de dados, o console pode levar algum tempo para refletir as atualizações. Aguarde a conclusão do processo.
Limpar arquivos
Para tabelas que não são mais necessárias, use o comando TRUNCATE TABLE ou DROP TABLE para liberar imediatamente todo o espaço ocupado.
Faça backup dos seus dados antes de executar as operações para evitar perda de dados.
Recuperar espaço de tabela
Para tabelas com fragmentação significativa que você precisa manter, execute o comando OPTIMIZE TABLE durante horários de menor movimento. Essa operação reconstrói a tabela, elimina a fragmentação e recupera o espaço livre. Você também pode usar o ferramenta DMS para realizar essa otimização. O DMS oferece suporte a limitação de taxa, o que causa menos impacto nas cargas de trabalho de negócios, mas é executado de forma mais lenta.
Precauções
Quando a taxa de fragmentação da tabela de destino é baixa, a execução do comando
OPTIMIZE TABLEpode não reduzir significativamente o tamanho do tablespace. Verifique o campoinformation_schema.tablesna viewDATA_FREEpara conferir a taxa de fragmentação da tabela de destino.Ao executar o comando
OPTIMIZE TABLE, o sistema copia os dados da tabela para uma nova tabela temporária, o que aumenta temporariamente o uso do espaço de armazenamento do cluster.Para tabelas sem índices de texto completo, o sistema executa a instrução
OPTIMIZE TABLEusando Online DDL, que permite leituras e escritas simultâneas.A execução da operação
OPTIMIZE TABLEem tabelas grandes causa picos repentinos de uso de I/O e buffer, o que pode levar a bloqueios de tabela e contenção de recursos. Executar essa operação durante horários de pico pode causar indisponibilidade do cluster e lacunas de monitoramento. Recomendamos executar essa operação em horários de menor movimento.
Comparação de métodos
Escolha o método de recuperação adequado com base no seu cenário de negócios real.
|
Método |
Leituras/escritas simultâneas |
Velocidade |
Limitação de taxa |
Caso de uso |
|
Comando |
Sim |
Rápida |
Não |
Mais indicado para cargas de trabalho leves em que a eficiência de execução é prioridade. O comando |
|
Recuperação de espaço de tabela via DMS |
Sim |
Lenta |
Sim |
Recomendado quando a carga de trabalho do cluster é sensível e a velocidade de execução não é prioridade. A ferramenta DMS recupera o espaço da tabela com impacto mínimo nas operações de negócios. |
Procedimento
Recuperar espaço de tabela usando OPTIMIZE TABLE
Use o seguinte comando para recuperar o espaço da tabela.
kill [Session ID];[Database1]e[Database2]são nomes de bancos de dados, e[Table1]e[Table2]são nomes de tabelas.Ao executar o comando
OPTIMIZE TABLEno mecanismo InnoDB, o sistema retorna a mensagemTable does not support optimize, doing recreate + analyze instead. Essa é uma resposta normal. Ignore essa mensagem e confirme seokfoi retornado. Para mais informações sobre a instruçãoOPTIMIZE TABLE, consulte OPTIMIZE TABLE Statement.
Recuperação de espaço de tabela via DMS
Faça login no banco de dados: Acesse o PolarDB console, clique na página Basic Information do cluster de destino e clique no botão Log on to Database no canto superior direito para fazer login no cluster PolarDB for MySQL através do DMS.
Recupere o espaço da tabela: No painel de navegação à esquerda, selecione o ID do cluster de destino, clique duas vezes no banco de dados de destino, clique com o botão direito em qualquer nome de tabela e selecione Batch Operations On Tables. Na página de Operações em Lote em Tabelas, selecione as tabelas das quais deseja liberar espaço e clique em Table Maintenance>Optimize Table
Limpar arquivos de log
Os clusters PolarDB for MySQL podem gerar Binlog, Redo logs ou Undo logs rapidamente devido ao processamento de grandes transações, o que pode resultar em consumo excessivo de espaço de armazenamento ou armazenamento cheio. Nesse caso, recomendamos que você primeiro expanda a capacidade de armazenamento e, em seguida, investigue a causa da geração rápida de arquivos de log.
Ao limpar Binlog, Undo logs ou Redo logs, o console pode levar algum tempo para refletir as atualizações. Aguarde a conclusão do processo.
Binlog
Os clusters PolarDB for MySQL possuem o Binlog desativado por padrão e utilizam o log físico mais avançado (Redo Log) como substituto. Se o Binlog não estiver ativado no seu cluster, consulte as seções de limpeza de Redo log e Undo log.
Política de retenção
Os arquivos Binlog possuem as seguintes políticas de retenção:
-
Quando o Binlog está ativado, o sistema retém os arquivos por 3 dias por padrão e exclui automaticamente os arquivos com mais de 3 dias.
NotaPara clusters PolarDB for MySQL adquiridos antes de 23 de novembro de 2023, o período de retenção padrão do Binlog é de duas semanas (14 dias).
Para clusters PolarDB for MySQL adquiridos antes de 17 de janeiro de 2024, o período de retenção padrão do Binlog é de uma semana (7 dias).
-
Após a desativação do Binlog, o sistema retém os arquivos Binlog existentes por tempo indeterminado e não os exclui automaticamente.
NotaPara excluir arquivos Binlog, defina o parâmetro do período de retenção do Binlog (
loose_expire_logs_hoursoubinlog_expire_logs_seconds) com um valor baixo enquanto o Binlog estiver ativado. Após os arquivos expirarem e serem excluídos automaticamente, você poderá desativar o Binlog.
Modificar o período de retenção
A modificação do período de retenção do Binlog não causa interrupções de conexão nem requer a reinicialização do cluster.
Se a modificação do período de retenção resultar na purga de um grande volume de arquivos Binlog (por exemplo, 10 TB), podem ocorrer exceções de escrita no banco de dados a curto prazo durante o processo de purga. Portanto, quando os arquivos Binlog forem grandes, recomendamos realizar essa operação em horários de menor movimento e reduzir o período de retenção do Binlog em várias etapas, purgando uma parte dos dados do Binlog de cada vez.
Os arquivos Binlog purgados não podem ser recuperados após a exclusão.
Modifique o período de retenção do Binlog da seguinte forma:
MySQL 5.6: Modifique o parâmetro
loose_expire_logs_hours(intervalo de valores: 0 a 2376, em horas, valor padrão: 72) para definir o período de retenção do Binlog. O valor 0 significa que os arquivos Binlog não são excluídos automaticamente.MySQL 5.7MySQL 8.0: Modifique o parâmetro
binlog_expire_logs_seconds(intervalo de valores: 0 a 4294967295, em segundos, valor padrão: 259200) para definir o período de retenção do Binlog. O valor 0 significa que os arquivos Binlog não são excluídos automaticamente.
Limpar arquivos históricos
Após modificar o parâmetro do período de retenção do Binlog (loose_expire_logs_hours ou binlog_expire_logs_seconds), os arquivos Binlog históricos no cluster não são purgados imediatamente. Para purgar arquivos históricos, use um dos três métodos a seguir:
Aguarde a purga automática: Quando o último arquivo Binlog no cluster atinge o tamanho máximo de armazenamento (parâmetro
max_binlog_size), o sistema alterna para um novo arquivo Binlog e purga automaticamente esses arquivos Binlog históricos.Purga manual: Use uma conta privilegiada para executar o comando
flush binary logse acionar imediatamente a alternância de arquivo Binlog, purgando os arquivos Binlog expirados.Reinicie o cluster: Após a reinicialização do cluster, o sistema purga automaticamente os arquivos Binlog históricos.
Undo logs
Os Undo logs do PolarDB for MySQL servem como versões históricas no controle de concorrência multiversão (MVCC). Quando transações não confirmadas (seja em nós de somente leitura ou nós de leitura/escrita) mantêm views de leitura antigas, o sistema bloqueia o processo de limpeza do undo log, resultando em acúmulo contínuo de espaço.
Identificar e encerrar transações não confirmadas
Faça login no banco de dados: Acesse o PolarDB console, clique na página Basic Information do cluster de destino e clique no botão Log on to Database no canto superior direito para fazer login no cluster PolarDB for MySQL através do DMS.
-
Encontre transações não confirmadas: Execute o seguinte comando para verificar se há transações não confirmadas em execução prolongada.
kill [Session ID];Concentre-se em transações em que
trx_started(hora de início da transação) seja significativamente antigo, ou em quetrx_state(estado da transação) tenha permanecido no estadoRUNNINGpor um período prolongado. Anote o valor detrx_mysql_thread_id(ID da thread). -
Encerre a transação: Após confirmar que a ação não afetará seus negócios, execute o comando KILL para encerrar a transação de destino.
kill [Session ID];
Monitorar o progresso da limpeza
Após limpar as threads correspondentes às transações, verifique o progresso atual de Undo history. Se o comprimento de Undo history continuar crescendo rapidamente, ajuste o desempenho da limpeza em segundo plano (purga).
Quando a pressão de escrita é alta, a estratégia do PolarDB prioriza o desempenho de escrita atual. Isso pode fazer com que a limpeza do undo log sofra atrasos.
-
Monitore o progresso da limpeza: Execute o seguinte comando para observar o comprimento de
Undo history.kill [Session ID];Se o valor exceder 1 milhão ou continuar subindo ao longo de vários minutos enquanto a pressão atual estiver realmente alta, a velocidade de limpeza não conseguirá acompanhar a velocidade de escrita.
-
Ajuste os parâmetros de limpeza: Melhore a eficiência da limpeza.
Aumente o parâmetro
innodb_purge_batch_sizepara tornar cada lote de limpeza maior.-
Aumente o parâmetro
innodb_purge_threadspara adicionar mais threads de limpeza. Recomendamos definir esse valor como o número de núcleos de CPU na especificação do cluster.NotaEsta operação reinicia o cluster. Recomendamos realizá-la em horários de menor movimento.
Recuperar espaço ocupado
Depois que o comprimento de Undo history diminuir e estabilizar, se você quiser limpar o espaço ocupado pelos undo logs, ative o recurso Undo truncate.
Ative o recurso: Defina o parâmetro
innodb_undo_log_truncatecomo ON.Mecanismo de gatilho: O truncamento ocorre quando um único arquivo undo excede
innodb_max_undo_log_size, acionando oUndo truncate.Limitações de versão: Algumas versões anteriores possuem bugs conhecidos relacionados a
Undo truncate. Se a modificação deste parâmetro não for permitida no seu cluster, você precisará atualizar para a versão minor mais recente.Desative prontamente: Este recurso adiciona sobrecarga durante as alternâncias e reinicializações do cluster. Recomendamos definir este parâmetro de volta para OFF imediatamente após a conclusão da recuperação de espaço, especialmente antes de operações de manutenção, como um atualizar para a versão minor mais recente. Ative este recurso apenas quando necessário.
Redo logs
Os clusters PolarDB for MySQL utilizam Redo logs em vez de Binlog para a sincronização de dados entre o nó primário e os nós de somente leitura.
Sem backups de log, os Redo logs locais ocupam de 2 GB a 11 GB de espaço de armazenamento, com um máximo de 11 GB. Isso inclui 8 Redo logs no buffer pool (8 GB), o Redo log sendo escrito (1 GB), Redo logs pré-criados (1 GB) e o último Redo log (1 GB).
Com backups de log, o sistema retém os Redo logs locais por aproximadamente uma hora após a conclusão do backup. Se a velocidade de escrita for alta (por exemplo, excedendo 35 MB/s), pode ocorrer um acúmulo temporário de Redo logs.
Regras de limpeza
Os Redo logs não oferecem suporte a limpeza manual. O sistema os limpa automaticamente após a conclusão do backup de log, sem necessidade de intervenção manual.
Você pode ajustar o política de backup de logs do cluster PolarDB console (padrão: 7 dias) no console do PolarDB.
Limpar arquivos temporários
Os clusters PolarDB for MySQL podem gerar uma grande quantidade de arquivos temporários devido a consultas complexas ou grandes transações, resultando em consumo excessivo de armazenamento ou armazenamento cheio. Nesse caso, podem surgir mensagens de erro, como: error: 1114 The table '/home/mysql/log/tmp/#sqlxxx_xxx_xxx' is full
Resolva isso usando um dos seguintes métodos:
Encerrar sessões
Encerre sessões com uma grande quantidade de mensagens Copy to tmp table ou Sending data.
Faça login no banco de dados: Acesse o PolarDB console, clique na página Basic Information do cluster de destino e clique no botão Log on to Database no canto superior direito para fazer login no cluster PolarDB for MySQL através do DMS.
-
Visualize o status da sessão: Execute o seguinte comando para visualizar o status da sessão.
kill [Session ID]; Encontre a sessão de destino: No DMS, clique na coluna
Statenos resultados da consulta para classificar os dados e verifique se há um grande número de mensagensCopy to tmp tableouSending data. Anote o ID da sessão.-
Encerre as sessões: Execute o seguinte comando para encerrar a sessão de destino.
kill [Session ID];ImportanteAntes de encerrar uma sessão, certifique-se de que isso não afetará as operações de negócios em execução.
Se as etapas anteriores não liberarem espaço de armazenamento suficiente, você pode reiniciar cada nó do cluster para liberar o espaço de armazenamento ocupado por arquivos temporários.
Ajustar parâmetros
Acesse o PolarDB console, vá para a página e modifique os parâmetros tmp_table_size e max_heap_table_size para aumentar o tamanho do espaço de tabela temporária.