Ao gravar Binary Large Objects (BLOBs) em ambientes de alta concorrência, o MySQL frequentemente apresenta contenção de locks e gargalos no redo log. O PolarDB utiliza otimizações no nível do kernel para resolver a contenção de locks, a pressão de I/O e os problemas de gerenciamento de espaço durante a gravação de BLOBs. Essas otimizações melhoram significativamente o desempenho de DML e DDL, garantindo a execute estável e eficiente das suas cargas de trabalho em cenários de alta concorrência.
Visão geral
Um Binary Large Object (BLOB) é um tipo de campo de banco de dados usado para armazenar grandes volumes de dados, como imagens, documentos e textos longos. No mecanismo nativo InnoDB do MySQL, quando um campo BLOB em uma linha de dados excede um tamanho específico, ele é armazenado em páginas de dados separadas (off-page). Embora esse mecanismo lide bem com grandes volumes de dados, ele também introduz três principais desafios de desempenho:
Gargalo de gravação concorrente: a atualize de uma página de dados off-page aciona um lock pessimista, permitindo que apenas uma thread por vez grave BLOBs em uma tabela, o que limita severamente a concorrência.
Aumento abrupto da pressão de I/O: campos grandes geram redo logs volumosos. Se a capacidade de I/O do disco for insuficiente, o flush de logs se torna um gargalo e bloqueia as gravações em primeiro plano.
Recuperação de espaço atrasada: a limpeza de versões antigas de dados BLOB (Purge) é ineficiente, o que pode causar inchaço do espaço de armazenamento e degradação do desempenho.
A otimização de BLOB do PolarDB foi desenvolvida para resolver esses problemas. Ela otimiza todo o caminho de gravação, atualização e recuperação de BLOB no nível do kernel, sem alterar o uso do banco de dados.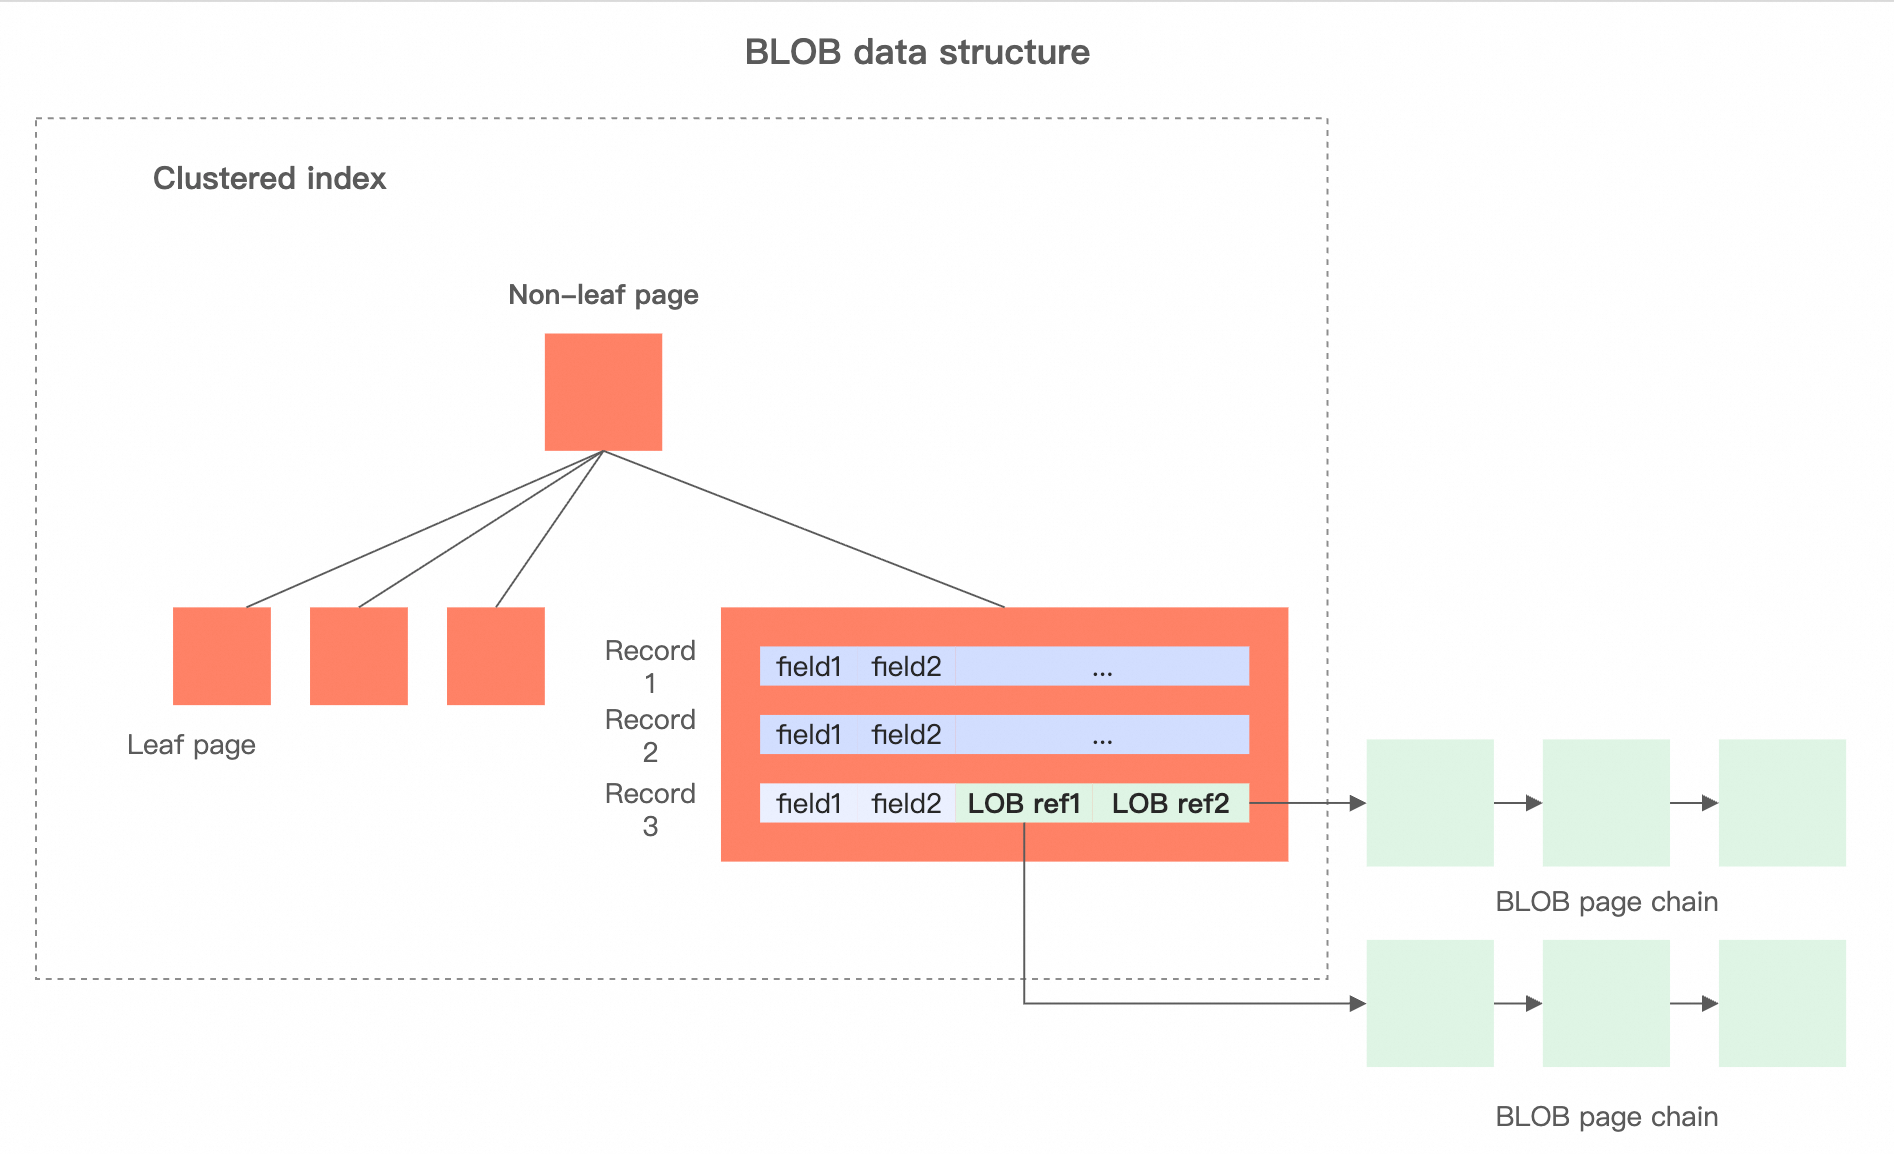
Faturamento
Os recursos de otimização de desempenho de BLOB estão integrados ao kernel do PolarDB e estão disponíveis sem custo adicional.
Otimizar o desempenho de gravação de BLOB
Ao encontrar gargalos de throughput de gravação ou alta latência de gravação concorrente em tabelas BLOB durante os horários de pico, a contenção de locks de gravação geralmente é a causa. O PolarDB fornece pré-alocação de páginas e otimização de latch de índice para resolver esse problema.
Otimização de pré-alocação de páginas
Essa otimização divide o processo de gravação de BLOB nas seguintes etapas:
Calcula e aloca todas as páginas de dados necessárias em um único lote.
Copia os dados em um estado sem locks, preenchendo as páginas recém-alocadas com o conteúdo do BLOB.
Anexa a cadeia resultante de páginas de dados ao registro de índice com uma única operação de lock otimista.
Durante todo o processo de gravação, apenas a fase inicial de alocação de espaço é mutuamente exclusiva. Outras operações demoradas, como a cópia de dados, podem ocorrer simultaneamente com outras gravações de BLOB. Além disso, como a cópia de dados ocorre fora da seção crítica, o sistema evita o risco de uma única gravação gerar dados de redo log suficientes para preencher o buffer e bloquear as gravações. Esse mecanismo minimiza o tempo de retenção do lock global, o que melhora significativamente a capacidade de gravação concorrente.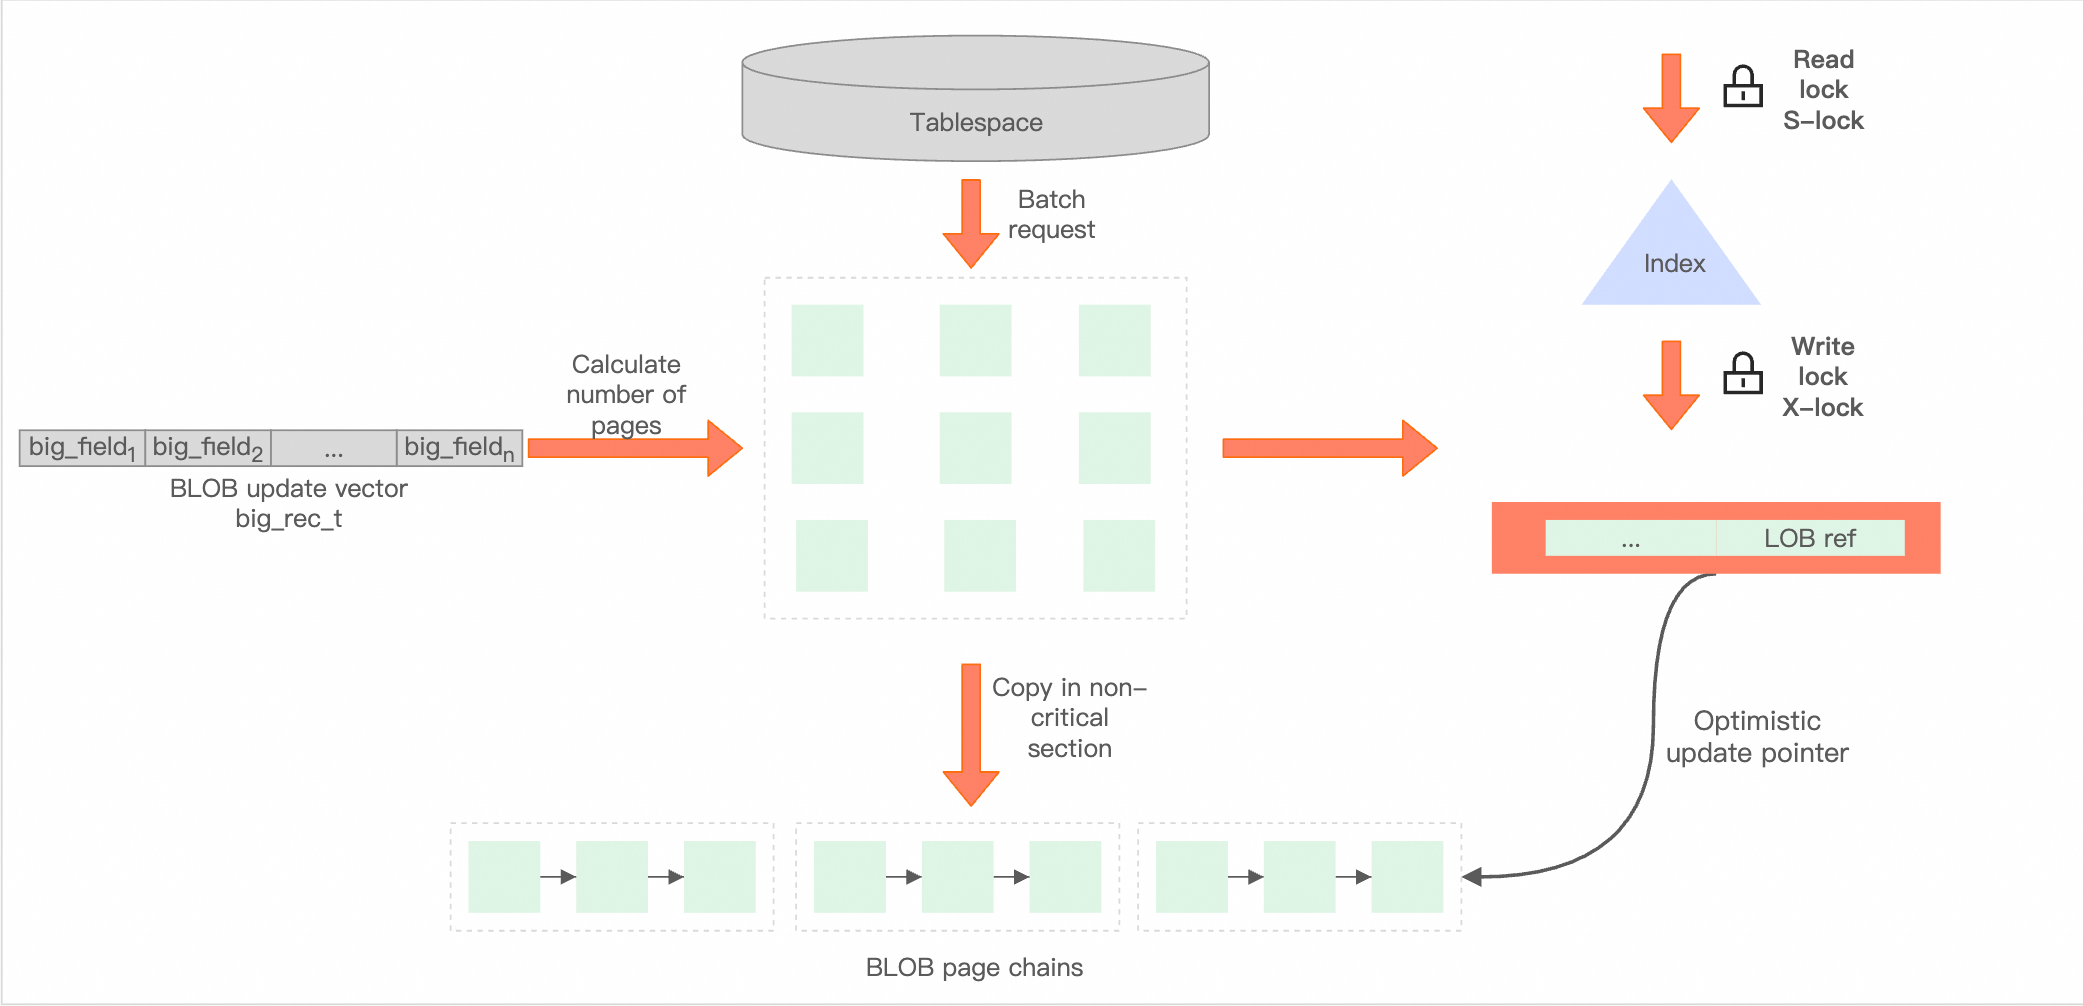
Otimização de latch de índice
Para tabelas com campos BLOB pequenos (menores que 8 KB) ou de tamanhos variados, o MySQL nativo frequentemente abandona o lock otimista prematuramente durante as atualizações devido a alterações na estrutura da página de índice, conhecidas como Split Merge Operations (SMOs). Em seguida, ele reverte para um modo de lock pessimista ineficiente, o que afeta severamente o desempenho concorrente. A otimização de latch resolve esse gargalo ao realizar mais trabalho no caminho otimista. Essa otimização funciona da seguinte forma:
Manter o caminho otimista: ao detectar uma possível atualize de campo BLOB, a lógica de otimização não muda imediatamente para o lock pessimista. Ela mantém um lock compartilhado (S-latch), com menor probabilidade de conflito, e permanece no caminho de atualize otimista.
Preparar e tentar a atualize: no caminho otimista, ela prepara a estrutura de dados BLOB necessária para a atualização e tenta modificar a página de índice diretamente.
-
Avaliar e confirmar ou reverter:
Sucesso: o registro atualizado atende aos requisitos de espaço da página de índice atual, portanto, a operação é concluída rapidamente no caminho otimista.
Falha: se a página não tiver espaço suficiente, a otimização abandona automaticamente a tentativa e reverte ao caminho de lock pessimista nativo do MySQL. Esse caminho conclui toda a atualize e garante a consistência dos dados.
A principal vantagem desse mecanismo de tentativa otimista é o aumento significativo da taxa de sucesso das atualize otimistas. Muitas operações que, de outra forma, reverteriam para o lock pessimista, são concluídas de maneira mais leve e eficiente, o que melhora muito o throughput para atualize de dados BLOB de tamanhos variados sob alta concorrência.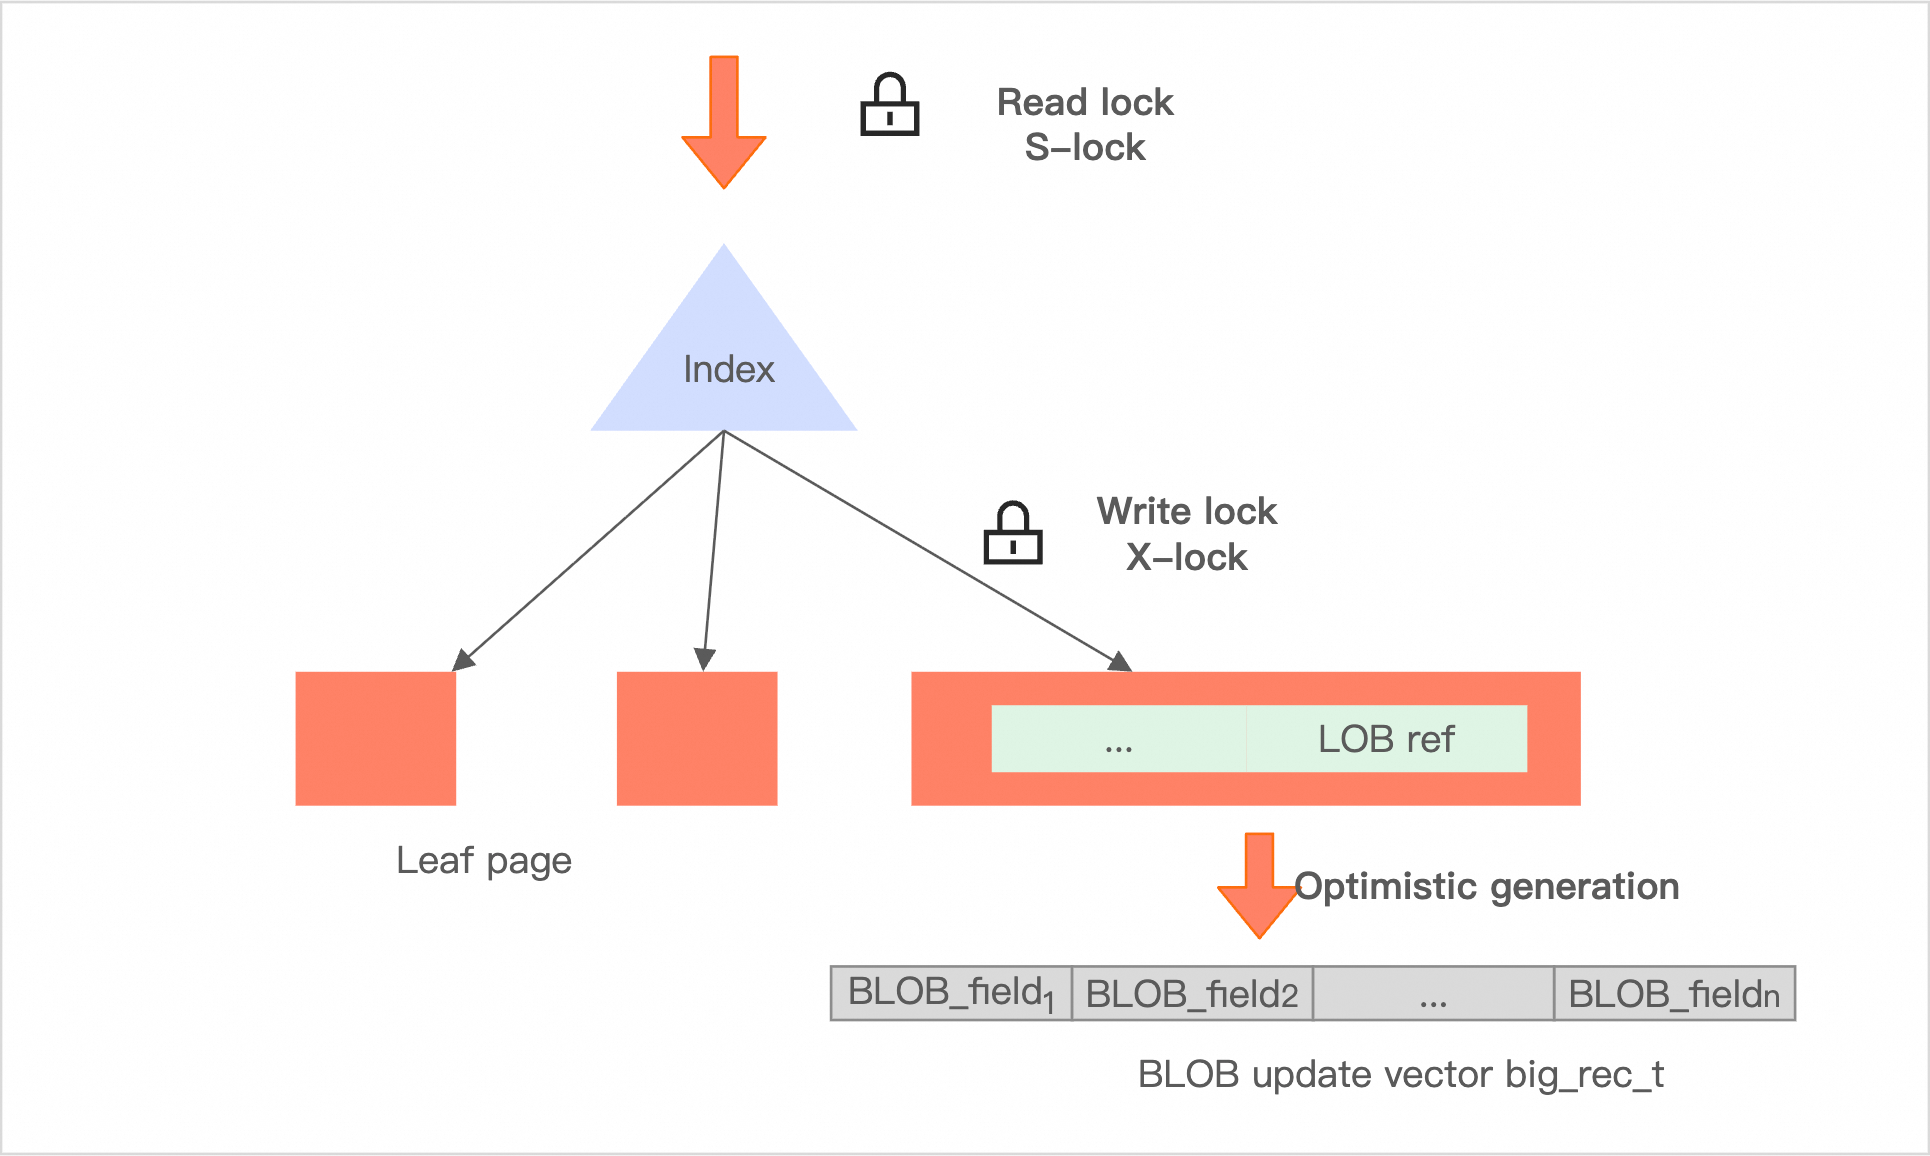
Ative as otimizações de gravação
No console do PolarDB, acesse a página para visualize e modifique os seguintes parâmetros e ativar essas otimizações:
Parâmetro | Descrição | Versões suportadas |
| Ativa ou desativa a otimização de pré-alocação de páginas BLOB. Valores válidos:
|
|
| Define o comprimento máximo de uma única coluna BLOB para a otimização de pré-alocação de páginas BLOB. | |
| Ativa ou desativa a otimização de latch de índice BLOB. |
Reduzir o volume de redo log nas gravações de BLOB
Se a sua carga de trabalho gravar grandes quantidades de dados BLOB, os redo logs podem ser gerados muito rapidamente e se tornar um gargalo de I/O no sistema. Ative a compactação de redo para aliviar a pressão.
A compactação de redo comprime os redo logs relacionados a BLOB em paralelo antes da gravação no buffer de log. Isso reduz significativamente o volume real de gravação de redo log, entre 40% e 60% em média nos testes, o que diminui a pressão de I/O no armazenamento e evita que um gargalo no módulo de redo afete o desempenho geral de gravação. Durante a recuperação de falhas, o banco de dados descompacta e aplica esses logs automaticamente.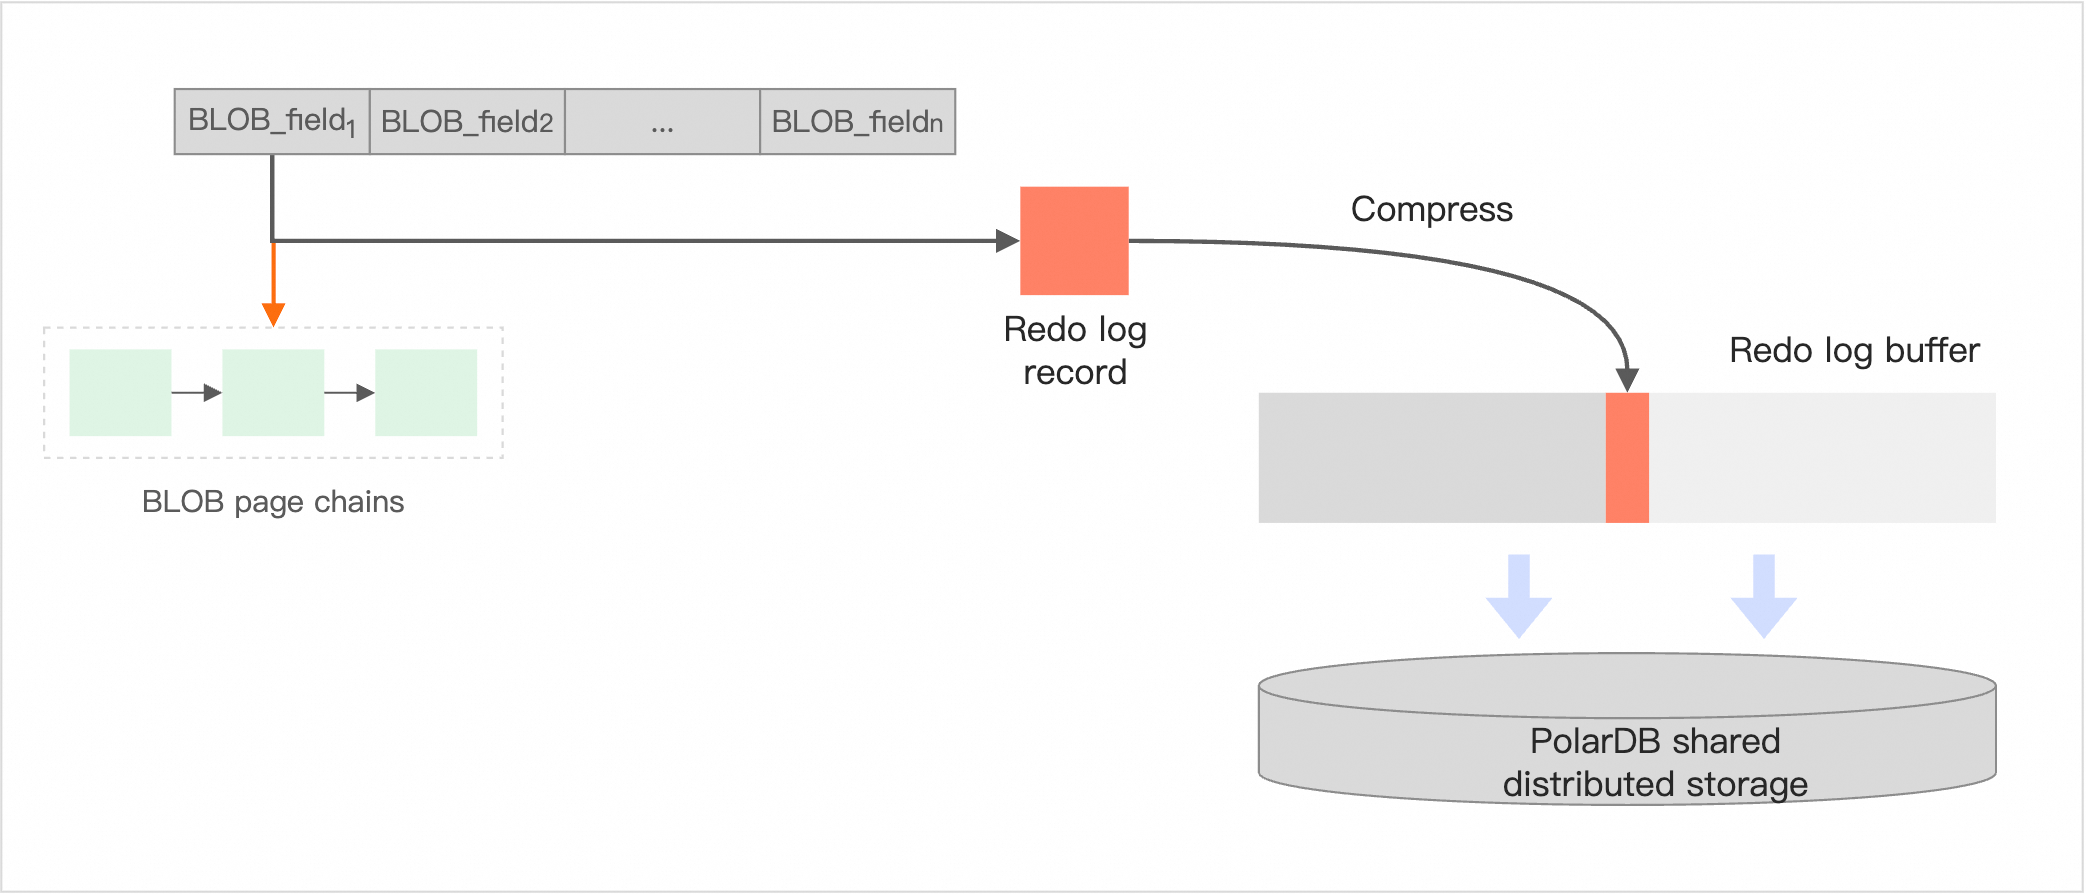
Ative a compactação de redo
No console do PolarDB, acesse a página para visualize e modifique os seguintes parâmetros e ativar esta otimização:
Parâmetro | Descrição | Versões suportadas |
| Define o algoritmo de compactação para redo logs BLOB. Valores válidos:
|
|
| Define o nível de compactação do algoritmo de compactação selecionado. Valores válidos: 0 a 9. Valor padrão: 6. |
Acelerar a recuperação de espaço de BLOB após exclua
Se a recuperação de tablespace for lenta e os arquivos continuarem crescendo após a exclua ou atualize frequente de dados BLOB, a causa raiz é a baixa eficiência do processo de Purge em segundo plano do MySQL nativo. Ao limpar os dados, esse processo primeiro retém locks centrais, como Index SX, antes de ler as páginas BLOB. Se uma página não estiver na memória, ocorre uma operação de I/O de disco demorada durante a retenção do lock, o que bloqueia outras operações concorrentes na tabela por um longo período. A otimização de pré-leitura de páginas do Purge do PolarDB resolve esse gargalo separando as operações de I/O do processo de bloqueio. Essa otimização funciona da seguinte forma:
Identificar páginas de destino: antes de adquirir locks e iniciar a limpeza, o processo de Purge identifica primeiro a cadeia completa de páginas BLOB off-page que devem ser recuperadas.
Pré-ler de forma assíncrona: o processo emite solicitações de I/O assíncronas para carregar as páginas de destino que ainda não estão na memória, a partir do disco, para o buffer pool.
Limpar rapidamente: após todas as páginas serem carregadas na memória, o processo de Purge adquire locks centrais, como
Index SX, e executa rapidamente as operações de liberação de página e modificação de metadados inteiramente na memória.
O mecanismo de pré-leitura de páginas do Purge evita principalmente que operações de I/O de disco ocorram na seção crítica durante a retenção dos locks. Ao antecipar as operações de I/O mais demoradas, ele reduz o tempo de retenção do lock apenas para as operações rápidas na memória. Isso melhora a eficiência da recuperação de dados BLOB e evita o inchaço do espaço. Mais importante ainda, reduz o impacto da limpeza em segundo plano sobre as cargas de trabalho em primeiro plano, como gravações de alta concorrência. Como resultado, melhora a concorrência e a estabilidade de todo o banco de dados.
Ative a pré-leitura do Purge
No console do PolarDB, acesse a página para visualize e modifique o seguinte parâmetro e ativar esta otimização:
Parâmetro | Descrição | Versões suportadas |
| Ativa ou desativa a otimização de pré-leitura de páginas durante o Purge de BLOBs. Valores válidos:
| Suportado em todas as versões. |
Melhorar a eficiência de execute de DDL
Ao precisar execute operações DDL, como ALTER TABLE, em tabelas com grandes quantidades de dados BLOB e as operações demorarem muito, ative as otimizações de BLOB relacionadas a DDL para reduzir significativamente o tempo da operação.
Otimização de pré-alocação de páginas: como as colunas de overflow de campos BLOB existem na chave primária, as operações DDL ao reconstruir a tabela principal também gravam campos BLOB. A pré-alocação de páginas usa um método de locking mais direto e simplificado para gravar dados BLOB, o que evita a sobrecarga de lidar com conflitos de concorrência complexos e melhora significativamente a eficiência da reconstrução.
Otimização de latch: como o DDL paralelo particiona a árvore de chave primária, várias threads de trabalho não operam na mesma página de dados. Essa otimização protege a alocação de novas páginas de forma independente, permitindo que outras operações ocorram simultaneamente, o que melhora a eficiência.
-
Otimização de redo:
Agregação de páginas: durante um bulk load, o sistema deixa de gerar uma entrada de redo log para cada registro. Em vez disso, após uma página de dados ficar cheia, ele grava as alterações em toda a página como um único grande registro de redo, o que melhora a eficiência da operação de redo.
Compactação de agregados: o sistema comprime esses grandes registros de redo agregados para reduzir ainda mais o volume de redo log durante as operações DDL.
Ative as otimizações de DDL
No console do PolarDB, acesse a página para visualize e modifique os seguintes parâmetros e ativar essas otimizações:
Alguns parâmetros na tabela a seguir não podem ser modificados manualmente. Para alterá-los, envie um ticket para entrar em contato conosco.
Parâmetro | Descrição | Versões suportadas |
| Define se a otimização de campos grandes será ativada durante operações DDL. Valores válidos:
|
|
| Define se a otimização de latch de índice será ativada durante operações DDL. Valores válidos:
|
|
| Define se a agregação de páginas de redo será ativada durante o bulk load de DDL. Valores válidos:
|
|
| Define o algoritmo de compactação de redo para bulk load de DDL. Valores válidos:
|
|
| Define o alvo para compactação de redo durante operações DDL. Valores válidos:
|
|
Otimizações de módulos relacionados
Em cargas de trabalho BLOB de alto throughput, também podem ocorrer gargalos em outros módulos. Para melhorar o desempenho, o PolarDB também combina as seguintes otimizações:
Gravações de redo assíncronas paralelas: o sistema fragmenta os dados no buffer de redo e usa várias threads para emitir tarefas de I/O assíncronas simultaneamente, o que aumenta significativamente o throughput de gravação de redo log (até 4 GB/s nos testes).
Otimização de extensão de arquivo: com base no sistema de arquivos distribuído desenvolvido pelo próprio PolarDB, uma operação de extensão de tablespace modifica apenas uma pequena quantidade de metadados, e a operação nativa de preenchimento de arquivo com zeros é eliminada. O tempo de extensão de arquivo e a sobrecarga de lock deixam de ser um gargalo.
Flush de páginas sujas sem locks: essa otimização usa a tecnologia de shadow page. Ao fazer o flush de uma página suja, o sistema primeiro cria uma cópia na memória, libera o lock da página e, em seguida, usa a cópia para a operação de I/O. Isso evita que as solicitações de gravação fiquem bloqueadas por um lock de página retido durante o flush.
Dados de testes de desempenho
Os dados a seguir mostram as melhorias de desempenho em cenários DML e DDL após a ativação da otimização de BLOB.
-
Desempenho de DML: em cenários de alta concorrência com tamanhos de linha de 100 KB e 200 KB, a otimização do PolarDB melhora o desempenho de INSERT e UPDATE em quase 3 vezes. Com a compactação de redo, o desempenho melhora de 4 a 5 vezes.


Desempenho de DDL: para uma tabela de 40 GB com campos BLOB, a ativação dessas otimizações aumenta a taxa de gravação de DDL em 5 a 6 vezes e reduz o tempo total em 84%.
