Seleciona automaticamente modelos ARIMA ideais para dados de séries temporais com base nos procedimentos de Gomez e Maravall (1998) e TRAMO (1996).
Como funciona
O componente seleciona o melhor modelo ARIMA em quatro etapas:
-
Estimativa do modelo padrão
Para
frequency = 1, o modelo padrão é(0,1,1).Para
frequency > 1, o modelo padrão é(0,1,1)(0,1,1).
Identificação da ordem de diferenciação: Se você especificar
diffeseasonalDiff, esta etapa será ignorada. Caso contrário, testes de raiz unitária determinam a ordem de diferenciação não sazonal d e a ordem de diferenciação sazonal D.Identificação da ordem ARMA: Seleciona o modelo mais adequado com base no Critério de Informação Bayesiano (BIC). Os parâmetros
maxOrderemaxSeasonalOrdercontrolam os limites superiores.Comparação de modelos e verificações finais: A estatística Q de Ljung-Box compara o modelo identificado com o modelo padrão. Se ambos forem inaceitáveis, o sistema recorre ao modelo
(3,d,1)(0,D,1).
Para obter mais informações sobre ARIMA, consulte Autoregressive integrated moving average.
Limitações
Executa apenas em recursos de computação do MaxCompute.
Limite de 1.200 registros de dados por grupo.
Apenas uma coluna numérica.
Cálculo de recursos
-
Sem groupColNames:
coreNum = 1 memSizePerCore = 4096 -
Com groupColNames:
  coreNum = floor(Total number of rows / 120,000)
  memSizePerCore = 4096
Configure o componente
Configure o x13_auto_arima de uma das seguintes maneiras:
Método 1: Configure no PAI console
Configure os parâmetros na página de pipeline do Machine Learning Designer.
Fields Setting
|
Parâmetro |
Obrigatório |
Descrição |
|
Time Series Column |
Sim |
Ordena os valores na coluna de valor. |
|
Value Column |
Sim |
Coluna numérica que contém os valores da série temporal. |
|
Stratification Column |
Não |
Separe várias colunas com vírgulas ( |
Parameters Setting
|
Parâmetro |
Descrição |
Padrão |
|
Start Date |
Formato: |
-- |
|
Series Frequency |
Número inteiro positivo no intervalo (0,12]. |
-- |
|
Maximum of p and q |
Número inteiro positivo no intervalo (0,4]. |
-- |
|
Maximum of Seasonal p and q |
Número no intervalo (0,2]. |
-- |
|
Maximum of Difference d |
Número inteiro positivo no intervalo (0,2]. |
-- |
|
Maximum of Seasonal Difference d |
Número inteiro positivo no intervalo (0,1]. |
-- |
|
Difference d |
Número inteiro positivo no intervalo (0,2]. Se você especificar |
-- |
|
Seasonal Difference d |
Número inteiro positivo no intervalo (0,1]. Se você especificar |
-- |
|
Prediction Entries |
Quantidade de previsões. Por exemplo, para prever vendas dos próximos 7 dias com base no mês anterior, defina este valor como |
-- |
|
Prediction Confidence Interval |
Nível de confiança para calcular intervalos de previsão. |
0.95 |
|
Tolerance |
Opcional. Tolerância de convergência para ajuste do modelo. |
1e-5 |
|
Maximum Iterations |
Número inteiro positivo. |
1500 |
Execution Tuning
|
Parâmetro |
Descrição |
|
Cores |
Número de núcleos. O sistema determina automaticamente por padrão. |
|
Memory Size |
Tamanho da memória por núcleo, em MB. |
Método 2: Configure com comandos PAI
Execute comandos PAI por meio de scripts SQL. Para obter mais informações, consulte SQL Script.
PAI -name x13_auto_arima
    -project algo_public
    -DinputTableName=pai_ft_x13_arima_input
    -DseqColName=id
    -DvalueColName=number
    -Dstart=1949.1
    -Dfrequency=12
    -DpredictStep=12
    -DoutputPredictTableName=pai_ft_x13_arima_out_predict2
    -DoutputDetailTableName=pai_ft_x13_arima_out_detail2
Referência de parâmetros
|
Parâmetro |
Obrigatório |
Descrição |
Padrão |
|
inputTableName |
Sim |
Nome da tabela de entrada. |
N/A |
|
inputTablePartitions |
Não |
Colunas de recursos selecionadas da tabela de entrada para treinamento do modelo. |
Tabela completa |
|
seqColName |
Sim |
Coluna de série temporal. Ordena os valores na coluna de valor. |
N/A |
|
valueColName |
Sim |
Coluna de valor. |
N/A |
|
groupColNames |
Não |
Colunas de estratificação. Separe várias colunas com vírgulas ( |
N/A |
|
start |
Não |
Hora de início da série temporal. Formato: |
1.1 |
|
frequency |
Não |
Frequência da série temporal. Número inteiro positivo no intervalo (0,12]. Um valor de 12 indica 12 meses (um ano). Para detalhes, consulte Formato de série temporal. |
12 |
|
maxOrder |
Não |
Valores máximos de p e q. Número inteiro positivo no intervalo [0,4]. |
2 |
|
maxSeasonalOrder |
Não |
Valores máximos de p e q sazonais. Número inteiro positivo no intervalo [0,2]. |
1 |
|
maxDiff |
Não |
Ordem máxima de diferenciação não sazonal d. Número inteiro positivo no intervalo [0,2]. |
2 |
|
maxSeasonalDiff |
Não |
Ordem máxima de diferenciação sazonal d. Número inteiro positivo no intervalo [0,1]. |
1 |
|
diff |
Não |
Ordem de diferenciação não sazonal d. Número inteiro positivo no intervalo [0,2]. Se você especificar |
-1 |
|
seasonalDiff |
Não |
Ordem de diferenciação sazonal d. Número inteiro positivo no intervalo [0,1]. Se você especificar |
-1 |
|
maxiter |
Não |
Número máximo de iterações. Número inteiro positivo. |
1500 |
|
tol |
Não |
Tolerância de convergência. Tipo DOUBLE. |
1e-5 |
|
predictStep |
Não |
Número de entradas de previsão. Número inteiro positivo no intervalo (0,365]. |
12 |
|
confidenceLevel |
Não |
Nível de confiança para intervalos de previsão. Número no intervalo (0,1). |
0.95 |
|
outputPredictTableName |
Sim |
Tabela de previsão de saída. |
N/A |
|
outputDetailTableName |
Sim |
Tabela de detalhes de saída. |
N/A |
|
outputTablePartition |
Não |
Indica se os dados devem ser exportados para uma partição. |
Não exporta dados para partições |
|
coreNum |
Não |
Número de núcleos. Número inteiro positivo. Usado com |
Determinado pelo sistema |
|
memSizePerCore |
Não |
Tamanho da memória por núcleo, em MB. Número inteiro positivo no intervalo [1024, 65536]. |
Determinado pelo sistema |
|
lifecycle |
Não |
Ciclo de vida da tabela de saída. |
N/A |
Formato de série temporal
Os parâmetros start e frequency definem duas dimensões temporais, ts1 e ts2, para a coluna numérica.
frequencyespecifica quantas unidades ts2 cabem em uma unidade ts1.startusa o formaton1.n2, indicando que a série começa no n2-ésimo ts2 do n1-ésimo ts1.
Configurações comuns:
|
Unidade de tempo |
ts1 |
ts2 |
frequency |
Exemplo de start |
|
12 meses/ano |
Ano |
Mês |
12 |
|
|
4 trimestres/ano |
Ano |
Trimestre |
4 |
|
|
7 dias/semana |
Semana |
Dia |
7 |
|
|
1 |
Qualquer unidade de tempo |
1 |
1 |
|
Exemplos de séries temporais
Dados: value = [1, 2, 3, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15]
start=1949.3, frequency=12 (dados mensais, 12 meses por ano)
A previsão começa em junho de 1950.
|
year |
Jan |
Feb |
Mar |
Apr |
May |
Jun |
Jul |
Aug |
Sep |
Oct |
Nov |
Dec |
|
1949 |
1 |
2 |
3 |
4 |
5 |
6 |
7 |
8 |
9 |
10 |
||
|
1950 |
11 |
12 |
13 |
14 |
15 |
start=1949.3, frequency=4 (dados trimestrais, 4 trimestres por ano)
A previsão começa no 2º trimestre de 1953.
|
year |
Qtr1 |
Qtr2 |
Qtr3 |
Qtr4 |
|
1949 |
1 |
2 |
||
|
1950 |
3 |
4 |
5 |
6 |
|
1951 |
7 |
8 |
9 |
10 |
|
1952 |
11 |
12 |
13 |
14 |
|
1953 |
15 |
start=1949.3, frequency=7 (dados diários, 7 dias por semana)
A previsão começa no quarto dia da 1951ª semana.
|
week |
Sun |
Mon |
Tue |
Wed |
Thu |
Fri |
Sat |
|
1949 |
1 |
2 |
3 |
4 |
5 |
||
|
1950 |
6 |
7 |
8 |
9 |
10 |
11 |
12 |
|
1951 |
13 |
14 |
15 |
start=1949.1, frequency=1 (dados não sazonais)
A previsão começa em 1963.
|
cycle |
p1 |
|
1949 |
1 |
|
1950 |
2 |
|
1951 |
3 |
|
1952 |
4 |
|
1953 |
5 |
|
1954 |
6 |
|
1955 |
7 |
|
1956 |
8 |
|
1957 |
9 |
|
1958 |
10 |
|
1959 |
11 |
|
1960 |
12 |
|
1961 |
13 |
|
1962 |
14 |
|
1963 |
15 |
Exemplos
Preparar dados de teste
Este exemplo utiliza o conjunto de dados AirPassengers.csv, que registra o número de passageiros de companhias aéreas internacionais por mês entre 1949 e 1960. Para obter mais informações sobre o conjunto de dados, consulte AirPassengers.
Dados de amostra:
|
id |
number |
|
1 |
112 |
|
2 |
118 |
|
3 |
132 |
|
4 |
129 |
|
5 |
121 |
|
... |
... |
Execute os seguintes comandos Tunnel no cliente MaxCompute para carregar os dados. Para obter informações sobre como instalar e configurar o cliente MaxCompute, consulte MaxCompute client (odpscmd). Para obter mais informações sobre comandos Tunnel, consulte Tunnel commands.
create table pai_ft_x13_arima_input(id bigint, number bigint);
tunnel upload xxx/airpassengers.csv pai_ft_x13_arima_input -h true;
Execute comandos PAI
Use o componente SQL script ou ODPS SQL para executar comandos PAI:
PAI -name x13_auto_arima
    -project algo_public
    -DinputTableName=pai_ft_x13_arima_input
    -DseqColName=id
    -DvalueColName=number
    -Dstart=1949.1
    -Dfrequency=12
    -DmaxOrder=4
    -DmaxSeasonalOrder=2
    -DmaxDiff=2
    -DmaxSeasonalDiff=1
    -DpredictStep=12
    -DoutputPredictTableName=pai_ft_x13_arima_auto_out_predict
    -DoutputDetailTableName=pai_ft_x13_arima_auto_out_detail
Saída
Tabela de previsão (outputPredictTableName)
|
Coluna |
Descrição |
|
pdate |
Data da previsão. |
|
forecast |
Conclusão da previsão. |
|
lower |
Limite inferior do intervalo de previsão no nível de confiança especificado. Padrão: 0.95. |
|
upper |
Limite superior do intervalo de previsão no nível de confiança especificado. Padrão: 0.95. |
Dados gerados:
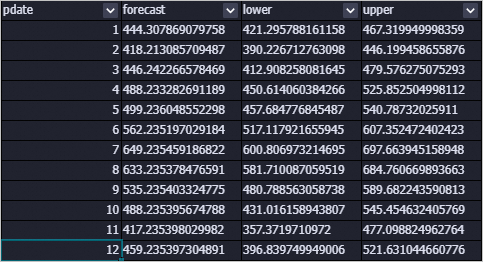
Tabela de detalhes (outputDetailTableName)
|
Coluna |
Descrição |
|
key |
Um dos seguintes: |
|
summary |
Detalhes de armazenamento da chave correspondente. |
Dados gerados:
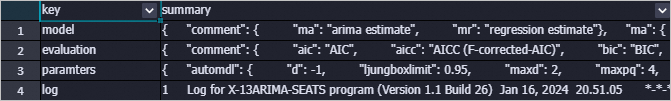
Perguntas frequentes
Por que todos os resultados de previsão têm o mesmo valor?
Isso ocorre quando o treinamento do modelo encontra uma exceção e recorre ao modelo de média, que gera a média dos dados de treinamento para todas as previsões. As causas comuns incluem instabilidade após a diferenciação, falha na convergência durante o treinamento ou variância igual a 0 nos dados de entrada.
Para diagnosticar o erro específico, verifique o arquivo stderr dos nós individuais no Logview.
Como escolha entre x13_arima e x13_auto_arima?
O x13_arima exige a especificação manual dos parâmetros p, d, q, sp, sd e sq. Se você não tiver certeza sobre quais valores usar, escolha o x13_auto_arima. Com o x13_auto_arima, defina apenas os limites superiores (como maxOrder e maxDiff), e o componente ajustará os parâmetros automaticamente.
Erro: O número de observações após a diferenciação é menor que o comprimento mínimo da série
ERROR: Number of observations after differencing and/or conditional AR estimation
is 9, which is less than the minimum series length required for the model estimated, 24
Os dados de treinamento são insuficientes para o modelo especificado. Modifique o parâmetro frequency ou adicione mais dados de treinamento.
Erro: A ordem do operador MA é muito grande
ERROR: Order of the MA operator is too largeEsse erro geralmente indica dados de treinamento insuficientes. Adicione mais pontos de dados à sua tabela de entrada.
Erro: A série deve ter pelo menos 3 anos completos de dados
ERROR: Series to be modelled and/or seasonally adjusted must have at least 3 complete
years of data
Quando parâmetros sazonais são especificados, os dados de entrada devem conter pelo menos três anos completos de observações.
Referências
O X-13ARIMA-SEATS é um algoritmo de modelo de média móvel integrada autorregressiva (ARIMA) com ajuste sazonal, baseado no algoritmo de código aberto X-13ARIMA-SEATS. Para o componente relacionado com parâmetros manuais, consulte x13_arima.