Fraudadores raramente agem sozinhos. Eles operam em redes, compartilhando contas, endereços, dispositivos e contatos. Sistemas tradicionais baseados em regras avaliam cada pessoa de forma independente e não detectam essas conexões ocultas. Algoritmos de grafo identificam fraudes ao analisar os relacionamentos entre as pessoas, e não apenas atributos individuais.
Este tutorial demonstra como usar o modelo de pipeline Financial Risk Management no PAI Designer para calcular uma pontuação de probabilidade de fraude para cada pessoa em uma rede de relacionamentos.
Como o pipeline detecta fraudes
O pipeline representa pessoas como vértices e seus relacionamentos como arestas. Cada aresta possui um valor count que mede a proximidade: quanto maior o valor, mais forte é o relacionamento.
Três componentes de algoritmo de grafo são executados em sequência:
Maximum Connected Subgraph — classifica as pessoas no grafo de relacionamentos em dois grupos e atribui um ID a cada grupo. Em seguida, junto com os componentes SQL Script e JOIN, remove pessoas não relacionadas ao encontrar o conjunto que contém o maior número de pessoas interligadas.
Single-Source Shortest Path — mede quantas pessoas Enoch precisa contatar para alcançar as pessoas desejadas. O campo de saída
distanceregistra essa contagem de saltos.Label Propagation Classification — propaga rótulos de fraude de casos conhecidos (Evan, um fraudador) pela rede. Os rótulos se espalham dos vértices rotulados para seus vértices adjacentes. O campo de saída
weightregistra a probabilidade de cada pessoa ser um fraudador.
Conjunto de dados
O pipeline utiliza um conjunto de dados de relacionamentos com os seguintes campos.
|
Campo |
Tipo |
Descrição |
|
|
STRING |
Vértice inicial de uma aresta. Representa o nome de uma pessoa. |
|
|
STRING |
Vértice final de uma aresta. Representa o nome de uma pessoa. |
|
|
DOUBLE |
Proximidade entre duas pessoas. Um valor maior indica um relacionamento mais próximo. |
A figura a seguir mostra os dados de exemplo usados no pipeline. 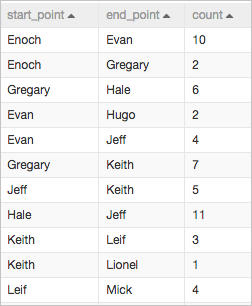
Pré-requisitos
Antes de começar, verifique se você tem:
Um workspace do PAI. Para instruções de configuração, consulte a documentação do PAI.
Acesso ao PAI console com permissões para usar o Designer.
Criação e execução do pipeline
Etapa 1: Abrir o Designer
Faça login no PAI console.
No painel de navegação à esquerda, clique em Workspaces. Na página Workspaces, clique no nome do seu workspace.
No painel de navegação à esquerda, escolha Model Training > Visualized Modeling (Designer).
Etapa 2: Criar o pipeline a partir de um modelo
Na página Visualized Modeling (Designer), clique na aba Preset Templates.
Localize o modelo Financial Risk Management e clique em Create.
Na caixa de diálogo Create Pipeline, revise os parâmetros. O parâmetro Data Storage define o caminho do bucket do Object Storage Service (OSS) onde o pipeline armazena dados temporários e modelos durante a execução. Os valores padrão funcionam para este tutorial.
Clique em OK. A criação do pipeline leva cerca de 10 segundos.
Na aba Pipelines, clique duas vezes no pipeline Financial Risk Management para abri-lo na tela.
A tela exibe o pipeline com três seções. 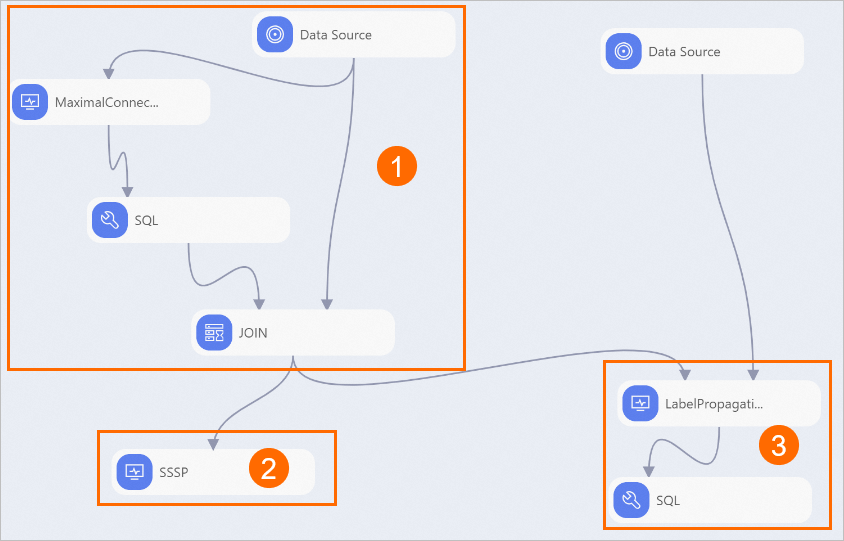
| Seção | Componentes | Finalidade |
|---|---|---|
| ① | Maximum Connected Subgraph → SQL Script → JOIN | Classifica as pessoas em dois grupos e atribui um ID a cada grupo. Em seguida, remove pessoas não relacionadas ao encontrar o conjunto com o maior número de pessoas interligadas. 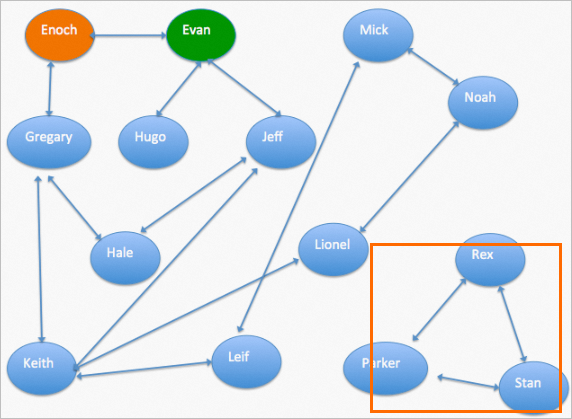 |
| ② | Single-Source Shortest Path | Calcula o número de pessoas que Enoch deve contatar para alcançar as pessoas desejadas. O campo distance na saída registra esse valor. A saída do componente Single-Source Shortest Path contém quatro colunas:
|
| ③ | Data Source → Label Propagation Classification → SQL Script | Importa dados rotulados (onde weight = probabilidade de fraude), propaga rótulos de fraude de fraudadores conhecidos pela rede até vértices adjacentes e filtra os resultados para mostrar a probabilidade de fraude de cada pessoa. 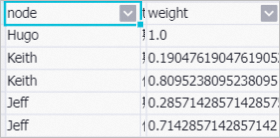 |
Etapa 3: Executar o pipeline e visualizar resultados
No canto superior esquerdo da tela, clique em
 para executar o pipeline.
Após a conclusão da execução, clique com o botão direito em SQL na tela e selecione View Data.
A tabela de saída lista as oito pessoas rotuladas como fraudadores — Leif, Evan, Mick, Noah, Hugo, Keith, Jeff e Lionel — juntamente com o valor weight que indica a probabilidade de cada pessoa ser um fraudador.
Por que algoritmos de grafo detectam fraudes que sistemas baseados em regras ignoram
A figura a seguir mostra um exemplo de grafo de relacionamentos. Setas representam relações como colegas de trabalho ou parentes. Neste grafo, Enoch é um cliente confiável e Evan é um fraudador. 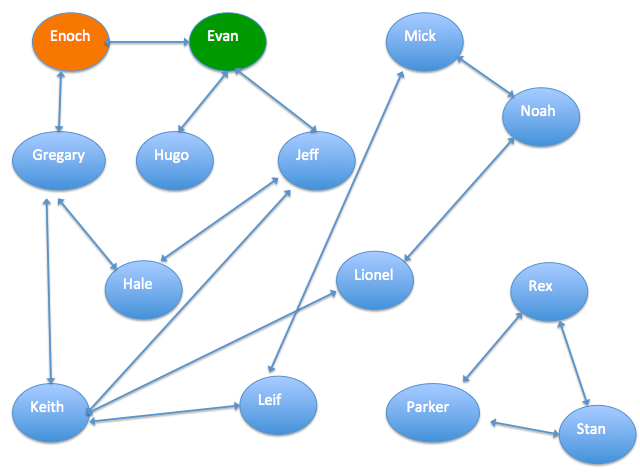
O Machine Learning Platform for AI (PAI) fornece vários componentes de algoritmo de grafo para análise de relacionamentos, incluindo K-Core, Maximum Connected Subgraph e Label Propagation Classification. Esses componentes analisam estruturas de relacionamento para revelar sinais de risco que modelos de nível individual não detectam.
Como funciona a propagação de rótulos: O Label Propagation Classification é um algoritmo de classificação semissupervisionado. Ele usa um grafo de relacionamentos e dados rotulados como entrada, e prevê os rótulos de vértices não rotulados com base nos rótulos dos vértices rotulados. A propagação de rótulos transfere o rótulo de cada vértice para os vértices adjacentes a ele.