A Recommendation Solution - Rank utiliza tabelas de features de usuário, features de item e comportamento do usuário processadas por engenharia de features. A solução gera um modelo de ranking para implantação. Este tópico descreve como implementar essa solução.
Pré-requisitos
Os conjuntos de dados necessários para o ranking são gerados ao executar o modelo de workflow Recommendation Solution - Feature Engineering. Para mais informações, consulte Feature engineering.
rec_sln_demo_user_table_preprocess_all_feature_v2
rec_sln_demo_item_table_preprocess_all_feature_v2
rec_sln_demo_behavior_table_preprocess_v2
Implementar o ranking
-
Acesse a página Machine Learning Designer.
Faça login no PAI console.
No painel de navegação à esquerda, clique em Workspaces. Na página Workspaces, clique no nome do workspace que você deseja gerenciar.
No painel de navegação à esquerda, escolha .
-
Construa o workflow.
Na página Machine Learning Designer, clique na aba Preset Templates.
Na lista de modelos, clique em Create abaixo de Recommendation Solution - Rank.
-
Na caixa de diálogo Create Workflow, configure os parâmetros. É possível utilizar os valores padrão.
Defina Workflow Data Storage como um caminho de Bucket OSS, usado para armazenar dados temporários e arquivos de modelo gerados pelo workflow. Esse caminho deve ser idêntico ao utilizado na engenharia de features.
Clique em OK. A criação do workflow leva cerca de dez segundos.
-
O sistema constrói automaticamente o workflow com base no modelo predefinido, conforme ilustrado na figura a seguir.
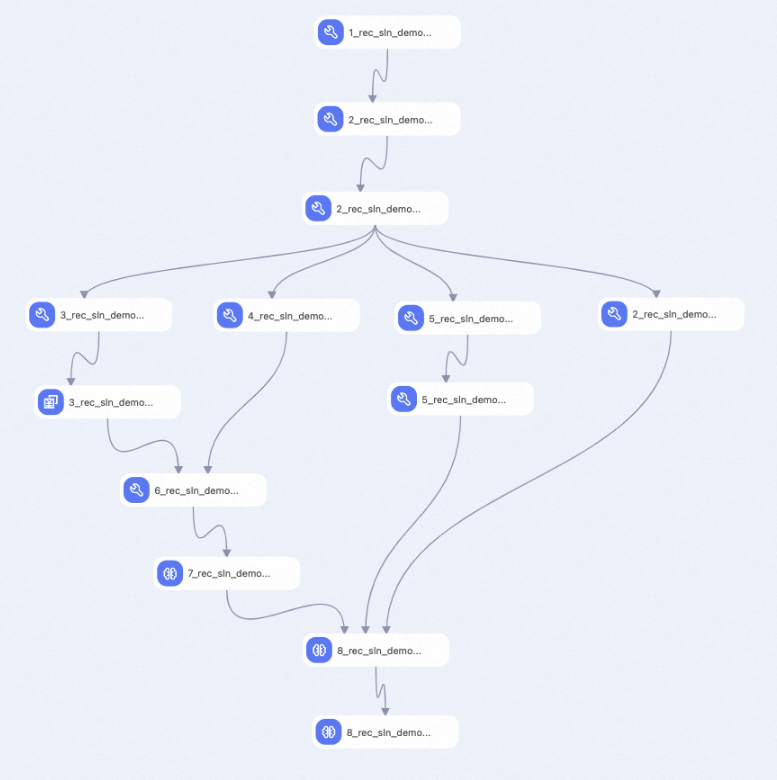
Número do Componente
Descrição
1
Amostra para o modelo de ranking.
2
Executa operações de geração de features (FG) na amostra com base no arquivo fg.json. Anexos: fg_on_odps-1.3.59-jar-with-dependencies.jar, rec_sln_demo_rec_sln_demo_sorting_fg_v1.json
3
Realiza binning de frequência igual para features numéricas. Os boundaries são utilizados na discretização dessas features.
4
Conta o número de valores únicos para features de enumeração. Essa contagem define o embedding_dim e o hash_bucket_size do modelo.
5
Embaralha os dados de amostra de 30 dias do modelo rec_sln_demo_sorting para formar as amostras de treinamento.
6
Agrega os resultados das tabelas rec_sln_demo_rec_sln_demo_sorting_30d_binning_v2 e rec_sln_demo_rec_sln_demo_sorting_30d_count_v2 para calcular as informações de configuração de features e etapas.
7
Preenche as informações de configuração no arquivo do EasyRec com base nos resultados de cálculo do componente 6. Anexo: rec_sln_demo_rec_sln_demo_sorting_v1_template.config
NotaEste nó precisa ser executado apenas uma vez.
8
Para treinar o modelo, execute primeiro o componente 7 para gerar o arquivo de configuração do EasyRec. Anexo: fg.json
Instruções
Leia o conteúdo em inglês para compreender O QUE precisa ser comunicado
Escreva o português brasileiro DO ZERO — esqueça a estrutura das frases em inglês
Preserve toda a formatação markdown, blocos de código, links e imagens exatamente como estão
Copie os placeholders xref (
{XREF_N}) literalmente, sem traduzir ou modificarAplique rigorosamente todas as regras específicas do idioma
Aplique as regras de stopwords com tolerância zero
Utilize o modo imperativo em passos numerados e listas procedimentais
Garanta consistência terminológica — o mesmo termo deve ter a mesma tradução em todo o documento
Varie os inícios de frase em listas e tabelas — nenhum início deve se repetir 3 vezes ou mais
Retorne APENAS o documento markdown em português brasileiro, sem explicações