A análise de justiça identifica vieses em modelos de IA e previne resultados injustos baseados em atributos como sexo ou raça. Ao integrar o responsible-ai-toolbox no PAI DSW, você avalia como o desempenho do modelo varia entre diferentes características sensíveis.
Como funciona
A análise de justiça identifica e corrige vieses em sistemas de IA para garantir que fatores irrelevantes não influenciem as decisões. Os princípios fundamentais são:
Evitar viés: Identifique e reduza vieses nos dados e algoritmos para impedir que os sistemas de IA produzam decisões injustas com base em atributos pessoais, como sexo, raça ou idade.
Dados representativos: Treine modelos de IA com conjuntos de dados representativos que reflitam com precisão todos os grupos de usuários e evitem a marginalização de minorias.
Transparência e explicabilidade: Aumente a transparência dos sistemas de IA por meio de técnicas de IA explicável para ajudar usuários e tomadores de decisão a compreender os motivos das previsões específicas do modelo.
Monitoramento e avaliação contínuos: Monitore e avalie regularmente os sistemas de IA para detectar e corrigir vieses que surjam ao longo do tempo.
Diversidade e inclusão: Incorpore perspectivas diversas no design e desenvolvimento de sistemas de IA para assegurar que os problemas sejam considerados sob múltiplas origens e pontos de vista.
Conformidade e ética: Siga regulamentações e padrões éticos para garantir que as aplicações de IA não causem danos ou injustiças.
O exemplo a seguir avalia a justiça de um modelo de previsão de renda considerando sexo e raça. O modelo prevê se a renda anual excede US$ 50 mil. Este tópico demonstra como utilizar o responsible-ai-toolbox para análise de justiça no PAI DSW.
Pré-requisitos
-
Uma instância do DSW. Caso não possua uma, consulte Crie uma instância do DSW. Configuração recomendada:
Tipo de instância: ecs.gn6v-c8g1.2xlarge
Imagem: Python 3.9 ou superior. Este tópico utiliza a seguinte imagem oficial: tensorflow-pytorch-develop:2.14-pytorch2.1-gpu-py311-cu118-ubuntu22.04
Framework do modelo: O responsible-ai-toolbox oferece suporte a modelos de regressão e classificação binária criados com scikit-learn, PyTorch e TensorFlow.
Conjunto de dados de treinamento: Use seu próprio conjunto de dados. Para usar o conjunto de dados de exemplo, siga Etapa 3: Prepare o conjunto de dados.
Modelo treinado: Use seu próprio modelo. Para usar o modelo de exemplo, siga Etapa 5: Treine o modelo.
Etapa 1: Abrir a Galeria do DSW
Faça login no PAI console.
No canto superior esquerdo, selecione uma região.
No painel de navegação à esquerda, escolha QuickStart > Notebook Gallery. Pesquise por Responsible AI - Fairness Analysis e clique em Open in DSW no cartão correspondente.
Selecione uma instância do DSW e clique em Open Notebook. O notebook Responsible AI - Fairness Analysis será aberto.
Etapa 2: Instalar dependências
Instale o pacote responsible-ai-toolbox (raiwidgets) para avaliação de justiça.
!pip install raiwidgets==0.34.1Etapa 3: Preparar o conjunto de dados
Execute o script abaixo para carregar o conjunto de dados OpenML 1590 utilizado no exemplo deste tópico.
from raiutils.common.retries import retry_function
from sklearn.datasets import fetch_openml

class FetchOpenml(object):
    def __init__(self):
        pass
    # Fetch the OpenML dataset with data_id = 1590
    def fetch(self):
        return fetch_openml(data_id=1590, as_frame=True)

fetcher = FetchOpenml()
action_name = "Dataset download"
err_msg = "Failed to download openml dataset"
max_retries = 5
retry_delay = 60
data = retry_function(fetcher.fetch, action_name, err_msg,
                      max_retries=max_retries,
                      retry_delay=retry_delay)
Você também pode carregar seu próprio conjunto de dados. O código a seguir carrega um arquivo CSV:
import pandas as pd

# Load your own dataset in CSV format
# Use pandas to read the CSV file
data = pd.read_csv(filename)
Etapa 4: Pré-processar os dados
Obter variáveis de características e a variável alvo
A variável alvo representa o resultado real que o modelo prevê. As variáveis de características correspondem a todas as outras variáveis presentes em cada instância de dados. Neste exemplo:
class: Indica se a renda anual excede US$ 50 mil
sex: Gênero
race: Raça
age: Idade
Execute o script a seguir para carregar as variáveis de características em X_raw e visualize as cinco primeiras linhas:
# Get the feature variables, excluding the target variable.
X_raw = data.data
# Display the first 5 rows of feature variables, excluding the target variable.
X_raw.head(5)
Execute o script abaixo para codificar a variável alvo e visualize sua distribuição. O valor 1 indica renda >US$ 50 mil, enquanto 0 indica renda <=US$ 50 mil.
from sklearn.preprocessing import LabelEncoder

# Convert the target variable to a binary classification target
# data.target is the target variable "class"
y_true = (data.target == '>50K') * 1
y_true = LabelEncoder().fit_transform(y_true)

import matplotlib.pyplot as plt
import numpy as np

# View the distribution of the target variable
counts = np.bincount(y_true)
classes = ['<=50K', '>50K']
plt.bar(classes, counts)
Identificar características sensíveis
Execute o script a seguir para definir sexo e raça como características sensíveis e visualize os dados. O responsible-ai-toolbox avalia se as previsões do modelo apresentam viés em relação a essas características sensíveis. Na prática, defina as características sensíveis conforme os requisitos do seu negócio.
# Define "sex" and "race" as sensitive attributes
# First, select the columns related to sensitive attributes from the dataset to form a new DataFrame `sensitive_features`
sensitive_features = X_raw[['sex','race']]
sensitive_features.head(5)
Execute o script abaixo para remover as características sensíveis de X_raw e visualize o resultado:
# Remove the sensitive features from the feature variables
X = X_raw.drop(labels=['sex', 'race'],axis = 1)
X.head(5)
Codificar e escalar características
Execute o script a seguir para aplicar codificação one-hot e escalonamento de características, convertendo os dados para um formato adequado ao responsible-ai-toolbox.
import pandas as pd
from sklearn.preprocessing import StandardScaler

# One-hot encoding
X = pd.get_dummies(X)

# Perform feature scaling on the dataset X
sc = StandardScaler()
X_scaled = sc.fit_transform(X)
X_scaled = pd.DataFrame(X_scaled, columns=X.columns)

X_scaled.head(5)
Dividir dados de treinamento e teste
Execute o script a seguir para destinar 20% dos dados ao conjunto de teste e os 80% restantes ao conjunto de treinamento.
from sklearn.model_selection import train_test_split

# Split the feature variables X and target variable y into training and test sets according to the `test_size` ratio
X_train, X_test, y_train, y_test = \
    train_test_split(X_scaled, y_true, test_size=0.2, random_state=0, stratify=y_true)

# Use the same random seed to split the sensitive features into training and test sets, ensuring consistency with the above split
sensitive_features_train, sensitive_features_test = \
    train_test_split(sensitive_features, test_size=0.2, random_state=0, stratify=y_true)
Verifique o tamanho de cada conjunto de dados:
print("Training set size:", len(X_train))
print("Test set size:", len(X_test))
Redefina os índices de ambos os conjuntos de dados:
# Reset the DataFrame index to avoid index errors
X_train = X_train.reset_index(drop=True)
sensitive_features_train = sensitive_features_train.reset_index(drop=True)
X_test = X_test.reset_index(drop=True)
sensitive_features_test = sensitive_features_test.reset_index(drop=True)
Etapa 5: Treinar o modelo
O exemplo abaixo utiliza o scikit-learn para treinar um modelo de regressão logística com os dados de treinamento.
scikit-learn
from sklearn.linear_model import LogisticRegression

# Create a logistic regression model
sk_model = LogisticRegression(solver='liblinear', fit_intercept=True)
# Train the model
sk_model.fit(X_train, y_train)
PyTorch
import torch
import torch.nn as nn
import torch.optim as optim

# Define logistic regression model
class LogisticRegression(nn.Module):
    def __init__(self, input_size):
        super(LogisticRegression, self).__init__()
        self.linear = nn.Linear(input_size, 1)

    def forward(self, x):
        outputs = torch.sigmoid(self.linear(x))
        return outputs

# Instantiate the model
input_size = X_train.shape[1]
pt_model = LogisticRegression(input_size)

# Loss function and optimizer
criterion = nn.BCELoss()
optimizer = optim.SGD(pt_model.parameters(), lr=5e-5)

# Train the model
num_epochs = 1
X_train_pt = X_train
y_train_pt = y_train
for epoch in range(num_epochs):
    # Forward pass
    # Convert DataFrame to Tensor
    if isinstance(X_train_pt, pd.DataFrame):
        X_train_pt = torch.tensor(X_train_pt.values)
        X_train_pt = X_train_pt.float()
    outputs = pt_model(X_train_pt)
    outputs = outputs.squeeze()
    # Convert ndarray to Tensor
    if isinstance(y_train_pt, np.ndarray):
        y_train_pt = torch.from_numpy(y_train_pt)
        y_train_pt = y_train_pt.float()
    loss = criterion(outputs, y_train_pt)

    # Backward pass and optimization
    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
TensorFlow
import tensorflow as tf
from tensorflow.keras import layers

# Define the logistic regression model
tf_model = tf.keras.Sequential([
    layers.Dense(units=1, input_shape=(X_train.shape[-1],), activation='sigmoid')
])

# Compile the model using binary cross-entropy loss and stochastic gradient descent optimizer
tf_model.compile(optimizer='sgd', loss='binary_crossentropy', metrics=['accuracy'])

# Train the model
tf_model.fit(X_train, y_train, epochs=1, batch_size=32, verbose=0)
Etapa 6: Avaliar o modelo
Use o Fairness Dashboard do responsible-ai-toolbox para gerar previsões no conjunto de teste e produzir um relatório de avaliação de justiça.
O Fairness Dashboard agrupa previsões e resultados reais pelos valores das características sensíveis. Ele compara os resultados previstos e reais entre os grupos para revelar como o desempenho do modelo varia.
Por exemplo, com a característica sensível "sex", o Fairness Dashboard classifica as previsões (y_pred) e os resultados reais (y_test) por sexo, calculando e comparando a taxa de seleção, acurácia e outras métricas para "Male" e "Female".
O exemplo a seguir avalia o modelo scikit-learn:
scikit-learn
from raiwidgets import FairnessDashboard
import os
from urllib.parse import urlparse
# Generate prediction results on the test dataset
y_pred_sk = sk_model.predict(X_test)

# Use responsible-ai-toolbox to compute data information for each sensitive group
metric_frame_sk = FairnessDashboard(sensitive_features=sensitive_features_test,
                  y_true=y_test,
                  y_pred=y_pred_sk, locale = 'zh-Hans')

# Set the URL redirect link
metric_frame_sk.config['baseUrl'] =  'https://{}-proxy-{}.dsw-gateway-{}.data.aliyuncs.com'.format(
    os.environ.get('JUPYTER_NAME').replace("dsw-",""),
    urlparse(metric_frame_sk.config['baseUrl']).port,
    os.environ.get('dsw_region') )
print(metric_frame_sk.config['baseUrl'])
PyTorch
from raiwidgets import FairnessDashboard
import torch
import os
from urllib.parse import urlparse
# Test the model and evaluate fairness
pt_model.eval()  # Set model to evaluation mode
X_test_pt = X_test
with torch.no_grad():
    X_test_pt = torch.tensor(X_test_pt.values)
    X_test_pt = X_test_pt.float()
    y_pred_pt = pt_model(X_test_pt).numpy()

# Use responsible-ai-toolbox to compute metrics for each sensitive group
metric_frame_pt = FairnessDashboard(sensitive_features=sensitive_features_test,
                           y_true=y_test,
                           y_pred=y_pred_pt.flatten().round(),locale='zh-Hans')

# Set the URL redirect link
metric_frame_pt.config['baseUrl'] =  'https://{}-proxy-{}.dsw-gateway-{}.data.aliyuncs.com'.format(
    os.environ.get('JUPYTER_NAME').replace("dsw-",""),
    urlparse(metric_frame_pt.config['baseUrl']).port,
    os.environ.get('dsw_region') )
print(metric_frame_pt.config['baseUrl'])
TensorFlow
from raiwidgets import FairnessDashboard
import os
from urllib.parse import urlparse
# Test the model and evaluate fairness
y_pred_tf = tf_model.predict(X_test).flatten()

# Use responsible-ai-toolbox to compute data information for each sensitive group
metric_frame_tf = FairnessDashboard(
                           sensitive_features=sensitive_features_test,
                           y_true=y_test,
                           y_pred=y_pred_tf.round(),locale='zh-Hans')

# Set the URL redirect link
metric_frame_tf.config['baseUrl'] =  'https://{}-proxy-{}.dsw-gateway-{}.data.aliyuncs.com'.format(
    os.environ.get('JUPYTER_NAME').replace("dsw-",""),
    urlparse(metric_frame_tf.config['baseUrl']).port,
    os.environ.get('dsw_region') )
print(metric_frame_tf.config['baseUrl'])
Parâmetros principais:
sensitive_features: Os atributos sensíveis.
y_true: Os resultados reais do conjunto de teste.
y_pred: As previsões do modelo.
locale (opcional): O idioma de exibição do painel de avaliação. Suporta chinês simplificado ("zh-Hans") e chinês tradicional ("zh-Hant"). O padrão é inglês ("en").
Etapa 7: Visualizar o relatório de avaliação
Após a conclusão da avaliação, clique na URL para visualizar o relatório completo.
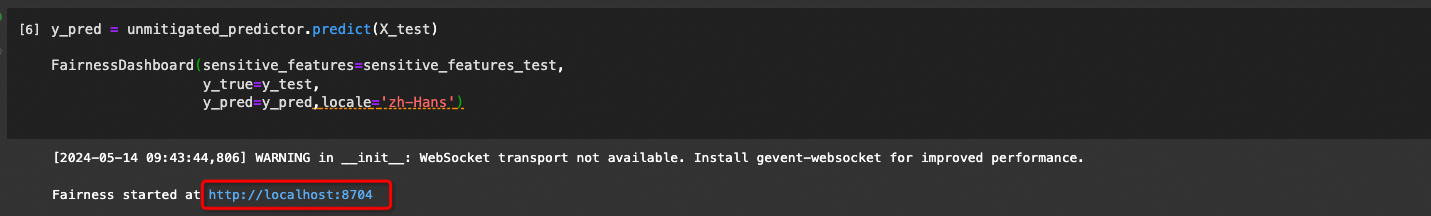
Caso a página de avaliação fique travada em "Calculating", consulte FAQ para obter uma solução.
Na página do Fairness dashboard, clique em Get Started. Configure a característica sensível, a métrica de desempenho e a métrica de justiça conforme descrito abaixo para comparar as métricas do modelo entre os grupos de características sensíveis.
Característica sensível: sex
Característica sensível: sex
Métrica de desempenho: Accuracy
Métrica de justiça: Demographic parity difference
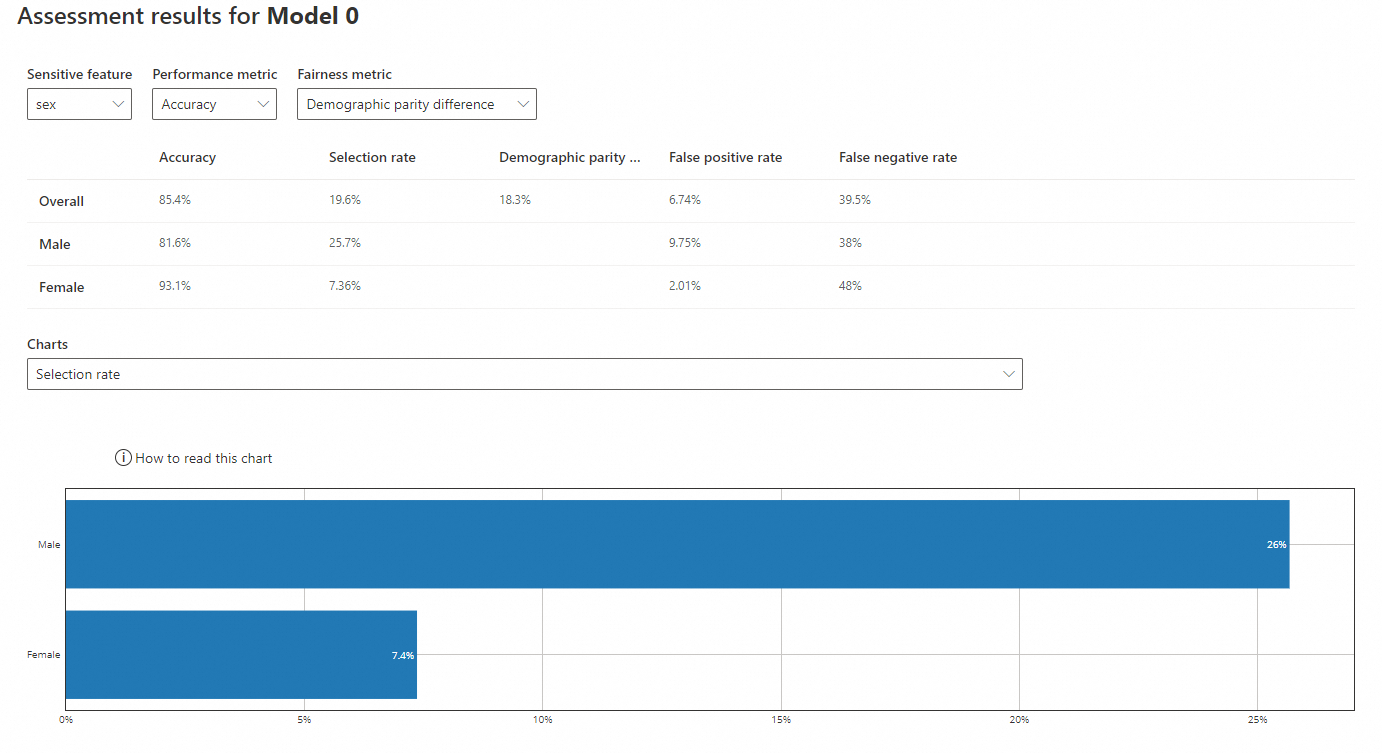
Accuracy: A proporção de amostras previstas corretamente em relação ao total. O modelo prevê a renda masculina com 81,6% de acurácia e a feminina com 93,1%. Ambos os valores estão próximos da acurácia geral de 85,4%.
Selection rate: A probabilidade de o modelo prever o resultado favorável (renda >US$ 50 mil). O modelo prevê uma taxa de seleção de 25,7% para homens e 7,36% para mulheres. A taxa feminina está muito abaixo da taxa geral de 19,6%.
Demographic parity difference: A diferença na probabilidade de receber uma previsão positiva entre os grupos protegidos. Um valor mais próximo de 0 indica menos viés entre os grupos. A diferença geral de paridade demográfica é de 18,3%.
Característica sensível: race
Característica sensível: race
Métrica de desempenho: Accuracy
Métrica de justiça: Demographic parity difference
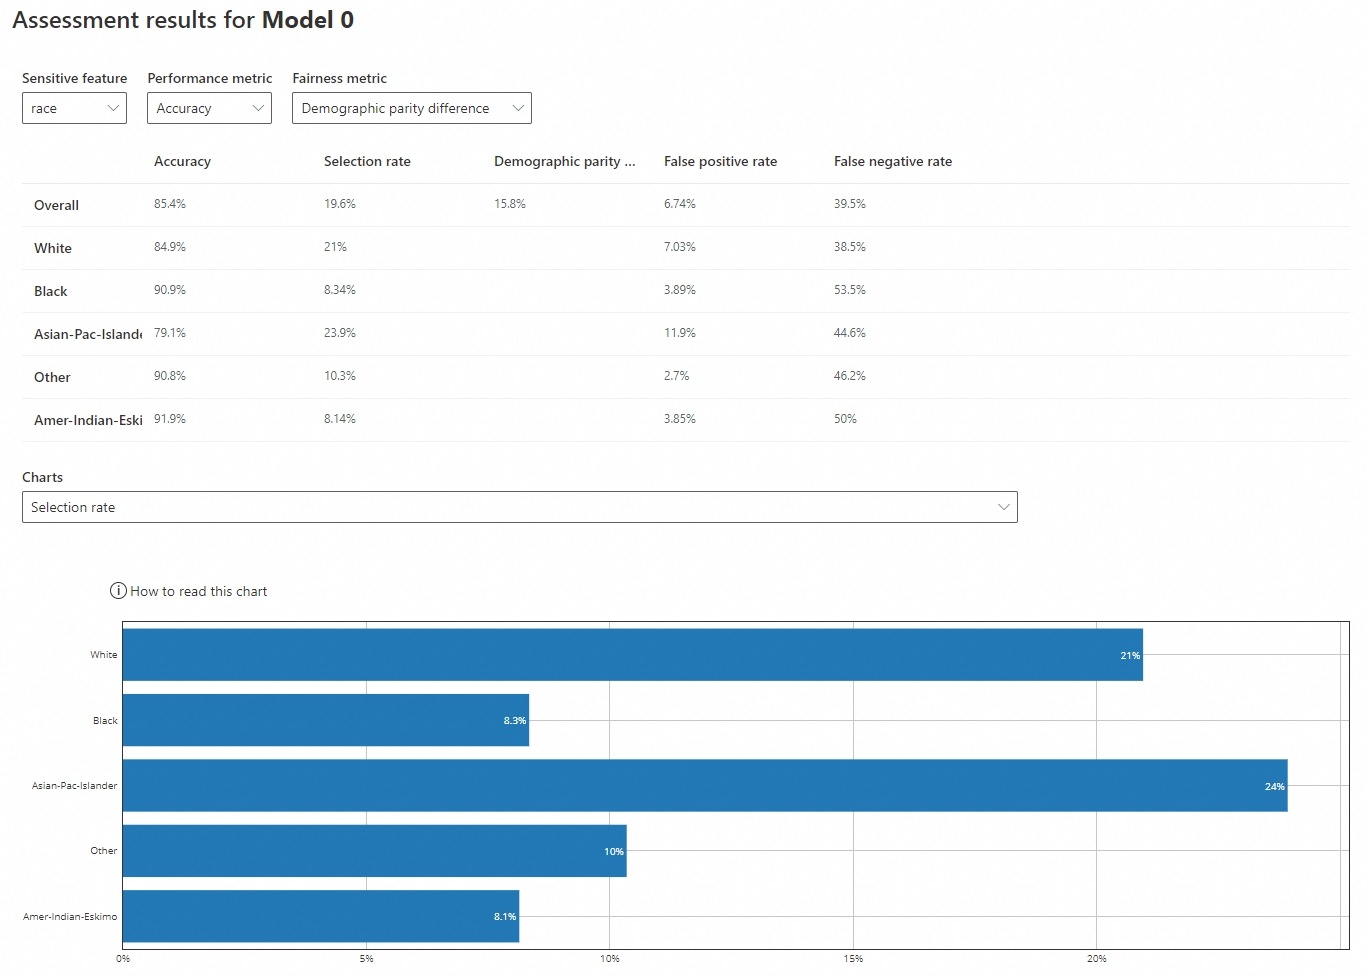
Accuracy: A proporção de amostras previstas corretamente em relação ao total. O modelo prevê a renda para "White" e "Asian-Pac-Islander" com 84,9% e 79,1% de acurácia, respectivamente, em comparação a 90,9%, 90,8% e 91,9% para "Black", "Other" e "Amer-Indian-Eskimo". Todas as acurácias dos grupos estão próximas da acurácia geral de 85,4%.
Selection rate: A probabilidade de o modelo prever o resultado favorável (renda >US$ 50 mil). As taxas de seleção para "White" (21%) e "Asian-Pac-Islander" (23,9%) são maiores do que para "Black" (8,34%), "Other" (10,3%) e "Amer-Indian-Eskimo" (8,14%). Essas taxas menores estão bem abaixo da taxa de seleção geral de 19,6%.
Demographic parity difference: A diferença na probabilidade de receber uma previsão positiva entre os grupos protegidos. Um valor mais próximo de 0 indica menos viés entre os grupos. A diferença geral de paridade demográfica é de 15,8%.
Perguntas frequentes
P: O que fazer se o Fairness Dashboard ficar travado em "Calculating"?
No ambiente DSW, o Fairness Dashboard pode travar em "Calculating" porque solicitações de origem cruzada não carregam credenciais de autenticação. Para resolver isso, abra o console do navegador (pressione F12 e mude para a aba Console) na página inicial e execute o código a seguir:
const _fetch = window.fetch;
window.fetch = function(url, opts = {}) {
  if (String(url).includes('/metrics') || String(url).includes(location.host)) {
    opts.credentials = 'include';
  }
  return _fetch.call(this, url, opts);
};