Introdução
Em 6 de março, a Alibaba Cloud disponibilizou como open source o QwQ-32B, um modelo de inferência da família Qwen. Baseado em aprendizado por reforço em larga escala, ele oferece ganhos expressivos em matemática, programação e capacidades gerais. Seu desempenho geral é comparável ao do DeepSeek-R1, com redução significativa nos custos de implantação.
Nos benchmarks AIME24 (matemática) e LiveCodeBench (programação), o QwQ-32B apresenta desempenho equivalente ao DeepSeek-R1 e supera consideravelmente o o1-mini e modelos destilados do R1 de tamanho similar.
No LiveBench (o "ranking de avaliação de LLMs mais difícil", liderado pelo cientista-chefe da Meta, Yann LeCun), no IFEval para seguimento de instruções (proposto pelo Google, entre outros) e no teste BFCL para precisão em chamadas de função (proposto pela UC Berkeley, entre outros), o QwQ-32B obtém pontuações superiores às do DeepSeek-R1.
O QwQ-32B integra capacidades de agente, permitindo pensar criticamente durante o uso de ferramentas e ajustar seu processo de raciocínio com base no feedback do ambiente.
A PAI-Model Gallery agora oferece suporte completo para implantação com um clique, ajuste fino e avaliação do QwQ-32B. A implantação requer uma GPU com 96 GB de memória. Versões quantizadas, como QwQ-32B-GGUF e QwQ-32B-AWQ, também são compatíveis e podem ser implantadas em GPUs de menor custo, como uma única placa A10.
Implantação do modelo
-
Acesse a página da PAI-Model Gallery.
Faça login no PAI console e selecione uma região no canto superior esquerdo. Alterne entre as regiões para localizar os recursos de computação disponíveis.
No painel de navegação à esquerda, escolha Workspaces e clique em nome de um workspace para acessá-lo.
No painel de navegação à esquerda, escolha QuickStart > Model Gallery.
Na página da PAI-Model Gallery, localize o cartão do modelo QwQ-32B e clique em nele para abrir a página de detalhes do modelo.
-
Clique em Deploy no canto superior direito. Selecione um framework de implantação, configure um nome para o service de inferência e especifique os recursos para a implantação. Essa ação implanta o modelo no Elastic Algorithm Service (EAS). A plataforma suporta diversos frameworks de implantação, incluindo SGLang, vLLM e BladeLLM (um framework de inferência de alto desempenho desenvolvido pela PAI).
Para o método de implantação, selecione Single-Node - Standard Instance ou Single-Node - GP7V Instance. Para criar o service, crie um New Service ou faça o Update Existing Service, configurando seu grupo e tags. Os tipos de recurso suportados incluem Public Resources, EAS Resource Group e Resource Quota.
-
Utilize o service de inferência. Após a conclusão da implantação, acesse a página do service e clique em View Call Information para obter o endpoint e o token. Para aprender a chamar o service, clique em link do modelo pré-treinado para retornar à página de detalhes do modelo e visualize as instruções.
Durante a criação do service, clique em View Deployment Events ao lado do campo Status para monitorar o progresso da implantação. A mensagem de status exibe
Waiting task server to be ready.Também é possível depurar o service do modelo QwQ-32B implantado online no Elastic Algorithm Service (EAS).
Na página Online Debugging, selecione a aba Chat. O método HTTP é POST e o caminho da requisição é
/api/predict/quickstart_qwq32b/v1/chat/completions. No exemplo JSON do Body,modelestá definido comoQwQ-32B,messagescontémrole: userecontent: Please introduce yourself, emax_tokensestá definido como1024. Ao clicar em Send Request, o sistema retorna um código de status 200, o corpo da resposta contém um resultado de inferência do tipochat.completione o conteúdo da função assistente inclui um processo de raciocínio delimitado pelas tags<think>.
Ajuste fino do modelo
A PAI-Model Gallery fornece um algoritmo de ajuste fino supervisionado (SFT) para o QwQ-32B. Com suporte a ajuste LoRA e ajuste de parâmetros completos, você pode ajustar o modelo imediatamente, sem configurações complexas.
-
Prepare os dados de treinamento. O algoritmo SFT aceita conjuntos de dados de treinamento em formatos como JSONL. Para mais informações sobre os requisitos de formato, consulte a documentação do modelo. Abaixo está um exemplo de conjunto de dados de treinamento no formato JSONL:
{"messages": [{"role": "system", "content": "You are a helpful and harmless assistant."}, {"role": "user", "content": "Who are you?"}, {"role": "assistant", "content": "I am Xiaopai, an AI assistant trained by PAI. My goal is to provide users with useful, accurate, and timely information and to help them communicate effectively in various ways. How can I help you?"}]} {"messages": [{"role": "system", "content": "You are a helpful and harmless assistant."}, {"role": "user", "content": "Who are you!"}, {"role": "assistant", "content": "Hello! I am an AI language model developed by PAI, named Xiaopai. I can answer your questions, provide information, engage in conversation, and help you solve problems. If you have any questions or need assistance, please feel free to let me know!"}]} -
Configure os parâmetros de treinamento. Após preparar os dados, faça o upload deles para um bucket no Object Storage Service (OSS). Como o modelo 32B é grande, o algoritmo exige recursos de GPU com pelo menos 96 GB de memória. Verifique se sua cota de recursos oferece recursos de computação suficientes.
O algoritmo suporta os hiperparâmetros listados abaixo. Ajuste-os conforme seu conjunto de dados e recursos de computação ou utilize os valores padrão.
Parâmetro
Descrição
Mais informações
learning_rate
Taxa de aprendizado, que controla a magnitude dos ajustes nos pesos do modelo.
Uma taxa muito alta pode causar instabilidade no treinamento, com o valor da perda oscilando excessivamente e falhando em convergir. Uma taxa muito baixa faz a perda diminuir lentamente, exigindo muito tempo para convergir. Uma taxa adequada permite que o modelo convirja para uma solução ótima de forma rápida e estável.
num_train_epochs
Número de passagens completas pelo conjunto de dados de treinamento.
Poucas épocas podem causar underfitting, enquanto muitas podem causar overfitting. Se o tamanho da amostra for pequeno, aumente o número de épocas para evitar underfitting. Uma taxa de aprendizado menor geralmente exige mais épocas.
per_device_train_batch_size
Quantidade de amostras processadas por cada GPU em uma única iteração de treinamento.
Um batch size maior aumenta a velocidade de treinamento, mas também eleva a demanda de memória da GPU. O batch size ideal é geralmente o valor máximo que não causa estouro de memória da GPU. Verifique o uso de memória da GPU na página de monitoramento da tarefa, nos detalhes do treinamento.
gradient_accumulation_steps
Número de etapas de acumulação de gradiente.
Um batch size pequeno aumenta a variância da estimativa do gradiente, afetando a velocidade de convergência. A acumulação de gradiente permite que o modelo atualize os pesos após acumular gradientes de um número especificado de batches. Garanta que
gradient_accumulation_stepsseja um múltiplo do número de GPUs.max_length
Comprimento máximo de tokens dos dados de entrada processados pelo modelo em uma única etapa de treinamento.
Um tokenizador processa os dados de treinamento para gerar uma sequência de tokens. Utilize uma ferramenta de estimativa de tokens para calcular o comprimento do texto nos seus dados de treinamento.
lora_rank
Dimensão do LoRA.
lora_alpha
Peso do LoRA.
Fator de escala do LoRA, geralmente definido como
lora_rank * 2.lora_dropout
Taxa de dropout para o treinamento LoRA. Ajuda a prevenir overfitting desativando neurônios aleatoriamente durante o treinamento.
lorap_lr_ratio
Razão da taxa de aprendizado do LoRA+ (λ = ηB/ηA), onde ηA e ηB são as taxas de aprendizado para as matrizes adaptadoras A e B, respectivamente.
Em comparação ao LoRA, o LoRA+ alcança melhor desempenho e ajuste fino mais rápido usando taxas de aprendizado diferentes para partes essenciais do processo, sem aumentar os requisitos computacionais. Quando
lorap_lr_ratioé definido como 0, o treinamento usa o LoRA padrão em vez do LoRA+.advanced_settings
Além dos parâmetros acima, personalize outros parâmetros neste campo usando o formato
--key1 value1 --key2 value2. Se não for necessário, deixe este campo em branco.-
save_strategy: Estratégia de salvamento de checkpoints do modelo. As opções sãosteps,epocheno. Padrão:steps. -
save_steps: Intervalo de salvamento do modelo. Padrão: 500. -
save_total_limit: Número máximo de checkpoints a serem salvos. O sistema exclui checkpoints mais antigos para permanecer dentro desse limite. Padrão: 2. SeNone, o sistema salva todos os checkpoints. -
warmup_ratio: Hiperparâmetro que controla a fase de aquecimento da taxa de aprendizado. Nessa fase inicial, a taxa aumenta gradualmente de um valor pequeno até seu valor inicial definido. Owarmup_ratiodetermina a proporção dessa fase em relação a todo o processo de treinamento. Padrão: 0.
-
Clique em botão Train para iniciar o treinamento. Visualize o status e os logs da tarefa de treinamento. Também é possível implantar o modelo ajustado como um service online.
Avaliação do modelo
A PAI-Model Gallery inclui algoritmos de avaliação integrados, permitindo avaliar modelos pré-treinados e ajustados prontamente. A avaliação ajuda a mensurar o desempenho do modelo e suporta comparações lado a lado para auxiliar na escolha do modelo mais adequado ao seu caso de uso.
Inicie a avaliação do modelo a partir de dois locais:
|
Avaliar um modelo pré-treinado diretamente |
Na página de detalhes do modelo na PAI-Model Gallery, clique em botão Evaluate no canto superior direito. |
|
Avaliar um modelo ajustado a partir da página de detalhes da tarefa de treinamento |
Clique em botão Evaluate no canto superior direito. |
A avaliação do modelo suporta conjuntos de dados personalizados e públicos.
Na página New Evaluation Task, clique em Switch to professional mode ao lado do título da página para entrar no modo profissional, que suporta recursos avançados como avaliação por modelo juiz. No formulário, configure os parâmetros Task Name, Model, Output Path, Dataset Source, Resource Type, Resource Group Type, Resource Configuration Method, Task Resources, VPC Configuration e Internet gateway.
-
Avaliação com conjunto de dados personalizado
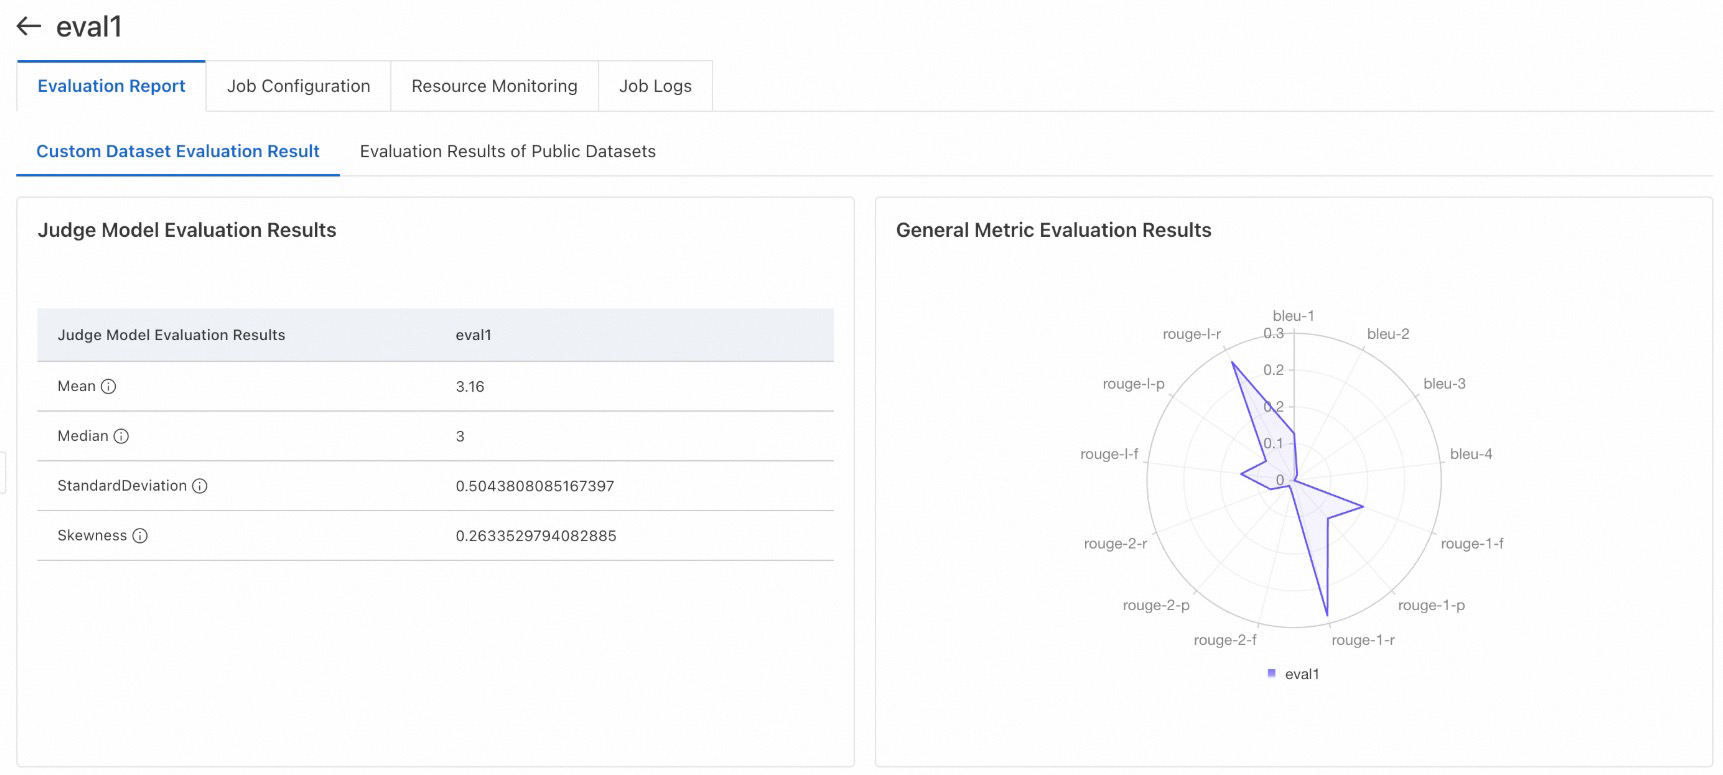
A avaliação do modelo suporta métricas comuns de correspondência de texto NLP, como BLEU e ROUGE, além de avaliação por modelo juiz. Este recurso, disponível apenas no modo profissional, usa um LLM juiz para avaliar outro LLM, fornecendo uma pontuação e o raciocínio utilizado. Use dados específicos do seu cenário para determinar se o modelo selecionado é adequado.
A avaliação requer um arquivo de conjunto de avaliação formatado em JSONL, onde cada linha é um objeto JSON. Use
questionpara identificar a coluna de perguntas eanswerpara a coluna de respostas. Arquivo de exemplo: evaluation_test.jsonl. -
Avaliação com conjunto de dados público
Oferece uma avaliação abrangente de grandes modelos usando conjuntos de dados de avaliação open source agrupados por domínio. A PAI mantém atualmente conjuntos como CMMLU, GSM8K, TriviaQA, MMLU, C-Eval, TruthfulQA e HellaSwag, cobrindo múltiplos domínios, incluindo matemática, conhecimento e raciocínio. Novos conjuntos de dados públicos são adicionados regularmente. Nota: Avaliações nos conjuntos GSM8K, TriviaQA e HellaSwag consomem bastante tempo. Selecione-os apenas se necessário.
Em seguida, selecione um caminho de saída para os resultados da avaliação, escolha os recursos de computação recomendados e envie a tarefa de avaliação. Após a conclusão da tarefa, visualize os resultados na página da tarefa. Se você selecionar vários conjuntos de dados, o modelo executará as avaliações sequencialmente, o que pode aumentar o tempo de espera. Consulte os logs para verificar o progresso da tarefa.
Visualize o relatório de avaliação: As imagens a seguir mostram exemplos de resultados de avaliação para conjuntos de dados personalizados e públicos.
Fale conosco
Convidamos você a acompanhar e utilizar a PAI-Model Gallery. Atualizamos continuamente a plataforma com modelos SOTA. Caso tenha alguma solicitação de modelo, sinta-se à vontade para entrar em contato. Participe da comunidade de usuários da PAI-Model Gallery pesquisando pelo número do grupo no DingTalk 79680024618.